第 35 章 · 折线图:容量衰减曲线
这一章要解决什么:把 SOH 随循环次数的变化画成一张能给别人看的图。 打掉第一个坑:matplotlib 默认字体不含汉字,中文会变成"豆腐块"(□□□)。
本章你需要完成的代码:demos/ch35-line-plot.py
35.1 为什么需要可视化
同一个事实,三种表达方式的效果差别巨大:
点开:三种表达方式的对比
方式一:一个数字
全批平均 SOH = 0.9071读者的反应:"哦,0.9 左右。所以呢?"
方式二:一句话
全批平均 SOH 从 0.9999 降到 0.8000,用了 859~1423 次循环。读者的反应:"下降了多少?快不快?"
方式三:一张图 + 一句话
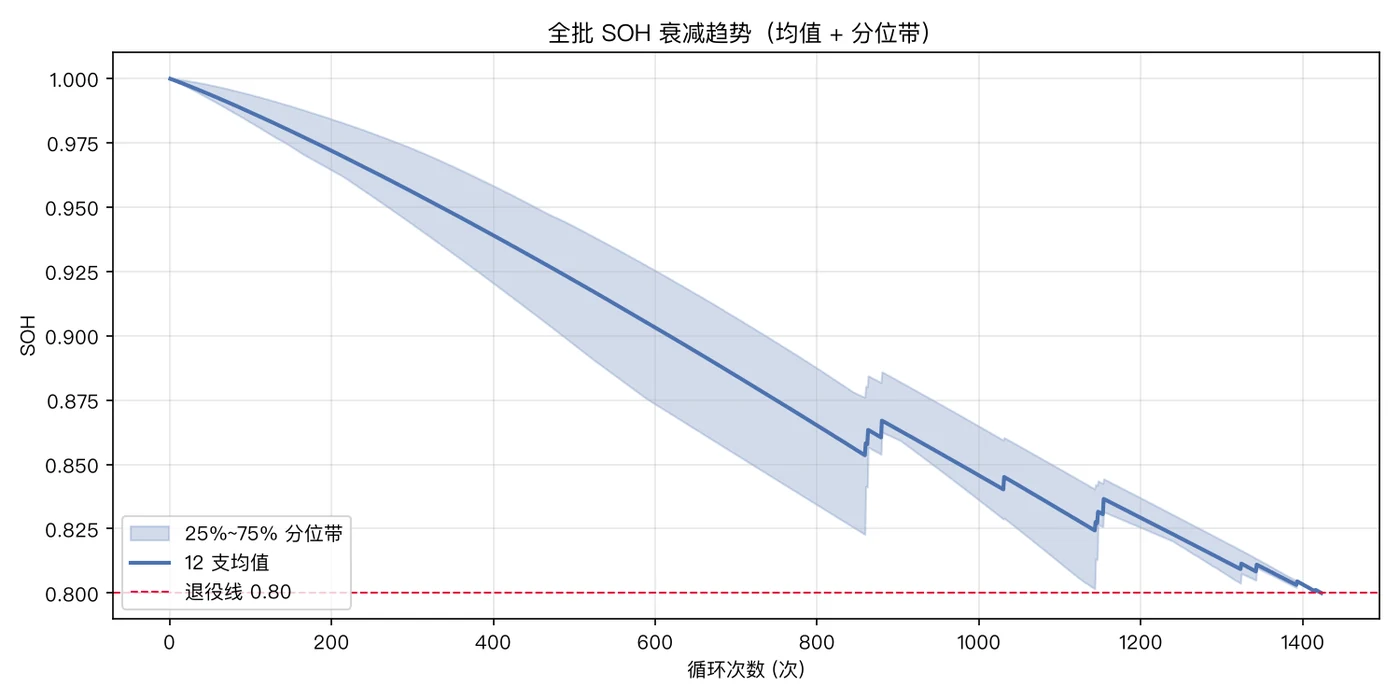
全批平均 SOH 从 0.9999 降到 0.8000(图 1),
25%~75% 分位带平均宽度仅 0.0294,说明电芯一致性良好。读者的反应(看图 3 秒):"前期慢、后期陡,12 条曲线挤在一起 —— 一致性好。"
这就是可视化的价值:
| 信息量 | 传递速度 | 说服力 | |
|---|---|---|---|
| 数字 | 低 | 快,但没感觉 | 弱 |
| 文字 | 中 | 慢 | 中 |
| 图 + 文字 | 高 | 快 | 强 |
★ 但可视化有一个前提:你得画对。
一张画错的图比没有图更糟 —— 它会误导别人做出错误判断。 本章的重点不是"怎么调用 API",而是"怎么画一张不误导人的图"。
35.2 第一步:解决中文字体问题
这是新手遇到的第一个(也是最"吓人"的)问题:
import matplotlib.pyplot as plt
plt.plot([1, 2, 3], [1, 4, 9])
plt.title("我的第一张图")
plt.show()
标题显示成 □□□□□ —— 这就是所谓的**"豆腐块"**。
原因:matplotlib 的默认字体(DejaVu Sans)不包含汉字。 它会用一个"缺字"符号代替,看起来像豆腐。
解决:指定一个系统里有汉字的字体。
点开:本书的解决方案(common/plots.py)
各平台常见的中文字体:
| 平台 | 字体名 |
|---|---|
| macOS | PingFang SC、Hiragino Sans GB、Heiti SC |
| Windows | Microsoft YaHei、SimHei |
| Linux | Noto Sans CJK SC、Source Han Sans SC、WenQuanYi Micro Hei |
本书的做法:自动探测可用的中文字体。
CJK_CANDIDATES = [
    "PingFang SC", "Hiragino Sans GB", "Heiti SC",      # macOS
    "Microsoft YaHei", "SimHei",                         # Windows
    "Noto Sans CJK SC", "Source Han Sans SC",            # Linux
    "WenQuanYi Micro Hei", "Arial Unicode MS",
]


def find_cjk_font():
    """返回系统里第一个可用的中文字体名;都找不到时返回 None。"""
    from matplotlib import font_manager
    available = {f.name for f in font_manager.fontManager.ttflist}
    for name in CJK_CANDIDATES:
        if name in available:
            return name
return None然后一次性设好全局样式:
def setup_style():
    font = find_cjk_font()
    plt.rcParams["font.sans-serif"] = ([font] if font else []) + ["DejaVu Sans"]
    plt.rcParams["axes.unicode_minus"] = False   # ★ 否则负号也是豆腐块!
    plt.rcParams["figure.dpi"] = 110
    plt.rcParams["savefig.dpi"] = 150            # 出图清晰度
    plt.rcParams["axes.grid"] = True
    plt.rcParams["grid.alpha"] = 0.3
    plt.rcParams["axes.prop_cycle"] = plt.cycler(color=PALETTE)
    return font
★ 注意 axes.unicode_minus = False 这一行
它经常被忽略,但很关键:默认的负号用的是 Unicode 减号(U+2212), 而中文字体里通常没有这个字符 —— 结果 y 轴的负数变成豆腐块。
所以中文环境里这一行是必备的。
实测输出:
=== ① 样式就绪(中文字体:PingFang SC) ===如果找不到中文字体,setup_style() 会打印提示:
[plots] ⚠ 没找到中文字体,图中中文可能显示为方框。
[plots]   macOS 一般自带 PingFang SC;Linux 可装 fonts-noto-cjk。
★ 一个额外的好处:MPLCONFIGDIR
# 必须在 import matplotlib 之前设置
import os
os.environ.setdefault("MPLCONFIGDIR", str(CODE_DIR / ".mplconfig"))为什么:matplotlib 默认把字体缓存写在 ~/.matplotlib 或 ~/.cache/matplotlib。 在受限环境(Docker、CI、共享服务器)里可能没有写权限, 会打印一大段警告,还会拖慢启动。
指到项目内的目录就永远不会有权限问题。
这个坑在"把脚本放进 Docker 跑"时特别容易遇到 —— 本地开发一切正常,容器里一堆警告。
35.3 四步画图流程
fig, ax = plt.subplots(figsize=(9, 4.5))      # ① 准备画布和坐标轴
ax.plot(c1["cycle"], c1["soh"], label="C001") # ② 画数据
ax.set_xlabel("循环次数 (次)")                 # ③ 修饰
ax.set_ylabel("SOH")
ax.set_title("C001:SOH 衰减曲线")
save_fig(fig, str(OUT / "ch35_fade_c001.png"))# ④ 保存并释放
这四步是固定套路,所有 matplotlib 代码都长这样。
点开:为什么要用 fig, ax 而不是 plt.plot()?
两种写法:
# 写法一:状态机式(隐式)
plt.plot(x, y)
plt.title("标题")
plt.savefig("a.png")

# 写法二:面向对象式(显式)—— 本书推荐
fig, ax = plt.subplots()
ax.plot(x, y)
ax.set_title("标题")
fig.savefig("a.png")为什么推荐写法二:
① 多子图时必须用。
fig, axes = plt.subplots(1, 2, figsize=(12, 4.5))    # 并排两个子图
axes[0].plot(x1, y1)
axes[1].plot(x2, y2)写法一做不到这个(plt.plot 永远画在"当前图"上,容易搞混)。
② 显式传递对象,不容易出"画错图"的问题。
# 状态机写法的典型 bug
plt.plot(x1, y1)
plt.figure()          # 新建了一张图
plt.plot(x2, y2)
plt.savefig("a.png") # 保存的是第二张(第一张被丢了)对象式写法里,fig 和 ax 就在你手上,不会搞错。
③ fig 和 ax 的分工很清楚。
| 对象 | 管什么 | 常用方法 |
|---|---|---|
fig(Figure) | 整张画布 | savefig、tight_layout、suptitle |
ax(Axes) | 一个坐标系 | plot、scatter、set_xlabel、legend |
记忆法:
fig  = 画布(可以放多个 ax)
ax   = 一个坐标系(画线、画点、设标签都在这里)
本书所有示例都用 fig, ax 写法,你也应该习惯它。
35.4 参考线:让图"会说话"
ax.axhline(0.85, color="orange", ls="--", lw=1.0)
ax.axhline(0.80, color="crimson", ls="--", lw=1.0)
ax.text(20, 0.855, "预警线 0.85", color="orange", fontsize=9, va="bottom")
ax.text(20, 0.805, "退役线 0.80", color="crimson", fontsize=9, va="bottom")
ax.set_ylim(0.78, 1.02)真实输出:
起点 SOH 0.9999 → 终点 0.8000
用到 862 圈,前 300 圈只掉了 5.92 个百分点
点开:参考线为什么这么重要?
没有参考线的图:读者看到一条下降的曲线,但不知道"降到多少算危险"。
有参考线的图:读者立刻知道"曲线什么时候穿过警戒线"。
三种参考线:
ax.axhline(y, ...)                # 水平线(最常用)
ax.axvline(x, ...)                # 垂直线(标时间节点)
ax.axhspan(y1, y2, alpha=0.1) # 水平色带(标区间)实用技巧:
| 参数 | 作用 |
|---|---|
ls="--" | 虚线(实线会和数据线混在一起) |
lw=1.0 | 细线(参考线不该比数据线粗) |
color="crimson" | 颜色要和"严重程度"匹配(红=危险) |
alpha=0.5 | 半透明(不抢数据的视觉重点) |
标签的位置要手动调:
ax.text(x, y, "文字", va="bottom")      # va = vertical alignment
# va="bottom" → 文字在 (x, y) 的上方
# va="top"    → 文字在 (x, y) 的下方
为什么不用 ax.legend() 标参考线:图例会变得很长, 而"线旁边的文字标注"更直接。
★ 一个实用的封装
def add_threshold_lines(ax, thresholds, x_pos=20):
    """在轴上画一组阈值线 + 标注。

    thresholds: [(值, 文字, 颜色), ...]
    """
    for value, label, color in thresholds:
        ax.axhline(value, color=color, ls="--", lw=1.0, alpha=0.8)
        ax.text(x_pos, value + 0.003, label, color=color,
                fontsize=9, va="bottom")

# 用法
add_threshold_lines(ax, [
    (0.85, "预警线 0.85", "orange"),
    (0.80, "退役线 0.80", "crimson"),
])这个函数的价值:把"画线 + 标注"绑在一起, 不会出现"画了线但忘了标"的情况。
35.5 ★ 双 y 轴:twinx 的三条纪律
这是本章最重要的技术点。
fig, ax = plt.subplots(figsize=(9, 4.5))

# 左轴:SOH
ax.plot(c1["cycle"], c1["soh"], color="#4C72B0", lw=1.8, label="SOH")
ax.set_ylabel("SOH", color="#4C72B0")
ax.tick_params(axis="y", labelcolor="#4C72B0")

# 右轴:内阻
ax2 = ax.twinx()                       # ★ 共享 x 轴的第二根 y 轴
ax2.plot(c1["cycle"], c1["resistance_mohm"], color="#C44E52", lw=1.8, label="内阻")
ax2.set_ylabel("内阻 (mΩ)", color="#C44E52")
ax2.tick_params(axis="y", labelcolor="#C44E52")
ax2.grid(False)                        # ★ 关掉第二条轴的网格

# 合并图例
h1, l1 = ax.get_legend_handles_labels()
h2, l2 = ax2.get_legend_handles_labels()
ax.legend(h1 + h2, l1 + l2, loc="center left")结果:
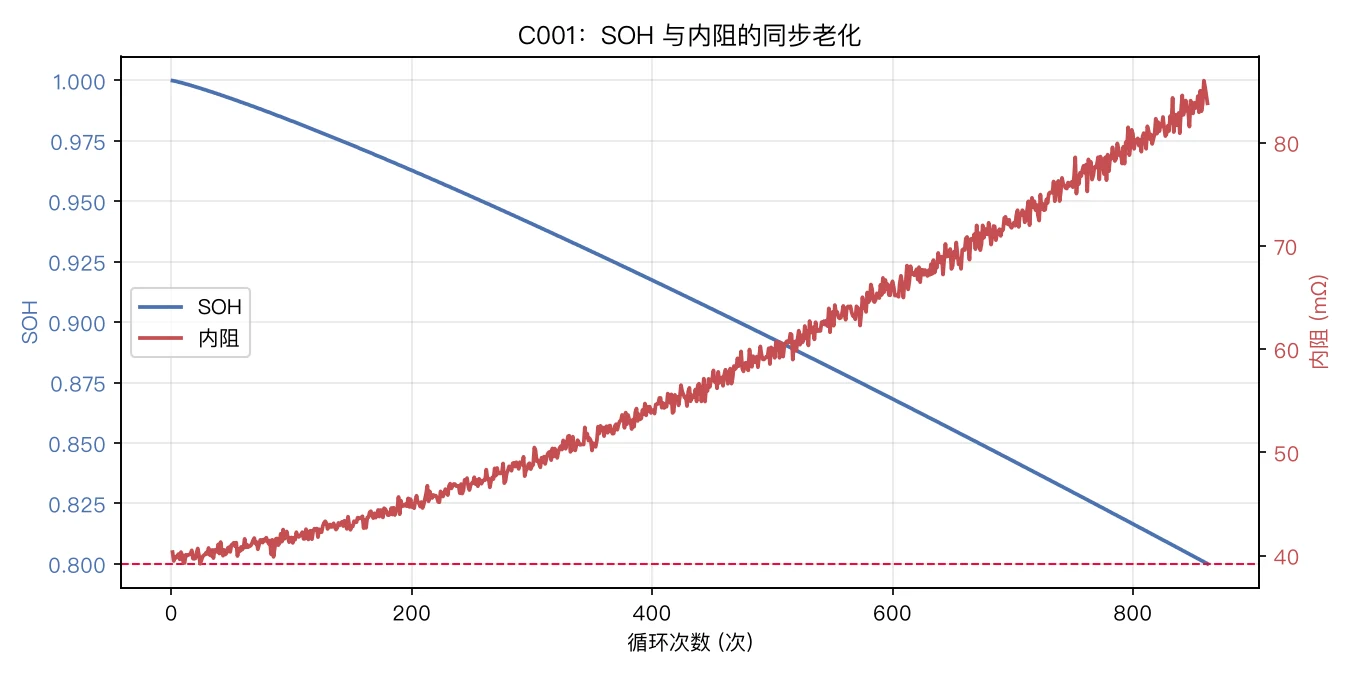
对比:如果不使用双轴会怎样
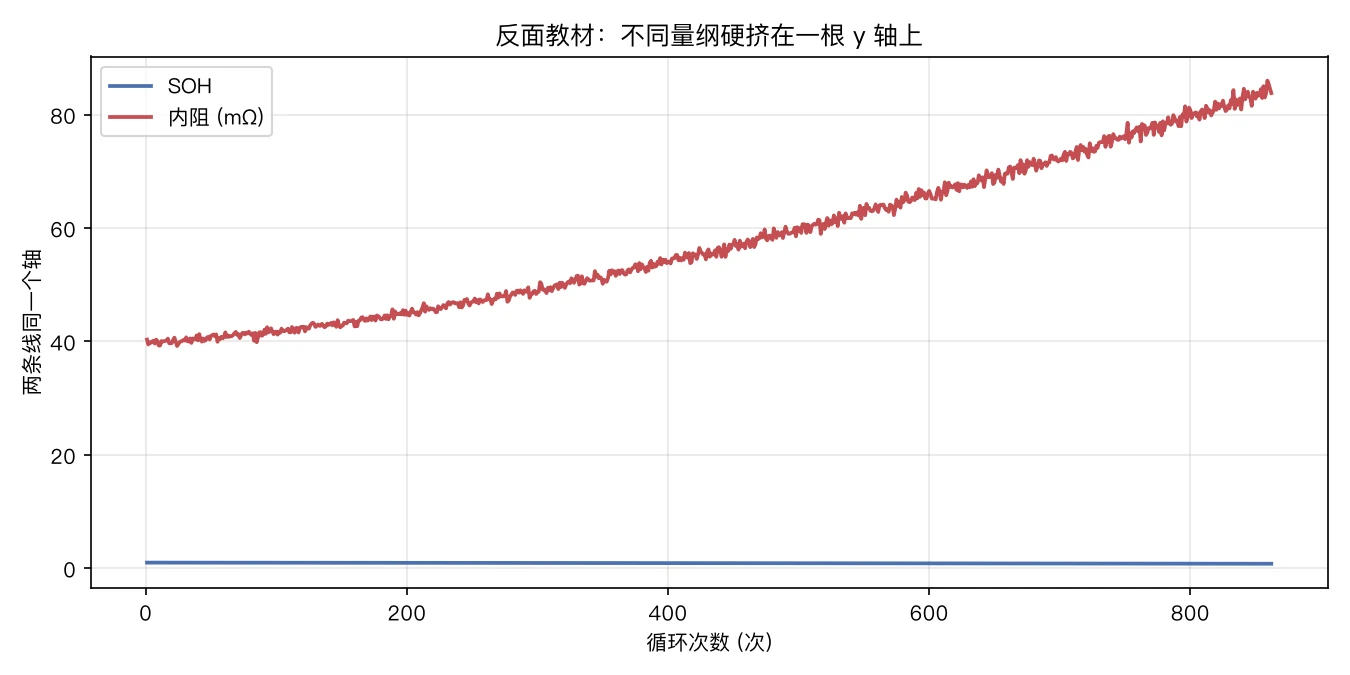
点开:为什么必须用双 y 轴,以及三条纪律的由来
为什么需要双轴
看两个量的数值范围:
SOH  :0.80 ~ 1.00      范围宽度 0.20
内阻 :38 ~ 88 mΩ 范围宽度 50画在同一根轴上会怎样:
y 轴的显示范围必须覆盖 0.80 ~ 88
    ↓
SOH 的 0.80~1.00 只占 y 轴的 0.2/88 ≈ 0.2%
    ↓
SOH 曲线被压成一条贴着底部的水平线
    ↓
完全看不出衰减!
这就是反面教材图里展示的效果 —— 蓝线(SOH)几乎是一条直线。
★ 所以双 y 轴存在的唯一理由:两个量的量纲差太远。
如果两个量量纲接近(比如"容量 Ah"和"能量 Wh"), 就不该用双轴 —— 那会让读者误以为两者可以比较。
三条纪律
纪律一:轴标签用和线一样的颜色。
ax.set_ylabel("SOH", color="#4C72B0")                  # 蓝色标签配蓝线
ax.tick_params(axis="y", labelcolor="#4C72B0")         # ★ 刻度也要染色
ax2.set_ylabel("内阻 (mΩ)", color="#C44E52")          # 红色标签配红线
ax2.tick_params(axis="y", labelcolor="#C44E52")为什么要染刻度:只染标签不染刻度,读者还是要靠位置去猜"哪个刻度配哪条线"。
纪律二:关掉第二条轴的网格。
ax2.grid(False)不写会怎样:两根轴各有自己的网格线,它们的位置不同 → 图上出现两套交错的白线,非常脏乱。
⚠ 这个错误不报错,只是图变丑 —— 所以容易被忽略。
纪律三:图例要手工合并。
h1, l1 = ax.get_legend_handles_labels()       # 左轴的 handles 和 labels
h2, l2 = ax2.get_legend_handles_labels()      # 右轴的
ax.legend(h1 + h2, l1 + l2, loc="center left") # 合并后一起画为什么:ax.legend() 只认自己那个 ax 上的线。
ax.legend()      # ❌ 只显示 SOH,内阻的线不见了
ax2.legend()     # ❌ 只显示内阻,而且会把图例画在右侧
★ 一个封装好的工具
def plot_twin_axis(ax, x, y1, y2, label1, label2, color1="#4C72B0", color2="#C44E52"):
    """在 ax 上画双 y 轴曲线,自动处理颜色、网格、图例。"""
    ax.plot(x, y1, color=color1, lw=1.8, label=label1)
    ax.set_ylabel(label1, color=color1)
    ax.tick_params(axis="y", labelcolor=color1)

    ax2 = ax.twinx()
    ax2.plot(x, y2, color=color2, lw=1.8, label=label2)
    ax2.set_ylabel(label2, color=color2)
    ax2.tick_params(axis="y", labelcolor=color2)
    ax2.grid(False)                                    # 纪律二

    h1, l1 = ax.get_legend_handles_labels()
    h2, l2 = ax2.get_legend_handles_labels()
    ax.legend(h1 + h2, l1 + l2, loc="center left")      # 纪律三
    return ax2
用这个函数,三条纪律不会再漏。
35.6 均值 + 分位带:一张图表达"趋势 + 离散度"
问题:12 支电芯画在一张图上会显得很乱(12 条线)。
解决:画均值曲线 + 25%~75% 分位带。
pivot = df.pivot_table(index="cycle", columns="cell_id", values="soh")
mean_curve = pivot.mean(axis=1)
q25, q75 = pivot.quantile(0.25, axis=1), pivot.quantile(0.75, axis=1)

fig, ax = plt.subplots(figsize=(10, 5))
ax.fill_between(mean_curve.index, q25, q75, alpha=0.22,
                color=PALETTE[0], label="25%~75% 分位带")
ax.plot(mean_curve.index, mean_curve, color=PALETTE[0], lw=2.0, label="全批均值")
ax.axhline(0.85, color=PALETTE[1], ls="--", lw=1.0, label="预警线 0.85")
ax.axhline(0.80, color=PALETTE[3], ls="--", lw=1.0, label="退役线 0.80")结果:
真实输出:
第 1 圈均值 0.9999,第 1423 圈均值 0.8000
分位带平均宽度 = 0.0294(最大 0.0534)
点开:为什么"分位带"比"12 条线"好?
三种表达多组数据的方式:
| 方式 | 优点 | 缺点 |
|---|---|---|
| 12 条线 | 每条都能看清 | 太乱;读者抓不住重点 |
| 只有均值 | 干净 | 丢掉了离散度信息 |
| 均值 + 分位带 | 趋势和离散度都在 | 看不到单条曲线 |
分位带传达的信息:
带子窄 → 各支电芯表现一致(工艺稳定)
带子宽 → 个体差异大(工艺待改进)

带子随循环变宽 → 老化过程中分化加剧
带子全程等宽 → 老化过程一致本数据:分位带平均宽度 0.0294,全程变化不大 → "12 支电芯的衰减轨迹高度一致"。
这个结论比"平均 SOH 是 0.9071"有价值得多 —— 它直接回答了"工艺稳不稳定"这个业务问题。
★ 常用的分位带选择
| 分位带 | 含义 | 适合 |
|---|---|---|
| 25%~75%(IQR) | 中间 50% 的数据 | 最常用(和箱线图一致) |
| 10%~90% | 中间 80% | 想看得更"全" |
| min~max | 全部范围 | 数据量小时(否则被极值撑得太宽) |
| 均值 ± 1 标准差 | 正态假设下约 68% | 数据近似正态时 |
本书用 25%~75%,因为它和 IQR 规则一致(第 33 章), 而且不受极值影响。
★ 一个相关的技巧:叠加几条代表性曲线
# 分位带 + 3 条代表性曲线(最好/中位/最差)
fig, ax = plt.subplots(figsize=(10, 5))
ax.fill_between(mean_curve.index, q25, q75, alpha=0.2, color=PALETTE[0])
ax.plot(mean_curve.index, mean_curve, color=PALETTE[0], lw=2.0, label="全批均值")

for cid, style in [("C009", ":"), ("C010", "--"), ("C011", "-.")]:
    sub = df[df["cell_id"] == cid].sort_values("cycle")
    ax.plot(sub["cycle"], sub["soh"], ls=style, lw=1.2,
            label=f"{cid}(寿命 {len(sub)})")
ax.legend()
这样既有"整体趋势",又有"具体例子" —— 汇报时特别有用(观众既能看全局,也能看细节)。
35.7 常见坑小结
① 中文变豆腐块 → 没设中文字体,用 setup_style()
② 图不弹窗 → 脚本里用的是 Agg 无界面后端,这是正常的,图存在文件里
③ 忘 plt.close(fig) → 批量画几十张图内存一路涨(save_fig 已处理)
④ x 与 y 长度不一致 → ValueError: x and y must have same first dimension
⑤ x 轴乱序 → 画之前先 sort_values(否则曲线来回折返)
⑥ 保存时被裁掉 → 用 fig.tight_layout() 或 bbox_inches='tight'
⑦ 保存路径的目录不存在 → 先 mkdir(parents=True, exist_ok=True)(save_fig 已处理)
点开:逐条解释这七个坑
① 中文豆腐块 → 见 35.2,用 setup_style()。
② 图不弹窗
import matplotlib
matplotlib.use("Agg") # 无界面后端:不弹窗,只存文件这是有意为之:服务器/CI 上没有图形界面, Agg 后端让脚本能在任何环境跑。
看到"没有弹窗"不要以为出错了 —— 去看输出目录里的文件。
如果你想在本地交互式看:
# 在 Jupyter 里
%matplotlib inline

# 在本地脚本里(不想设 Agg)
import matplotlib.pyplot as plt
plt.show()                 # 会弹窗
③ 忘 plt.close(fig)
for i in range(50):
    fig, ax = plt.subplots()
    ax.plot(...)
    fig.savefig(f"fig_{i}.png")
# ❌ 忘了 plt.close(fig) → 50 个 figure 都留在内存里后果:内存持续增长,画到第 100 张可能就 OOM 了。
save_fig() 里已经包含了 plt.close(fig):
def save_fig(fig, path):
    path = os.path.abspath(path)
    os.makedirs(os.path.dirname(path), exist_ok=True)
    fig.tight_layout()
    fig.savefig(path)
    plt.close(fig)          # ★ 释放内存
    return path
④ x 与 y 长度不一致
ax.plot([1, 2, 3], [1, 4])       # ValueError
# ValueError: x and y must have same first dimension, but have shapes (3,) and (2,)修复:assert len(x) == len(y) 加在画图前。
⑤ x 轴乱序
# ❌ 数据没排序,曲线来回折返
ax.plot(sub["cycle"], sub["soh"])

# ✅ 先排序
sub = sub.sort_values("cycle")
ax.plot(sub["cycle"], sub["soh"])
⚠ 这个坑很隐蔽:图看起来"有线条",但形状完全不对。
为什么会出现乱序:如果数据经过 sample()、merge()、concat(), 顺序就不再保证。
⑥ 保存时被裁掉
fig.savefig("a.png")                   # 标题/标签可能被切掉
fig.tight_layout()                     # ✅ 自动调整间距
fig.savefig("a.png", bbox_inches="tight")   # ✅ 或者用这个
save_fig() 里已经调了 tight_layout()。
⑦ 目录不存在
df.to_csv("outputs/a/b/c.csv") # FileNotFoundErrorsave_fig() 里已经 os.makedirs(..., exist_ok=True)。
★ 总结:save_fig() 帮你处理了 ③⑥⑦
save_fig(fig, str(OUT / "ch35_fade_c001.png"))一行调用,比手写四行更不容易漏。
35.8 完整示例与输出
cd code
python demos/ch35-line-plot.py
真实输出(节选):
=== ① 样式就绪(中文字体:PingFang SC) ===
  数据读入:(13967, 9),共 12 支电芯

=== ③ 单条曲线:C001 的 SOH 衰减(862 圈) ===
  起点 SOH 0.9999 → 终点 0.8000
  用到 862 圈,前 300 圈只掉了 5.92 个百分点

=== ④ 多支电芯画在一张图上 ===
  观察:所有曲线都在 SOH=0.80 收工(这是数据生成规则),
        但「用了多少圈才走到那里」差别很大(859 ~ 1423 圈)。

=== ⑤ 双 y 轴:SOH 与内阻同步老化 ===
  ★ 双轴三纪律:
    ① 轴标签要用和线一样的颜色
    ② 关掉第二条轴的网格(ax2.grid(False))
    ③ 图例必须手工合并两个 ax 的 handles

=== ⑥ 一张图看多支电芯的「平均衰减」+ 分散带 ===
  第 1 圈均值 0.9999,第 1423 圈均值 0.8000
本次共产出 5 张图(在 code/outputs/ 下):
| 文件 | 内容 |
|---|---|
ch35_fade_c001.png | 单支电芯的 SOH 曲线 + 阈值线 |
ch35_fade_all.png | 12 支电芯叠在一张图 |
ch35_fade_resistance.png | 双 y 轴(正确示范) |
ch35_fade_bad_axis.png | 单 y 轴(反面教材) |
ch35_fade_band.png | 均值 + 分位带 |
本章练习
练习 1:双轴画 C001 的 SOH 与内阻
在一张图上同时画 C001 的 SOH(左轴)与内阻(右轴):
- 两条线用不同颜色、各自的轴标签也用对应颜色;
- 标出 0.85 / 0.80 两条参考线(带文字);
- 标题写「C001:SOH 与内阻的同步老化」;
- 保存成
outputs/ch35_exercise.png。
参考答案
import os
import sys
from pathlib import Path

import pandas as pd

CODE_DIR = Path(__file__).resolve().parent.parent.parent
sys.path.insert(0, str(CODE_DIR))
os.environ.setdefault("MPLCONFIGDIR", str(CODE_DIR / ".mplconfig"))

import matplotlib.pyplot as plt                             # noqa: E402
from common.plots import setup_style, save_fig              # noqa: E402

OUT = CODE_DIR / "outputs"
setup_style()

df = pd.read_csv(CODE_DIR / "data" / "battery" / "cycle_raw.csv")
c1 = df[df["cell_id"] == "C001"].sort_values("cycle")       # ★ 先排序

C_SOH, C_R = "#4C72B0", "#C44E52"

fig, ax = plt.subplots(figsize=(9, 4.5))

# 左轴
ax.plot(c1["cycle"], c1["soh"], color=C_SOH, lw=1.8, label="SOH")
ax.set_xlabel("循环次数 (次)")
ax.set_ylabel("SOH", color=C_SOH)
ax.tick_params(axis="y", labelcolor=C_SOH)

# 参考线
ax.axhline(0.85, color="orange", ls="--", lw=1.0)
ax.axhline(0.80, color="crimson", ls="--", lw=1.0)
ax.text(20, 0.855, "预警线 0.85", color="orange", fontsize=9, va="bottom")
ax.text(20, 0.805, "退役线 0.80", color="crimson", fontsize=9, va="bottom")
ax.set_ylim(0.78, 1.02)

# 右轴
ax2 = ax.twinx()
ax2.plot(c1["cycle"], c1["resistance_mohm"], color=C_R, lw=1.8, label="内阻")
ax2.set_ylabel("内阻 (mΩ)", color=C_R)
ax2.tick_params(axis="y", labelcolor=C_R)
ax2.grid(False)                       # 纪律二

# 合并图例
h1, l1 = ax.get_legend_handles_labels()
h2, l2 = ax2.get_legend_handles_labels()
ax.legend(h1 + h2, l1 + l2, loc="center left")   # 纪律三

ax.set_title("C001:SOH 与内阻的同步老化")
save_fig(fig, str(OUT / "ch35_exercise.png"))三条纪律一个都不能少:
| 纪律 | 代码 | 漏了会怎样 |
|---|---|---|
| ① 轴标签染色 | ax.set_ylabel(..., color=) + tick_params | 读者不知道哪根轴配哪条线 |
| ② 关网格 | ax2.grid(False) | 两套网格交错,图很脏 |
| ③ 合并图例 | h1 + h2, l1 + l2 | 只显示一条线的图例 |
★ 三个额外的注意点
① 画之前一定要 sort_values("cycle"):
c1 = df[df["cell_id"] == "C001"]        # ❌ 顺序不保证
c1 = c1.sort_values("cycle")             # ✅
② 参考线的 va 参数决定文字在线上面还是下面:
ax.text(20, 0.855, "预警线", va="bottom")    # 文字在线之上
ax.text(20, 0.805, "退役线", va="top")       # 文字在线之下
③ set_ylim 给参考线留出空间:
ax.set_ylim(0.78, 1.02) # 否则 0.80 的参考线可能贴着图的下边缘完整练习:exercises/ex35-01-line-plot
练习 2:为什么"两条线画在一个轴上"是错的?
fig, ax = plt.subplots()
ax.plot(c1["cycle"], c1["soh"], label="SOH")
ax.plot(c1["cycle"], c1["resistance_mohm"], label="内阻 (mΩ)")
ax.legend()要求:说出这张图会有什么问题,并解释原因。
参考答案
问题:SOH 曲线会被压成一条贴着底部的水平线,完全看不出衰减。
原因:两个量的数值范围差太远。
SOH  :0.80 ~ 1.00      范围宽度 0.20
内阻 :38 ~ 88 mΩ       范围宽度 50

y 轴必须覆盖 0.80 ~ 88(跨度 87.2)
    ↓
SOH 的变化范围 0.20 只占 y 轴的 0.20 / 87.2 ≈ 0.23%
    ↓
在 500 像素高的图上,SOH 的变化只有约 1.1 像素
    ↓
看起来就是一条直线对比:
| 单轴 | 双轴 | |
|---|---|---|
| SOH 的可见变化 | ~1 像素 | 占满左轴 |
| 内阻的可见变化 | 占满 y 轴 | 占满右轴 |
| 能看出"SOH 下降"吗 | ❌ | ✅ |
| 能看出两者同步吗 | ❌ | ✅ |
★ 但双轴不是万能的
双 y 轴有一个"原罪":它让读者以为两条线可以比较。
读者看到两条线交叉,会想"它们在这个点相等了"
但实际上:左轴的 0.9 和右轴的 0.9 完全没关系所以双轴的使用纪律:
| 情况 | 用双轴吗 |
|---|---|
| 两个量纲差很远,但变化趋势要对比 | ✅ 可以 |
| 两个量纲差很远,要比较绝对大小 | ❌ 不该(会误导) |
| 两个量纲接近 | ❌ 不该(一个轴就够) |
★ 更好的替代方案
方案一:上下两个子图,共享 x 轴(最不容易误导)
fig, (ax1, ax2) = plt.subplots(2, 1, figsize=(9, 7), sharex=True)
ax1.plot(c1["cycle"], c1["soh"], color="#4C72B0")
ax1.set_ylabel("SOH")
ax2.plot(c1["cycle"], c1["resistance_mohm"], color="#C44E52")
ax2.set_ylabel("内阻 (mΩ)")
ax2.set_xlabel("循环次数 (次)")优点:两个量各有自己的坐标系,没有任何"可以比较"的暗示, 而且趋势对齐(共享 x 轴)。
方案二:标准化到同一尺度(如果想放在一个轴上)
# 各自标准化到 [0, 1]
soh_n = (c1["soh"] - c1["soh"].min()) / (c1["soh"].max() - c1["soh"].min())
r_n = (c1["resistance_mohm"] - c1["resistance_mohm"].min()) / \
      (c1["resistance_mohm"].max() - c1["resistance_mohm"].min())

ax.plot(c1["cycle"], soh_n, label="SOH(归一化)")
ax.plot(c1["cycle"], r_n, label="内阻(归一化)")
ax.set_ylabel("归一化值 [0, 1]")优点:一个轴,趋势对比清楚; 缺点:失去了绝对数值的直观感受。
★ 该怎么选
要展示"趋势是否同步" → 方案一(双子图)最稳
汇报页数有限、要放一张图 → 双轴 + 明确的轴标签颜色
要精确比较两个量的变化幅度 → 方案二(归一化)本书示例里三种都演示了(第 35 章是双轴,第 38 章用分位带, 可以按自己的场景选)。
练习 3:为什么中文变成"豆腐块"?
import matplotlib.pyplot as plt
plt.plot([1, 2, 3], [1, 4, 9])
plt.title("我的第一张图")
plt.ylabel("-1 到 1")要求:说出这张图会有几处显示问题,以及怎么修。
参考答案
两处问题:
| # | 问题 | 原因 |
|---|---|---|
| ① | 标题「我的第一张图」变豆腐块 | 默认字体不含汉字 |
| ② | y 轴标签里的负号也变豆腐块 | 默认用 Unicode 减号(U+2212),中文字体里没有 |
第二点最容易被忽略 —— 因为大家只注意汉字,忘了负号。
完整的修复:
import matplotlib
import matplotlib.pyplot as plt

# 方案一:本书的 setup_style()(推荐)
from common.plots import setup_style
setup_style()它内部做的事:
plt.rcParams["font.sans-serif"] = ["PingFang SC"] + ["DejaVu Sans"]
plt.rcParams["axes.unicode_minus"] = False      # ★ 解决负号问题
方案二:手动设置
# macOS
plt.rcParams["font.sans-serif"] = ["PingFang SC", "Arial Unicode MS"]
plt.rcParams["axes.unicode_minus"] = False

# Windows
plt.rcParams["font.sans-serif"] = ["Microsoft YaHei", "SimHei"]
plt.rcParams["axes.unicode_minus"] = False

# Linux(需先安装 fonts-noto-cjk)
plt.rcParams["font.sans-serif"] = ["Noto Sans CJK SC", "WenQuanYi Micro Hei"]
plt.rcParams["axes.unicode_minus"] = False
方案三:查看系统里有哪些中文字体
from matplotlib import font_manager
names = sorted({f.name for f in font_manager.fontManager.ttflist})
cjk = [n for n in names if any(k in n for k in
       ("PingFang", "Hei", "YaHei", "Song", "Noto", "CJK", "SimSun", "Kai"))]
print(cjk)
★ 一个常见误区
plt.rcParams["font.family"] = "sans-serif"       # 不够!
plt.rcParams["font.sans-serif"] = ["SimHei"]必须两个都设(或者只设第二个也够): font.family 决定用哪个"字体族",font.sans-serif 决定这个族里优先用哪个。 只设 font.family 不会生效。
★ 如果找不到中文字体怎么办
Linux 服务器上很常见(精简镜像里没有中文字体)。
# 安装思源黑体
sudo apt install fonts-noto-cjk           # Debian/Ubuntu
sudo yum install google-noto-sans-cjk-fonts   # RHEL/CentOS

# 或者手动放字体文件
mkdir -p ~/.fonts
cp your-font.ttf ~/.fonts/
rm -rf ~/.cache/matplotlib                # 清缓存,让 matplotlib 重新扫描
清缓存这一步很关键 —— matplotlib 有字体缓存, 新装的字体不重新扫描就发现不了。
★ 一个"降级"策略
如果实在没有中文字体,就把图中的文字改成英文:
LABELS = {
    "cycle": "Cycle count" if not HAS_CJK else "循环次数 (次)",
    "soh": "SOH",
}
这比"图上有豆腐块"要专业得多。
面向 AI 开发:可视化是"模型诊断"的第一工具
训练完一个模型,你最该做的不是看指标数字,而是画图。
★ 为什么:指标是"平均值",而模型的问题往往在局部。
四个必看的诊断图:
① 预测 vs 真实(散点图)
fig, ax = plt.subplots(figsize=(5, 5))
ax.scatter(y_true, y_pred, s=3, alpha=0.3, linewidths=0)
lims = [min(y_true.min(), y_pred.min()), max(y_true.max(), y_pred.max())]
ax.plot(lims, lims, "r--", lw=1, label="完美预测")
ax.set_xlabel("真实值")
ax.set_ylabel("预测值")
ax.legend()能看出:
- 点是否落在对角线附近(整体准确度);
- 是否有系统偏差(点整体在对角线一侧);
- 不同区间的表现差异(比如高 SOH 区很准、低 SOH 区发散)。
② 残差图(Residual plot)
residual = y_pred - y_true
fig, ax = plt.subplots(figsize=(8, 4))
ax.scatter(y_pred, residual, s=3, alpha=0.3, linewidths=0)
ax.axhline(0, color="crimson", ls="--", lw=1)
ax.set_xlabel("预测值")
ax.set_ylabel("残差(预测 - 真实)")能看出:
- 有没有结构(如果残差呈现曲线/漏斗形,说明模型漏掉了某些模式);
- 残差应该"随机分布在 0 附近",任何结构都是线索。
③ 按分组的误差对比(箱线图)
df["err"] = (df["pred"] - df["soh"]).abs()
fig, ax = plt.subplots(figsize=(8, 4))
ax.boxplot([df.loc[df["batch"] == b, "err"].to_numpy()
            for b in sorted(df["batch"].unique())])
ax.set_xticklabels([f"批次 {b}" for b in sorted(df["batch"].unique())])
ax.set_ylabel("绝对误差")能看出:模型在哪个子群上表现差(比如某个批次、某个 SOH 区间)。
这比总体 MAE 有用得多 —— 它告诉你"下一步该往哪优化"。
④ 训练曲线(折线图)
fig, ax = plt.subplots(figsize=(8, 4))
ax.plot(history["train_loss"], label="训练损失")
ax.plot(history["val_loss"], label="验证损失")
ax.set_xlabel("Epoch")
ax.set_ylabel("Loss")
ax.legend()能看出:
- 过拟合(训练损失还在降、验证损失开始升);
- 欠拟合(两条都高且平);
- 学习率问题(损失震荡或下降太慢)。
★ 一个反例:为什么不看指标只看图会漏问题
总体 MAE = 0.012  (看起来很好)
    ↓
但把残差按 SOH 区间拆开看:
  SOH > 0.90    MAE = 0.005   ✅
  SOH 0.85~0.90 MAE = 0.010   ✅
  SOH < 0.85    MAE = 0.045   ❌ ← 误差是平均值的 4 倍!
总体 MAE 被大量"容易预测的样本"掩盖了 —— 而"低 SOH 区预测不准"恰恰是最致命的(那是最需要准确判断"该不该退役"的区间)。
★ 一条纪律
报告模型效果时,必须同时给出"分组的误差" —— 总体指标会掩盖局部问题。
这和本章的"折线图 + 参考线"是同一个思路:
| 只看数字 | 加上图 | |
|---|---|---|
| 数据探索 | "SOH 均值 0.9071" | "前期慢后期陡,12 条曲线很集中" |
| 模型诊断 | "MAE = 0.012" | "低 SOH 区误差是平均值的 4 倍" |
图的价值是"暴露结构",而结构往往就是问题的所在。