第 39 章 · ❖ 阶段目标:电池数据体检报告
本章没有新概念 —— 它把前面 38 章拼成一个可交付的东西: 一条命令 → 清洗数据 + 4 张图 + 一份带结论的 Markdown 报告。
本章唯一要学的是「工程组织」: 怎么把一堆脚本拆成函数,让「图、数字、结论」永远不会互相矛盾。
本章你需要完成的代码:demos/ch39-report.py
39.1 先看成品
cd code
python demos/ch39-report.py真实输出:
[1/5] 样式就绪(中文字体:PingFang SC)
[2/5] 清洗完成:13,967 行 → 缺失 0 格,标记异常 68 条
[3/5] 图 1 完成:SOH 0.9999 → 0.8000
[4/5] 图 2/3/4 完成:r(SOH, 内阻) = -0.9397,与 SOH 最强 = capacity_ah
[5/5] 报告已写出:outputs/体检报告.md
清洗后数据已写出:outputs/cycle_clean.csv(13,967 行 × 10 列)产物清单:
✅ ch39_fade.png                  110.9 KB
✅ ch39_resistance_vs_soh.png     514.3 KB
✅ ch39_corr_heatmap.png           79.1 KB
✅ ch39_soh_by_batch.png           35.7 KB
✅ 体检报告.md                      5.7 KB
✅ cycle_clean.csv 821.0 KB四张图分别是:
图 1 · 全批 SOH 衰减曲线
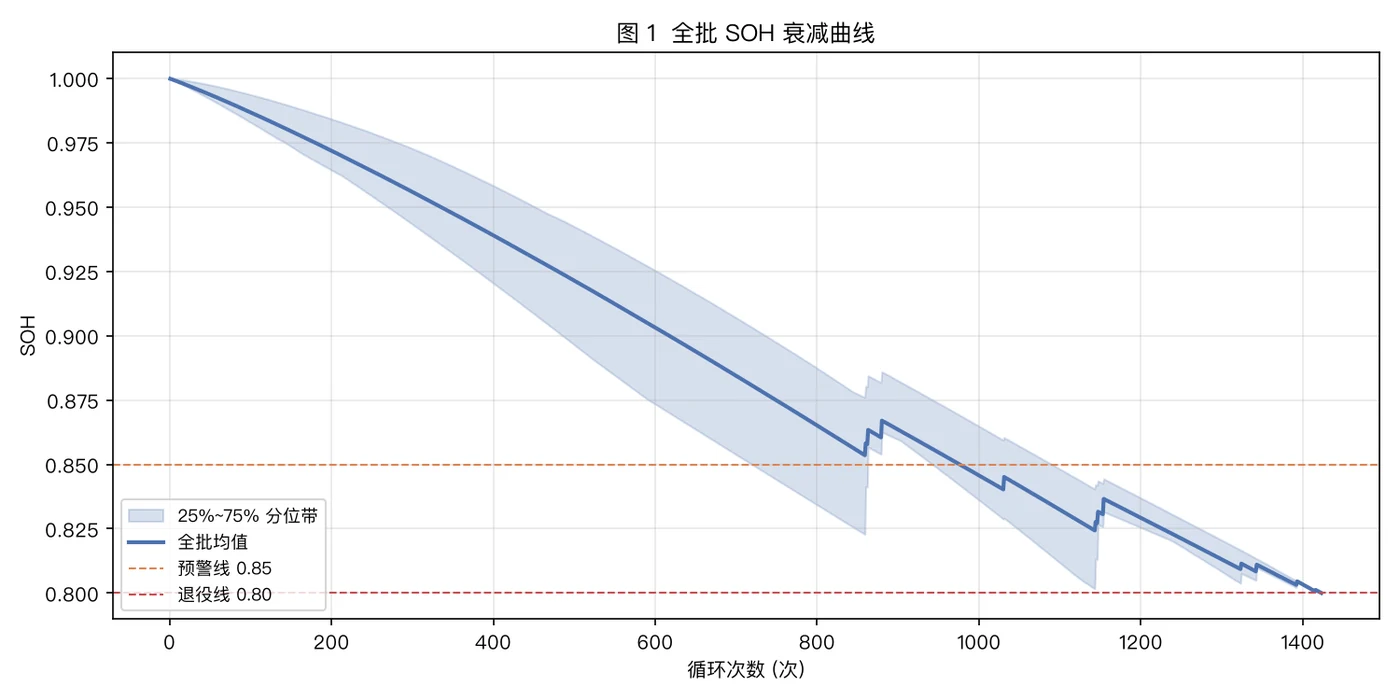
图 2 · 内阻 vs SOH(清洗前后对比)
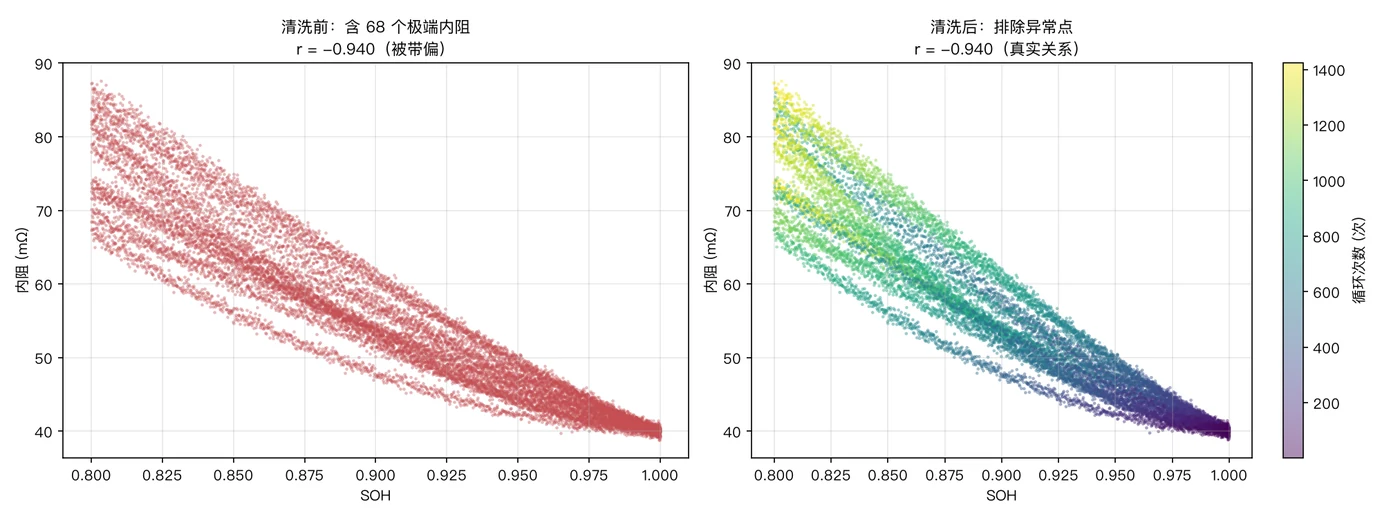
图 3 · 相关系数热力图
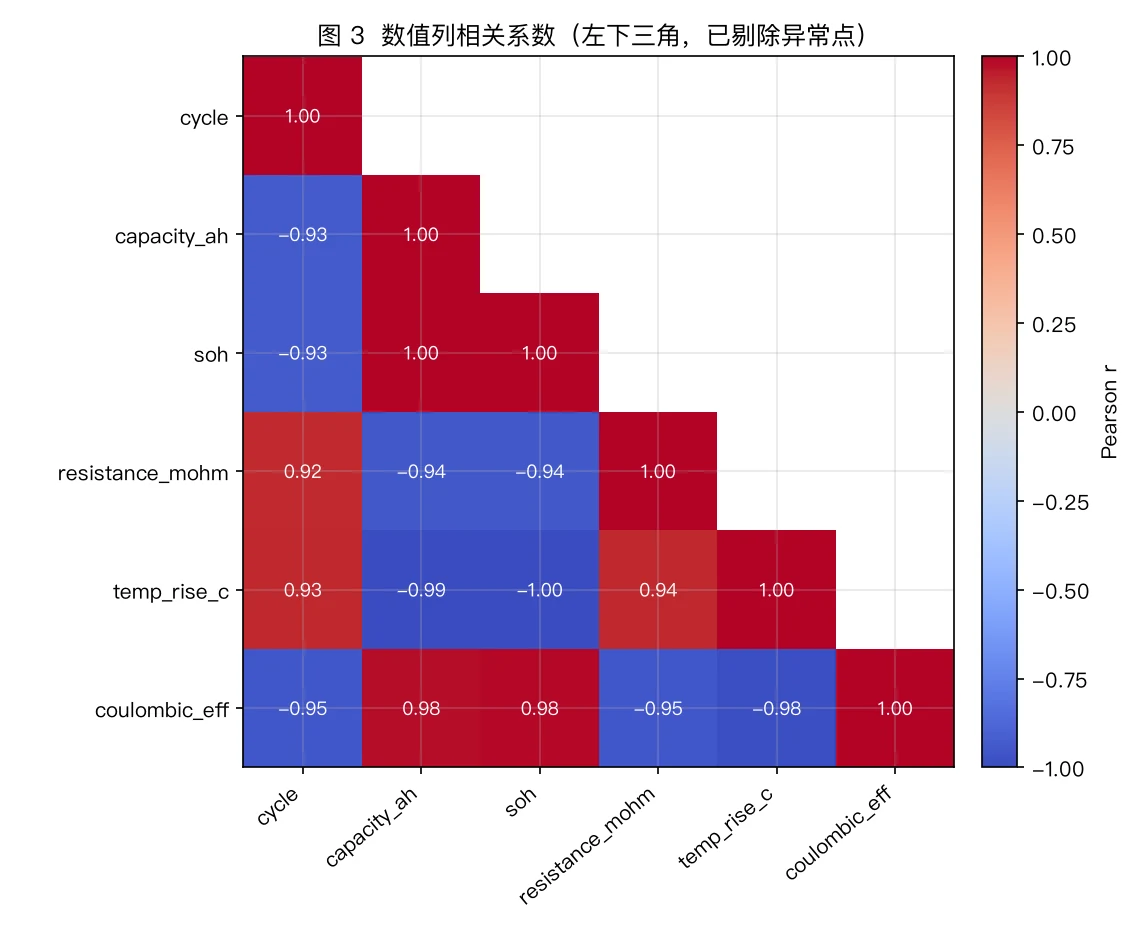
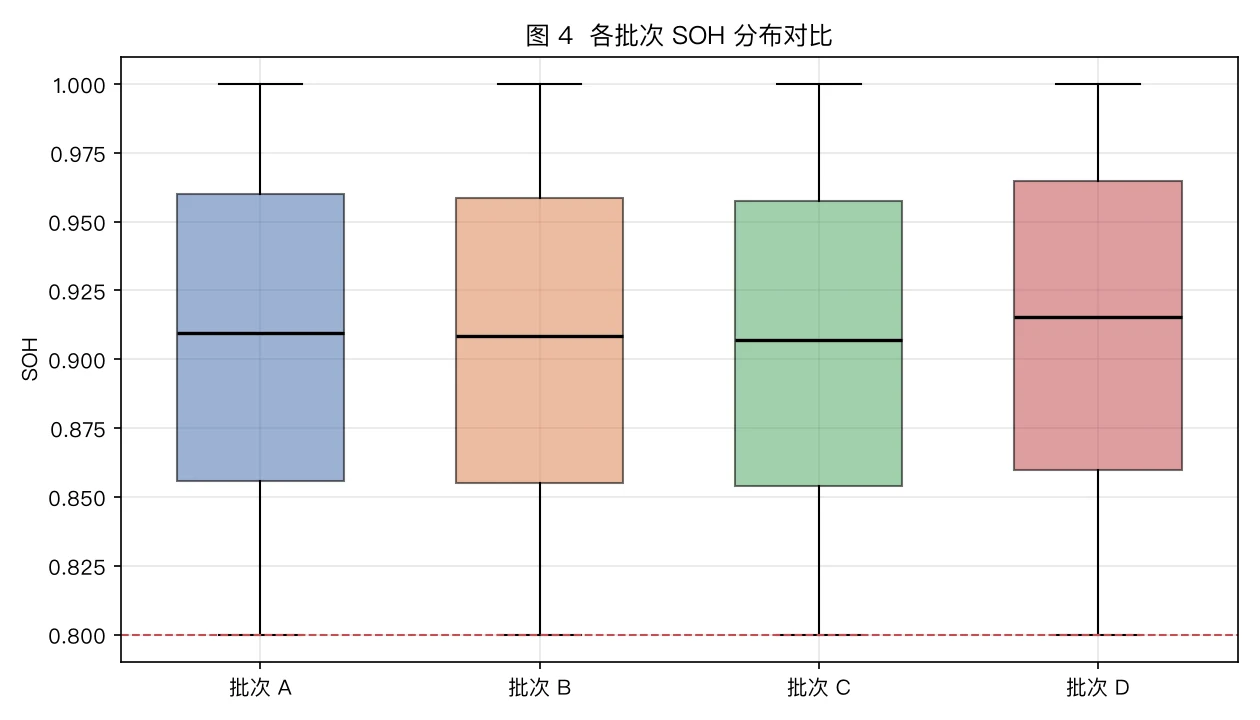
图 4 · 各批次 SOH 分布
★ 这一章要做的事,就是让上面这些东西"一条命令产出"。
39.2 犯过的错:把所有东西塞进一个 main()
如果你现在动手写,最自然的写法可能是这样:
点开:看一个"能用但不可维护"的版本
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
from pathlib import Path

# 读数据
df = pd.read_csv("data/battery/dirty.csv")

# 清洗
df = df.sort_values(["cell_id", "cycle"])
NUM = ["capacity_ah", "soh", "resistance_mohm", "temp_rise_c", "coulombic_eff"]
df[NUM] = df.groupby("cell_id")[NUM].transform(
    lambda g: g.interpolate(limit_direction="both"))

# 算各种统计量
n_rows = len(df)
n_cells = df["cell_id"].nunique()
soh_first = df.groupby("cycle")["soh"].mean().iloc[0]
soh_last = df.groupby("cycle")["soh"].mean().iloc[-1]
r_soh_r = df["soh"].corr(df["resistance_mohm"])
corr = df.select_dtypes("number").corr()

# 画图 1
fig, ax = plt.subplots(figsize=(10, 5))
ax.plot(df.groupby("cycle")["soh"].mean(), color="#4C72B0")
ax.set_xlabel("循环次数 (次)")
ax.set_ylabel("SOH")
ax.set_title("图 1  全批 SOH 衰减曲线")
fig.savefig("outputs/fig1.png")

# 画图 2
fig, ax = plt.subplots(figsize=(8.6, 5.2))
ax.scatter(df["soh"], df["resistance_mohm"], s=5, alpha=0.45, linewidths=0)
# ... 20 行画图代码 ...
fig.savefig("outputs/fig2.png")

# 画图 3
# ... 30 行画图代码 ...
fig.savefig("outputs/fig3.png")

# 画图 4
# ... 25 行画图代码 ...
fig.savefig("outputs/fig4.png")

# 写报告(手工拼字符串,数字从上面的变量里拿)
report = f"""# 电池数据体检报告

全批平均 SOH 从 {soh_first:.4f} 降到 {soh_last:.4f}。
内阻与 SOH 的相关系数 r = {r_soh_r:+.4f}。
...
"""
Path("outputs/体检报告.md").write_text(report, encoding="utf-8")

print("完成")
大约 200 行,能跑,能产出全部东西。
但它有五个问题(每一个都会在真实项目里造成麻烦):
| # | 问题 | 后果 |
|---|---|---|
| ① | 变量都堆在全局 | 30 个变量混在一起,改一个不知道会影响谁 |
| ② | 每一段都假设"前面跑过了" | 想单独重画图 3?做不到 |
| ③ | 数字散落在各处 | 图里用的 r 和报告里写的 r 可能不是同一个 |
| ④ | 清洗逻辑无法复用 | 第 39 章的清洗和第 30 章示例是两份代码 |
| ⑤ | 没法测试 | 想验证"清洗对不对",只能看最终报告 |
★ 最危险的是第 ③ 个
# 画图 2 时用了"剔除异常后"的数据
ax.scatter(clean["soh"], clean["resistance_mohm"], ...)

# 但报告里写的是"未剔除"的相关系数
r_soh_r = df["soh"].corr(df["resistance_mohm"])     # ← 用了 df 而不是 clean!

# → 图上是 r = -0.94(干净数据),报告里写 r = -0.47(含异常)
# → 图和文字矛盾,而没人会发现
这正是本章要解决的问题。
39.3 正确的结构:四层职责
把代码按"职责"分成四层:
① load_and_clean  → 读 + 清洗,返回 (干净数据, 清洗日志)
        ↓
② fig_xxx         → 一个图一个函数,只画图 + 返回它算出的关键数字
        ↓
③ build_findings  → 所有要写进报告的数字,集中算一次
        ↓
④ write_report    → 只负责拼 Markdown,不做任何计算

main()            → 只做编排:依次调用上面四层
点开:这个分层解决了什么?
逐条解决 39.2 里的五个问题:
| # | 原问题 | 分层后 |
|---|---|---|
| ① | 变量堆在全局 | 每层的局部变量在函数内,只通过返回值传递 |
| ② | 无法单独重跑 | 想重画图 3 就单独调 fig_corr(df, path) |
| ③ | 数字散落 | 所有数字都来自 build_findings() 的返回值 |
| ④ | 清洗无法复用 | load_and_clean() 是独立函数,能被别的脚本 import |
| ⑤ | 没法测试 | 每层都能单独测:df, log = load_and_clean(path) |
★ 核心设计:让"数字"只有一个来源
def fig_corr(df, out_path) -> dict:
    corr = df.select_dtypes("number").corr()
    # ... 画图 ...
    return {
        "corr": corr,
        "top3": [...],
        "most_negative": (...),
}画图函数既画图,也把"它算出的关键数字"返回。
def build_findings(df, log, fade, scat, corr_info, box) -> dict:
    """所有要写进报告的数字,集中算一次。"""
    return {
        "n_rows": len(df),
        "fade": fade,              # ← 来自 fig_fade 的返回值
        "scat": scat,              # ← 来自 fig_resistance_vs_soh
        "corr": corr_info,         # ← 来自 fig_corr
        "box": box,                # ← 来自 fig_soh_by_batch
        ...
}def write_report(f, out_path):
# 只拼接,不计算
text = f"r = {f['scat']['r_soh_resistance']:+.4f}"这样"报告里的 r"和"图上标的 r"必然来自同一个变量 —— 不可能再出现图数矛盾。
★ 三条纪律(本章的核心)
① main() 里只有「调用」,没有「计算」
② 一个图 = 一个函数,函数只画图 + return 关键数字
③ 报告里每个数字都来自 build_findings(),绝不手写
39.4 第一层:load_and_clean
def load_and_clean(data_dir: Path) -> tuple:
    """读 dirty.csv,做「物理规则 + 统计规则」双保险清洗,并返回清洗日志。"""
    raw = pd.read_csv(data_dir / "dirty.csv")
    log = {"输入": "dirty.csv", "原始行数": len(raw)}

    df = raw.sort_values(["cell_id", "cycle"]).copy()

    # ① 先记录脏在哪(这一步不能省,报告要写)
    log["缺失格数"] = int(df[NUM].isna().sum().sum())
    log["容量为负条数"] = int((df["capacity_ah"] < 0).sum())

    # ② 物理规则:容量为负 → 置为缺失,交给插值(比直接删行温和)
    df.loc[df["capacity_ah"] < 0, "capacity_ah"] = np.nan
    log["负容量处置"] = "置为缺失后按电芯插值"

    # ③ 统计规则:内阻用 IQR 上须标记(不删,只标记)
    x = df["resistance_mohm"]
    q1, q3 = x.quantile(0.25), x.quantile(0.75)
    r_hi = q3 + 1.5 * (q3 - q1)
    df["is_outlier"] = df["resistance_mohm"] > r_hi
    log["内阻 IQR 上须"] = round(r_hi, 3)
    log["内阻越界条数"] = int(df["is_outlier"].sum())
    log["越界处置"] = "标记 is_outlier 列,主表保留(可回溯)"

    # ④ ★ 关键顺序:先把被污染的尖峰「置为缺失」,再做插值。
    df.loc[df["is_outlier"], "resistance_mohm"] = np.nan
    log["异常值处置细节"] = "标记后置为缺失,与其它缺失一并插值修复"

    # ⑤ 缺失值:排序后按电芯分组插值
    df[NUM] = df.groupby("cell_id")[NUM].transform(
        lambda g: g.interpolate(limit_direction="both"))
    log["插值方式"] = "sort_values(['cell_id','cycle']) 后 groupby('cell_id').interpolate(limit_direction='both')"
    log["清洗后剩余缺失"] = int(df[NUM].isna().sum().sum())
    log["清洗后行数"] = len(df)

    assert log["清洗后剩余缺失"] == 0, "还有残留缺失"
    assert log["清洗后行数"] == log["原始行数"], "行数变了"
    return df, log
★ 第 ④ 步是整个函数的关键
点开:为什么"先把尖峰置为缺失,再插值"?(这一步很容易做反)
两种顺序的对比:
# ❌ 顺序 A:先插值,再标记
df[NUM] = df.groupby("cell_id")[NUM].transform(
    lambda g: g.interpolate(limit_direction="both"))
df["is_outlier"] = df["resistance_mohm"] > r_hi # 插值完再标记问题:插值会把两个尖峰之间的邻居一起抬高。
原始:  ... 45.2  460.1  44.8  453.2  45.5 ...
                    ↑ 尖峰        ↑ 尖峰

先插值(如果中间有缺失):用 460.1 和 453.2 插出来的值 ≈ 456
                          → 一个"不存在的 456"进入了数据

再标记(r_hi = 92.03):460.1 和 453.2 会被标出来,
但那个插出来的 456 标记不到 —— 因为它已经被"洗白"了后果:异常被"摊开"成若干个看起来正常的值,检测不出来。
# ✅ 顺序 B:先标记,把尖峰置为缺失,再插值
df["is_outlier"] = df["resistance_mohm"] > r_hi        # ① 先标记
df.loc[df["is_outlier"], "resistance_mohm"] = np.nan    # ② 尖峰变缺失
df[NUM] = df.groupby("cell_id")[NUM].transform(...) # ③ 用"干净的邻居"插值这样:
尖峰 460.1 被置为 nan
    ↓
插值时用"它两侧的正常值"(比如 44.8 和 45.2)→ 插出 45.0
    ↓
✅ 合理!
★ 一般化的原则
"标记异常"和"修复异常"的顺序: 先标记(用原始数据),再修复(用干净的邻居)。
同类问题:
| 场景 | 错误顺序 | 正确顺序 |
|---|---|---|
| 异常值 + 插值 | 先插值再标记 | 先标记再插值 |
| 缺失值 + 标准化 | 先标准化再填缺失 | 先填缺失再标准化 |
| 异常值 + 统计量 | 用含异常的数据算阈值 | 用清洗后的数据算统计量 |
第二行的道理:缺失值会污染均值和标准差(第 22 章), 所以要先处理缺失,再算统计量做标准化。
★ 一个自检方法
# 检查"标记的异常"和"清洗后的数据"是否一致
hits_before = int((raw["resistance_mohm"] > r_hi).sum())
hits_after = int((df["resistance_mohm"] > r_hi).sum())
print(f"清洗前内阻超上须 {hits_before} 条,清洗后 {hits_after} 条")
# 应该:清洗后 = 0(因为都插值修复了)
assert hits_after == 0
这个断言能抓住"顺序做反"的问题。
39.5 第二层:一图一函数
def fig_fade(df, out_path) -> dict:
    """图 1:容量衰减曲线(全批均值 + 分位带)。"""
    pivot = df.pivot_table(index="cycle", columns="cell_id", values="soh")
    mean_curve = pivot.mean(axis=1)
    q25, q75 = pivot.quantile(0.25, axis=1), pivot.quantile(0.75, axis=1)
    band = q75 - q25

    fig, ax = plt.subplots(figsize=(10, 5))
    ax.fill_between(mean_curve.index, q25, q75, alpha=0.22,
                    color=PALETTE[0], label="25%~75% 分位带")
    ax.plot(mean_curve.index, mean_curve, color=PALETTE[0], lw=2.0, label="全批均值")
    ax.axhline(0.85, color=PALETTE[1], ls="--", lw=1.0, label="预警线 0.85")
    ax.axhline(EOL_SOH, color=PALETTE[3], ls="--", lw=1.0, label="退役线 0.80")
    ax.set_xlabel("循环次数 (次)")
    ax.set_ylabel("SOH")
    ax.set_title("图 1  全批 SOH 衰减曲线")
    ax.legend(loc="lower left", fontsize=9)
    save_fig(fig, str(out_path))

    return {
        "soh_first": float(mean_curve.iloc[0]),
        "soh_last": float(mean_curve.iloc[-1]),
        "cycle_max": int(mean_curve.index[-1]),
        "fade_pct": float((mean_curve.iloc[0] - mean_curve.iloc[-1]) * 100),
        "band_mean": float(band.mean()),
        "band_max": float(band.max()),
    }
★ 注意两个设计细节
① 函数签名统一:(df, out_path) -> dict
def fig_fade(df, out_path) -> dict: ...
def fig_resistance_vs_soh(df, out_path) -> dict: ...
def fig_corr(df, out_path) -> dict: ...
def fig_soh_by_batch(df, out_path) -> dict: ...
四个画图函数的签名完全一样 —— 这样 main() 里调用它们的形式也一样,读起来很整齐。
② 返回值是"这张图算出的关键数字"
return {
    "soh_first": ...,       # 起点
    "soh_last": ...,        # 终点
    "fade_pct": ...,        # 总衰减百分比
    "band_mean": ...,       # 分位带平均宽度
}
报告里凡是要引用"图 1 说了什么",都从这里取。
图 2 的特殊处理:清洗前后对比
def fig_resistance_vs_soh(df, out_path) -> dict:
    """图 2:内阻 vs SOH 散点,返回清洗前后的相关系数。

    ★ 这个函数是全书最重要的「方法学对照」:
      左图 = 只处理了缺失、忽略异常尖峰 → r 被 68 个极端值拖到 -0.47;
      右图 = 把异常尖峰一并按缺失修复 → r 回到 -0.94 的真实关系。
      同一份数据、同一个相关系数公式,一次清洗决策就让结论完全相反。
    """
    clean = df.loc[~df["is_outlier"]]
    r_all = float(df["soh"].corr(df["resistance_mohm"]))
    r = float(clean["soh"].corr(clean["resistance_mohm"]))

    fig, axes = plt.subplots(1, 2, figsize=(13.5, 5.0))
    # 左图:清洗前(含极端值)
    axes[0].scatter(df["soh"], df["resistance_mohm"], s=5, alpha=0.4,
                    linewidths=0, color=PALETTE[3])
    axes[0].set_title(f"清洗前:含 {int(df['is_outlier'].sum())} 个极端内阻\nr = {r_all:+.3f}(被带偏)",
                      fontsize=11)
    # 右图:清洗后
    sc = axes[1].scatter(clean["soh"], clean["resistance_mohm"], c=clean["cycle"],
                         cmap="viridis", s=5, alpha=0.45, linewidths=0)
    cb = fig.colorbar(sc, ax=axes[1])
    cb.set_label("循环次数 (次)")
    axes[1].set_title(f"清洗后:排除异常点\nr = {r:+.3f}(真实关系)", fontsize=11)
    save_fig(fig, str(out_path))
    return {"r_soh_resistance": r, "r_before_clean": r_all,
"n_outliers": int(df["is_outlier"].sum())}真实输出:
[4/5] 图 2/3/4 完成:r(SOH, 内阻) = -0.9397,与 SOH 最强 = capacity_ah★ 这个"左图 + 右图"的设计值得学
它把"方法学决策的影响"可视化了:
左图:r = -0.467(只修缺失,忽略异常)
右图:r = -0.940(把异常也按缺失修复)

同一个公式、同一份数据 → 结论从"弱负相关"变成"强负相关"
这比"写一段文字解释为什么清洗很重要"有说服力得多。
★ 一般化的技巧:把"对照实验"画进图里
| 场景 | 对照设计 |
|---|---|
| 清洗前后 | 左:含异常 / 右:排除异常 |
| 特征工程前后 | 左:原始特征 / 右:加了新特征 |
| 两种插值方法 | 左:整表插值 / 右:分组插值 |
| 模型对比 | 左:基线模型 / 右:改进模型 |
汇报时一张对照图胜过一千字说明。
39.6 第三层:build_findings
def build_findings(df, log, fade, scat, corr_info, box) -> dict:
    """把报告需要的所有数字集中算好 —— 报告只负责「拼」,不负责「算」。"""
    per_cell = df.groupby("cell_id").agg(
        n_cycles=("cycle", "max"),
        soh_mean=("soh", "mean"),
    )
    per_cell["r_max"] = (df.loc[~df["is_outlier"]]
                           .groupby("cell_id")["resistance_mohm"].max())
    per_cell["n_cycles"] = per_cell["n_cycles"].astype(int)

    health = np.select(
        [df["soh"] < 0.85, df["soh"] < 0.90], ["待退役", "预警"], default="健康")
    health_counts = pd.Series(health).value_counts()

    return {
        "n_rows": len(df),
        "n_cells": int(df["cell_id"].nunique()),
        "batches": sorted(df["batch"].unique()),
        "cycle_range": (int(df["cycle"].min()), int(df["cycle"].max())),
        "fade": fade,           # ← 图 1 的返回值
        "scat": scat,           # ← 图 2 的返回值
        "corr": corr_info,      # ← 图 3 的返回值
        "box": box,             # ← 图 4 的返回值
        "log": log,             # ← load_and_clean 的返回值
        "per_cell": per_cell,
        "worst_cell": per_cell["soh_mean"].idxmin(),
        "worst_soh_mean": float(per_cell["soh_mean"].min()),
        "best_cell": per_cell["soh_mean"].idxmax(),
        "best_soh_mean": float(per_cell["soh_mean"].max()),
        "life_range": (int(per_cell["n_cycles"].min()), int(per_cell["n_cycles"].max())),
        "health_counts": {k: int(v) for k, v in health_counts.items()},
        "health_pct": {k: float(v / len(df)) for k, v in health_counts.items()},
    }
★ 这个函数的三条设计原则
① 它接收前面各层的返回值,而不是重新计算。
def build_findings(df, log, fade, scat, corr_info, box):
#                    ↑     ↑    ↑     ↑      ↑        ↑
#                  数据  日志  图1   图2    图3      图4
"图 2 算出的 r" 直接传进来,不再重算 —— 保证报告里的 r 和图上标的 r 是同一个数字。
② 它内部算的东西,是"报告需要但还没算过的"。
比如:
per_cell = df.groupby("cell_id").agg(...)      # 每支电芯的汇总
health = np.select([...], [...])                # 健康分档
这些数字不属于任何一张图,但报告要用。
③ 它返回一个扁平的字典。
为什么扁平:报告拼接时用 f["fade"]["soh_first"] 这样的路径访问, 扁平结构让"数据来自哪里"一目了然。
★ 一个细节:r_max 为什么要排除异常行
per_cell["r_max"] = (df.loc[~df["is_outlier"]]
.groupby("cell_id")["resistance_mohm"].max())如果不排除:
# 错:内阻的最大值会被"注入的尖峰"占据
per_cell["r_max"] = df.groupby("cell_id")["resistance_mohm"].max()
# → C006 的 r_max 变成 494.52 mΩ(一个注入的异常值)
# → 报告里的"最大内阻"变成一堆无意义的 400+排除后:
C011  r_max = 67.62
C006  r_max = 82.54     ← 合理的值
C005  r_max = 79.34
这就是"清洗决策要贯穿到每一个下游指标" —— 不能只在图里排除异常,然后统计量里又用上了。
★ 一般化:
一旦你决定了"哪些数据不可信", 所有下游的统计量都必须一致地应用这个决定。
这条纪律在真实项目里经常被违反(图里排除了异常,表里没排除), 导致报告自相矛盾。
39.7 第四层:write_report
def write_report(f, out_path) -> None:
"""拼装 Markdown 报告。这里只做字符串拼接,不做任何计算。"""
fade, scat, corr, box = f["fade"], f["scat"], f["corr"], f["box"]
top3 = "\n".join(f"| `{k}` | {v:+.4f} | {'同向' if v > 0 else '反向'} |"
for k, v in corr["top3"])
# ... 其他行的拼接 ...
text = f"""# 某批次电池数据体检报告
## 三、核心发现
### 发现 2 · 内阻与 SOH 强负相关,但「一次清洗决策」就能让结论完全相反

| 口径 | r(SOH, 内阻) | 说明 |
|---|---|---|
| 只修缺失、**忽略**异常尖峰 | **{scat['r_before_clean']:+.4f}** | 被 {scat['n_outliers']} 个极端内阻严重带偏 |
| 把异常尖峰也按缺失修复 | **{scat['r_soh_resistance']:+.4f}** | 与真实物理关系一致 |
- 仅仅 {scat['n_outliers']} 个异常点(占 {scat['n_outliers'] / f['n_rows']:.2%})
就让相关系数从 {scat['r_soh_resistance']:+.3f} 变成 {scat['r_before_clean']:+.3f}。
...
"""
out_path.write_text(text, encoding="utf-8")真实产出的报告(节选):
点开:看 report 的实际内容(这是最终交付物)
# 某批次电池数据体检报告
> 本报告由 `demos/ch39-report.py` 自动生成,所有数字均由脚本计算。
> 数据为**合成教学数据**(固定随机种子),不代表任何真实产线。
## 一、数据概况
| 项 | 值 |
|---|---|
| 记录数 | 13,967 行 |
| 电芯数 | 12 支 |
| 批次 | A、B、C、D |
| 循环次数范围 | 1 ~ 1423 次 |
| 单支寿命范围 | 859 ~ 1423 次循环 |
## 二、数据清洗日志
| 项 | 值 |
|---|---|
| 输入 | dirty.csv |
| 原始行数 | 13967 |
| 缺失格数 | 279 |
| 容量为负条数 | 70 |
| 负容量处置 | 置为缺失后按电芯插值 |
| 内阻 IQR 上须 | 92.03 |
| 内阻越界条数 | 68 |
| 越界处置 | 标记 is_outlier 列,主表保留(可回溯) |
| 异常值处置细节 | 标记后置为缺失,与其它缺失一并插值修复 |
| 插值方式 | sort_values(['cell_id','cycle']) 后 groupby('cell_id').interpolate(limit_direction='both') |
| 清洗后剩余缺失 | 0 |
| 清洗后行数 | 13967 |
**清洗结论**:13,967 行数据中,发现缺失 279 格、
容量为负 70 条、内阻越界 68 条。
负容量按「置为缺失 → 按电芯分组插值」修复;内阻越界只做标记不做删除,保留可追溯性。
## 三、核心发现
### 发现 1 · 容量衰减呈「加速下降」形态

- 全批平均 SOH 从 **0.9999** 降到 **0.8000**(共 1423 次循环);
- 总衰减 **19.99 个百分点**,且**后期明显变陡**(膝点效应);
- 一致性证据:25%~75% 分位带平均宽度仅 **0.0294**(最大 0.0534),
说明 12 支电芯的衰减轨迹高度一致 —— 这是"工艺稳定"的正向证据。
### 发现 2 · 内阻与 SOH 强负相关,但「一次清洗决策」就能让结论完全相反

| 口径 | r(SOH, 内阻) | 说明 |
|---|---|---|
| 只修缺失、**忽略**异常尖峰 | **-0.4668** | 被 68 个极端内阻严重带偏,几乎"抹平"了关系 |
| 把异常尖峰也按缺失修复 | **-0.9397** | 与真实物理关系一致(干净数据实测 -0.9397) |
- **这是全书最值得记住的一组对比**:仅仅 68 个异常点
(占 0.49%)就让相关系数从 -0.940 变成 -0.467,结论从"强负相关"变成"弱负相关";
- 物理含义:SOH 下降的同时内阻系统性上升,两者是同一老化过程的两条侧面;
- **方法学教训**:相关系数是「对极端值极其敏感」的统计量。
算出 r 之后一定要看一眼散点图,确认没有几个孤立的点把结果拉偏了。
### 发现 3 · 与 SOH 相关性最强的三个特征,以及一个必须剔除的泄漏列

| 特征 | r | 方向 |
|---|---|---|
| `capacity_ah` | +0.9981 | 同向 |
| `temp_rise_c` | -0.9957 | 反向 |
| `coulombic_eff` | +0.9849 | 同向 |
- **`capacity_ah` 不能当特征**:SOH 的定义就是「容量 / 额定容量」,
它与 SOH 的 r = +0.9981,等于把答案抄进试卷(特征泄漏);
- 最强反向相关:`temp_rise_c`(r = -0.9957);
- 多重共线性提醒:`capacity_ah` / `temp_rise_c` / `coulombic_eff` 三者互相也在 0.98 以上,
做线性模型时只保留其中一个。
### 发现 4 · 四个批次之间没有明显差异

| 批次 | 样本数 | SOH 中位数 | IQR |
|---|---|---|---|
| 批次 A | 3,331 | 0.9095 | 0.1043 |
| 批次 B | 4,157 | 0.9085 | 0.1036 |
| 批次 C | 3,304 | 0.9069 | 0.1035 |
| 批次 D | 3,175 | 0.9154 | 0.1048 |
- 四批 SOH 中位数差距仅 0.0085,箱体高度(IQR)差距仅 0.0013;
- **结论:批次间无显著差异。** 内阻/SOH 的离散主要来自批内个体差异,而非批次工艺差异;
- 建议:若要继续追查一致性,应关注落在须外的单支电芯,而不是批次均值。
## 四、全批健康状态分布
| 状态 | 记录数 | 占比 |
|---|---|---|
| 健康 | 7,642 | 54.7% |
| 预警 | 3,214 | 23.0% |
| 待退役 | 3,111 | 22.3% |
按记录数统计(同一支电芯在不同循环阶段会落在不同档位):
**健康 54.7% / 预警 23.0% / 待退役 22.3%**。
- 「待退役」和「预警」合计接近一半,是因为**数据在设计上要求"退化到 SOH=0.80 才停止采样"** ——
每一支电芯的生命末尾都必然落在低 SOH 区间,这部分记录被完整保留了下来;
- 真实产线的分布会完全不同(大多数电芯处于寿命前中期,低 SOH 记录稀少);
- **所以这里的比例不能拿去和真实产线对比**,它的意义是"验证分档逻辑跑通了"。
## 五、单体电芯排名(按全周期平均 SOH)
| 电芯 | 循环数 | 平均 SOH | 最大内阻 (mΩ) |
|---|---|---|---|
| C011 | 1,030 | 0.8918 | 67.62 |
| C006 | 1,392 | 0.8956 | 82.54 |
| C005 | 1,323 | 0.8957 | 79.34 |
| C004 | 1,153 | 0.9040 | 70.86 |
| C001 | 862 | 0.9069 | 86.00 |
- 表现最弱:**C011**(平均 SOH 0.8918);
- 表现最好:**C009**(平均 SOH 0.9199);
- ⚠ **解读警告**:平均 SOH 高低受「寿命长短」影响 —— 跑得久的电芯平均 SOH 天然更低。
要评价"质量",应结合「用了多少圈才到 0.80」一起看。
## 六、方法学说明与局限
- **数据性质**:合成教学数据(**非真实产线数据**);单调退化、无随机跳水、
无工况切换、无传感器漂移。
- **可复现性**:数据固定不变(校验和见 `data/battery/README.md`),
同一份代码重复运行结果逐字节一致。
- **方法可迁移,结论不可直接上线**:真实产线数据必须重新采集、重新标定阈值
(尤其是内阻 IQR 上须 92.03 mΩ 这个数字)。
- **报告纪律**:本报告每个数字都来自 `build_findings()`,不存在手写数字。
数据一换,重跑即可,不会出现"图变了但结论没变"的情况。39.8 main():只编排,不计算
def main() -> int:
    OUT_DIR.mkdir(exist_ok=True)
    font = setup_style()
    print(f"[1/5] 样式就绪(中文字体:{font})")

    df, log = load_and_clean(DATA_DIR)
    print(f"[2/5] 清洗完成:{log['原始行数']:,d} 行 → 缺失 {log['清洗后剩余缺失']} 格,"
          f"标记异常 {log['内阻越界条数']:,d} 条")

    fade = fig_fade(df, OUT_DIR / "ch39_fade.png")
    print(f"[3/5] 图 1 完成:SOH {fade['soh_first']:.4f} → {fade['soh_last']:.4f}")

    scat = fig_resistance_vs_soh(df, OUT_DIR / "ch39_resistance_vs_soh.png")
    corr_info = fig_corr(df, OUT_DIR / "ch39_corr_heatmap.png")
    box = fig_soh_by_batch(df, OUT_DIR / "ch39_soh_by_batch.png")
    print(f"[4/5] 图 2/3/4 完成:r(SOH, 内阻) = {scat['r_soh_resistance']:+.4f},"
          f"与 SOH 最强 = {corr_info['top3'][0][0]}")

    findings = build_findings(df, log, fade, scat, corr_info, box)
    report_path = OUT_DIR / "体检报告.md"
    write_report(findings, report_path)
    print(f"[5/5] 报告已写出:{report_path}")

    clean_path = OUT_DIR / "cycle_clean.csv"
    df.to_csv(clean_path, index=False)
    print(f"      清洗后数据已写出:{clean_path}({len(df):,d} 行 × {df.shape[1]} 列)")
    return 0
点开:为什么 main() 要"短"?
看它做的事:
df, log = load_and_clean(DATA_DIR)                 # 调用
fade = fig_fade(df, ...)                            # 调用
scat = fig_resistance_vs_soh(df, ...)               # 调用
corr_info = fig_corr(df, ...)                       # 调用
box = fig_soh_by_batch(df, ...)                     # 调用
findings = build_findings(df, log, fade, scat, corr_info, box)   # 调用
write_report(findings, report_path)                 # 调用
df.to_csv(clean_path, index=False)                  # 调用
全是调用,没有一行计算。
好处:
① 一眼看出整个流程。
读+清洗 → 画4张图 → 汇总数字 → 写报告 → 落盘七个步骤,一目了然。
② 想跳过某一步(调试时)只要注释一行。
# corr_info = fig_corr(df, ...) ← 调试时先跳过图 3③ 想换顺序、加步骤都容易。
# 加一个新的图(图 5)
heat = fig_temp_heatmap(df, OUT_DIR / "ch39_temp_heatmap.png")
findings = build_findings(df, log, fade, scat, corr_info, box, heat)
④ 进度提示自然嵌入。
print(f"[3/5] 图 1 完成:SOH {fade['soh_first']:.4f} → {fade['soh_last']:.4f}")[3/5] 让用户知道跑到哪了 —— 对耗时的脚本很重要。
★ 对照:如果 main() 里塞了计算
# ❌ 反面教材
def main():
    df = pd.read_csv("dirty.csv")
    df = df.sort_values(["cell_id", "cycle"])
    NUM = [...]
    df[NUM] = df.groupby("cell_id")[NUM].transform(...)     # 清洗逻辑
    ...
    fig, ax = plt.subplots()                                # 画图逻辑
    ...
    n_rows = len(df)                                        # 算统计量
    ...
text = f"..." # 拼报告问题:
- 60 行混在一起,看不出流程;
- 想跳过画图只测清洗?做不到;
- 出错时不知道是"清洗错了"还是"画图错了"。
★ 一句经验
如果一个函数超过 30 行,就该问问"它能不能拆"。
main() 是"编排者",不是"执行者" —— 它应该像一份目录,而不是一章正文。
39.9 验收标准
本章的产物应该满足这四条:
① 一条命令跑完,outputs/ 下出现 4 张 PNG + 报告 + 干净数据
② 报告里每一个结论都能追到某张图或某个统计量
③ 图上中文正常显示、坐标轴有单位
④ 换一份同格式数据只需改 DATA_DIR 一行就能重跑
点开:逐条解读这四条标准(它们也是"合格报告"的标准)
① 一条命令跑完
cd code
python demos/ch39-report.py为什么这是标准:
如果需要"先跑 A 再跑 B 然后手动改 C",
那这份报告就不能被复现 —— 别人拿到你的代码跑不出来。
★ 换数据只改一处:
DATA_DIR = CODE_DIR / "data" / "battery" # ← 只有这一行需要改为什么强调"只改一行":如果路径散落在十个地方, 换数据时漏改一处就会出错(而且可能不报错,只是读错了文件)。
② 每个结论都能追到某个统计量
"好结论" vs "坏结论":
| 坏结论 | 好结论 |
|---|---|
| "这批电池衰减挺快的" | "全批平均 SOH 从 0.9999 降到 0.8000,用了 859~1423 次循环(图 1)" |
| "数据质量还行" | "13,967 行中发现缺失 279 格、容量为负 70 条、内阻越界 68 条(清洗日志)" |
| "内阻和容量有关系" | "内阻与 SOH 的 r = -0.94(剔除 68 个异常点后;剔除前 -0.47,见图 2)" |
| "批次之间差不多" | "四批 SOH 中位数极差 0.0085、IQR 极差 0.0013(图 4)" |
判据:
能把结论里的每个数字,指到"某个函数的某个返回值"吗?
能 → 合格。不能 → 那个数字是"感觉",不是"结论"。
③ 中文正常、坐标轴有单位
看起来琐碎,但它是"专业性"的第一道门槛。
| 检查 | 不合格的样子 |
|---|---|
| 中文 | SOH 衰减曲线 显示成 □□ □□ □□ |
| x 轴单位 | 循环次数 (没有"次") |
| y 轴单位 | 内阻 (没有"mΩ") |
| 参考线标注 | 画了 0.80 的线但没标"退役线" |
| 图例 | 有图例但看不出哪条线是哪支电芯 |
★ 一个自检清单
# 每张图都问一遍
CHECKS = [
    "中文显示正常吗?",
    "x 轴有标签和单位吗?",
    "y 轴有标签和单位吗?",
    "标题说明了这张图在讲什么吗?",
    "有图例吗?图例能看懂吗?",
    "有参考线吗?参考线标注了吗?",
    "颜色对比够清楚吗?打印成黑白还能看吗?",
]
最后一条(黑白打印)经常被忽略 —— 很多报告会被打印出来,纯靠颜色区分的图在黑白下就废了。
修复:用线型(实线/虚线/点划线)而不是只用颜色区分。
④ 换数据只改一行
这一条检验的是"代码的通用性"。
反例:
# ❌ 硬编码
df = pd.read_csv("/Users/jini/Projects/.../dirty.csv")
soh_first = 0.9999                              # 手写的数字!
if len(df) == 13967:                            # 硬编码行数
    ...
threshold = 92.03 # 硬编码阈值(应该从数据算)正例:
# ✅ 全部从数据推导
DATA_DIR = CODE_DIR / "data" / "battery"        # 唯一的"配置"
r_hi = q3 + 1.5 * (q3 - q1)                     # 阈值从数据算
soh_first = float(mean_curve.iloc[0])           # 统计量从数据算
★ 怎么检验"只改一行"
# 复制数据到新目录,改 DATA_DIR,重跑
cp -r data/battery data/battery_v2
# 修改 DATA_DIR 指向 battery_v2
python demos/ch39-report.py
# 报告里的所有数字应该都跟着变
如果某处数字没变 → 那里有硬编码。
★ 这条标准的价值
"通用性"不是"为了以后可能用",而是"为了证明你的流程是对的"。
如果一个脚本只能跑一份特定的数据, 那它的逻辑里必然混着"这份数据的特例" —— 而那些特例就是 bug 的来源。
39.10 你可以继续做的事
这一章完成了"从 CSV 到报告"的闭环。往下走有四个方向:
方向一:把清洗逻辑抽成可复用模块
当前状态:load_and_clean 在 ch39-report.py 里。
改进:抽到 src/clean.py,让别的脚本也能用。
# src/clean.py
def clean_missing(df, num_cols, group_col="cell_id", order_col="cycle"):
    ...

def clean_outliers(df, col, k=1.5):
    ...

def load_and_clean(data_dir, config):
...# 任何脚本都能用
from src.clean import load_and_clean
df, log = load_and_clean(DATA_DIR, CONFIG)收益:第 30 章的示例、第 39 章的报告、将来的建模脚本共用一套清洗逻辑。
这消除了"两份清洗代码不一致"的风险(39.2 的第 ④ 个问题)。
方向二:把配置抽出来
当前状态:阈值、列名、路径散在代码里。
改进:用一个配置字典(或 YAML 文件)。
CONFIG = {
    "data_dir": "data/battery",
    "num_cols": ["capacity_ah", "soh", "resistance_mohm", "temp_rise_c", "coulombic_eff"],
    "group_col": "cell_id",
    "order_col": "cycle",
    "rated_cap": 2.5,
    "eol_soh": 0.80,
    "warn_soh": 0.85,
    "outlier": {"method": "iqr", "k": 1.5},
    "physical_rules": {
        "capacity_ah": (0.0, 3.0),
        "soh": (0.0, 1.05),
        "resistance_mohm": (10.0, 200.0),
        "temp_rise_c": (0.0, 60.0),
    },
}收益:
- 换数据/换阈值只改配置,不动代码;
- 配置可以存成 YAML,非程序员也能改;
- 多个数据集共用一套代码。
# 用 YAML 的话
import yaml
with open("config.yaml") as f:
    CONFIG = yaml.safe_load(f)
方向三:加自动化测试
当前状态:验证靠"看输出对不对"。
改进:写测试,让机器帮你验证。
# tests/test_clean.py
import pandas as pd
import pytest
from src.clean import clean_missing


def test_no_missing_after_clean():
    """清洗后不应该有残留缺失。"""
    df = pd.DataFrame({
        "cell_id": ["C001"] * 3,
        "cycle": [1, 2, 3],
        "capacity_ah": [2.5, None, 2.4],
    })
    out = clean_missing(df, ["capacity_ah"])
    assert out["capacity_ah"].isna().sum() == 0


def test_row_count_unchanged():
    """清洗不应该改变行数。"""
    df = pd.DataFrame({
        "cell_id": ["C001"] * 3,
        "cycle": [1, 2, 3],
        "capacity_ah": [2.5, None, 2.4],
    })
    out = clean_missing(df, ["capacity_ah"])
    assert len(out) == len(df)


def test_boundary_missing_uses_same_cell():
    """边界缺失应该用同一支电芯的邻居插值。"""
    df = pd.DataFrame({
        "cell_id": ["C001", "C001", "C002", "C002"],
        "cycle": [1, 2, 1, 2],
        "capacity_ah": [1.9, 1.95, None, 2.50],      # C002 首圈缺失
    })
    out = clean_missing(df, ["capacity_ah"])
    # C002 首圈应该接近 2.50(同组邻居),而不是 1.95(C001 末圈)
    filled = out.loc[(out["cell_id"] == "C002") & (out["cycle"] == 1), "capacity_ah"].iloc[0]
    assert filled > 2.0, f"被跨组污染了:{filled}"
第三个测试最有价值 —— 它就是第 30 章那个坑的回归测试。
收益:以后重构清洗逻辑时,机器能立刻告诉你"有没有破坏原有行为"。
运行:
pip install pytest
pytest tests/ -v
方向四:接入建模(这本书的下一步)
当前状态:产出了干净数据和报告。
下一步:用这份数据训练模型。
# src/train.py
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import GroupKFold
from sklearn.metrics import mean_absolute_error

FEATURES = ["cycle", "resistance_mohm", "temp_rise_c", "coulombic_eff"]
TARGET = "soh"


def main():
    df = pd.read_csv("outputs/cycle_clean.csv")

    # ★ 按电芯分组切分(避免同一支电芯跨训练/测试)
    gkf = GroupKFold(n_splits=4)
    errors = []
    for tr_idx, te_idx in gkf.split(df, groups=df["cell_id"]):
        train, test = df.iloc[tr_idx], df.iloc[te_idx]
        model = LinearRegression().fit(train[FEATURES], train[TARGET])
        pred = model.predict(test[FEATURES])
        errors.append(mean_absolute_error(test[TARGET], pred))
    print(f"4 折交叉验证 MAE: {np.mean(errors):.5f} ± {np.std(errors):.5f}")
★ 三个必须注意的点
① 特征列表要排除泄漏列。
FEATURES = ["cycle", "resistance_mohm", "temp_rise_c", "coulombic_eff"]
#           ↑ 不含 capacity_ah(泄漏,第 37 章)
② 按电芯分组切分,不能随机切分。
# ❌ 随机切分 → 同一支电芯的相邻圈会同时出现在训练和测试集
train = df.sample(frac=0.8)

# ✅ GroupKFold → 保证同一支电芯不跨集
gkf = GroupKFold(n_splits=4)
③ 标准化要在训练集上 fit。
# ❌ 数据泄漏
X_test_s = StandardScaler().fit_transform(X_test)

# ✅ 只在训练集上 fit
scaler = StandardScaler().fit(X_train)
X_test_s = scaler.transform(X_test)
这三条都是前面章节讲过的"数据泄漏"的不同表现。
★ 这本书到这里结束了,但"数据分析"这件事刚刚开始
本书教的是:把 CSV 变成"我敢下判断的证据"
下一步是:  把证据变成"可预测的模型"

而它们共享同一套底层能力:
  · 看清数据(第 24 章)
  · 处理缺失与异常(第 30、34 章)
  · 识别泄漏(第 37 章)
  · 用分布而不是均值说话(第 38 章)
  · 把数字追溯到来源(本章)
本章练习
练习 1:跑通报告生成
- 运行
python demos/ch39-report.py,确认产出 6 个文件; - 打开
outputs/体检报告.md,找出"发现 2"里的两个相关系数,在报告里和图上分别核对; - 说出"清洗日志"里那一项
异常值处置细节为什么必须写。
参考答案
① 应该产出:
✅ ch39_fade.png                  110.9 KB
✅ ch39_resistance_vs_soh.png     514.3 KB
✅ ch39_corr_heatmap.png           79.1 KB
✅ ch39_soh_by_batch.png           35.7 KB
✅ 体检报告.md                      5.7 KB
✅ cycle_clean.csv                821.0 KB
② "发现 2"里的两个 r:
| 只修缺失、忽略异常尖峰 | **-0.4668** |
| 把异常尖峰也按缺失修复 | **-0.9397** |核对方法:
# 在报告里找 → -0.4668 / -0.9397
# 在图上找 → 左图标题 "r = -0.467",右图标题 "r = -0.940"
# 在代码里找 → scat["r_before_clean"] 和 scat["r_soh_resistance"]
三者一致,说明"数字只有一个来源"这个设计起作用了。
③ 为什么必须写 异常值处置细节
因为它记录了"一个关键的执行顺序"。
"标记后置为缺失,与其它缺失一并插值修复"如果只写"内阻越界 68 条,已标记",读者不知道:
- 这 68 个值后来被怎么处理了(留在表里?还是修复了?)
- 如果修复了,是"先标记再修复"还是"先修复再标记"?
后者会影响结果(39.4 详细讲了):
先插值再标记 → 插值会把尖峰"摊开",产生一批"看起来正常"的假值
先标记再插值 → 尖峰被置为缺失,用干净的邻居插值 → 结果合理
★ 这引出一条通用纪律
日志要记录"决策 + 执行顺序",而不只是"发现了什么"。
三类信息缺一不可:
| 类别 | 例子 |
|---|---|
| 发现了什么 | 缺失 279 格、容量为负 70 条、内阻越界 68 条 |
| 怎么决定的 | IQR k=1.5,上须 92.03 mΩ;负容量无合理夹取目标 |
| 怎么执行的 | 标记后置为缺失,按电芯分组插值(limit_direction='both') |
只有第一类 → 读者不知道结果怎么来的缺第三类 → 读者无法复现,也无法判断顺序对不对
练习 2:如果数据换了一份,需要改什么?
DATA_DIR = CODE_DIR / "data" / "battery"
EOL_SOH = 0.80
RATED_CAP = 2.5要求:说出"换一份同格式数据"需要改哪些行、 以及哪些东西不该硬编码。
参考答案
只需改一行:
DATA_DIR = CODE_DIR / "data" / "battery_v2" # ← 就这一处其他都应该从数据推导出来:
| 量 | ❌ 不该硬编码 | ✅ 应该怎么来 |
|---|---|---|
| 行数 | assert len(df) == 13967 | len(df) 或范围断言 |
| 电芯数 | n_cells = 12 | df["cell_id"].nunique() |
| IQR 上须 | r_hi = 92.03 | q3 + 1.5 * (q3 - q1) |
| SOH 首末 | soh_first = 0.9999 | float(mean_curve.iloc[0]) |
| 健康分档比例 | "54.7%" | f"{count / len(df):.1%}" |
| 寿命范围 | "859 ~ 1423" | per_cell["n_cycles"].min()/max() |
★ 但有两类"常量"是可以(也应该)硬编码的
① 物理常量 / 业务规则
RATED_CAP = 2.5        # 额定容量:这是产品规格,来自数据字典
EOL_SOH = 0.80         # 退役阈值:这是行业惯例/业务规定
WARN_SOH = 0.85 # 预警阈值为什么可以硬编码:它们不来自数据,而来自"业务定义"。
但要放在显眼的地方(文件顶部),并加注释说明来源:
# ── 业务常量(来自数据字典 / 行业惯例)──────────────────────
RATED_CAP = 2.5        # 额定容量(Ah),来自产品规格
EOL_SOH = 0.80         # 退役阈值,行业惯例
WARN_SOH = 0.85        # 预警阈值,本厂内部规定
② 列名
NUM = ["capacity_ah", "soh", "resistance_mohm", "temp_rise_c", "coulombic_eff"]
FEATURES = ["cycle", "resistance_mohm", "temp_rise_c", "coulombic_eff"]为什么可以硬编码:列名是数据接口的一部分。 如果列名变了,那就不是"同格式数据"了,代码本来就应该改。
但要加强校验:
missing = set(NUM + ["cell_id", "batch", "cycle"]) - set(df.columns)
if missing:
    raise ValueError(f"输入数据缺少必需的列: {missing}")
★ "换数据只改一行"怎么检验
# 复制数据、改路径、重跑,对比数字
cp -r data/battery /tmp/battery_v2
sed -i '' 's|data" / "battery"|data" / "battery_v2"|' demos/ch39-report.py
python demos/ch39-report.py
# 报告里的所有数字应该都跟着变
如果某处数字没变 → 那里有硬编码。
★ 一个实用的检查脚本
import re
from pathlib import Path


def find_hardcoded_numbers(script_path, ignore_small=True):
    """粗查脚本里的"魔数"(可能是硬编码的统计量)。"""
    text = Path(script_path).read_text(encoding="utf-8")
    # 找形如 0.9999 / 13967 / 92.03 这样的数字字面量
    candidates = re.findall(r"\b(\d+\.\d{3,}|\d{4,})\b", text)
    print(f"可疑的字面量:{sorted(set(candidates))}")
它能粗查出"0.9999"、"13967"这类不该出现的数字 —— 剩下的靠人判断(比如 1.5、0.80 是合理的业务常量)。
练习 3:为什么 main() 要"只编排不计算"?
def main():
    df, log = load_and_clean(DATA_DIR)
    fade = fig_fade(df, OUT_DIR / "ch39_fade.png")
    scat = fig_resistance_vs_soh(df, OUT_DIR / "ch39_resistance_vs_soh.png")
    corr_info = fig_corr(df, OUT_DIR / "ch39_corr_heatmap.png")
    box = fig_soh_by_batch(df, OUT_DIR / "ch39_soh_by_batch.png")
    findings = build_findings(df, log, fade, scat, corr_info, box)
write_report(findings, OUT_DIR / "体检报告.md")要求:说出这个"七行 main"相比"200 行 main"的三个好处, 并举一个"不这样写会出的问题"。
参考答案
三个好处:
① 一眼看出流程
读+清洗 → 图1 → 图2 → 图3 → 图4 → 汇总 → 写报告七行代码就是完整的流程图。 新人接手时看 main() 就知道这个脚本干什么。
② 能单独测试/重跑任何一步
# 只想重画图 3(改了个颜色)
df, log = load_and_clean(DATA_DIR)
corr_info = fig_corr(df, OUT_DIR / "ch39_corr_heatmap.png")

# 只想检查清洗结果
df, log = load_and_clean(DATA_DIR)
print(log)
如果是 200 行的 main,这些做不到 —— 必须从头跑到尾。
③ 加/删步骤容易
# 加一个新图
heat = fig_temp_heatmap(df, OUT_DIR / "ch39_temp_heatmap.png")
findings = build_findings(df, log, fade, scat, corr_info, box, heat)
★ 一个"不这样写会出的问题"(真实场景)
场景:报告上线两周后,业务方说"内阻的 IQR 上须是不是定得太松了?改成 k=1.2 重跑一份"。
200 行 main 的版本:
1. 打开脚本,找到"内阻上须"那几行(在 200 行里的某个位置)
2. 改成 k=1.2
3. 跑一遍
4. 发现报告里的数字变了,但不确定"是不是所有地方都跟着变了"
   (因为阈值是硬编码的常量,可能某个地方还写着 92.03)
5. 手动检查报告里的每个数字……
七行 main 的版本:
1. 打开 load_and_clean,改 k=1.5 为 k=1.2
2. 跑一遍
3. ✅ 报告里所有涉及 r_hi 的地方都来自 log["内阻 IQR 上须"],自动跟着变关键差异:"数字只有一个来源"让改动是"安全的"。
★ 一个更隐蔽的问题
问题不在"改起来麻烦",而在"改不干净"。
# 200 行版本里可能出现的:
r_hi = 92.03                              # ① 计算处(改这里)
...
print(f"内阻越界 {n} 条(阈值 {r_hi})")   # ② 用变量 ✅
...
ax.axhline(92.03, color="red")            # ③ ❌ 硬编码的!忘了改
...
text = f"...阈值 92.03 mΩ..." # ④ ❌ 硬编码的!忘了改结果:图上的线和报告里的文字用了不同的阈值 —— 而没有人会发现(两个数字都"看起来合理")。
★ 这就是本章的核心价值
本章教的不是"怎么画图"或"怎么清洗"(那些前面都学过了), 而是"怎么组织代码,让图、数字、结论永远一致"。
三条纪律再重复一遍:
① main() 里只有「调用」,没有「计算」
② 一个图 = 一个函数,函数只画图 + return 关键数字
③ 报告里每个数字都来自 build_findings(),绝不手写
这三条看起来是"代码风格",实际上是"数据可信度"的保障。
面向 AI 开发:从"脚本"到"系统"
这一章的组织方式,就是 AI 项目里"数据管道"的雏形。
★ 一个真实的 AI 项目结构
project/
├── configs/
│   └── default.yaml              ← 配置(对应本章的 DATA_DIR / CONFIG)
├── src/
│   ├── data/
│   │   ├── load.py               ← 读取(对应 load_and_clean 的前半)
│   │   └── clean.py              ← 清洗(对应 load_and_clean 的后半)
│   ├── features/
│   │   └── build.py              ← 特征工程(对应派生列)
│   ├── models/
│   │   ├── train.py
│   │   └── predict.py
│   ├── viz/
│   │   └── plots.py              ← 图(对应 fig_xxx)
│   └── reports/
│       └── build.py              ← 报告(对应 build_findings + write_report)
├── pipelines/
│   └── run_all.py                ← 编排(对应 main)
├── tests/
├── data/{raw,interim,processed}/
└── outputs/{models,figures,reports}/
★ 三层对应关系
| 本章 | 真实项目 | 差异 |
|---|---|---|
load_and_clean | src/data/ | 拆成更多模块(不同数据源、不同清洗步骤) |
fig_xxx | src/viz/ | 更多图,可能用配置文件驱动 |
build_findings | src/reports/build.py | 更复杂的聚合 |
write_report | 同上 | 可能输出 HTML/PDF,或用模板引擎 |
main | pipelines/run_all.py | 可能用 Airflow / Prefect / Dagster 编排 |
★ 从"脚本"到"系统"的三个跃迁
跃迁一:配置化(Configuration)
脚本:  路径、阈值写死在代码里
系统: 路径、阈值放在 YAML / 环境变量为什么:同一个流程要跑多个数据集/多个环境(开发/测试/生产)。
# configs/dev.yaml
data_dir: data/battery
outlier_k: 1.5

# configs/prod.yaml
data_dir: /mnt/data/prod
outlier_k: 2.0        # 生产数据更脏,阈值更严
跃迁二:可测试(Testability)
脚本:  靠"看输出对不对"验证
系统: 靠 pytest 自动验证为什么:改一处代码,要能立刻知道"有没有破坏别的地方"。
跃迁三:可观测(Observability)
脚本:  出错就崩
系统: 记录日志、记录指标、出错时告警import logging
logger = logging.getLogger(__name__)
def load_and_clean(data_dir):
logger.info(f"读取数据: {data_dir}")
...
logger.info(f"清洗完成: {len(df)} 行,缺失 {log['缺失格数']} 格")
if log["内阻越界条数"] / len(df) > 0.05:
logger.warning(f"异常比例偏高: {log['内阻越界条数'] / len(df):.1%}")
return df, log为什么:生产环境里,你不知道哪一步慢、哪一步错。
★ 本章的"清洗日志"就是"可观测性"的第一步
log = {
    "原始行数": len(raw),
    "缺失格数": ...,
    "内阻越界条数": ...,
    ...
}
它记录了"这一步做了什么",这是日志的雏形。
★ 一个实用的建议
不要一上来就追求"完整的数据平台"。
正确的路径:
① 先写出"能跑"的脚本(第 03~38 章)
② 把脚本拆成函数(本章)
③ 把配置抽出来(方向二)
④ 加测试(方向三)
⑤ 加日志
⑥ 需要时再引入编排工具(Airflow 等)
每一步都"够用就好",不要跳过 ①② 直接上 ⑥。
一个真实的教训:
很多团队第一天上 Airflow,结果 pipeline 里跑的还是 一个 300 行的、没有测试的、硬编码的 Python 脚本。
工具不会让代码变好。先把代码写好,再考虑工具。
★ 最后:本章最想传达的一句话
"一条命令产出全部结果,且每个数字都能追溯" —— 这是数据工作的及格线,也是本章的全部内容。
它看起来朴素,但它区分了"做过分析"和"能交付分析"。
全书回顾
恭喜你走到这里。回头看看这 39 章。
点开:全书能力清单(自测一下)
已勾选 0 / 0 项
A · Python 基础(03~16)
B · NumPy(17~22)
C · Pandas(23~31)
D · 数据清洗(32~34)
E · 可视化(35~38)
F · 工程(39)
如果打勾超过 80%,你已经具备"独立完成一份数据分析"的能力。
剩下的 20%,是需要在真实项目里反复遇到、反复踩坑才能内化的 —— 那本书帮不了你,只有实践能。
这已经是最后一章。
回到最初的那句话:
把一堆 CSV 变成"我敢下判断的证据"。
你现在能做到这件事了。