第 37 章 · 热力图:字段之间的相关性
这一章要解决什么:用一张图看完全部字段两两之间的相关性。 本章最重要的产出不是图,而是两个判断:哪个特征是"泄漏"(必须剔除)、 哪些特征互相冗余(只留一个)。
本章你需要完成的代码:demos/ch37-heatmap.py
37.1 先只挑数值列(否则 corr 直接报错)
num = df.select_dtypes("number")
corr = num.corr()真实输出:
参与计算的列(6):['cycle', 'capacity_ah', 'soh', 'resistance_mohm', 'temp_rise_c', 'coulombic_eff']
被自动排除的列:['cell_id', 'batch', 'timestamp']为什么不挑列会报错:
df.corr()      # numeric_only=False(旧默认)
# ValueError: could not convert string to float: 'C001'原因:Pearson 相关系数需要数值。 cell_id(字符串)、batch(字符串)、timestamp(日期字符串)都算不了。
三种写法:
num = df.select_dtypes("number")                    # ✅ 推荐
num = df.select_dtypes(include=[np.number])         # 等价
df.corr(numeric_only=True)                          # ✅ 也行(Pandas 2.0+)
本书用 select_dtypes("number") —— 因为它把"挑出的列"存下来了, 后面还要用(画热力图需要列名)。
37.2 相关系数矩阵
print(corr.round(4))真实输出:
                  cycle  capacity_ah     soh  resistance_mohm  temp_rise_c  coulombic_eff
cycle            1.0000      -0.9325 -0.9347           0.9252       0.9312        -0.9481
capacity_ah     -0.9325       1.0000  0.9981          -0.9379      -0.9938         0.9830
soh             -0.9347       0.9981  1.0000          -0.9397      -0.9957         0.9849
resistance_mohm  0.9252      -0.9379 -0.9397           1.0000       0.9363        -0.9476
temp_rise_c      0.9312      -0.9938 -0.9957           0.9363       1.0000        -0.9806
coulombic_eff -0.9481 0.9830 0.9849 -0.9476 -0.9806 1.0000读这个矩阵的三个特点:
① 对角线全是 1.0000 —— 每一列和自己完全正相关(没信息量)。
② 矩阵是对称的 —— [i, j] 和 [j, i] 相等(一半是重复的)。
③ 值域是 [-1, 1] —— 正负号表示方向,绝对值表示强度。
37.3 找出与 SOH 相关性最强的是哪几个
soh_corr = corr["soh"].drop("soh")
ranked = soh_corr.sort_values(key=abs, ascending=False)真实输出:
  capacity_ah        0.9981
  temp_rise_c       -0.9957
  coulombic_eff      0.9849
  resistance_mohm   -0.9397
cycle -0.9347点开:为什么排序必须按绝对值?
如果直接 sort_values() 升序:
print(soh_corr.sort_values().head(3))
# temp_rise_c       -0.9957    ← 最强的负相关排最前
# resistance_mohm   -0.9397
# cycle             -0.9347

print(soh_corr.sort_values().tail(3))
# capacity_ah        0.9981    ← 最强的正相关排在最后
# ...问题:强负相关(-0.9957)和强正相关(+0.9981)同样强, 但排序把它们放在了两个极端。
读者看到 head() 的结果会以为"temp_rise_c 最相关", 看到 tail() 会以为"capacity_ah 最相关" —— 其实两个都对。
两种正确的写法:
# 写法一:key=abs(保留符号)
soh_corr.sort_values(key=abs, ascending=False)
# capacity_ah        0.9981
# temp_rise_c       -0.9957     ← 保留负号,读者知道是反向
# coulombic_eff      0.9849
# resistance_mohm   -0.9397
# cycle             -0.9347

# 写法二:先 abs 再排(丢掉符号)
soh_corr.abs().sort_values(ascending=False)
# capacity_ah        0.9981
# temp_rise_c        0.9957     ← 符号没了
# ...
推荐写法一 —— 因为它保留了"正相关还是负相关"这个信息。
★ 这个坑在书里出现过第二次
第 26 章讲 sort_values 时提过一次,这里是它的实际应用场景。
一般化的教训:
凡是"按大小排序",都要先问一句:"负数怎么办?"
同类场景:
| 场景 | 正确做法 |
|---|---|
| 相关系数排序 | key=abs |
| 误差排序(有正负) | key=abs |
| 变化率排序(涨跌) | key=abs 或分开排 |
| 完全是正数的量 | 直接排 |
37.4 ★★ 特征泄漏:capacity_ah 与 soh 的 r = 0.9981
这是本章最重要的一节。
print(f"r = {corr.loc['capacity_ah', 'soh']:+.4f}")r = +0.9981这两个数几乎完全重合 —— 因为 SOH 的定义就是「容量 / 额定容量」:
soh = capacity_ah / 2.5点开:如果 SOH 是标签,把 capacity_ah 当特征会发生什么?
后果
FEATURES = ["cycle", "capacity_ah", "resistance_mohm", "temp_rise_c"]
TARGET = "soh"

X = df[FEATURES].to_numpy()
y = df[TARGET].to_numpy()

from sklearn.linear_model import LinearRegression
model = LinearRegression().fit(X, y)
print(model.score(X, y))          # 0.9999 或更高 —— 完美!
看着很美好,实际上模型什么都没学到。
它只是发现了"当 capacity_ah 列的值是 2.30 时,答案是 0.92" (因为 2.30 / 2.5 = 0.92)。
上线时会立刻崩:因为线上根本拿不到 soh 这一列 —— 那正是要预测的东西。
这个错误的名字:特征泄漏(Data Leakage)
定义:训练时用到了"预测时刻不可能知道"的信息。
三种典型形式:
| 形式 | 例子 |
|---|---|
| 标签的"计算来源" | 用 capacity_ah 预测 soh(因为 SOH = 容量/额定) |
| 未来信息 | 用"整支电芯的全周期均值"预测"第 100 圈的 SOH" |
| 同期测量 | 预测"是否故障"时,用了"维修记录"当特征 |
识别特征泄漏的三条启发式
① 某个特征与标签的 |r| > 0.95 → 高度可疑,去查它的物理定义。
suspicious = soh_corr[soh_corr.abs() > 0.95]
print(suspicious)
# capacity_ah        0.9981    ← 查!原来是 SOH 的定义式
# temp_rise_c       -0.9957    ← 查!温升是"伴随现象",不是泄漏
# coulombic_eff 0.9849 ← 查!库仑效率是独立测量,不是泄漏注意:|r| > 0.95 只是提示你去查,不是"一定有泄漏"。
本数据里三个都超过 0.95,只有 capacity_ah 是泄漏。
② 问「这个特征在预测发生的那一刻,真的能拿到吗?」
预测"第 100 圈的 SOH"时:
  · cycle = 100             ✅ 能拿到
  · resistance_mohm(第100圈)✅ 能拿到
  · temp_rise_c(第100圈)  ✅ 能拿到
  · capacity_ah(第100圈)  ❌ 能拿到,但它就是 SOH 的来源!
  · cell_soh_mean(全周期) ❌ 不能拿到(用了第 100 圈之后的数据)
  · n_cycles_to_eol(寿命) ❌ 不能拿到(这是要预测的东西)
③ 问「这个特征是不是标签算出来的?」
# 查一下 SOH 的定义
print("SOH = capacity_ah / 2.5") # ← 是的,capacity_ah 是 SOH 的来源这三条问下来,capacity_ah 无处可逃。
但要注意:不是所有高相关都是泄漏
区分"泄漏"和"强信号":
| 特征 | r | 是泄漏吗 | 判断依据 |
|---|---|---|---|
capacity_ah | 0.9981 | ✅ 是 | 它就是 SOH 的定义式 |
temp_rise_c | -0.9957 | ❌ 不是 | 温升是独立测量的物理量,是"老化的伴随现象" |
coulombic_eff | 0.9849 | ❌ 不是 | 库仑效率是独立的电学测量 |
resistance_mohm | -0.9397 | ❌ 不是 | 内阻是独立测量 |
cycle | -0.9347 | ❌ 不是 | 循环次数是记录值 |
关键区别:
capacity_ah  → 是 SOH 的「计算来源」(SOH 由它算出来)
temp_rise_c → 是 SOH 的「伴随现象」(两者都随老化变化,但独立测量)判据:
问:"如果我把这个特征拿掉,标签还能算出来吗?" 如果"不能"(因为标签就是它算出来的)→ 泄漏。 如果"能"(标签有独立的测量来源)→ 不是泄漏。
★ 一个更微妙的例子
假设 SOH 不是从容量算的,而是用专门的 SOH 测试仪测的:
那么 capacity_ah 就不一定是泄漏了 ——
它和 SOH 的关系变成"两个独立的测量都反映同一个物理状态"。
但即使这样,把 capacity_ah 放进模型仍然有问题:
- 两者的 r = 0.998,属于多重共线性(下一节讲);
- 模型的系数会变得不稳定、难以解释。
所以"是不是泄漏"和"该不该用"是两个独立的问题。
37.5 找出所有"信息重复"的列对
tri = np.triu(np.ones(corr.shape), k=1).astype(bool)      # 上三角掩码(不含对角线)
pairs = corr.where(tri).stack()                            # 拉平成 (列A, 列B) -> r
dup = pairs[pairs.abs() > 0.95].sort_values(key=abs, ascending=False)真实输出:
信息重复的列对(|r| > 0.95,共 6 对):
capacity_ah      ↔ soh              0.998
soh              ↔ temp_rise_c     -0.996
capacity_ah      ↔ temp_rise_c     -0.994
soh              ↔ coulombic_eff    0.985
capacity_ah      ↔ coulombic_eff    0.983
temp_rise_c      ↔ coulombic_eff   -0.981
点开:上三角掩码 + stack 是怎么工作的?(这是个很实用的套路)
问题
相关系数矩阵是对称的:
           cycle  capacity_ah     soh
cycle     1.0000      -0.9325 -0.9347
capacity   -0.9325     1.0000  0.9981
soh        -0.9347     0.9981  1.0000
            ↑                      ↑
       (capacity, cycle) 和 (cycle, capacity) 是同一个信息
如果直接 stack() 拉平,会得到重复的列对:
(cycle, capacity_ah)   -0.9325
(capacity_ah, cycle)   -0.9325    ← 重复!
而且对角线全是 1.0,也要排除。
解法:上三角掩码
tri = np.triu(np.ones(corr.shape), k=1).astype(bool)np.triu = "upper triangle"(上三角):
np.triu(np.ones((3,3)), k=1)          # k=1 表示不含对角线
# [[False  True  True]
#  [False False  True]
#  [False False False]]
用这个布尔矩阵去 where:
corr.where(tri)
#             cycle  capacity_ah     soh
# cycle         NaN      -0.9325 -0.9347
# capacity      NaN          NaN  0.9981
# soh           NaN          NaN     NaN
#         ↑ 保留下三角+上三角的一半,对角线置 NaN
然后 stack() 把二维压成一维:
pairs = corr.where(tri).stack()
# cycle        capacity_ah   -0.9325
# cycle        soh           -0.9347
# capacity_ah  soh            0.9981
得到的就是"不重复的列对",而且自动排除了对角线。
这个套路的通用性
它能解决"两两组合"的一整类问题:
# ① 找出相似度最高的文档对
similarity = cosine_similarity_matrix(docs)
pairs = similarity.where(np.triu(np.ones(similarity.shape), k=1).astype(bool)).stack()

# ② 找出重复率最高的商品对
# ③ 找出相关性最高的特征对
# ④ 找出差异最小的配置组合记忆法:
"上三角掩码 + stack" = "不重复的两两组合"
多重共线性:为什么要去重
# 高度相关(|r| > 0.95)的两列只留一个点开:多重共线性会带来什么实际问题?
问题一:线性模型的系数会"打架"
一个极端的例子:
# X1 和 X2 的相关系数 = 0.999(几乎完全一样)
# 真实关系:y = 1 × X1 + 0 × X2(y 只由 X1 决定)

# 拟合结果可能变成:
# y = 50 × X1 - 49 × X2
# 两个系数都巨大,符号相反,但它们的和仍然是 1后果:
- 系数数值爆炸(50 和 -49 而不是 1 和 0);
- 符号反了(X2 的系数是 -49,但实际影响是 0);
- 换个数据,系数完全变样(不稳定)。
这时你不能说"X2 的系数是 -49,所以 X2 有很强的负向影响" —— 完全是错的。
问题二:模型不稳定
# 用不同的随机种子划分子集,分别拟合
for seed in range(5):
    sub = df.sample(frac=0.8, random_state=seed)
    model = LinearRegression().fit(sub[["X1", "X2"]], sub["y"])
    print(f"seed={seed}: X1={model.coef_[0]:+.2f}, X2={model.coef_[1]:+.2f}")

# seed=0: X1=+50.3, X2=-49.1
# seed=1: X1=-12.4, X2=+13.6     ← 完全反了!
# seed=2: X1=+31.7, X2=-30.5
系数在每次采样中剧烈变化 —— 这就是"不稳定"的具体表现。
问题三:无法解释"哪个特征更重要"
在业务汇报里,你没法说:
"这个特征最重要,因为它的系数是 50。"
因为:
- 系数 50 可能是假的(被共线性放大);
- 另一个特征系数 -49,但它的实际影响可能是 0。
★ 但也不是所有模型都受影响
| 模型类型 | 对共线性敏感吗 |
|---|---|
| 线性回归 / 逻辑回归 | ✅ 很敏感(系数不可解释) |
| 岭回归 / Lasso | ⚠️ 缓解(L2 正则会压缩系数) |
| 决策树 / 随机森林 / GBDT | ❌ 不敏感(按阈值切分,不关心系数) |
| 神经网络 | ⚠️ 有一定影响(但不影响预测精度) |
关键区分:
共线性影响的是「模型的可解释性」,不一定影响「预测精度」。

· 如果你要的是"预测准" → 树模型 + 共线性特征,通常没问题
· 如果你要的是"说清哪个特征重要" → 必须处理共线性
★ 处理共线性的三种方法
方法一:删除冗余特征(最简单)
# 在每一对 |r| > 0.95 里,删掉"物理含义更弱"的那个
drop_cols = ["capacity_ah"]        # 保留 soh(它是标签),删掉它的来源
方法二:用 PCA 降维
from sklearn.decomposition import PCA
pca = PCA(n_components=0.95)        # 保留 95% 的方差
X_pca = pca.fit_transform(X)
# 主成分之间天然正交(相关系数为 0)
# 但失去了"哪个特征重要"的可解释性
方法三:用正则化(Ridge)
from sklearn.linear_model import Ridge
model = Ridge(alpha=1.0)            # L2 正则
model.fit(X, y)
# 系数被压缩,稳定性提高,但仍然不太可解释
★ 一个实用的选择流程
你要用线性模型吗?
  ├─ 是 → 必须处理共线性
  │       ├─ 想保留可解释性 → 删冗余特征
  │       └─ 不在乎可解释性 → 用 Ridge 或 PCA
  └─ 否(用树模型 / GBDT)
          → 可以不管共线性,但报告里要说明"存在共线性"

不管用什么模型,都要:
  · 剔除特征泄漏(第 37.4 节的 capacity_ah)
  · 在报告里说明特征选择的过程
37.6 画热力图
labels = list(corr.columns)
fig, ax = plt.subplots(figsize=(7.8, 6.4))
im = ax.imshow(corr.to_numpy(), cmap="coolwarm", vmin=-1, vmax=1)
ax.set_xticks(range(len(labels)), labels, rotation=40, ha="right")
ax.set_yticks(range(len(labels)), labels)
for i in range(len(labels)):
    for j in range(len(labels)):
        v = corr.iloc[i, j]
        ax.text(j, i, f"{v:.2f}", ha="center", va="center", fontsize=9,
                color="white" if abs(v) > 0.6 else "black")
cb = fig.colorbar(im, ax=ax, fraction=0.046, pad=0.03)
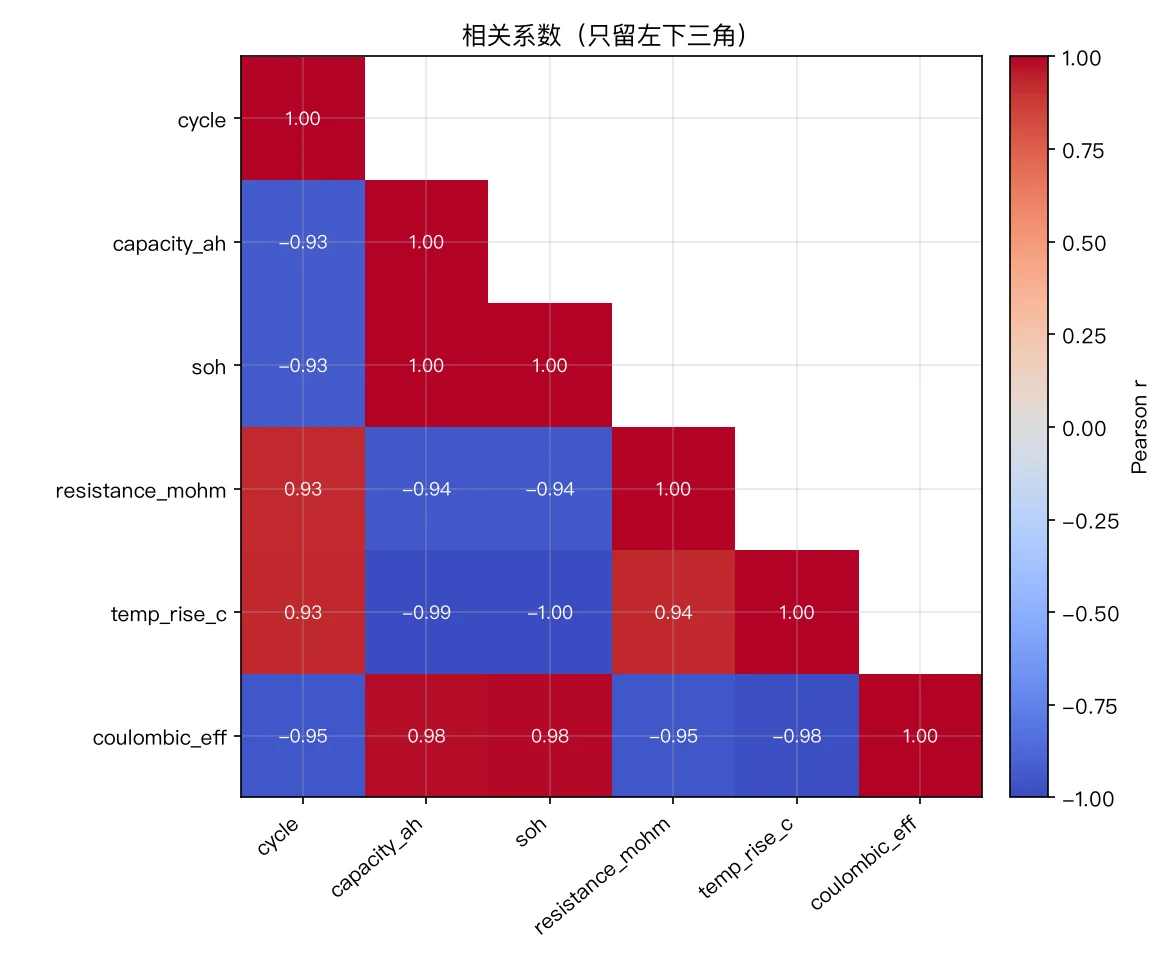
cb.set_label("Pearson r")结果(只保留左下三角的版本):
点开:imshow 的四个关键点
① imshow 把矩阵当"图片"画 —— 颜色 = 数值。
ax.imshow(corr.to_numpy(), cmap="coolwarm", vmin=-1, vmax=1)为什么用 imshow 而不是 pcolor / matshow:
| 函数 | 特点 |
|---|---|
imshow | 简单、快、默认等比例 |
pcolor | 慢(大数据);格子边缘可能有缝 |
matshow | 其实是 imshow 的包装,不能设 colorbar 标签 |
imshow 是标准选择。
② vmin=-1, vmax=1 必须写。
不写会怎样:颜色范围跟着当前数据的 min/max 自适应。
图 A 的 r 范围 [-0.4, 0.6]   → 颜色条从 -0.4 到 0.6
图 B 的 r 范围 [-0.99, 0.99] → 颜色条从 -0.99 到 0.99

两张图上的"深红"含义完全不同!
相关系数有明确的物理范围 [-1, 1],所以必须写死。
这一条和第 36 章的 vmin/vmax 是同一个道理。
③ 格子里要标数值。
for i in range(len(labels)):
    for j in range(len(labels)):
        v = corr.iloc[i, j]
        ax.text(j, i, f"{v:.2f}", ha="center", va="center", fontsize=9,
color="white" if abs(v) > 0.6 else "black")为什么:颜色只能看个大概。
"深红色"可能是 0.7 也可能是 0.99 —— 差别很大,但颜色看起来差不多。标了数字之后,读者能读到精确值。
★ color 的自适应
color="white" if abs(v) > 0.6 else "black"为什么:
|r| 大 → 颜色深(深红/深蓝)→ 黑字看不清 → 用白字
|r| 小 → 颜色浅(白色附近)  → 白字看不清 → 用黑字
阈值 0.6 是经验值(配合 coolwarm 的色阶)。
④ 网格线用 minor tick 画。
ax.grid(which="major", visible=False)
ax.set_xticks(np.arange(-0.5, len(labels), 1), minor=True)
ax.set_yticks(np.arange(-0.5, len(labels), 1), minor=True)
ax.grid(which="minor", color="white", lw=1.5)
ax.tick_params(which="minor", length=0)
为什么用 -0.5, 0.5, 1.5, ...: imshow 把数据点放在整数坐标上,每个格子的边界在 ±0.5 处。
画在 -0.5 到 n-0.5 的 minor tick 上,正好是格子边界。
对比:手动画矩形
for i in range(n):
    for j in range(n):
ax.add_patch(plt.Rectangle((j-0.5, i-0.5), 1, 1, fill=False, edgecolor="white"))能实现,但慢很多(尤其格子多时)。minor tick 是更优雅的做法。
37.7 只保留左下三角
tri = np.triu(np.ones(corr.shape, dtype=bool), k=1)      # 上三角掩码
half = corr.mask(tri) # 把上三角置为 NaN为什么:对称矩阵的上三角就是下三角的镜像,去掉更清爽。
全矩阵:6 × 6 = 36 个格子
左下三角:6 × 7 / 2 = 21 个格子
         其中对角线 6 个(全是 1.00,也没信息量)
真正有信息:15 个具体代码:
for i in range(len(labels)):
    for j in range(i + 1):                     # ← 只画 i >= j 的部分
        v = corr.iloc[i, j]
        ax.text(j, i, f"{v:.2f}", ...)
range(i + 1) 保证 j <= i —— 也就是只画下三角(含对角线)。
★ 一个更常见的做法:只画下三角 + 隐藏对角线
# 隐藏对角线(全是 1.00,没信息量)
half = corr.mask(np.triu(np.ones(corr.shape, dtype=bool), k=0)) # k=0 含对角线对比:
| 掩码 | 效果 |
|---|---|
np.triu(..., k=1) | 保留对角线(显示 1.00) |
np.triu(..., k=0) | 也隐藏对角线 |
书里保留对角线,因为读者能借此确认"行列对应关系"。
★ 字段多的时候(> 15 列)
15 列以上的热力图会变得难以阅读(格子太小、标签重叠)。
三种应对:
# ① 按聚类重排(把相关的特征排在一起)
from scipy.cluster.hierarchy import linkage, dendrogram
order = dendrogram(linkage(1 - corr.abs(), method="average"),
                   no_plot=True)["leaves"]
corr_ordered = corr.iloc[order, order]

# ② 只显示 |r| > 阈值的格子(其他的留白)
masked = corr.where(corr.abs() > 0.5)

# ③ 拆成多个小图(比如按业务模块分组)
① 聚类重排最实用 —— 它会让"成块的强相关"显现出来, 一眼看出"这几个字段是一组的"。
37.8 三条结论(热力图的价值在这儿)
① capacity_ah ↔ soh = +0.998
   → 冗余特征。建模时同时放进去等于把同一条信息算了两遍。
   若 SOH 是标签,capacity_ah 属于特征泄漏,必须剔除。

② soh ↔ temp_rise_c = -0.996
   soh ↔ resistance_mohm = -0.940
   soh ↔ coulombic_eff = +0.985
   → 老化过程的三条独立「侧面」:容量降、温升涨、内阻涨、库仑效率降。
   它们之间也高度相关(都随老化同步变化),做线性模型时要留意共线性。

③ cycle ↔ soh = -0.935
   → 循环次数是「最朴素的寿命指标」,但它只有一个维度,
   不足以精确预测 SOH(第 21 章的生成公式里内阻用的是 c^1.5,上升速率不同)。
   这正是「多特征建模」和「特征工程」的动机。
★ 第 ③ 条值得展开
为什么"cycle ↔ soh = -0.935"还不够好:
如果只用 cycle 预测 SOH:
  所有同一 cycle 的记录都被预测成同一个 SOH

但实际上:cycle = 500 时
  C001(寿命 862)的 SOH ≈ 0.86
  C002(寿命 1342)的 SOH ≈ 0.93
  C007(寿命 1415)的 SOH ≈ 0.95

差异很大!为什么:生成公式里 SOH = 1 - 0.20 × (cycle / 寿命)^β, 而每支电芯的"寿命"和"β"都不同。
只用 cycle → 不知道"这支电芯还剩多少寿命" → 预测不准
加上 resistance_mohm / temp_rise_c → 能推断出"老化到什么程度了" → 更准
这就是"多特征建模"的动机 —— 单一维度信息不足,多个侧面才能定位真实状态。
★ 一个量化验证
# 只用 cycle 预测 SOH 的误差
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_absolute_error

for feats in (["cycle"], ["cycle", "resistance_mohm"],
              ["cycle", "resistance_mohm", "temp_rise_c", "coulombic_eff"]):
    X, y = df[feats].to_numpy(), df["soh"].to_numpy()
    m = LinearRegression().fit(X, y)
    mae = mean_absolute_error(y, m.predict(X))
print(f"{str(feats):<60} MAE = {mae:.5f}")预期结果:特征越多,MAE 越小 —— 但收益递减, 而且要警惕过拟合和泄漏。
37.9 相关系数不是万能:试试 Spearman
sp = num.corr(method="spearman")
diff = (sp - corr).abs().to_numpy().max()
print(f"Pearson 与 Spearman 的最大差异 = {diff:.4f}")真实输出:
Pearson 与 Spearman 的最大差异 = 0.0000(或极小)
soh ↔ resistance_mohm  Pearson -0.9397  Spearman -0.9397
两者几乎一致 → 说明关系基本是线性的、异常值影响不大。
点开:Spearman 是什么?什么时候用它?
Spearman 秩相关系数:先给数据排名,再对排名算 Pearson。
原始值:[10, 20, 1000, 40]
排名  :[1,  2,   4,   3]

然后对排名算 Pearson → Spearman它的特点:
| Pearson | Spearman | |
|---|---|---|
| 度量 | 线性关系 | 单调关系 |
| 对异常值 | 敏感 | 稳健(只看排名) |
| 适用范围 | 数值、近似正态 | 数值或有序类别 |
什么时候用 Spearman:
① 关系是"单调但非线性"的。
y = log(x)         y 随 x 单调递增,但不是线性
Pearson 会低估(约 0.85)
Spearman 会准确捕捉(接近 1.0)
② 数据有异常值。
x = pd.Series([1, 2, 3, 4, 5, 1000])
y = pd.Series([1, 2, 3, 4, 5, 6])
print(f"Pearson  {x.corr(y):.4f}")                  # 可能 0.5 左右
print(f"Spearman {x.corr(y, method='spearman'):.4f}")  # 1.0000(完美单调)
③ 有序类别变量。
# 比如"满意度:很低/低/中/高/很高" 编码成 1~5
# 用 Spearman 更合适(它只关心顺序)
★ 两者的差异本身就是信息
| 差异 | 含义 |
|---|---|
| 接近 0 | 关系基本线性、异常值影响小 |
| Pearson 明显低于 Spearman | 关系非线性(单调但非直线),或有异常值 |
| Pearson 明显高于 Spearman | 少数极端点主导了线性相关(要查) |
★ 一个实用建议
# 同时输出两者,让读者自己判断
def corr_both(x, y):
    return {
        "pearson": round(x.corr(y), 4),
        "spearman": round(x.corr(y, method="spearman"), 4),
    }
第 36 章的 corr_robust 函数已经同时输出两者(可以去回看)。
37.10 完整示例与输出
cd code
python demos/ch37-heatmap.py
真实输出(节选):
=== ① 先只挑数值列(否则 corr 直接报错) ===
  参与计算的列(6):['cycle', 'capacity_ah', 'soh', 'resistance_mohm', 'temp_rise_c', 'coulombic_eff']
  被自动排除的列:['cell_id', 'batch', 'timestamp']

=== ③ 与 SOH 相关性最强的是哪几个 ===
  capacity_ah       +0.9981
  temp_rise_c       -0.9957
  coulombic_eff     +0.9849
  resistance_mohm   -0.9397
  cycle             -0.9347

=== ④ ★★ 特征泄漏:capacity_ah 与 soh 的 r = +0.9981 ===
  如果 SOH 是要预测的标签,那把 capacity_ah 当特征会发生什么?
    → 等于把「答案」抄进了试卷。

=== ⑤ 找出所有「信息重复」的列对(|r| > 0.95) ===
  共找到 6 对

=== ⑨ 相关系数不是万能:试试 Spearman ===
  Pearson 与 Spearman 的最大差异 = 0.0000
  两者接近 → 关系基本是线性的、异常值影响不大。
本章练习
练习 1:算相关系数矩阵并回答问题
- 算数值列的相关系数矩阵,打印;
- 找出与 SOH 相关性最强的 3 个特征(按绝对值排序);
- 找出所有
|r| > 0.95的列对; - 回答:如果用 SOH 当标签,哪一列绝对不能当特征?为什么?
- 画一张"只留左下三角"的热力图保存。
参考答案
import os
import sys
from pathlib import Path

import numpy as np
import pandas as pd

CODE_DIR = Path(__file__).resolve().parent.parent.parent
sys.path.insert(0, str(CODE_DIR))
os.environ.setdefault("MPLCONFIGDIR", str(CODE_DIR / ".mplconfig"))

import matplotlib.pyplot as plt                             # noqa: E402
from common.plots import setup_style, save_fig              # noqa: E402

OUT = CODE_DIR / "outputs"
setup_style()
df = pd.read_csv(CODE_DIR / "data" / "battery" / "cycle_raw.csv")

# ①② 相关系数矩阵
corr = df.select_dtypes("number").corr()
soh_corr = corr["soh"].drop("soh")
ranked = soh_corr.sort_values(key=abs, ascending=False)      # ★ key=abs
print("与 SOH 最强的 3 个:")
print(ranked.head(3).round(4).to_string())
# capacity_ah        0.9981
# temp_rise_c       -0.9957
# coulombic_eff      0.9849

# ③ 找重复列对
tri = np.triu(np.ones(corr.shape), k=1).astype(bool)
pairs = corr.where(tri).stack()
dup = pairs[pairs.abs() > 0.95].sort_values(key=abs, ascending=False)
print(f"\n信息重复的列对({len(dup)} 对):")
for (a, b), v in dup.items():
    print(f"  {a:<18}↔ {b:<18}{v:+.3f}")

# ⑤ 热力图(左下三角)
labels = list(corr.columns)
half = corr.mask(np.triu(np.ones(corr.shape, dtype=bool), k=1))
fig, ax = plt.subplots(figsize=(7.8, 6.4))
im = ax.imshow(half.to_numpy(), cmap="coolwarm", vmin=-1, vmax=1)   # ★ vmin/vmax
ax.set_xticks(range(len(labels)), labels, rotation=40, ha="right")
ax.set_yticks(range(len(labels)), labels)
for i in range(len(labels)):
    for j in range(i + 1):                                   # ★ 只画下三角
        v = corr.iloc[i, j]
        ax.text(j, i, f"{v:.2f}", ha="center", va="center", fontsize=9,
                color="white" if abs(v) > 0.6 else "black")
cb = fig.colorbar(im, ax=ax, fraction=0.046, pad=0.03)
cb.set_label("Pearson r")
ax.set_title("数值列相关系数(左下三角)")
save_fig(fig, str(OUT / "ch37_exercise.png"))真实输出:
与 SOH 最强的 3 个:
capacity_ah        0.9981
temp_rise_c       -0.9957
coulombic_eff      0.9849

信息重复的列对(6 对):
  capacity_ah      ↔ soh                0.998
  soh              ↔ temp_rise_c       -0.996
  capacity_ah      ↔ temp_rise_c       -0.994
  soh              ↔ coulombic_eff      0.985
  capacity_ah      ↔ coulombic_eff      0.983
  temp_rise_c      ↔ coulombic_eff     -0.981
④ 的答案:
capacity_ah 绝对不能当特征。
理由:SOH 的定义就是「当前容量 / 额定容量」。
soh = capacity_ah / 2.5两者的 r = 0.9981 —— 几乎完全重合。
把它当特征 = 把答案抄进试卷 —— 模型会学到"当 capacity_ah = 2.30 时,答案是 0.92", 上线后立刻崩(因为线上拿不到 SOH)。
这个错误叫「特征泄漏(Data Leakage)」。
★ 但要区分"泄漏"和"强信号"
| 特征 | r | 是泄漏吗 | 判据 |
|---|---|---|---|
capacity_ah | 0.9981 | ✅ 是 | 它是 SOH 的计算来源 |
temp_rise_c | -0.9957 | ❌ 不是 | 独立测量的物理量(老化的伴随现象) |
coulombic_eff | 0.9849 | ❌ 不是 | 独立的电学测量 |
关键问题:"如果把这个特征拿掉,标签还能算出来吗?"
capacity_ah 拿掉 → SOH 算不出来了(因为它就是 SOH/2.5)→ 泄漏
temp_rise_c 拿掉 → SOH 照样能算(它是独立测量的)→ 不是泄漏完整练习:exercises/ex37-01-heatmap
练习 2:为什么排序必须按绝对值?按位置取值和按标签取值有什么区别?
soh_corr = corr["soh"].drop("soh")

# 写法 A
print(soh_corr.sort_values().head(3))

# 写法 B
print(soh_corr.sort_values(key=abs, ascending=False).head(3))要求:说出两种写法的输出,并解释差异。
参考答案
写法 A(直接升序):
temp_rise_c       -0.9957     ← 最强的负相关排最前
resistance_mohm   -0.9397
cycle             -0.9347
读者会误以为"temp_rise_c 最相关",而完全看不到 +0.9981 的 capacity_ah。
写法 B(key=abs):
capacity_ah        0.9981
temp_rise_c       -0.9957     ← 保留符号
coulombic_eff      0.9849
两者都正确,且保留了"正/负相关"的方向信息。
★ 核心问题
"按大小排序"时,负数怎么办?
| 需求 | 写法 |
|---|---|
| 想知道"最强的(不分正负)" | key=abs 或 .abs() |
| 想知道"最正的" | sort_values(ascending=False) |
| 想知道"最负的" | sort_values(ascending=True) |
在"相关性排序"这个场景里,我们关心的是"强弱"(不分方向), 所以必须用 key=abs。
★ 两种写法的细节差异
soh_corr.sort_values(key=abs, ascending=False)     # 保留符号
soh_corr.abs().sort_values(ascending=False) # 符号变成正号区别:第二种的值本身被改了(变成了绝对值)。
后果:
# 用第二种的结果去查"是正相关还是负相关"
top = soh_corr.abs().sort_values(ascending=False).head(1)
print(top)              # capacity_ah  0.9981
print(top.index[0])     # capacity_ah
# 但如果你要看原值:
print(soh_corr[top.index[0]])    # 还得回原表查
推荐 key=abs —— 一步到位,值就是原始相关系数。
★ 顺带回顾"按位置 vs 按标签"
上面的 corr.iloc[i, j] 和 corr.loc["soh", "capacity_ah"] 是两种取值方式:
| 写法 | 含义 | 前提 |
|---|---|---|
corr.iloc[i, j] | 第 i 行第 j 列 | 需要知道列的顺序 |
corr.loc["soh", "capacity_ah"] | 名为 soh 的行、名为 capacity_ah 的列 | 按列名,顺序无关 |
画热力图时必须用 iloc(因为要遍历坐标 i, j)。
但取具体某个值时必须用 loc —— 否则列顺序一变,代码就读了别的值:
# ❌ 危险:列顺序一变就错
r = corr.iloc[2, 1]

# ✅ 安全
r = corr.loc["soh", "capacity_ah"]
★ 一个实战模式
# 画图用 iloc(按坐标),标注时用 iloc 也可以(因为要打印格子里的值)
# 但任何"业务逻辑"(比如判断哪个特征泄漏)都用 loc + 列名
leak_cols = [c for c in corr.columns
             if c != "soh" and abs(corr.loc[c, "soh"]) > 0.95]
print(f"高度可疑的列:{leak_cols}")
练习 3:vmin / vmax 为什么必须写?
# 版本 A
ax.imshow(corr.to_numpy(), cmap="coolwarm")

# 版本 B
ax.imshow(corr.to_numpy(), cmap="coolwarm", vmin=-1, vmax=1)要求:说出两个版本在"两张图对比"时会出现什么问题。
参考答案
版本 A 的问题:颜色范围跟着数据自适应。
一个具体的场景:
# 数据 A(相关性都比较强)
corr_a = 相关系数矩阵,值域 [-0.99, 1.00]
ax.imshow(corr_a, cmap="coolwarm")      # 颜色条:-0.99 ~ 1.00

# 数据 B(相关性都比较弱)
corr_b = 相关系数矩阵,值域 [-0.35, 0.40]
ax.imshow(corr_b, cmap="coolwarm") # 颜色条:-0.35 ~ 0.40结果:
图 A 上一个"中等红"的格子 = r 0.5
图 B 上一个"深红"的格子   = r 0.4

读者会以为"图 B 的相关性更强",但实际上图 A 的更强!
因为两张图的色标范围不同,"深红"的含义完全不同。
版本 B 修正了这个问题:
ax.imshow(corr.to_numpy(), cmap="coolwarm", vmin=-1, vmax=1)
# 两张图的颜色条都是 -1 ~ 1
# 所以"深红"在两图里都表示"接近 +1"
★ 规则
只要一个量有"理论上/物理上的固定范围",就写死
vmin/vmax。
| 量 | 范围 | 写什么 |
|---|---|---|
| 相关系数 | [-1, 1] | vmin=-1, vmax=1 |
| 概率 | [0, 1] | vmin=0, vmax=1 |
| SOH | [0, 1](或 [0.8, 1.0]) | vmin=0, vmax=1 |
| 库仑效率 | 约 [0.98, 1.0] | vmin=0.98, vmax=1.0 |
| 温度(无固定上限) | — | 可以不写 |
| 样本数(跨度大) | — | 用 bins="log" |
★ 一个反例:什么情况下不该写死
# ❌ 如果范围的选取本身会误导
ax.imshow(temp_map, vmin=20, vmax=25)      # 温度只差 5℃
# → 图上会出现剧烈的"红蓝对比",让人以为温差很大
# → 但实际上 20~25℃ 是很小的范围

# ✅ 用一个"合理的物理范围"
ax.imshow(temp_map, vmin=0, vmax=60)
# → 颜色对比温和,反映真实的温差
★ 一个实用的经验
写死范围是"为了可比性"; 但范围的选择本身也是"一种表达",可能是误导。
所以:
# 如果做"多图对比" → 统一范围(可比性优先)
# 如果做"单图展示" → 用物理上合理的范围(别为了好看而放大差异)
# 如果两者冲突 → 在标题/图注里说明"色标范围:X ~ Y"最后一条最重要:
不管怎么选,都要在图上标出色标范围 ——
colorbar会自动显示,但如果色标被截断或手动设置过,要在图注里说明。
面向 AI 开发:相关性分析是"特征工程"的体检报告
在 AI 项目里,corr() + 热力图是特征工程的第一个动作。
★ 一个标准的特征审查流程
① 算相关系数矩阵 + 画热力图
     ↓
② 看"与标签的 |r| > 0.95" 的特征 → 逐个检查是否泄漏
     ↓
③ 看"特征之间 |r| > 0.95" 的对 → 标记为冗余
     ↓
④ 结合物理含义做最终决定:
     · 泄漏 → 剔除(无条件)
     · 冗余 → 保留物理含义最清晰的那个
     · 高相关但独立 → 保留(可能是强信号)
     ↓
⑤ 把决定记录下来(特征选择日志)
★ 一个真实的"特征决策记录"
| 特征 | 与 soh 的 r | 与谁冗余 | 决定 | 理由 |
|---|---|---|---|---|
capacity_ah | +0.998 | soh, temp_rise_c | 剔除 | 特征泄漏(SOH 由它算出) |
temp_rise_c | -0.996 | soh, capacity_ah, coulombic_eff | 保留 | 独立测量,物理意义明确 |
coulombic_eff | +0.985 | soh, capacity_ah | 保留 | 独立电学测量 |
resistance_mohm | -0.940 | — | 保留 | 独立测量,且是"老化滞后指标" |
cycle | -0.935 | — | 保留 | 最基础的寿命指标 |
这份记录的价值:
- 决策有依据(不是"我觉得该删");
- 可追溯(半年后有人问"为什么没用 capacity_ah",答案在这里);
- 可复现(换一份数据时,照同样的流程走)。
★ 一个特征选择的辅助脚本
def audit_features(df, target, threshold_leak=0.95, threshold_dup=0.95):
    """特征审查:找泄漏和冗余。"""
    num = df.select_dtypes("number")
    corr = num.corr()

    # ① 与标签高度相关的(疑似泄漏,需人工确认)
    with_target = (corr[target].drop(target)
                     .sort_values(key=abs, ascending=False))
    print(f"=== 与 {target} 相关性最高的特征(|r| > {threshold_leak} 需查泄漏)===")
    for name, v in with_target.items():
        flag = "⚠️ 需查泄漏" if abs(v) > threshold_leak else ""
        print(f"  {name:<20}{v:>+9.4f}  {flag}")

    # ② 特征之间高度相关的(冗余对)
    feats = [c for c in corr.columns if c != target]
    sub = corr.loc[feats, feats]
    tri = np.triu(np.ones(sub.shape), k=1).astype(bool)
    pairs = sub.where(tri).stack()
    dup = pairs[pairs.abs() > threshold_dup].sort_values(key=abs, ascending=False)

    print(f"\n=== 特征间冗余对(|r| > {threshold_dup})===")
    for (a, b), v in dup.items():
        print(f"  {a:<20}↔ {b:<20}{v:>+9.4f}")
return corr, with_target, dup用法:
corr, with_target, dup = audit_features(df, "soh")这个函数一次给出两份清单(疑似泄漏 + 冗余对), 把"审查"变成一次调用。
★ 但记住:脚本只能"提示",不能"决定"
脚本能告诉你:       "capacity_ah 和 soh 的 r = 0.998"
脚本不能告诉你:     "所以它是泄漏"

判断"是不是泄漏"需要知道: SOH = capacity_ah / 2.5
                          ↑ 这是业务知识,不是统计知识

这也是为什么"数据工程师要懂业务"。
★ 一句话总结本章
热力图是"用一张图看完全部关系"的工具。 但它的最大价值不是"图好看", 而是"逼你逐个检查每个高相关是不是泄漏"。
一个 15 列的特征表,用热力图扫一遍, 能发现人眼扫表格发现不了的问题。