第 38 章 · 箱线图:按批次看离散度
这一章要解决什么:比较几组数据的分布(不只是均值)。 学会读"中位数一样但箱体高度不同"这类信息 —— 它在工业场景里指向完全不同的问题。
本章你需要完成的代码:demos/ch38-boxplot.py
38.1 箱线图怎么读(必背)
点开:箱线图的解剖图
              ○  ← 须外的点 = 异常值
              │
          ┌───┴───┐  ← 上须 = Q3 + 1.5×IQR
          │       │        (或范围内最远的实际数据点)
          ├───────┤  ← 箱体上边 = Q3(75% 分位)
          │       │
          ├───────┤  ← 箱体内横线 = 中位数(Q2 / 50% 分位)
          │       │
          └───┬───┘  ← 箱体下边 = Q1(25% 分位)
              │
○ ← 下须 = Q1 - 1.5×IQR六个要素:
| 要素 | 含义 | 读出什么 |
|---|---|---|
| 箱体下边 | Q1(25% 分位) | 下四分位 |
| 箱体上边 | Q3(75% 分位) | 上四分位 |
| 箱子高度 | IQR = Q3 - Q1 | 离散度(中间 50% 的范围) |
| 箱内横线 | 中位数(Q2) | 中心位置 |
| 上下须 | 1.5×IQR 以内最远的实际点 | 正常范围 |
| 须外的点 | 异常值 | 需要关注 |
★ 一句话:
箱线图就是第 33 章 IQR 规则的图像版。
所以"图上的异常点"和"IQR 算出的异常"必然一致 —— 不会出现图数矛盾。这个性质在报告里特别有用(第 39 章会用到)。
38.2 先算数,再画图(顺序别反)
这是本书反复强调的纪律:先把数字算清楚,再画图。
COL = "resistance_mohm"
batches = sorted(df["batch"].unique())
stats = {}
for b in batches:
    s = df.loc[df["batch"] == b, COL]
    q1, q2, q3 = s.quantile(0.25), s.median(), s.quantile(0.75)
stats[b] = q3 - q1真实输出:
  {'批次':<6}{'n':>7}{'Q1':>9}{'中位数':>9}{'Q3':>9}{'IQR':>9}{'均值':>9}
  A      3331    44.48    52.60    63.14    18.66    52.96
  B      4157    44.91    53.85    65.41    20.50    53.41
  C      3304    44.72    53.19    64.31    19.60    53.15
D 3175 44.00 51.26 60.65 16.65 52.51最不一致的是:批次 B(IQR = 20.50)
最一致的是 :批次 D(IQR = 16.65)
箱体高度相差 3.85 mΩ(相对水平 23.1%)
而四批的中位数只差 2.59 mΩ点开:为什么"先算数"比"先画图"重要?
三个理由:
① 数字能进报告,图不能。
print(per_batch.round(4).to_string())
# 这段输出可以直接贴进报告/表格
# 而图只能"看起来差不多"
② 数字能做进一步计算。
# 算"批间差异"和"批内差异"的比值
between = stats.max() - stats.min()         # 批间
within = np.mean(list(stats.values()))      # 批内平均
print(f"批间/批内 = {between / within:.3f}")   # 0.21
# → 批内差异远大于批间差异
③ 数字能暴露"图看不出来的问题"。
# 比如:某个批次的样本量特别少
print(df.groupby("batch").size())
# A    3331
# B    4157
# C    3304
# D    3175
# → 样本量接近,可以比较

# 如果变成:
# A    3331
# B      50      ← 样本量太小!
# → 这个批次的箱体不可信(四分位数不稳定,见 38.7)
★ "先算数"能发现的问题
| 检查 | 命令 | 能发现 |
|---|---|---|
| 样本量 | df.groupby(g).size() | 某组样本太少,箱体不可信 |
| 中位数 | .median() | 中心位置差异 |
| IQR | q3 - q1 | 离散度差异 |
| 缺失 | .isna().sum() | 某组缺失特别多 |
| 极值 | .min() / .max() | 异常值 |
图能传达"感觉",数字能支撑"结论"。报告两者都要有。
38.3 画图
data = [df.loc[df["batch"] == b, COL].to_numpy() for b in batches]
fig, ax = plt.subplots(figsize=(8, 4.8))
bp = ax.boxplot(data, patch_artist=True, widths=0.6, showfliers=True,
                medianprops=dict(color="black", lw=1.6))
for patch, color in zip(bp["boxes"], PALETTE):
    patch.set_facecolor(color)
    patch.set_alpha(0.55)
ax.set_xticks(range(1, len(batches) + 1), [f"批次 {b}" for b in batches])
ax.set_ylabel("内阻 (mΩ)")
ax.set_title("各批次内阻分布对比")结果:
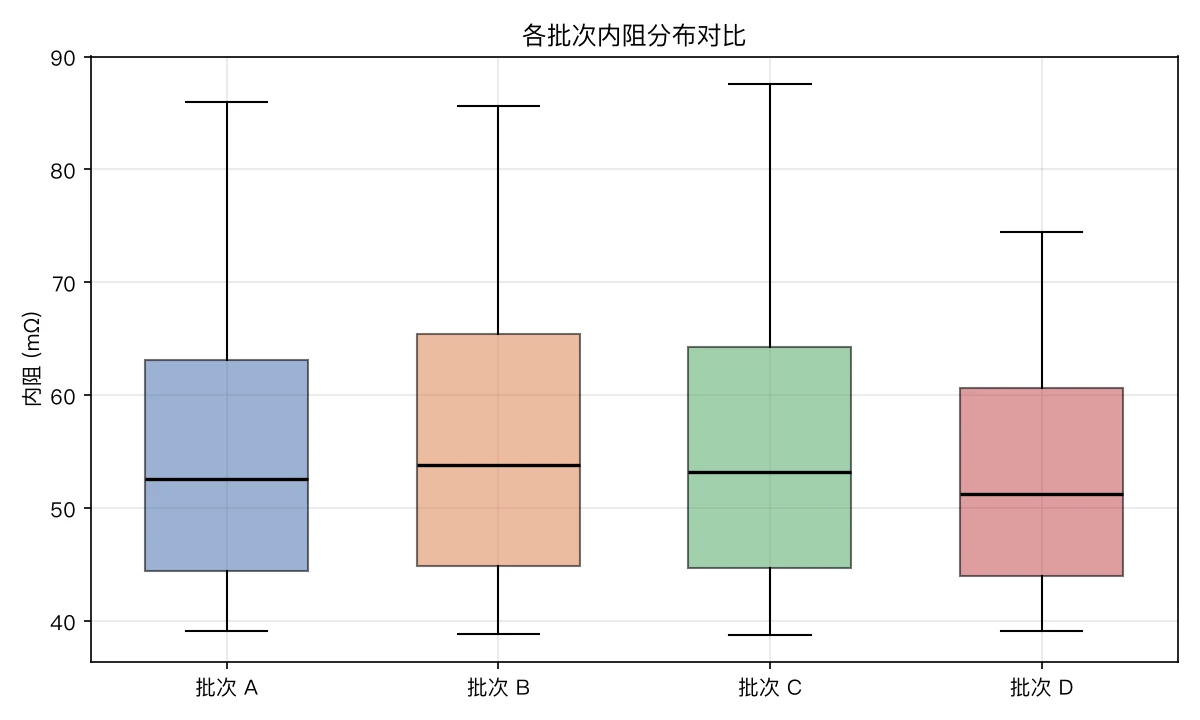
点开:patch_artist=True —— 最容易漏的一行
问题
bp = ax.boxplot(data)                    # ❌ 没有 patch_artist
for patch in bp["boxes"]:
    patch.set_facecolor("blue")          # 完全不生效,而且不报错!
箱体还是空心的线条图 —— 你会以为"颜色没生效是不是我参数写错了", 但其实是没有开 patch_artist。
原因
matplotlib 的 boxplot 默认用"线条"画箱体(Line2D 对象), 而不是"色块"(Patch 对象)。
Patch 才能 set_facecolor。
# 默认(patch_artist=False):箱体是 4 条线组成的矩形
bp["boxes"][0]        # <matplotlib.lines.Line2D>

# 开了 patch_artist=True:箱体是一个 Polygon
bp["boxes"][0]        # <matplotlib.patches.PathPatch>
正确写法
bp = ax.boxplot(data, patch_artist=True, widths=0.6)
for patch, color in zip(bp["boxes"], PALETTE):
    patch.set_facecolor(color)
    patch.set_alpha(0.55)               # 半透明,让中位线更清楚
★ 为什么这个坑特别隐蔽
因为它不报错。
不生效 + 不报错 = 你可能花 20 分钟查"为什么颜色没变"同类"不报错但无效"的坑(本书出现过好几次):
| 场景 | 症状 | 原因 |
|---|---|---|
boxplot 上色 | 颜色不变 | 没开 patch_artist |
| 双轴图画图例 | 只显示一条线 | ax.legend() 只认自己的轴 |
twinx 后网格 | 图很脏 | 没写 ax2.grid(False) |
| 链式赋值 | 改了没生效 | Copy-on-Write |
interpolate 跨组 | 数据被污染 | 没 groupby |
★ 一个"防御性"的检查方法
如果某个视觉效果没生效,先确认"对象类型对不对":
print(type(bp["boxes"][0]))
# <class 'matplotlib.patches.PathPatch'>  ← 可以 set_facecolor
# <class 'matplotlib.lines.Line2D'>       ← 不能 set_facecolor
boxplot 的其他常用参数
ax.boxplot(data,
           patch_artist=True,          # 能上色
           widths=0.6,                  # 箱体宽度(占间距的比例)
           showfliers=True,             # 显示须外的异常点
           medianprops=dict(color="black", lw=1.6),      # 中位线样式
           boxprops=dict(linewidth=1.0),                  # 箱体边框
           whiskerprops=dict(linestyle="--"),             # 须的样式
           flierprops=dict(marker="o", markersize=3, alpha=0.5),  # 异常点样式
)常用组合:
| 场景 | 参数 |
|---|---|
| 正常展示 | patch_artist=True, widths=0.6 |
| 异常点太多糊成一片 | showfliers=False(先看主体) |
| 要突出中位数 | medianprops=dict(color="black", lw=2) |
| 数据量大、异常点多 | flierprops=dict(markersize=2, alpha=0.3) |
38.4 换成 SOH 再看一遍:换一列,结论可能完全不同
soh_stats = {}
for b in batches:
    s = df.loc[df["batch"] == b, "soh"]
    q1, q2, q3 = s.quantile(0.25), s.median(), s.quantile(0.75)
soh_stats[b] = q3 - q1真实输出:
  {'批次':<6}{'Q1':>9}{'中位数':>9}{'Q3':>9}{'IQR':>9}
  A      0.8557    0.9095    0.9600    0.1043
  B      0.8551    0.9085    0.9587    0.1036
  C      0.8540    0.9069    0.9575    0.1035
D 0.8599 0.9154 0.9646 0.1048结果:
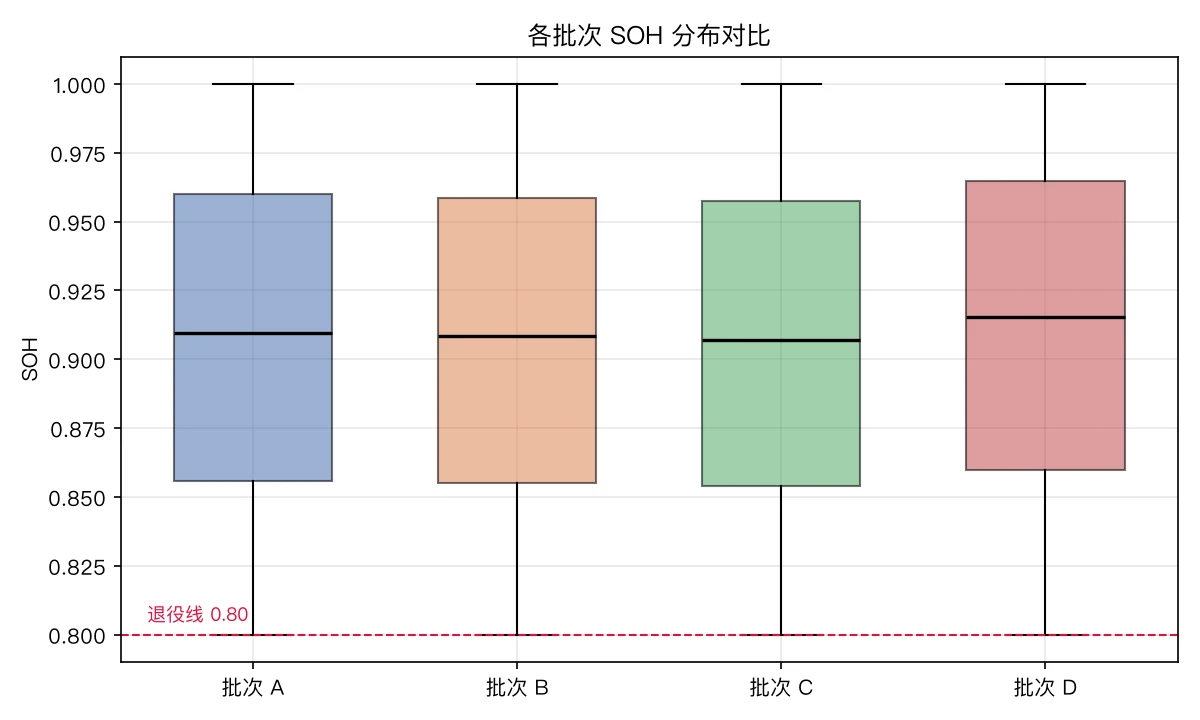
四批 SOH 中位数差 0.0085,
IQR 都约 0.1040 —— 离散度几乎一样。
点开:为什么"内阻"和"SOH"的结论不一样?
对比两列的结果:
| 列 | 中位数差 | IQR 差 | 结论 |
|---|---|---|---|
resistance_mohm | 2.59 mΩ | 3.85 mΩ | 批次 B 离散度明显更大 |
soh | 0.0085 | 0.0013 | 四批几乎一样 |
为什么:
① 两列的"生成公式"不同。
# SOH:每支电芯的曲线形状随 β 变化,但都是"从 1.0 到 0.8"的完整轨迹
soh = 1.0 - 0.20 * c ** beta

# 内阻:上升速率随 γ 变化,而且指数是 1.5(不是 β)
res = 40.0 * (1.0 + gamma * c ** 1.5)
SOH 的分布被"归一化"了(每支都从 1.0 走到 0.8), 所以各批的 SOH 分布几乎一样。
而内阻的绝对水平随 γ 变化 —— 不同电芯的内阻曲线差异更大。
② 这告诉我们一个重要的事实:
"换一列,结论可能完全不同" —— 所以对比分析要明确"对比的是哪个指标"。
★ 报告里的正确表述
❌ 含糊:"四批之间没有明显差异。"

✅ 明确:"四批的 SOH 分布无显著差异(中位数差 0.0085,IQR 差 0.0013)。
        但内阻的离散度有差异:批次 B 的 IQR 为 20.50 mΩ,
比批次 D(16.65 mΩ)高 23.1%。"第二段表述的关键:说明了"比的是哪个指标"、 "差异是多少"、"差异体现在哪(离散度 vs 中位数)"。
38.5 ★ 怎么读"没有差异"这个结论
四批的中位数几乎一样、箱体高度也接近 → 「批次间没有明显差异」也是一个结论。点开:为什么"没有差异"值得写进报告?
很多人的直觉是"没有差异就不用写了" —— 这是错的。
"没有差异"回答了业务上一个重要的问题:
"这四个批次是不是来自同一工艺?"
  ↓
"从内阻和 SOH 的分布看,四批无显著差异"
  → 支持"同一工艺"的假设
  → 如果有差异,就该去查"是不是换了配方/设备"
★ "没有差异"和"有差异"的价值是等价的
| 结论 | 业务含义 |
|---|---|
| 有显著差异 | 去找差异的原因(工艺?来料?设备?) |
| 无显著差异 | 确认工艺稳定;后续可以把批次合并分析 |
"确认无差异"直接影响下一步决策:
# 如果批次间无差异 → 可以把四批合并,增大样本量
df_all = df                                   # 直接用全部数据

# 如果有差异 → 要分批次建模或加入 batch 特征
df["batch_code"] = df["batch"].map({"A": 0, "B": 1, "C": 2, "D": 3})
FEATURES = [..., "batch_code"]
★ 报告里该怎么写"无差异"
❌ 太简单:"四批没有差异。"

✅ 完整:"四个批次的 SOH 中位数在 0.9069~0.9154 之间(极差 0.0085),
        箱体高度(IQR)在 0.1035~0.1048 之间(极差 0.0013)。
        内阻的中位数在 51.26~53.85 mΩ 之间(极差 2.59 mΩ),
        IQR 在 16.65~20.50 mΩ 之间(极差 3.85 mΩ)。
        综合判断:批次间的中心位置与离散度均无实质差异,
可以认为四批来自同一工艺,后续分析可合并处理。"这段话的四个要素:
- 给出具体数字(不是"感觉差不多");
- 覆盖两个指标(SOH 和内阻);
- 覆盖两个统计量(中位数和 IQR);
- 给出业务判断(可合并处理)。
★ 但也要能识别"真正的差异"
中位数一样、箱体高度也接近   → 无差异
中位数一样、但箱子比别人高一截 → 离散度差异(工艺一致性差)
中位数差得多、箱子一样       → 系统性偏移(工艺参数不同)
中位数和箱子都差得多 → 两个总体这四种情况对应的业务问题完全不同(见 38.6)。
38.6 ★ "中位数一样但离散度不同"意味着什么
这是本章最重要的一节。
中位数一样  → 平均水平相同
IQR 更大    → 个体离散度更大 → 工艺一致性更差
点开:四种情况对应的业务问题
四种组合
情况 A:中位数一样,IQR 一样
┌─────┐  ┌─────┐
│     │  │     │
├─────┤  ├─────┤
└─────┘  └─────┘
  A 批    B 批
→ 无差异

情况 B:中位数一样,IQR 不同
┌─────┐     ┌───────┐
│     │     │       │
├─────┤     ├───────┤
└─────┘     └───────┘
  A 批        B 批
→ 平均水平相同,但 B 批一致性差

情况 C:中位数不同,IQR 一样
┌─────┐
│     │
├─────┤
└─────┘
    ┌─────┐
    │     │
    ├─────┤
    └─────┘
  A 批    B 批
→ 系统性偏移,但波动范围相同

情况 D:中位数和 IQR 都不同
→ 可能是两个不同的总体
对应的业务问题
| 情况 | 业务含义 | 该查什么 |
|---|---|---|
| A 无差异 | 工艺稳定 | (不用查,可以做合并分析) |
| B 离散度差异 | 工艺一致性差 | 单支电芯的一致性、分选环节、原材料均匀性 |
| C 中心偏移 | 工艺参数不同 | 配方、设备设定、环境条件 |
| D 都不同 | 可能是两个总体 | 先确认"这两批是不是同一工艺" |
★ 为什么这个区分重要
因为"批间差异"和"批内差异"的处理方式完全不同:
批间差异(批次 A 整体偏高)
  → 查"这一批的生产条件和其他批有什么不同"
  → 解决方案:调整工艺参数、追溯来料批次

批内差异(同一批里散得开)
  → 查"同一批内为什么个体差异大"
→ 解决方案:改善工序一致性、增加分选环节、检查原材料均匀性如果误判:
把"批内差异大"当成"批间差异"处理 → 去调工艺参数,做了无用功
把"批间差异"当成"批内差异"处理   → 没发现工艺参数变了,问题持续
★ 一个量化的分析方法
# 批间差异 vs 批内差异
per_batch = df.groupby("batch")[COL].agg(["median", "std"])
between = per_batch["median"].max() - per_batch["median"].min()   # 批间
within = per_batch["std"].mean()                                   # 批内平均

print(f"批间中位数极差: {between:.3f}")
print(f"批内标准差均值: {within:.3f}")
print(f"批间 / 批内 = {between / within:.3f}")判读:
| 比值 | 含义 |
|---|---|
| < 0.3 | 差异主要来自批内(个体差异) |
| 0.3 ~ 1.0 | 两者都有贡献 |
| > 1.0 | 差异主要来自批间(工艺差异) |
★ 更严格的做法:方差分析(ANOVA)
上面那个比值是"启发式",正式的判断要用 ANOVA:
from scipy import stats

groups = [df.loc[df["batch"] == b, COL].to_numpy() for b in sorted(df["batch"].unique())]
f_stat, p_value = stats.f_oneway(*groups)
print(f"F = {f_stat:.4f}, p = {p_value:.6f}")判读:
| p 值 | 结论 |
|---|---|
| p < 0.05 | 批次间有显著差异(拒绝"无差异"的原假设) |
| p ≥ 0.05 | 无显著差异(不能拒绝原假设) |
⚠ 两条纪律:
① "p ≥ 0.05"不等于"证明无差异" —— 它只是说"数据不足以证明有差异"。样本量小时很容易得到这个结果。
② p 值受样本量影响很大 —— 1.4 万行数据下,很小的差异也可能显著。
# 报告里要同时给"效应量"(差异多大)和"p 值"(是否显著)
# 只报 p 值不报效应量是常见的误导
★ 总结:一张判断表
| 现象 | 统计判据 | 业务含义 | 行动 |
|---|---|---|---|
| 中位数差大、p<0.05 | 中心偏移显著 | 工艺参数不同 | 查配方/设备 |
| IQR 差大、p<0.05 | 离散度差异显著 | 一致性差 | 查工序/分选 |
| 都不显著 | p≥0.05 | 工艺稳定 | 合并分析 |
| 都差很多 | p<0.001 | 可能是两个总体 | 先确认工艺流程 |
38.7 按循环阶段分组:分布随老化整体右移
df["stage"] = pd.cut(df["cycle"], bins=[0, 300, 600, 900, 1200, 1500],
labels=["0-300", "300-600", "600-900", "900-1200", "1200+"])真实输出:
  阶段             n     中位数     IQR
  0-300        3600    42.05    11.04
  300-600      3600    49.56    13.04
  600-900      3500    59.76    15.56
  900-1200     2372    66.69    17.49
1200+ 895 76.84 20.36结果:
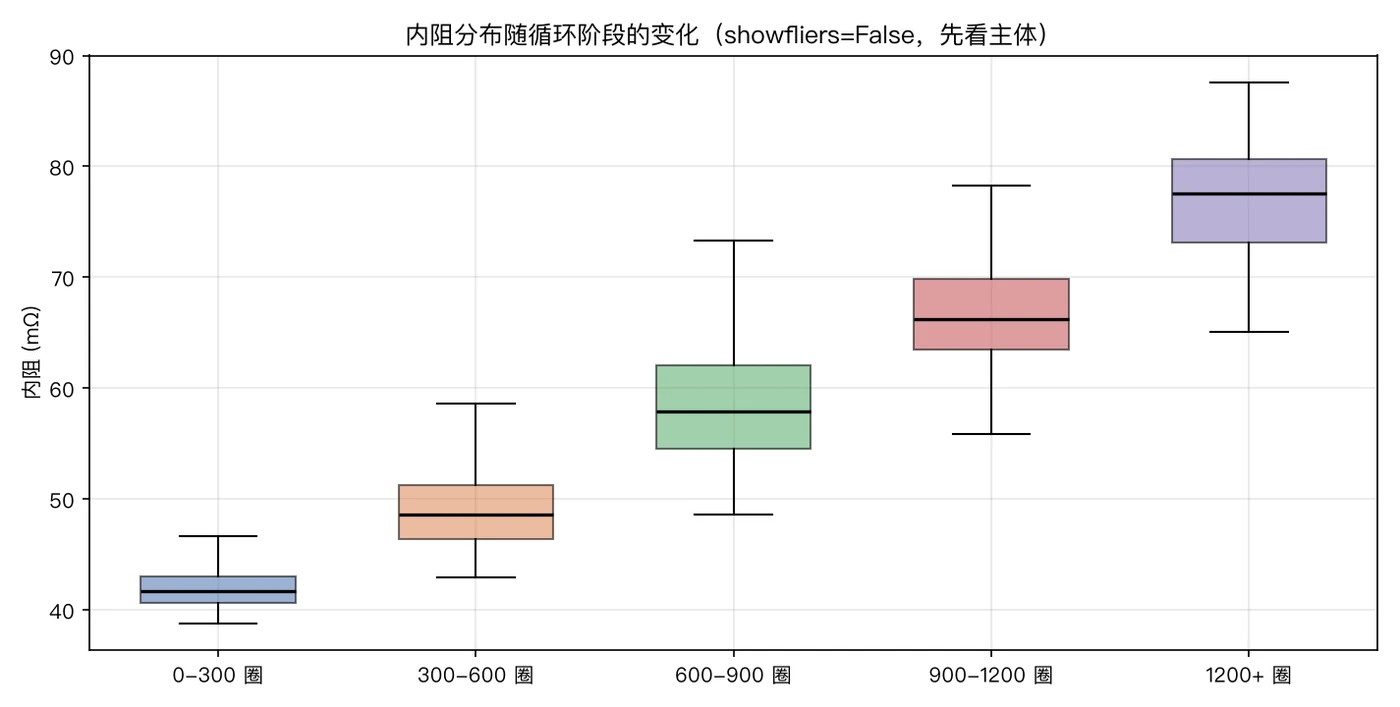
→ 中位数从 45 一路涨到 70+:老化在推进。
→ 同时箱体也在变高:越到后期,个体差异越大(衰退速度不一致)。
点开:为什么"箱体随老化变高"是一个重要发现?
两个现象:
① 中位数右移 —— 内阻整体上升(老化的直接表现)。
② 箱体变高(IQR 从 11.04 涨到 20.36,涨了 84%) —— 个体差异随老化放大。
为什么第 ② 点重要:
如果老化的过程中,所有电芯"同步退化":
  → 中位数上升,但 IQR 不变(整体平移)

实际上是:
  → 中位数上升,IQR 也扩大(有的退得快、有的退得慢)
→ 说明"衰退速度的差异"在积累这个发现的业务含义:
越到寿命后期,电芯之间的差异越大 —— 所以"用平均值代表一批电芯"在后期越来越不靠谱。
在实践上的影响:
| 阶段 | 用平均值可靠吗 |
|---|---|
| 早期(0~300 圈) | ✅ 可靠(IQR 小,个体接近) |
| 后期(1200+ 圈) | ❌ 不可靠(IQR 大,个体差异显著) |
所以"整批健康度"这个指标,在寿命后期应该改用"分布"来描述, 而不是"平均值"。
★ 一个验证方法
# 看 IQR 随循环的变化趋势
pivot = df.pivot_table(index="cycle", columns="cell_id", values=COL)
iqr_by_cycle = (pivot.quantile(0.75, axis=1) - pivot.quantile(0.25, axis=1))

fig, ax = plt.subplots(figsize=(9, 4.5))
ax.plot(iqr_by_cycle.index, iqr_by_cycle, color=PALETTE[0], lw=1.5)
ax.set_xlabel("循环次数 (次)")
ax.set_ylabel("跨电芯 IQR (mΩ)")
ax.set_title("内阻离散度随循环的变化")
如果曲线单调上升 → 证实"个体差异随老化放大"。
★ 这个现象叫"一致性衰减(consistency degradation)"
它是电池领域的真实问题:一个电池包由几百支电芯串联/并联, 如果电芯的退化速度不一致,短板效应会让整个包提前报废。
所以工业上非常关心"一致性" —— 而箱线图(和 IQR)正是度量一致性的标准工具。
★ 一个实用的报告模板
"内阻分布随循环阶段显著右移(中位数 42.05 → 76.84 mΩ), 同时离散度持续扩大(IQR 11.04 → 20.36 mΩ,扩大 84%)。 这表明电芯的退化速度存在个体差异,且差异随老化积累。 建议:在寿命后期使用分布(而非均值)描述批次状态; 对 IQR 异常扩大的批次,排查分选工艺与原材料一致性。"
38.8 箱线图的三个局限
① 掩盖双峰分布:两坨完全分开的数据可能画出同一个箱子。
   → 配一张直方图或小提琴图(violinplot)交叉验证。
② 不同样本量的箱子不可直接比宽度:样本极少时四分位数本身就不稳。
   本数据 12 支电芯分摊到 4 批,每批 3175~4157 行 —— 样本量够,可以比。
③ 它只描述分布,不提供「差异是否显著」的判定。
   要下「批次间有显著差异」的结论,需要做统计检验(t 检验 / ANOVA)。
验证 ②:
sizes = df.groupby("batch").size()
print(f"各批样本量 {sizes.to_dict()}")
print(f"最多/最少 = {sizes.max() / sizes.min():.2f}")真实输出:
各批样本量 {'A': 3331, 'B': 4157, 'C': 3304, 'D': 3175}
最多/最少 = 1.31
点开:逐个解释这三个局限
局限一:掩盖双峰分布
问题:
真实分布(双峰)              箱线图看起来
    ███                           ┌───────┐
    ███      ███                  │       │
    ███      ███                  ├───────┤
  ──┴────────┴──                  └───────┘
两个完全分开的群体 一个"正常"的箱子为什么会这样:箱线图只用 5 个统计量(min/Q1/中位数/Q3/max) 描述一个分布 —— 5 个数字无法区分"单峰"和"双峰"。
一个具体的例子:
bimodal = pd.Series(np.concatenate([
    np.random.normal(40, 2, 500),        # 群体 A:均值 40
    np.random.normal(70, 2, 500),        # 群体 B:均值 70
]))
print(f"中位数 {bimodal.median():.2f}, IQR {bimodal.quantile(.75) - bimodal.quantile(.25):.2f}")
# 中位数 55, IQR 约 30
# 箱线图会画出一个很宽的箱子 —— 看起来像"一个宽分布"
# 但实际上中间是空的(没有值在 45~65 之间)检测方法:
# ① 直方图
fig, ax = plt.subplots(figsize=(8, 4))
ax.hist(data, bins=50, color=PALETTE[0], alpha=0.7)
ax.set_xlabel(COL)
ax.set_ylabel("频数")

# ② 小提琴图(箱线图 + 核密度)
fig, ax = plt.subplots(figsize=(8, 4.8))
ax.violinplot(data, showmedians=True)

# ③ 检查"箱体内部是否有空洞"
def has_gap(x, bins=20):
    """检查分布是否有明显的空洞(疑似双峰)。"""
    hist, edges = np.histogram(x, bins=bins)
    # 找"中间区域频数接近 0,但两侧都有值"的情况
    mid = len(hist) // 2
    return hist[mid] < hist.max() * 0.05 and hist[:mid].max() > 0 and hist[mid:].max() > 0
★ 实践建议:做分组对比时,箱线图 + 直方图一起看。
局限二:不同样本量的箱子不可比
问题:四分位数的稳定性依赖样本量。
# 5 个样本
small = pd.Series([45, 52, 61, 70, 85])
print(f"Q1={small.quantile(.25)}, Q3={small.quantile(.75)}")

# 5000 个样本
big = pd.Series(np.random.normal(55, 10, 5000))
print(f"Q1={big.quantile(.25):.2f}, Q3={big.quantile(.75):.2f}")
小样本的 Q1/Q3 只由排序后的第 1~2 个值决定 —— 少一个值、多一个值,Q1/Q3 可能差很多。
经验规则:
| 每组样本量 | 箱线图可信度 |
|---|---|
| < 30 | ❌ 不可信 |
| 30 ~ 100 | ⚠️ 参考 |
| > 300 | ✅ 可信 |
| > 1000 | ✅ 很稳 |
本数据每批 3175~4157 行,完全够用。
★ 一个相关的坑:样本量差异太大时
# A 批 10000 行、B 批 50 行
# A 的箱体很"紧"(四分位数稳定)
# B 的箱体很"松"(四分位数不稳)
# → 直接比较会误以为"B 的离散度更大"修复:
# ① 至少报出样本量,让读者自己判断
ax.set_xticklabels([f"批次 {b}\n(n={sizes[b]:,d})" for b in batches])

# ② 或者对每组做等量抽样
n_min = df.groupby("batch").size().min()
balanced = df.groupby("batch", group_keys=False).apply(
    lambda g: g.sample(n=n_min, random_state=42))
① 更简单也更有信息量 —— 读者看到 (n=50) 就知道要谨慎。
局限三:不提供"差异是否显著"的判定
问题:箱线图只描述分布,不告诉你"这个差异是否是随机的"。
一个具体的场景:
批次 A 中位数 52.60,CI 批次 B 中位数 53.85
差异 1.25 mΩ —— 这是"真实差异"还是"抽样波动"?
箱线图回答不了这个问题。 需要统计检验:
from scipy import stats

# 两组比较:t 检验(或 Mann-Whitney U 检验)
a = df.loc[df["batch"] == "A", COL]
b = df.loc[df["batch"] == "B", COL]
t, p = stats.ttest_ind(a, b, equal_var=False)
print(f"t = {t:.4f}, p = {p:.6f}")

# 多组比较:单因素方差分析
groups = [df.loc[df["batch"] == g, COL].to_numpy() for g in sorted(df["batch"].unique())]
f, p = stats.f_oneway(*groups)
print(f"F = {f:.4f}, p = {p:.6f}")判读(p < 0.05 通常认为"显著"):
| p 值 | 结论 |
|---|---|
| p < 0.05 | 有显著差异 |
| p ≥ 0.05 | 无显著差异(数据不足以证明有差异) |
★ 两条重要提醒
① "p ≥ 0.05" ≠ "证明无差异"。
它只是说"在现有样本量下,没发现足够强的证据"。
样本量小的时候,很容易得到 p ≥ 0.05。所以报告里要写:"未发现显著差异(p = 0.42)", 而不是"证明无差异"。
② 必须同时报告"效应量"。
样本量 1.4 万时,0.01 mΩ 的差异都可能 p < 0.05(显著,但毫无实际意义)

样本量 20 时,10 mΩ 的差异也可能 p > 0.05(不显著,但差异很大)所以:
# 报告里同时给出
print(f"中位数差 {abs(a.median() - b.median()):.3f} mΩ(效应量)")
print(f"p = {p:.4f}(显著性)")
两个都看,才能判断"这个差异值不值得关注"。
★ 箱线图 + 检验 = 完整的对比分析
箱线图:告诉我"看起来有差异吗"、"差异体现在哪(中心/离散度)"
检验  :告诉我"这个差异是否可靠"
效应量:告诉我"这个差异值不值得关注"
三者缺一不可。
38.9 完整示例与输出
cd code
python demos/ch38-boxplot.py
真实输出(节选):
=== ② 先算数,再画图(顺序别反) ===
  批次      n      Q1    中位数      Q3     IQR
  A      3331   44.48   52.60   63.14   18.66
  B      4157   44.91   53.85   65.41   20.50
  C      3304   44.72   53.19   64.31   19.60
  D      3175   44.00   51.26   60.65   16.65

  最不一致的是:批次 B(IQR = 20.50)
  最一致的是  :批次 D(IQR = 16.65)

=== ④ 换成 SOH 再看一遍 ===
  中位数 0.9069~0.9154,IQR 都约 0.1040 —— 离散度几乎一样。

=== ⑤ ★ 怎么读「没有差异」这个结论 ===
  四批的中位数几乎一样、箱体高度也接近 → 「批次间没有明显差异」也是一个结论。

=== ⑥ 按循环阶段分组:分布会随老化整体右移 ===
  → 中位数从 45 一路涨到 70+:老化在推进。
  → 同时箱体也在变高:越到后期,个体差异越大。
本章练习
练习 1:画批次箱线图并回答"哪一批最不一致"
- 对每个批次算 Q1 / 中位数 / Q3 / IQR,打印成表;
- 画
resistance_mohm的箱线图(patch_artist=True+ 上色)保存; - 找出 IQR 最大 / 最小的批次;
- 换成
soh再画一张,打印各批统计; - 写一句结论:批次间有没有差异?
参考答案
import os
import sys
from pathlib import Path

import pandas as pd

CODE_DIR = Path(__file__).resolve().parent.parent.parent
sys.path.insert(0, str(CODE_DIR))
os.environ.setdefault("MPLCONFIGDIR", str(CODE_DIR / ".mplconfig"))

import matplotlib.pyplot as plt                                  # noqa: E402
from common.plots import PALETTE, setup_style, save_fig          # noqa: E402

OUT = CODE_DIR / "outputs"
setup_style()
df = pd.read_csv(CODE_DIR / "data" / "battery" / "cycle_raw.csv")
batches = sorted(df["batch"].unique())


def batch_stats(col):
    """返回 {批次: (Q1, 中位数, Q3, IQR, n)}。"""
    out = {}
    for b in batches:
        s = df.loc[df["batch"] == b, col]
        q1, q2, q3 = s.quantile(0.25), s.median(), s.quantile(0.75)
        out[b] = (q1, q2, q3, q3 - q1, len(s))
    return out


def draw(col, ylabel, title, path):
    data = [df.loc[df["batch"] == b, col].to_numpy() for b in batches]
    fig, ax = plt.subplots(figsize=(8, 4.8))
    bp = ax.boxplot(data, patch_artist=True, widths=0.6,     # ★ patch_artist
                    medianprops=dict(color="black", lw=1.6))
    for patch, color in zip(bp["boxes"], PALETTE):
        patch.set_facecolor(color)
        patch.set_alpha(0.55)
    ax.set_xticks(range(1, len(batches) + 1), [f"批次 {b}" for b in batches])
    ax.set_ylabel(ylabel)
    ax.set_title(title)
    save_fig(fig, str(path))


# ①② 内阻
COL = "resistance_mohm"
stats = batch_stats(COL)
print(f"{'批次':<6}{'n':>7}{'Q1':>9}{'中位数':>9}{'Q3':>9}{'IQR':>9}")
for b, (q1, q2, q3, iqr, n) in stats.items():
    print(f"{b:<6}{n:>7,d}{q1:>9.2f}{q2:>9.2f}{q3:>9.2f}{iqr:>9.2f}")
draw(COL, "内阻 (mΩ)", "各批次内阻分布对比", OUT / "ch38_exercise_resistance.png")

# ③ 最不一致 / 最一致
iqrs = {b: v[3] for b, v in stats.items()}
widest, narrowest = max(iqrs, key=iqrs.get), min(iqrs, key=iqrs.get)
print(f"\n最不一致: 批次 {widest}(IQR = {iqrs[widest]:.2f})")
print(f"最一致  : 批次 {narrowest}(IQR = {iqrs[narrowest]:.2f})")

# ④ SOH
stats_soh = batch_stats("soh")
print()
for b, (q1, q2, q3, iqr, n) in stats_soh.items():
    print(f"{b:<6}{q1:>9.4f}{q2:>9.4f}{q3:>9.4f}{iqr:>9.4f}")
draw("soh", "SOH", "各批次 SOH 分布对比", OUT / "ch38_exercise_soh.png")真实输出:
批次      n      Q1    中位数      Q3     IQR
A      3331   44.48   52.60   63.14   18.66
B      4157   44.91   53.85   65.41   20.50
C      3304   44.72   53.19   64.31   19.60
D      3175   44.00   51.26   60.65   16.65

最不一致: 批次 B(IQR = 20.50)
最一致  : 批次 D(IQR = 16.65)

A      0.8557    0.9095    0.9600    0.1043
B      0.8551    0.9085    0.9587    0.1036
C      0.8540    0.9069    0.9575    0.1035
D      0.8599    0.9154    0.9646    0.1048
⑤ 结论:
要分两个指标说:
指标 中位数极差 IQR 极差 结论 resistance_mohm2.59 mΩ 3.85 mΩ 批次 B 离散度偏高 soh0.0085 0.0013 四批几乎一样 综合判断:四个批次在中心位置上无实质差异(中位数极差很小); 内阻的离散度上批次 B 偏高(IQR 20.50 vs 批次 D 16.65,高 23.1%), 但 SOH 的离散度无差异。
建议:四批可合并做整体分析;若要追查一致性, 重点看批次 B 的内阻分布(可能是分选或来料均匀性问题)。
★ 为什么"内阻有差异、SOH 没差异"
SOH 的定义是 1 - 0.20·c^β,每支电芯都从 1.0 走到 0.8 —— 所以 SOH 的分布被"归一化"了,各批自然接近。
而内阻是 40·(1 + γ·c^1.5),绝对水平随 γ 变化 —— 所以内阻的分布差异更大。
这告诉我们:对比分析必须明确"比的是哪个指标"。
完整练习:exercises/ex38-01-boxplot
练习 2:patch_artist=True 为什么必须写?
# 版本 A
bp = ax.boxplot(data)
for patch in bp["boxes"]:
    patch.set_facecolor("skyblue")

# 版本 B
bp = ax.boxplot(data, patch_artist=True)
for patch in bp["boxes"]:
patch.set_facecolor("skyblue")要求:说出两个版本的差异,并解释原因。
参考答案
版本 A:颜色设置完全不生效,而且不报错。
版本 B:箱体被正确上色。
原因:
patch_artist=False(默认) | patch_artist=True | |
|---|---|---|
| 箱体对象类型 | Line2D(线条) | PathPatch(色块) |
能 set_facecolor 吗 | ❌ 不能(线条没有"填充色") | ✅ 能 |
能 set_alpha 吗 | ❌ 无效 | ✅ 能 |
验证:
bp_default = ax.boxplot(data)
print(type(bp_default["boxes"][0]))
# <class 'matplotlib.lines.Line2D'>

bp_patch = ax.boxplot(data, patch_artist=True)
print(type(bp_patch["boxes"][0]))
# <class 'matplotlib.patches.PathPatch'>
★ 为什么这个坑特别隐蔽
因为它是"静默失败":
① 不报错 —— 你以为代码跑通了
② 对象存在(bp["boxes"] 有元素)—— 你以为能设置
③ set_facecolor 也不报错 —— 它只是"不起作用"
你可能会花时间查"是不是颜色值写错了"、"是不是被覆盖了", 而真正的原因是"对象类型不对"。
★ 一般的排查思路
当某个视觉效果不生效时,先确认"对象类型对不对":
# 通用检查
print(type(obj))
print(dir(obj)) # 看看有没有 set_facecolor 这个方法本书出现过的同类"静默失败"(值得记住):
| 场景 | 症状 | 真正原因 |
|---|---|---|
boxplot 上色 | 颜色不变 | 没开 patch_artist |
| 双轴图画图例 | 只显示一条线 | ax.legend() 只认自己的轴 |
twinx 后网格 | 图很脏 | 没写 ax2.grid(False) |
| 链式赋值 | 改了没生效 | Copy-on-Write |
interpolate 跨组 | 数据被污染 | 没 groupby |
float_format | 文件变大 | Pandas 3.0 默认写最短表示 |
这些坑的共同特点:不报错,只是结果不对/不生效。
★ 防御方式
① 关键操作后加验证:
bp = ax.boxplot(data, patch_artist=True)
for patch, color in zip(bp["boxes"], PALETTE):
    patch.set_facecolor(color)
    patch.set_alpha(0.55)
# 验证
assert hasattr(bp["boxes"][0], "set_facecolor")
② 用封装函数(把"正确的写法"固化):
def draw_boxplot(ax, data, labels, colors=PALETTE):
    """画带颜色的箱线图 —— 内置正确的参数。"""
    bp = ax.boxplot(data, patch_artist=True, widths=0.6,   # 参数已设好
                    medianprops=dict(color="black", lw=1.6))
    for patch, color in zip(bp["boxes"], colors):
        patch.set_facecolor(color)
        patch.set_alpha(0.55)
    ax.set_xticks(range(1, len(labels) + 1), labels)
return bp封装的价值:下次调用不会漏参数。
练习 3:为什么"没有差异"也是一个结论?
per_batch = df.groupby("batch")["soh"].agg(["median", lambda s: s.quantile(.75) - s.quantile(.25)])要求:说出"批次间无差异"这个结论的业务价值, 以及如果发现差异该怎么进一步分析。
参考答案
"无差异"的业务价值
它回答了一个重要的业务问题:
"这四个批次是不是来自同一工艺?"
    ↓
"从 SOH 分布看,四批无显著差异"
    → 支持"同一工艺"的假设
→ 后续可以把四批数据合并分析(增大样本量)"确认无差异"直接影响下一步决策:
# 无差异 → 合并分析
df_all = df
print(f"合并后样本量 {len(df_all):,d}")

# 有差异 → 分批次处理
df["batch_code"] = df["batch"].map({"A": 0, "B": 1, "C": 2, "D": 3})
FEATURES = ["cycle", "resistance_mohm", "temp_rise_c", "batch_code"]
★ 报告里该怎么写
❌ 太简单:"四批没有差异。"

✅ 完整:"四个批次的 SOH 中位数在 0.9069~0.9154 之间(极差 0.0085),
        箱体高度(IQR)在 0.1035~0.1048 之间(极差 0.0013)。
        综合判断:批次间无实质差异,四批可视为同工艺产出,
后续分析合并处理。"四个要素:① 具体数字;② 覆盖两个统计量;③ 给出判断;④ 说明影响。
★ 如果发现差异,怎么进一步分析
按"差异类型"分两种:
| 差异类型 | 表现 | 该查什么 |
|---|---|---|
| 中心偏移 | 中位数差得多 | 工艺参数(配方、设备设定) |
| 离散度差异 | IQR 差得多 | 一致性(工序、分选、来料均匀性) |
进一步分析的方法:
# ① 量化"批间 vs 批内"
per = df.groupby("batch")[COL].agg(["median", "std"])
between = per["median"].max() - per["median"].min()
within = per["std"].mean()
print(f"批间/批内 = {between / within:.3f}")
# < 0.3  → 差异主要在批内(个体差异)
# > 1.0  → 差异主要在批间(工艺差异)

# ② 统计检验(多组用 ANOVA)
from scipy import stats
groups = [df.loc[df["batch"] == b, COL].to_numpy() for b in sorted(df["batch"].unique())]
f, p = stats.f_oneway(*groups)
print(f"F = {f:.4f}, p = {p:.6f}")

# ③ 看分布形状(可能是双峰)
fig, ax = plt.subplots()
for b in sorted(df["batch"].unique()):
    ax.hist(df.loc[df["batch"] == b, COL], bins=40, alpha=0.4, label=f"批次 {b}")
ax.legend()
★ 一个重要的提醒
"p ≥ 0.05"不等于"证明无差异":
p ≥ 0.05 只是说"在现有样本量下,没发现足够强的证据"。
样本量小的时候,很容易得到这个结果。

所以报告里写"未发现显著差异(p = 0.42)",
而不是"证明无差异"。而且要同时报告"效应量":
# 样本量 1.4 万时,0.01 mΩ 的差异都可能 p < 0.05(显著但无实际意义)
# 样本量 20 时,10 mΩ 的差异也可能 p > 0.05(不显著但差异很大)

print(f"中位数差 {abs(a.median() - b.median()):.3f} mΩ")   # 效应量
print(f"p = {p:.4f}")                                       # 显著性
两个都看,才能判断"这个差异值不值得关注"。
面向 AI 开发:分布对比是"模型诊断"的必备视角
箱线图在 AI 项目里的核心用途:比较"不同子群的表现",而不是只看总体指标。
★ 一个典型场景:模型在不同子群上的误差
df["err"] = (df["pred"] - df["soh"]).abs()

groups = [df.loc[df["batch"] == b, "err"].to_numpy() for b in sorted(df["batch"].unique())]
fig, ax = plt.subplots(figsize=(8, 4.8))
bp = ax.boxplot(groups, patch_artist=True, widths=0.6)
for patch, color in zip(bp["boxes"], PALETTE):
    patch.set_facecolor(color)
    patch.set_alpha(0.55)
ax.set_xticks(range(1, len(batches) + 1), [f"批次 {b}" for b in batches])
ax.set_ylabel("绝对误差 (MAE)")
ax.set_title("模型在各批次上的误差分布")这张图能回答:
① 各批次的误差中位数差不多吗?    → 有没有系统性偏差
② 哪个批次的箱体特别高?          → 那个批次上模型不稳定
③ 有没有批次存在须外的极端误差?   → 那里有"模型完全搞错"的样本
★ 三种"分群"维度
| 分群依据 | 想发现什么 |
|---|---|
| 业务分组(批次、产线、地区) | 模型在哪个子群表现差 |
| 时间分组(月份、季度) | 模型是否会随时间退化 |
| 预测值分组(低/中/高) | 模型在哪段预测范围内不准 |
第三种最容易被忽略,但最有用:
df["soh_bin"] = pd.cut(df["soh"], bins=[0.8, 0.85, 0.9, 0.95, 1.0])
groups = [df.loc[df["soh_bin"] == b, "err"].to_numpy()
          for b in df["soh_bin"].cat.categories]
# → 看"低 SOH 区"的误差是不是明显更大为什么这个维度重要:
低 SOH 区(< 0.85)恰恰是"该不该退役"的关键判断区间。
如果模型在那里误差大,那它的实用价值就大打折扣 ——
即使总体 MAE 很漂亮。
★ 分布对比 vs 均值对比
| 只比均值 | 比分布(箱线图) | |
|---|---|---|
| 能看出"平均水平差异" | ✅ | ✅ |
| 能看出"稳定性差异" | ❌ | ✅ |
| 能看出"极端情况" | ❌ | ✅(须外的点) |
| 能看出"双峰" | ❌ | ⚠️ 需要配直方图 |
实例对比:
只报均值:
  "批次 A 平均误差 0.012,批次 B 平均误差 0.013 —— 差不多。"

看分布:
  "批次 A 误差中位数 0.011、IQR 0.008(稳定)
   批次 B 误差中位数 0.012、IQR 0.025(不稳定)
   → 虽然均值接近,但批次 B 上有大量"误差很大"的样本,
     说明模型在批次 B 上不可靠。"
第二段结论是"只比均值"永远发现不了的。
★ 一条纪律
报告模型效果时,除了总体指标, 必须至少给一个"分组分布"的视角。
这和第 35 章"报告分组的误差"是同一个原则:
| 章节 | 教训 |
|---|---|
| 第 24 章 | 拿到表先 describe(),别只看一个数 |
| 第 32 章 | 均值会被异常值带偏,要看分布 |
| 第 38 章 | 分组对比要看分布,不能只比均值 |
| 第 39 章 | 报告里每个结论都要能追到某个统计量或图 |
这四章串起来,就是"用数据说话"的完整方法。