第 07 章 · 预测与可视化:一条直线能回答"什么时候退役"吗
这一章要解决什么:把直线用起来 —— 正向预测、反向反解、画在图上。 然后回答一个业务上真正被问到的问题:"我这支设备什么时候退役?"
最容易踩的坑: ① 把"横截面回归"的预测当成某一支设备的寿命 —— 全表拟合出来的退役点 1347 圈,而 60 支设备实际有 80% 在它之前就停止记录了; ② 外推区(
cycle > 1440)的预测写法和内插区一模一样,从数字上看不出区别; ③ 画图时不设中文字体,图上全是方框(这不是"美观问题",是"读不懂")。
本章你需要完成的代码:demos/ch07-predict-and-line.py
7.1 predict() 的基本用法
fit 之后,predict 是唯一还需要学的动作:
model = LinearRegression().fit(df[["cycle"]], df["soh"])
grid = pd.DataFrame({"cycle": np.linspace(0, 1600, 7)})   # 一张表,不是一维数组
y_grid = model.predict(grid)真实输出:
  模型:soh ≈ -0.00014620 × cycle + 0.996891   (整表 R² = 0.834759)
  喂一张 DataFrame(列名和训练时一致,形状 (7, 1)):
    cycle =       0  →  预测 soh = 0.9969   ← 外推,无数据支持
    cycle =     267  →  预测 soh = 0.9579
    cycle =     533  →  预测 soh = 0.9189
    cycle =     800  →  预测 soh = 0.8799
    cycle =    1067  →  预测 soh = 0.8409
    cycle =    1333  →  预测 soh = 0.8020
    cycle =    1600  →  预测 soh = 0.7630   ← 外推,无数据支持
  ★ 数据范围是 50 ~ 1440;0 圈和 1600 圈都是模型自己「编」出来的。
★ 三个必须记住的写法细节:
| 写法 | 结果 |
|---|---|
model.predict(grid)(DataFrame) | ✅ 无警告,列名对齐 |
model.predict(grid["cycle"])(Series) | ❌ 报错:不是二维 |
model.predict(np.array([[500.0]])) | ⚠️ 能跑,但丢列名(第 04 章 4.6) |
为什么坚持用 DataFrame(第 04 章已经说过,这里是它的第一次实际使用):
# 特征多的时候,DataFrame 按【名字】对齐,不按位置
model.predict(pd.DataFrame({"resistance_mohm": [50.0], "cycle": [500.0]}))
# 顺序反了也没关系 —— 名字对上了就对
★ predict 的输出形状和 y 一样:
y.shape            # (21239,)
model.predict(X).shape    # (21239,)     ← 一个样本一个预测值
grid.shape         # (7, 1)
model.predict(grid).shape # (7,)         ← 7 个样本 7 个预测值
这个对应关系是"一行进去、一个数出来",不会多也不会少。
7.2 外推:模型不会说"我不知道"
看上面输出里的两行:
cycle =       0  →  预测 soh = 0.9969   ← 外推
cycle = 1600 → 预测 soh = 0.7630 ← 外推为什么说它们"没有数据支持":
数据范围:cycle ∈ [50, 1440]
   ↓
0 圈     ← 在范围左边
1600 圈  ← 在范围右边
   ↓
这两处的预测值,是把直线【延长】出去算的
★ 直线上没有任何标记能告诉你"这里开始不可信":
model.predict(pd.DataFrame({"cycle": [1400]}))    # 0.7922   ← 有数据
model.predict(pd.DataFrame({"cycle": [1600]}))    # 0.7630   ← 外推
# 两次调用的写法、输出形式、数字精度,完全相同
这是第 03 章那句话的第二次出现:
外推的结果看起来和正常预测一模一样。
所以"标注外推"这件事必须你自己做:
lo, hi = df["cycle"].min(), df["cycle"].max()
for c, p in zip(grid["cycle"], model.predict(grid)):
    tag = "" if lo <= c <= hi else "   ← 外推,无数据支持"
    print(f"  cycle = {c:6.0f}  →  预测 soh = {p:.4f}{tag}")
★ 这一段在真实项目里最常见的翻车方式
"模型预测设备在第 1600 圈时健康度 0.763"
   ↓
"所以我们把维护窗口定在 1500 圈吧"
   ↓
但 1500 圈处【一个样本都没有】
   ↓
这个规划建立在一段"数学上合法、数据上为零"的区域上
点开:外推的三种危险程度(不是所有外推都一样糟)
同样是"超出训练范围",危险程度差很多。分三档看:
第一档:范围外的近邻(危险低)
训练范围 [50, 1440],预测 cycle = 1450
   ↓
只超出 0.7%
   ↓
如果直线形状差不多,风险不大 —— 但要知道你在赌"形状不变"
第二档:远离数据的延长(危险高)
预测 cycle = 3000(超出 108%)
   ↓
直线继续往下走 → soh = 0.5583(第 03 章练习 2 算过)
   ↓
"容量只剩 56%" —— 数学合法,物理荒谬
第三档:跨过了机制改变的边界(最危险)
设备在 0.80 附近就停止采样(退役线)
   ↓
所以你预测 3000 圈时,其实是在假设"0.80 以下的退化规律和上面一样"
   ↓
但这个假设【没有任何数据可以检验】
★ 三档的共同问题:
模型不会区分这三档
   ↓
它在 1450、3000、3000 万 处都给你一个确定的数字
★ 一个可以放进代码的判据
def extrapolation_level(x, lo, hi):
    if lo <= x <= hi:
        return "内插(有数据)"
    gap = (lo - x) if x < lo else (x - hi)
    return f"外推 {100 * gap / (hi - lo):.0f}%(无数据支持)"

print(extrapolation_level(3000, 50, 1440))     # 外推 108%(无数据支持)
★ 为什么第 24~25 章要专门讲高斯过程
线性回归的外推:给一个数,不告诉你"这里很虚"
高斯过程的外推:置信带自己张开
     cycle = 1440(数据边界)→ ±0.0101
     cycle = 1500(外推区)  → ±0.1094   ← 涨了 11 倍
一个诚实的模型应该能说"这里我没见过,我不敢下结论"。
线性回归不会说这句话。所以这句话得由你(用代码和标注)来说。
7.3 ★ 横截面回归:它到底在拟合什么?
先把名字说清楚:
横截面(cross-sectional)回归:
   把表里【所有行】放在一起,拟合【一条】直线
   ↓
本书的做法:21,239 行 → 1 条线 → 2 个参数(coef_、intercept_)

个体(per-unit / per-entity)回归:
   对每一支设备【各拟合一条】直线
   ↓
60 支设备 → 60 条线 → 120 个参数
★ 关键问题:那条池化直线,究竟在描述什么?
真实输出:
  取 cycle ∈ [990, 1010] 的所有行(305 行,来自 39 支设备):
    这些行的 soh:min 0.8094 / 中位 0.8550 / max 0.8887
    标准差 = 0.0205,极差 = 0.0793
    池化直线在 cycle=1000 给出的唯一答案 = 0.8507
★ 直线只会说「大约 0.85」;真实的那 39 支设备分布在 0.809 ~ 0.889 之间。把这一段读三遍,它是这一章的核心:
在 cycle ≈ 1000 这个"时刻",同时存在 39 支设备
   ↓
它们的 soh 从 0.8094 到 0.8887 —— 相差 7.9 个百分点
   ↓
池化直线给出的答案:0.8507
   ↓
0.8507 大致等于"这 39 支的中位数(0.8550)附近"
   ↓
【它是一条"平均值曲线",不是一个"个体轨迹"】
★ 换一个说法,这件事就非常清楚了:
池化直线:
    对每个 cycle,回答"所有设备在那个时刻的平均健康度是多少"
   ↓
个体轨迹:
    对每支设备,回答"它在自己的时间里怎么掉下去"
这是两个不同的问题。
★ 一个时间轴上的类比(很贴切)
横截面回归 ≈ "把 60 个人的身高体重混在一起,拟合一条身高→体重的线"
   ↓
它回答:"身高 170cm 的人,平均体重是多少"
   ↓
它不回答:"张三减重 5 公斤后是多少"

个体回归 ≈ "对每个人各拟合一条"
   ↓
它才可能回答后者
⚠️ 但要注意:本书的数据里,"个体"和"时间"是一一对应的 (每支设备都有自己的时间刻度),所以这个类比要再补一句:
本书的数据:
   一行 = (设备, 窗口)
   ↓
   池化 = "在 cycle = 1000 时,所有设备平均 0.8507"
   个体 = "C001 在它自己的 cycle = 800 时是 0.8183"
   ↓
   两者用的是同一个横轴(cycle),含义完全不同
7.4 每支设备各自拟合:直线的"形式"错了吗?
做对照实验:对 60 支设备各拟合一条直线。
真实输出:
  每支设备各自拟合一条直线(60 条),其中 60 条斜率是负的,有确定的反解点:
    各自反解的 EOL:min 816 / 中位 1223 / max 1570 圈
  斜率本身分布:min -0.00025305 / 中位 -0.00016977 / max -0.00013263
  这 60 条各自的 R²:min 0.9789 / 中位 0.9967 / max 0.9990
  ★ 60 支的斜率全是负的:直线的【形式】没问题,问题出在把它们【合并成一条】。
★ 这一节最重要的发现:
每支设备【自己】的直线,R² 中位数是 0.9967
   ↓
对单支设备来说,"退化是线性的"这个假设【非常好】
   ↓
所以池化直线的 0.8348 不是因为"直线这种形式不行"
   ↓
而是因为"60 条斜率不同的线,被强行平均成了一条"把斜率分布摆出来看:
| 统计量 | 值 | 含义 |
|---|---|---|
| 最陡的(min) | -0.00025305 | 每 100 圈掉 2.53 个百分点 |
| 中位 | -0.00016977 | 每 100 圈掉 1.70 个百分点 |
| 最平的(max) | -0.00013263 | 每 100 圈掉 1.33 个百分点 |
最陡 / 最平 = 0.00025305 / 0.00013263 = 1.91 倍
   ↓
同样的圈数,一支设备掉 1.91 倍的量
   ↓
池化直线的斜率 -0.00014620 落在【偏平的那一侧】
   (比中位数 -0.00016977 还平)
⚠️ 注意最后一句话:池化直线的斜率不等于个体斜率的中位数。 因为池化是"最小化全体平方误差",它会被数量多、方差大的那段数据拉走。
数据里 60 支设备的行数不一样(235 ~ 464 行)
   ↓
行数多的设备,在池化拟合里的"话语权"更大
   ↓
池化直线偏向它们
★ 这是"聚合"的普遍规律:
把个体合并成一个模型时,你得到的不是"平均的个体", 而是"误差平方和最小的那个折中"。
★ 那为什么还要用池化回归?
"平均趋势"本身是有用的:
   · 做整体产能/维护预算 → 需要的就是平均
   · 做异常检测 → 偏离平均线的个体才值得看
   · 做第一版基线 → 它最便宜

它不能做的:
   · 回答"某一支还有多久"
   · 区分"哪支快、哪支慢"(它把差异全抹平了)
7.5 反解退役点:1347 圈
这是这一章的业务落点。
x_eol = (0.80 - model.intercept_) / model.coef_[0] # 1347真实输出:
  池化直线(把 21,239 行当成一个整体)说:
    soh 降到 0.8 需要 1347 圈
  每支设备的末次记录 cycle:
    min 752 / 中位 1117 / max 1440
  池化直线反解的 1347 圈落在第 80 百分位
  末次记录 < 1347 的设备:48 / 60 支(80%)
  中位设备差了 230 圈 —— 相当于 21% 的寿命
  ★ 「平均退役点」比一半以上设备的实际退役点晚。
★ 这 6 行数字,就是这一章的全部结论:
| 数字 | 来源 | 含义 |
|---|---|---|
| 1347 圈 | 池化的直线反解 | "平均退役点" |
| 1117 圈 | 60 支设备末次记录的中位数 | "典型设备的实际退役点" |
| 752 ~ 1440 圈 | 60 支末次记录的极值 | "个体差异的真实范围" |
| 第 80 百分位 | 1347 在末次记录分布里的位置 | "1347 偏晚" |
| 80% | 末次记录 < 1347 的比例 | "多数设备等不到它" |
| 230 圈 / 21% | 1347 − 1117,除以 1117 | "偏晚的幅度" |
★ 用一句话说清这个差距:
把池化直线的答案(1347 圈)当成"每支设备的退役时间", 对 80% 的设备来说都会说晚 —— 中位的那一支要晚 230 圈,约等于它寿命的 21%。
现在把"说晚了多少"逐支量化:
真实输出:
  把池化直线的答案(1347 圈)拿去回答 60 支设备各自的问题:
    绝对误差:中位 230 圈 / 最大 595 圈
    说晚了(危险):48 支,最多晚 595 圈
    说早了(保守):12 支,最多早 93 圈
    C032:直线说 1347 圈,它实际在 752 圈就掉到 0.8146 了 → 说晚了 595 圈
    C031:直线说 1347 圈,它实际在 756 圈就掉到 0.8126 了 → 说晚了 591 圈
    C016:直线说 1347 圈,它实际撑到 1440 圈 → 说早了 93 圈
  ★ 最大的那次「说晚了」595 圈 ≈ 中位寿命 (1117 圈) 的 53%。
★ 误差是"不对称"的,这比误差大更糟:
说晚了:48 支(80%)—— 会漏掉维护窗口
说早了:12 支(20%)—— 只是保守,代价是提前换了还能用的设备
   ↓
"不对称"意味着:这个错误会【系统性地】往危险的方向偏
★ 一个必须说清的因果关系
不是"直线算错了"
   ↓
而是"直线回答的不是这个问题"
   ↓
C032 在 752 圈掉到 0.8146 —— 直线从来没有为 C032 拟合过
    它拟合的是"所有设备在各自圈数上的平均水平"
★ 这三个数字并排放在一起,就是这个错误的全貌:
池化直线说:           1347 圈      ← 一个数,语气确定
各支设备的实际值:     752 ~ 1440   ← 一个分布,宽度 688 圈
中位设备:             1117 圈
   ↓
用"一个数"去回答"一个分布"里的每一个成员
   ↓
"1347" 这个答案的有效范围,只覆盖了这个分布的一小部分
7.6 画图:把这两件事画在同一张图上
真实输出:
=== ⑥ 画图 ===
[plots] 图已保存: .../outputs/ch07-pooled-line.png
[plots] 图已保存: .../outputs/ch07-eol-distribution.png
[plots] 图已保存: .../outputs/ch07-individual-vs-pooled.png
图 1:全部数据 + 池化直线 + 退役线
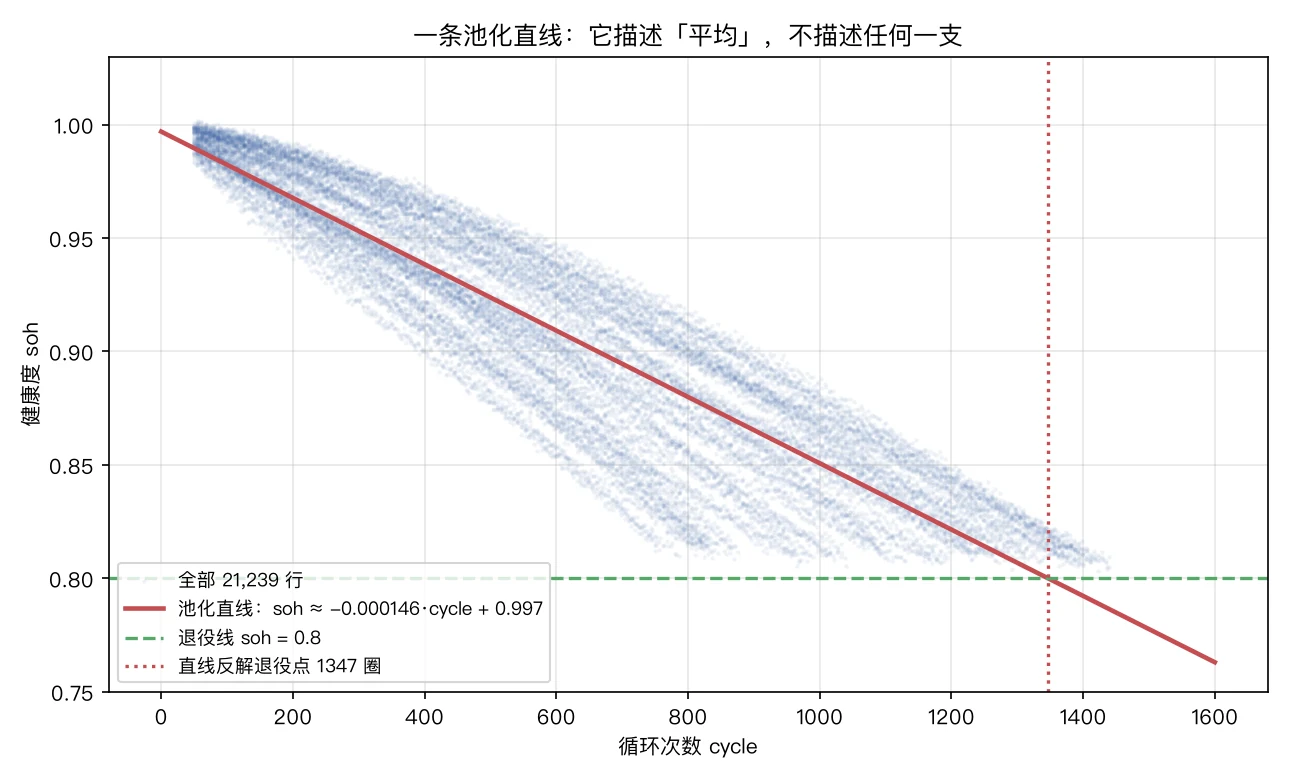
这张图要说的话:
① 散点(浅蓝,透明度 0.05):21,239 行 —— 它们形成一条【带】,不是一个点集
② 红线:池化直线 —— 它穿过这条带的中间
③ 绿色虚线:退役线 soh = 0.80
④ 红色点线:1347 圈 —— 红线与绿虚线的交点
★ 看图要看的不是红线,是散点的"宽度":
如果退化是"所有设备一模一样"
   → 散点会紧贴红线,形成一条细线
   ↓
实际:散点在每个 cycle 上都摊开成一片
   ↓
那一片的宽度,就是"池化直线解释不了的部分"
   ↓
它也正是"横截面回答不了个体问题"的根本原因
图 2:60 支设备实际停在哪里 vs 直线说它们该停在哪里
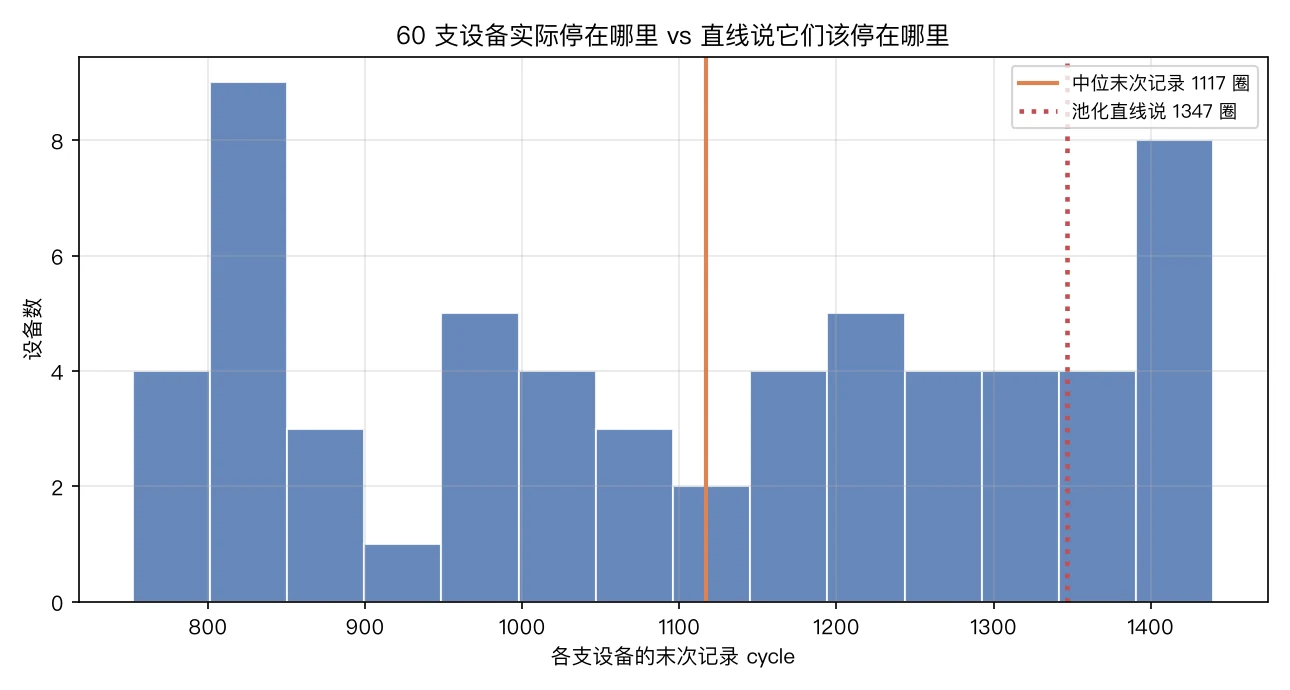
这张图是这一章最有说服力的一张:
橙色竖线:中位末次记录 1117 圈
红色点线:池化直线说的 1347 圈
   ↓
两个竖线之间隔着 230 圈
   ↓
而且 1347 落在了直方图的【右侧】,大部分柱子在它左边
★ 一句话读法:
"60 支设备实际停在哪里"是数据直接告诉你的; "1347 圈"是模型告诉你的。这两件事长得不一样。
图 3:个体轨迹 vs 池化直线
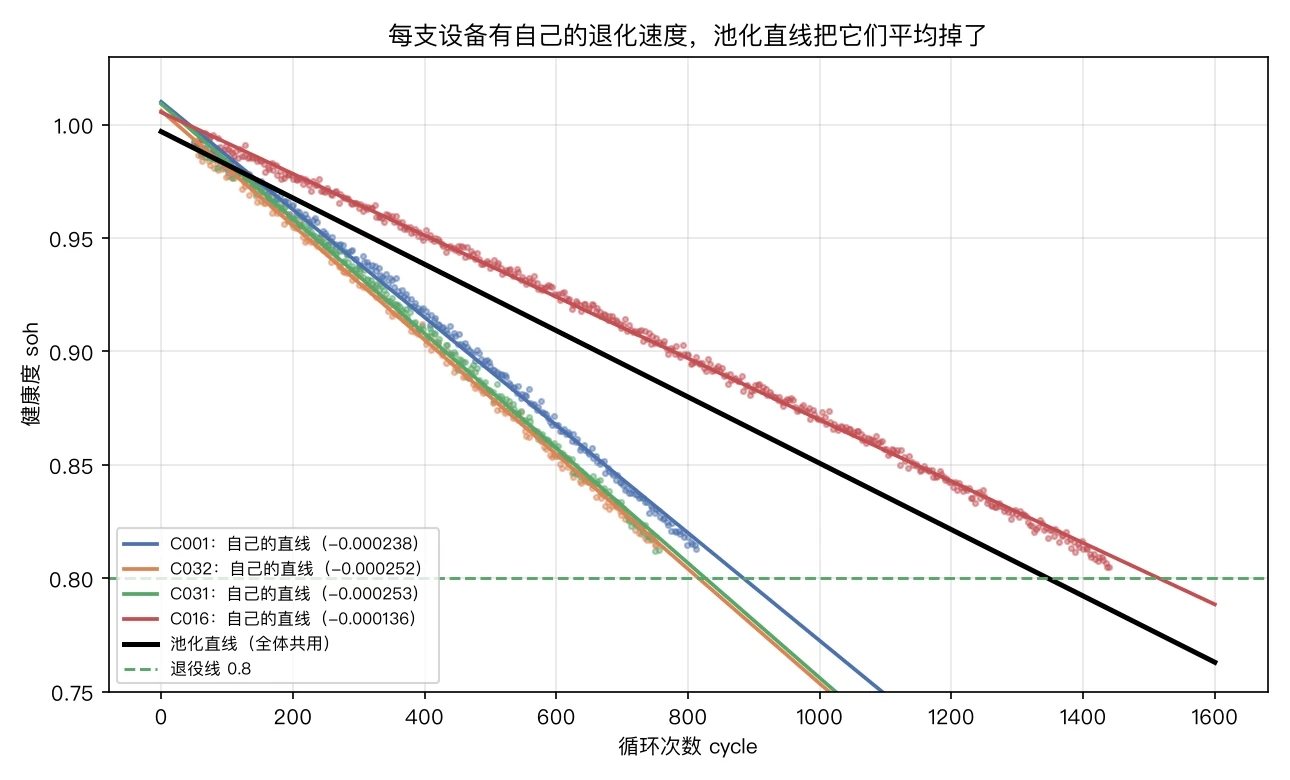
图中:
4 组彩色散点 + 4 条同色的细线:这 4 支设备各自的轨迹和各自的直线
黑色粗线:池化直线(全体共用)
绿色虚线:退役线 0.80
★ 这张图直接展示了"平均"的代价:
C001 / C032 / C031:自己的线比池化线【陡得多】,在 820~880 圈就穿过了 0.80
C016:自己的线比池化线【平得多】,一直撑到 1440 圈
   ↓
池化黑线走在这两组之间
   ↓
结果:对前三支说晚了,对 C016 说早了
★ 一个画图上的选择值得说明:
横轴画到 0 ~ 1600(超出数据范围 50~1440)
   ↓
为的是让读者看见"直线的延续"
   ↓
但同时必须【标注数据范围】,否则图本身就在鼓励外推
这就是"图上也要加限定词"。
点开:画这三张图的代码要点(中文、save_fig、透明度)
① 中文与负号:必须调,否则图上是方框
import os, sys
sys.path.insert(0, CODE)
os.environ.setdefault("MPLCONFIGDIR", os.path.join(CODE, ".mplconfig"))
import matplotlib.pyplot as plt
from common.plots import PALETTE, save_fig, setup_style

font = setup_style()        # ← 设中文字体 + axes.unicode_minus = False
print(f"中文字体:{font}") # 本机实际用到的字体名为什么必须在一开始就调:
matplotlib 默认字体不含中文 → 每个汉字变成一个方框
   ↓
图上读不出"健康度"、"循环次数"
   ↓
这张图就没法用了(不是"不好看",是"没有信息")
setup_style() 里做的三件关键事:
plt.rcParams["font.sans-serif"] = [font] + ["DejaVu Sans"]
plt.rcParams["axes.unicode_minus"] = False    # ← 负号也常变方框
plt.rcParams["axes.prop_cycle"] = plt.cycler(color=PALETTE)
② save_fig:一行搞定"存图 + 建目录 + 打印路径"
save_fig(fig, os.path.join(OUT, "ch07-pooled-line.png"))
# [plots] 图已保存: .../outputs/ch07-pooled-line.png
它比 plt.savefig 多做了三件事:
① os.makedirs(..., exist_ok=True)   → 目录不存在也不会崩
② fig.tight_layout()                → 中文标题不会被裁掉
③ plt.close(fig)                    → 循环画多张图时不会内存泄漏
★ 第 ③ 条在"批量出图"时会要命:不 close 的话, 画 100 张图之后 matplotlib 会警告 More than 20 figures have been opened。
③ 21,239 个散点:必须调透明度
ax.scatter(df["cycle"], df["soh"], s=2, alpha=0.05, color=PALETTE[0])alpha=1.0(默认)→ 一片实心色块,看不出密度分布
s=2 + alpha=0.05 → 密集处颜色深、稀疏处颜色浅
↓
"数据在哪里厚、在哪里薄"这件事才看得出来
↓
而它正是"这条直线可信不可信"的视觉依据④ 一条经验:图的标题就是结论
❌ ax.set_title("cycle vs soh")
✅ ax.set_title("一条池化直线:它描述「平均」,不描述任何一支")
   ↓
   读者看图 3 秒能拿到信息,不用先自己推
本书所有图的标题都写"结论",不写"变量名"。 这也是第 02 章"把分数变成证据"的一个具体做法。
7.7 常见坑
① predict 传一维数组        → ValueError(第 04 章的坑,这里会真的踩到)
② 外推不标注                → 1600 圈的预测和内插的写法完全一样
③ 把 1347 当成"每支设备的寿命" → 80% 的设备在它之前就退役了
④ 只用一条池化直线解释个体   → 单支 R² 中位 0.9967,池化只有 0.8348,差异全在"个体"上
⑤ 图上的中文是方框           → 没调 setup_style()
⑥ 散点不设 alpha            → 21,239 个点糊成一团,看不出分布
⑦ 横轴画到 1600 却不标注范围 → 图本身在鼓励外推
★ ③ 是这一章的"看起来对但其实错":
"1347 圈"这个数字:
   · 有公式支持((0.8-b)/k)
   · 有数据支持(落在训练范围内)
   · 有 R² 背书(0.8348)
   ↓
它唯一的问题是:它回答的不是你问的那个问题
★ 这类错误的共同特征:
数字算对了 + 方法命名对了 + 问题问错了
   ↓
没有任何技术检查能发现它
   ↓
只有"把数字和原始分布放在一起看"才能发现
7.8 完整示例与输出
cd code
MPLCONFIGDIR=/tmp/ex03-work/.mplconfig python demos/ch07-predict-and-line.py真实输出(节选):
=== ① predict() 的基本用法 ===
  cycle =       0  →  预测 soh = 0.9969   ← 外推,无数据支持
  cycle =     800  →  预测 soh = 0.8799
  cycle =    1600  →  预测 soh = 0.7630   ← 外推,无数据支持

=== ② 横截面回归 vs 个体:同一张图里的两件事 ===
  各自反解的 EOL:min 816 / 中位 1223 / max 1570 圈
  这 60 条各自的 R²:min 0.9789 / 中位 0.9967 / max 0.9990

=== ③ 末次记录分布:一个不该被丢掉的真相 ===
    min 752 / 中位 1117 / max 1440
  末次记录 < 1347 的设备:48 / 60 支(80%)

=== ④ 在同一个 cycle 上,个体差异有多大 ===
    这些行的 soh:min 0.8094 / 中位 0.8550 / max 0.8887
    标准差 = 0.0205,极差 = 0.0793

=== ⑤ 一个具体的问题:「我这支还有多久」 ===
    绝对误差:中位 230 圈 / 最大 595 圈
    说晚了(危险):48 支,最多晚 595 圈
本章练习
练习 1:predict 一张网格,并找出"平均"的代价
- 用
cycle = [100, 300, 500, 700, 900, 1100, 1300, 1500]造一张 DataFrame,打印每个预测值; - 标出哪些是外推(训练数据范围是 50 ~ 1440);
- 取
C001在cycle = 800的真实soh,和池化直线的预测值比较,说明差距来自哪里。
参考答案
import pandas as pd
from sklearn.linear_model import LinearRegression

df = pd.read_csv("data/battery/soh_features.csv")
y = df["soh"]
model = LinearRegression().fit(df[["cycle"]], y)
k, b = float(model.coef_[0]), float(model.intercept_)

grid = pd.DataFrame({"cycle": [100.0, 300.0, 500.0, 700.0, 900.0, 1100.0, 1300.0, 1500.0]})
lo, hi = float(df["cycle"].min()), float(df["cycle"].max())
for c, p in zip(grid["cycle"], model.predict(grid)):
    tag = "" if lo <= c <= hi else "   ← 外推,无数据支持"
    print(f"cycle = {c:6.0f}  →  预测 soh = {p:.4f}{tag}")
print(f"训练数据范围:{lo:.0f} ~ {hi:.0f} 圈")

c1 = df[(df["cell_id"] == "C001") & (df["cycle"].between(798, 802))]
real = float(c1.loc[c1["cycle"] == 800, "soh"].iloc[0])
print(f"C001 在 cycle=800 的真实 soh = {real:.4f},池化直线给的是 {k * 800 + b:.4f}")
print(f"差了 {(k * 800 + b) - real:.4f}({((k * 800 + b) - real) * 100:.2f} 个百分点)"
f"—— 这就是「平均」的代价。")期望输出:
cycle =    100  →  预测 soh = 0.9823
cycle =    300  →  预测 soh = 0.9530
cycle =    500  →  预测 soh = 0.9238
cycle =    700  →  预测 soh = 0.8946
cycle =    900  →  预测 soh = 0.8653
cycle =   1100  →  预测 soh = 0.8361
cycle =   1300  →  预测 soh = 0.8068
cycle =   1500  →  预测 soh = 0.7776   ← 外推,无数据支持
训练数据范围:50 ~ 1440 圈
C001 在 cycle=800 的真实 soh = 0.8183,池化直线给的是 0.8799
差了 0.0616(6.16 个百分点)—— 这就是「平均」的代价。
★ 第 2 问:只有 1500 是外推。注意 100 不是外推 —— 数据从 50 圈开始。
这条"边界"很容易记错:
   · 100 > 50          → 在范围内   ✅ 有数据
   · 1500 > 1440       → 超出       ❌ 外推
   ↓
判断外推要用【数据的最小值/最大值】,不是"看起来大不大"
★ 第 3 问的关键:
池化直线:0.8799        ("在 cycle=800 时,所有设备平均 0.8799")
C001 实际:0.8183        ("C001 在它自己的 cycle=800 时是 0.8183")
   ↓
差 6.16 个百分点
   ↓
为什么差?因为 C001 是【退化偏快】的那一类
   它自己的斜率 -0.00023754,池化斜率 -0.00014620
   陡了 62%
★ 6.16 个百分点是什么概念:
退役线 0.80
C001 在 800 圈时已经 0.8183(离退役线只剩 1.83 个百分点)
而池化直线认为它还有 0.8799 − 0.80 = 7.99 个百分点
   ↓
"还剩多少余量"这个判断,被高估了 4.4 倍
⚠️ 这正是"用平均值做个体决策"最典型的事故形态: 不是数字错,是"余量"这个量的尺度感全错了。
练习 2:五支设备各自拟合,看极差
挑 C001、C002、C010、C030、C060 五支设备:
- 每支用
np.polyfit拟合一条直线,反解soh = 0.80对应的cycle; - 打印五支的 EOL 和极差;
- 把极差和池化直线的答案
1347放在一起,用一句话说明"为什么池化直线不能回答个体问题"。
参考答案
import numpy as np
import pandas as pd
from sklearn.linear_model import LinearRegression

df = pd.read_csv("data/battery/soh_features.csv")
y = df["soh"]
pooled = LinearRegression().fit(df[["cycle"]], y)
pooled_eol = (0.80 - float(pooled.intercept_)) / float(pooled.coef_[0])

eols = []
for cid in ["C001", "C002", "C010", "C030", "C060"]:
    g = df[df["cell_id"] == cid]
    kk, bb = np.polyfit(g["cycle"].to_numpy(float), g["soh"].to_numpy(float), 1)
    e = (0.80 - bb) / kk
    eols.append(e)
    print(f"{cid}:自己的直线 soh ≈ {kk:.8f}·cycle + {bb:.4f}  →  反解 EOL = {e:.0f} 圈"
          f"(实际末次记录 {g['cycle'].max():.0f} 圈)")
print(f"五支的 EOL:{' / '.join(f'{e:.0f}' for e in eols)}")
print(f"极差 = {max(eols) - min(eols):.0f} 圈")
print(f"池化直线给所有人同一个答案:{pooled_eol:.0f} 圈")
print(f"对照末次记录分布:{df.groupby('cell_id')['cycle'].max().min():.0f} ~ "
f"{df.groupby('cell_id')['cycle'].max().max():.0f} 圈")期望输出:
C001:自己的直线 soh ≈ -0.00023754·cycle + 1.0100  →  反解 EOL = 884 圈(实际末次记录 812 圈)
C002:自己的直线 soh ≈ -0.00015444·cycle + 1.0189  →  反解 EOL = 1418 圈(实际末次记录 1292 圈)
C010:自己的直线 soh ≈ -0.00014373·cycle + 1.0118  →  反解 EOL = 1473 圈(实际末次记录 1374 圈)
C030:自己的直线 soh ≈ -0.00016281·cycle + 0.9874  →  反解 EOL = 1151 圈(实际末次记录 1130 圈)
C060:自己的直线 soh ≈ -0.00013263·cycle + 0.9905  →  反解 EOL = 1437 圈(实际末次记录 1412 圈)
五支的 EOL:884 / 1418 / 1473 / 1151 / 1437
极差 = 589 圈
池化直线给所有人同一个答案:1347 圈
对照末次记录分布:752 ~ 1440 圈
★ 第 3 问的答案:
五支设备的反解退役点从 884 圈到 1473 圈,极差 589 圈。 池化直线只给一个数字(1347 圈), 它落在这五个数里偏高的位置 —— 对 C001(884)说晚了 463 圈,对 C010(1473)又说早了 126 圈。 一个数字不可能同时答对分布里的每一个成员, 所以池化直线只能回答"平均"。
★ 顺便注意"自己的 EOL"和"实际末次记录"的差别:
C001:自己的直线反解 884 圈,实际末次记录 812 圈     → 差了 72 圈
C010:自己的直线反解 1473 圈,实际末次记录 1374 圈 → 差了 99 圈为什么每条"自己的直线"反解出来的数都比实际末次记录大:
① 数据在 soh ≈ 0.80~0.81 附近就【停止采样】了
     最后几圈的数据不包含"真正掉到 0.80"的那一段
② 直线要从 0.81 继续外推一小段才能到 0.80
   ↓
所以"反解出的 EOL"总是比"实际末次记录"再往后一点
   ↓
它是一次【很小的外推】—— 小到可以接受,但不等于 0
★ 这条观察在真实项目里很重要:
"反解出来的退役点"永远包含一点外推。 数据停止的地方离你要预测的地方有多远,决定了这一点外推值不值得信任。
练习 3:把一支设备画出来(散点 + 自己的线 + 池化线 + 退役线)
选 C012:
- 画它的散点、它自己的拟合直线、池化直线、
soh = 0.80的退役线; - 用
save_fig存到outputs/ex04-07-c012-line.png; - 打印三句话:它自己的反解退役点、池化直线说的退役点、它的末次记录。
要求:图上中文正常显示,标题写成结论而不是变量名。
参考答案
import os
import sys

import numpy as np
import pandas as pd
from sklearn.linear_model import LinearRegression

sys.path.insert(0, ".")                      # 当前目录就是 code/
os.environ.setdefault("MPLCONFIGDIR", "/tmp/ex03-work/.mplconfig")
import matplotlib.pyplot as plt
from common.plots import PALETTE, save_fig, setup_style

df = pd.read_csv("data/battery/soh_features.csv")
y = df["soh"]
EOL = 0.80
pooled = LinearRegression().fit(df[["cycle"]], y)
k, b = float(pooled.coef_[0]), float(pooled.intercept_)
pooled_eol = (EOL - b) / k

font = setup_style()
print(f"中文字体:{font}")
cid = "C012"
g = df[df["cell_id"] == cid]
kk, bb = np.polyfit(g["cycle"].to_numpy(float), g["soh"].to_numpy(float), 1)

fig, ax = plt.subplots(figsize=(8.6, 5.0))
ax.scatter(g["cycle"], g["soh"], s=7, alpha=0.5, color=PALETTE[0], label=f"{cid} 的每一行")
xs = np.linspace(0, 1500, 100)
ax.plot(xs, k * xs + b, color="black", lw=2.2,
        label=f"池化直线(全体共用,反解 {pooled_eol:.0f} 圈)")
ax.plot(xs, kk * xs + bb, color=PALETTE[3], lw=1.9,
        label=f"{cid} 自己的直线(反解 {(EOL - bb) / kk:.0f} 圈)")
ax.axhline(EOL, color=PALETTE[2], ls="--", lw=1.5, label=f"退役线 soh = {EOL}")
ax.axvline(float(g["cycle"].max()), color=PALETTE[1], ls=":", lw=1.5,
           label=f"{cid} 末次记录 {g['cycle'].max():.0f} 圈")
ax.set_xlabel("循环次数 cycle")
ax.set_ylabel("健康度 soh")
ax.set_title("一支设备自己的轨迹 vs 全体共用的那条直线")
ax.legend(loc="lower left", fontsize=9)
ax.set_ylim(0.75, 1.03)
save_fig(fig, os.path.join("outputs", "ex04-07-c012-line.png"))
print(f"{cid}:自己的直线反解 {(EOL - bb) / kk:.0f} 圈,池化直线说 {pooled_eol:.0f} 圈,"
f"实际末次记录 {g['cycle'].max():.0f} 圈")期望输出:
中文字体:PingFang SC
[plots] 图已保存: .../outputs/ex04-07-c012-line.png
C012:自己的直线反解 905 圈,池化直线说 1347 圈,实际末次记录 828 圈字体名会因操作系统而不同(macOS 上常见
PingFang SC, Linux 上常见Noto Sans CJK SC)。输出里"中文字体"不是None就说明设上了。
★ 图上能一眼看出的三件事:
① C012 的散点明显比池化黑线【陡】
② 它自己的红线在 905 圈穿过 0.80,黑线要到 1347 圈
③ 它的末次记录(828 圈)比自己的反解点(905 圈)还早 77 圈
   → 又一次"反解包含一点外推"(练习 2 的结论)
★ 一个画图上的取舍
如果只画池化黑线:
   图很干净,看起来"模型很好"
   ↓
但它把 60 支设备的真实差异全藏起来了
   ↓
画上个体轨迹之后,读者才知道那条黑线是"平均"
画图的目的不是"让模型好看",是"让读者看见模型看不见的东西"。
★ 一个可复用的模板(第 24~25 章还会用)
fig, ax = plt.subplots(figsize=(8.6, 5.0))
ax.scatter(x_data, y_data, s=6, alpha=0.4, color=PALETTE[0], label="原始数据")
ax.plot(xs, y_model, color="black", lw=2.2, label="模型")
ax.axhline(threshold, color=PALETTE[2], ls="--", label=f"阈值 {threshold}")
ax.set_xlabel("...")
ax.set_ylabel("...")
ax.set_title("结论式的标题")
ax.legend(fontsize=9)
save_fig(fig, os.path.join(OUT, "xxx.png"))
每张图都回答一个问题,标题就是那个问题的答案。
面向工程实践:把"平均"和"个体"分清楚
这一章的技术含量不高(就一个 predict),但它是全书最容易被误用的一章。
① "平均"是一个合法的答案,前提是你问的是平均问题
| 业务问题 | 池化直线够用吗 | 该用什么 |
|---|---|---|
| 这批设备的整体备件预算是多少? | ✅ 够 | 池化直线 / 直接算总量 |
| 什么圈数开始要加大巡检频次? | ✅ 够(看平均趋势) | 池化直线 + 分位带 |
| 这 3 支设备下周要不要换? | ❌ 不够 | 每支自己的模型 / 个体特征 |
| 有没有哪支设备明显异常? | ⚠️ 反向用 | 偏离池化线的个体才值得看 |
★ 最后一行是一个很好的用法:
池化直线 = "正常退化的模板"
   ↓
某支设备【离这条线特别远】→ 值得单独调查
   ↓
它不回答"什么时候退役",但它能回答"谁不太对劲"
② 一套完整的"个体预测"需要什么
横截面回归(本章):
   特征:cycle
   模型:1 条线
   回答:平均

个体预测(本书后面 + 真实项目):
   ① 要有【区分个体】的特征
        —— 开头几圈的退化速率、内阻上升速度……(第 13 章多特征)
   ② 要按设备划分来评估(第 09~12 章)
        —— 否则你评估的是"对见过的设备准不准"
   ③ 要报不确定度(第 24~25 章)
        —— "905 ± 80 圈" 比 "905 圈" 有用得多
★ 第 ③ 条最容易被忽略,也最值钱:
"1347 圈"          → 一个承诺
"1117 圈(752~1440)" → 一个事实
   ↓
给决策者的是后者的形态时,他才能自己决定"要不要按 752 准备"
③ 一个可操作的输出模板
对 60 支设备的退役点估计:

  数据直接给出的(无模型假设):
      中位 1117 圈,范围 752 ~ 1440 圈

  池化直线给出的(有线性假设):
      1347 圈 —— 落在分布的偏高端,对 80% 的设备偏乐观

  建议:
      ① 做总量规划时用 1347(它是"平均")
      ② 做个体维护排程时不要用它,必须先拿到个体特征
      ③ 想知道"某支还能撑多久",需要第 13 章之后的多特征模型
★ 这份输出的关键是"两行数字":
一行给"平均问题",一行给"个体事实"
   ↓
把它们分开写,读者就知道该用哪个
   ↓
把它们混成一句话,就会有人拿 1347 去安排某一支设备的更换
④ 这一章的知识,一句话
直线没有错,错的是把"平均"当成"个体"。 而纠正它不需要更好的模型,只需要你多打一行末次记录的分布。
下一章我们把这一章用到的 MAE、RMSE、R² 系统讲一遍 —— 包括那个最容易被误解的数字:负的 R²。