第 15 章 · 特征缩放与 Pipeline:把预处理焊进模型
这一章要解决什么:把
StandardScaler装进Pipeline, 并回答一个看起来很简单的问题:缩放到底改善了什么?最容易踩的坑: ① 以为缩放"提高了精度" —— 实测 +0.008008,但它不是精度的功劳(15.3 拆解); ② 以为"整表
fit_transform是泄漏,所以分数会虚高" —— 这份数据上分数一模一样,那才是最危险的地方(15.6); ③ 用pipe.named_steps["model"].coef_直接当原始系数读 —— 它是标准化尺度的。
本章你需要完成的代码:demos/ch15-scaling-pipeline.py
15.1 缩放到底做了什么
两个 scaler,一句话说清:
| scaler | 公式 | 结果范围 | 学到的参数 |
|---|---|---|---|
StandardScaler | z = (x - μ) / σ | 均值 0、标准差 1 | mean_、scale_ |
MinMaxScaler | z = (x - min) / (max - min) | [0, 1] | data_min_、data_max_ |
★ 两个都是"仿射变换"(先减一个数,再除一个数) —— 这个性质在 15.3 和 15.6 会两次派上用场。
为什么需要它:看这份数据的 7 个特征的真实量纲:
cycle                      50        ~ 1440        全距 1390
mean_charge_voltage_v      3.5912    ~ 4.0545      全距 0.4633
mean_temp_rise_c           0.2571    ~ 23.692      全距 23.4349
resistance_mohm            33.8434   ~ 87.7078     全距 53.7783
coulombic_eff              0.9937    ~ 0.9983      全距 0.0046
cap_fade_rate_ah_per_100   0.002     ~ 0.0973      全距 0.0953
temp_std_c                 0.0571    ~ 0.807       全距 0.7499
cycle 的全距是 coulombic_eff 的 302,174 倍
↓
放进同一个模型时,它们的"数值大小"完全不可比★ 两条使用纪律
① fit 和 transform 要分开想
scaler = StandardScaler()

scaler.fit(X_train)              # ← 只从这里学 mean_ 和 scale_
X_train_s = scaler.transform(X_train)
X_test_s = scaler.transform(X_test)   # ← 用【训练的】参数,不是 test 自己的
② 所有带下划线的属性都是"学出来的",fit 之前不存在
StandardScaler().mean_          # ❌ NotFittedError
StandardScaler().fit(X).mean_   # ✅
第 ② 条和第 04 章讲的 coef_ 是同一条约定:_ 结尾 = 学出来的。
点开:为什么"用测试集自己的均值去标准化"是错的(一句话版)
StandardScaler().fit(X_test).transform(X_test)
    ↓
你在用【要预测的那批数据】的统计量去做预处理
    ↓
这在离线评估时看起来没问题(你确实有 X_test)
    ↓
但上线时你只有一行新数据,"这一行的均值"没有意义
    ↓
→ 训练和上线用了两套完全不同的预处理规则,模型当场失效正确的写法永远是:
scaler.fit(X_train)                 # 学一次
scaler.transform(X_train)           # 训练时用
scaler.transform(X_new)             # 上线时用【同一个】scaler
★ 而 Pipeline 的作用,就是让你不可能写错这一步(15.5)。
15.2 先看现象:三种配置,同一份数据
真实输出:
=== ① 先看现象:三种配置,同一份数据 ===
  不缩放              训练 R² = 0.942958   测试 R² = 0.942526
  StandardScaler   训练 R² = 0.959701   测试 R² = 0.950534
  MinMaxScaler     训练 R² = 0.959701   测试 R² = 0.950534
  → 测试 R² 涨了 +0.008008
→ 但训练 R² 也涨了,而且是同一个涨法。这很可疑。多数教程讲到这里就结束了:
"看,缩放让测试 R² 从 0.942526 提升到 0.950534,涨了 0.008!"★ 本章要对这句话做两件事:先承认这个数字是真的,再证明这个解释是错的。
先记住三个观察:
| 观察 | 数字 |
|---|---|
| 不缩放 | 训练 0.942958 / 测试 0.942526 |
| 两个 scaler 给出完全相同的结果 | 0.950534 / 0.950534 |
| 训练 R² 也一起涨了 | 0.942958 → 0.959701 |
★ 第 2 条和第 3 条都是线索:
线索一:StandardScaler 和 MinMaxScaler 是两种完全不同的变换,
        为什么给出【一模一样】的 0.950534?
        → 因为两者都是仿射变换,而带截距的线性回归对仿射变换等变。

线索二:一个【没有正则化】的线性模型,训练 R² 为什么能涨?
        它有更多参数吗?没有。特征更多吗?没有。
        → 唯一的解释:之前那个解,不是最优解。
15.3 ★ 拆掉"缩放提精度"这个说法
真实输出:
=== ② 真相:不是模型变强,是求解器把方向丢了 ===
  不缩放:rank_ = 6/7   (7 个特征只当 6 个用)
          奇异值 = [4.56442064e+04 7.11701111e+02 3.76849542e+02 1.20463780e+01
 6.82032600e+00 1.28316800e+00 3.45260000e-02]
          截断阈值 = tol × σmax = 1e-6 × 45644.2064 = 0.045644
          最小 σ = 0.034526 < 阈值 → 这个方向被当作噪声扔掉
  标准化后:cond = 10.95    (不缩放时 3.795e+06)
  ③ 把截断关掉(tol=0)但不缩放:
     rank_ = 7/7   测试 R² = 0.950534
     系数(还原到原始单位)与「标准化解」的最大差 = 2.59e-13
  → 数学上这是【同一个最小二乘解】,只是走了两条数值路径。
     缩放没有让模型更强,它让求解器算对了。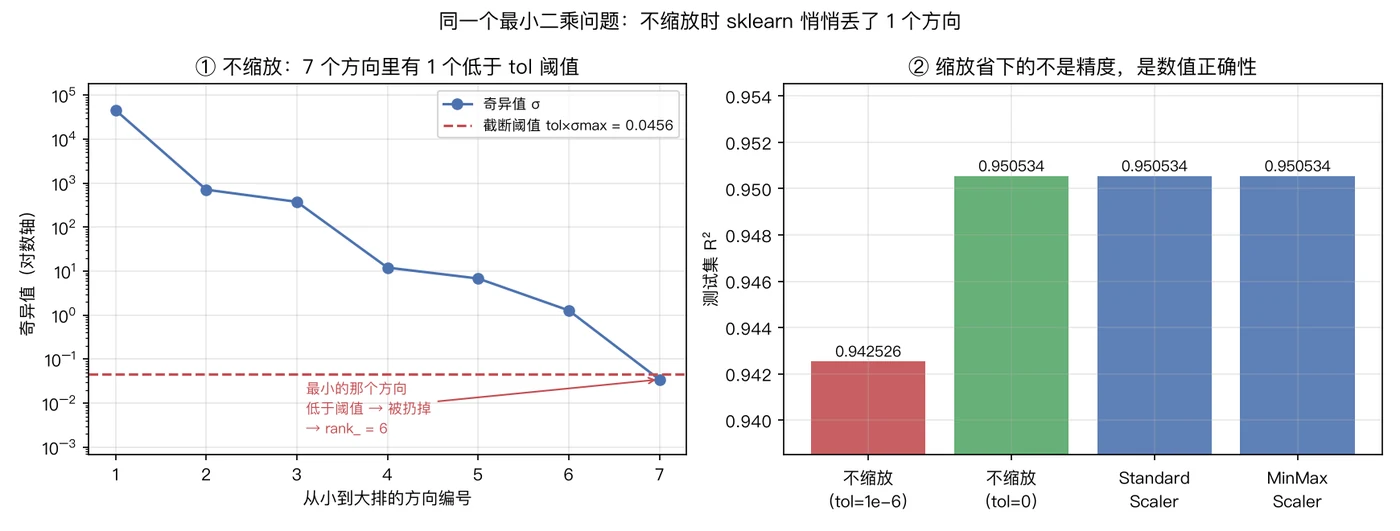
证据一:rank_ 只有 6
model = LinearRegression().fit(X_train, y_train)
print(model.rank_)      # 6
print(X_train.shape)    # (17244, 7)
传进去 7 个特征,解得出来的只有 6 个方向。
rank_ = 6 / 7
    ↓
"最优解"是在一个少了一维的空间里找的
    ↓
它当然不等于真正的最小二乘解
证据二:截断阈值是怎么算出来的
真实输出里那三行数字,是这件事的全部机制:
奇异值(从大到小):45644.206438, 711.701111, 376.849542, 12.046378,
                    6.820326, 1.283168, 0.034526
截断阈值 = tol × σmax = 1e-6 × 45644.2064 = 0.045644

最小的 σ (0.034526) < 阈值 (0.045644)  →  这个方向被扔掉  →  rank_ = 6
★ 为什么会这样:
scikit-learn 的 LinearRegression 默认 tol=1e-6,
它把这个值当作 scipy.linalg.lstsq 的 cond 参数使用:
    "把小于 cond × σmax 的奇异值都当作 0"

而这份数据的特征量纲差 6 个数量级
    ↓
条件数 cond(X) = 3.795e+06
    ↓
最小的那个方向的 σ 掉到了阈值以下
    ↓
被当成噪声扔掉注意最后那一句:不是数据有问题,是"量纲差异"被求解器当成了"这个方向不重要"。
证据三:换个数值路径,答案就回来了
fix = LinearRegression(tol=0).fit(X_train, y_train)      # 关掉截断
print(fix.rank_)                     # 7       ← 方向回来了
print(fix.score(X_test, y_test)) # 0.950534 ← 和 StandardScaler 完全一样真实输出:
     rank_ = 7/7   测试 R² = 0.950534
     系数(还原到原始单位)与「标准化解」的最大差 = 2.59e-13
★ 2.59e-13 是这一章最重要的一个数字。
两条完全不同的路径:
   ① 特征标准化 → 拟合 → 系数除以 scale_ 还原回原始单位
   ② 原始单位 → 拟合(tol=0)

得到的 7 个系数,最大差 2.59e-13(约等于浮点数的机器精度)
    ↓
结论:这是【同一个最小二乘解】
    ↓
所以 "+0.008008 的提升" 不是"缩放让模型变强",
而是"缩放让求解器终于算对了"。
★ 一个可以直接背下来的结论:
缩放的第一价值是"让求解器不丢方向",不是"提高精度"。 判据:如果加强预处理之后,训练集和测试集的分数一起涨,那多半是数值问题,不是泛化问题。
点开:那"缩放能加速收敛/提升精度"的说法是错的吗?
不完全是。要分两种情况:
情况一:模型有解析解、无正则化(本章的线性回归)
数学上:特征做仿射变换,最优解不变 → 缩放【不改变】模型
数值上:缩放【改善】条件数 → 求解器算得更准
    ↓
所以:它改变的是"你算出来的解离最优解有多远"
情况二:模型依赖距离或梯度(KNN / SVR / 神经网络 / 带正则化)
KNN:距离 = √(Σ (xᵢ - yᵢ)²)
     → 量纲大的特征独占距离(cycle 差 100 圈 = 距离 100)
     → 缩放【真正改变模型】
SVR:核函数是 RBF,也是距离
神经网络:梯度下降的步长对特征尺度敏感,不缩放会很难收敛
带正则化的线性模型:惩罚项 Σwⱼ² 对系数尺度敏感
     → 不缩放时,量纲小的特征系数会很大,被惩罚得更狠
    ↓
这些模型的缩放是【必须的】,不是可选的
15.4 会用实测数字分开这两类。
★ 所以本章的结论不是"缩放没用",而是:
"缩放提高了 +0.008"这句话用错了因果。 在解析解模型上它是数值修正;在距离/梯度模型上它是必要的建模前提。
15.4 哪些模型必须缩放、哪些不敏感
真实输出:
=== ③ 哪些模型必须缩放,哪些完全不在乎 ===
  模型                         不缩放 R²     标准化 R²         差
  KNN(k=5)                  0.90001    0.95504  +0.05502
  Ridge(alpha=100)          0.93033    0.95109  +0.02076
  SVR(RBF, ε=0.01)          0.89805    0.95968  +0.06163
  决策树(depth=3)              0.92497    0.92497  +0.00000
  随机森林(200棵)                0.96503    0.96502  -0.00001
  直方图提升(300)                0.96429    0.96429  +0.00000
  → 距离类(KNN / SVR)和带惩罚(Ridge)的模型:不缩放直接吃亏。
  → 树类只看大小顺序:缩不缩放预测值几乎一样。
★ 两类模型,泾渭分明:
| 类别 | 例子 | 不缩放会怎样 | 为什么 |
|---|---|---|---|
| 必须缩放 | KNN、SVM/SVR、神经网络、带正则化的线性模型(Ridge/Lasso) | KNN 掉 0.055、SVR 掉 0.062、Ridge 掉 0.021 | 它们依赖距离或系数的尺度 |
| 不敏感 | 决策树、随机森林、梯度提升 | 差 ≤ 0.00001 | 每个特征上只问"大于还是小于某个阈值",缩放不改变顺序 |
★ 一个能解释全部现象的类比:
KNN 问的是:"离这个样本最近的 5 个邻居是谁?"
    → 距离是对每个特征求平方和
    → cycle 差 100 圈贡献 10000,coulombic_eff 差 0.001 贡献 0.000001
    → 距离几乎只由 cycle 决定,其它 6 个特征白带了
    ↓
标准化后 7 个特征"说话一样大声",KNN 才能用上全部信息

决策树问的是:"coulombic_eff 大于 0.9959 吗?"
    → 把 coulombic_eff 乘以 1000,阈值从 0.9959 变成 995.9,判断结果完全一样
    → 缩放对它是"换了个记法"
★ 用第二把尺子验证(顺便看 scaler 的选择有没有影响):
KNN + StandardScaler: 测试 R² = 0.95504
KNN + MinMaxScaler  : 测试 R² = 0.95576
两个 scaler 给 KNN 的答案【不一样】(0.95504 vs 0.95576)
↓ 因为仿射变换不保持距离的比例
两个 scaler 给线性回归的答案【完全一样】(0.950534 vs 0.950534)
↓ 因为线性回归对仿射变换等变
↓
"要不要缩放"和"用哪个 scaler"是两个独立的问题。★ 顺带一个真实的坑(SVR 的 epsilon):
⚠️ 顺带一个坑:SVR 的 epsilon 默认是 0.1 —— 而这一步的标签只在 0.80~1.00 之间。
     '允许误差 0.1'等于'允许错掉半个量程',模型干脆什么都不学:R² = -0.01806
     超参数的默认值也是有量纲的,这句话在第 22 章还会出现。
SVR 的 epsilon 是"允许多大的误差不算错"
↓
默认 0.1,而标签 soh 的全距只有 0.2 左右
↓
模型发现:"我什么都不用预测,误差也在容忍范围内"
↓
R² = -0.01806(比"直接用均值预测"还差)★ 这条坑的教训不是"要调 epsilon",而是:
超参数的默认值是有量纲的。 换数据集、换标签范围时,凡是带单位的超参数(epsilon、alpha、gamma、length_scale) 都要重新想一遍。
★ 一份可直接复制到项目里的判断表
| 模型 | 缩放 | 说明 |
|---|---|---|
| 线性回归(无正则) | 建议(数值稳定性) | 数学上不影响最优解,但影响求解器算不算得准(15.3) |
| Ridge / Lasso / ElasticNet | 必须 | 惩罚项作用在系数尺度上 |
| KNN | 必须 | 距离由量纲最大的特征主导 |
| SVM / SVR | 必须 | 核函数是距离 |
| 神经网络 / MLP | 必须 | 梯度尺度与收敛速度 |
| 决策树 / 随机森林 / 提升 | 不需要 | 只比较大小顺序 |
| 高斯过程(第 24 章) | 必须 | 核函数的 length_scale 是各向同性的距离 |
15.5 Pipeline:把预处理焊进模型
先看"焊进去"长什么样:
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LinearRegression

pipe = Pipeline([
    ("scaler", StandardScaler()),
    ("model", LinearRegression()),
])

pipe.fit(X_train, y_train)       # scaler 只在 X_train 上 fit,然后 transform
pipe.predict(X_test) # 先 transform(用训练学到的参数),再 predict真实输出:
=== ④ Pipeline 里怎么把所有东西装进去 ===
  named_steps 的键:['scaler', 'model']
    coulombic_eff              +0.028881
    cycle                      -0.013282
    mean_temp_rise_c           -0.006670
    mean_charge_voltage_v      -0.004971
    temp_std_c                 -0.004154
    cap_fade_rate_ah_per_100   -0.003403
    resistance_mohm            +0.001261
  scaler 学到的均值(前 3 个):{'cycle': 611.0568, 'volt': 3.8144, 'temp_rise': 10.0413}
  ❌ 错误姿势:full.coef_ → AttributeError(Pipeline 本身没有 coef_)
     AttributeError: 'Pipeline' object has no attribute 'coef_'
  ❌ 还有一个更隐蔽的错误:named_steps['model'].coef_ 是【标准化尺度】的系数,
     直接和原始单位的特征名配对会读错。要比大小用它;要翻译成人话先除以 scale_。
★ Pipeline 的语义只有两条规则:
pipe.fit(X, y)      → 前面每一步 fit_transform,最后一步只 fit
pipe.predict(X)     → 前面每一步 transform,最后一步 predict
这两条规则就是"不可能泄漏"的全部机制 —— 15.6 会看到它的价值。
★ 取系数的三种写法,只有一种是对的
pipe.coef_                                    # ❌ AttributeError:Pipeline 没有 coef_
pipe.named_steps["model"].coef_               # ⚠️ 对,但单位是"标准化尺度"
pipe.named_steps["model"].coef_ / pipe.named_steps["scaler"].scale_ # ✅ 还原成原始单位用一个数字验证第三种写法(第 14 章练过):
cycle 的标准化系数      :-0.01328184
scaler 学到的 mean/scale:611.0568 / 347.4535
除以 scale_ 还原回原始单位:-0.00003823
与 tol=0 原始系数(-0.00003823)的最大差:2.17e-19
-0.01328184 / 347.4535 = -0.00003823
↓
和 LinearRegression(tol=0) 在原始单位下算出来的系数一致
↓
说明"标准化系数 ÷ scale_ = 原始系数"这条关系是可靠的★ 记住这条:
要比大小  → 用 named_steps["model"].coef_(标准化尺度)
要写成人话 → 先除以 scaler.scale_
★ 还有一个只有 Pipeline 才能干的事:
# 每个折内部重新 fit scaler —— 这两行代码就是"不泄漏"的保证
from sklearn.model_selection import cross_val_score
scores = cross_val_score(pipe, X_train, y_train, cv=GroupKFold(5), groups=groups)
#                       ↑ 传 pipe 而不是"已经缩放好的 X"
15.6 ★ 泄漏对照:整表 fit_transform 到底错在哪
这是本章第二个"看起来对但其实错",也是整本书里最反直觉的一段。
先看错误写法:
# ❌ 错误写法:先缩放整表,再划分
X_all = StandardScaler().fit_transform(X)      # ← 用了全部数据(含测试集)的统计量
X_tr, X_te, y_tr, y_te = train_test_split(X_all, y, test_size=0.2, random_state=42)
model.fit(X_tr, y_tr)真实输出:
=== ⑤ 泄漏对照:整表 fit_transform 到底错在哪 ===
  线性回归   :整表 fit_transform 0.95341±0.00742   Pipeline 0.95341±0.00742   差 +0.000000
  KNN(k=5)  :整表 fit_transform 0.92712±0.01310   Pipeline 0.92711±0.01279   差 +0.000009
  整表的 mean[cycle] = 602.8199   训练集的 mean[cycle] = 611.0568   (差 8.24 圈)
  ⚠️ 在线性回归上,这两种写法【分数一模一样】——因为带截距的线性回归对特征的
     仿射变换等变:用哪份均值/标准差标准化,最终预测完全相同。
     也就是说:这个泄漏在这份数据上【测不出来】。这才是最危险的。

  换一个能测出差距的场景(PCA 也用 y 之外的整表信息,但 KNN 对表示很敏感):
    PCA(2)+KNN  整表 fit 0.85767±0.02021   Pipeline 0.93191±0.01781   差 -0.07424
    → 这次差出来了,而且方向是'泄漏版更差'。
      泄漏不保证虚高,它保证的是'这个分数不再对应你要回答的问题'。
★ 这一节的三个结论,一个比一个反直觉
结论一:这不是"虚高 0.01"那种泄漏 —— 它在这份数据上完全看不出来
整表 fit_transform:0.95341 ± 0.00742
Pipeline 内部缩放  :0.95341 ± 0.00742
    ↓
小数点后 5 位完全一致为什么:带截距的线性回归对特征的仿射变换等变。
用整表均值标准化,和用训练集均值标准化,
只差一个仿射变换(减去不同的常数、除以不同的常数)
    ↓
线性回归的最优解会跟着"换算"过去
    ↓
最终的预测值一模一样
★ 所以"整表 fit_transform 会让分数虚高"这句话本身也是不准确的:
它不一定让分数变高,也不一定让分数变低 —— 它让分数不再是"你要评估的那个东西"。
结论二:有些预处理泄漏是能测出来的,而且方向是"更差"
PCA(2)(整表 fit) + KNN:0.85767 ± 0.02021
Pipeline(缩放+PCA(2)) + KNN:0.93191 ± 0.01781
                                       差 -0.07424
PCA 的"主方向"是用整表(含测试集)算的
↓
它把测试集的方差结构也压进了那 2 个主成分里
↓
训练时模型看到的坐标系,和"只用训练集"时完全不同
↓
KNN 在这个被扭曲的表示上找邻居 → 分数掉 0.074结论三:所以唯一的可靠办法是"让代码结构保证它不可能发生"
你不能指望"分数看起来正常"来发现泄漏(结论一)
你也不能指望"分数会虚高"来发现泄漏(结论二:它可能变差)
    ↓
只能靠结构:把预处理放进 Pipeline
    ↓
cross_val_score(pipe, ...) 会自动在每一折内部重新 fit 预处理
★ 一份"必须放进 Pipeline"的清单:
| 预处理 | 为什么必须放进 Pipeline |
|---|---|
StandardScaler / MinMaxScaler | 均值/极差来自数据 |
PCA | 主方向来自数据的协方差 |
SelectKBest / RFE | 特征选择用了标签 y |
SimpleImputer | 填充值来自数据 |
| target encoding | 直接用 y 算编码 |
任何 fit_transform(X_all) | 同一类错误的不同写法 |
★ 一句话记住这个模式:
只要你在
train_test_split之前调用了任何fit或fit_transform, 你就在做泄漏 —— 不管它有没有让分数变好看。
唯一的例外:只用 X 的行数、列名、dtype 这类与数值分布无关的信息(例如检查缺失值比例)。
点开:为什么"线性回归测不出泄漏"这件事,反而说明 Pipeline 更值钱
想象两种项目:
项目 A:模型是线性回归
整表 fit_transform 和 Pipeline 分数一样
    ↓
周五上线,两年后有人审查代码,指出"你这里泄漏了"
    ↓
你的回答:"但分数一样啊,说明没影响"
    ↓
审查者:"那是因为模型恰好等变。
         下次换成 KNN、换成 PCA、换成 target encoding,
         同样的写法就会让报告里的数字失去意义。"
项目 B:模型是 KNN + PCA
整表 fit 分数 0.85767,Pipeline 0.93191
    ↓
如果你用整表那套写法,你会以为"KNN + PCA 只有 0.86,不如线性回归"
    ↓
于是你放弃了一条本来能到 0.93 的路线
    ↓
泄漏不只是"虚高",它也会让你【错杀好方案】
★ 所以 Pipeline 的价值可以用三句话概括:
① 它让"正确的做法"变成"最省事的做法"
   (不加 Pipeline 就得手写 fit/transform 的分工)
② 它让"错误的做法"在代码里显得很别扭
   (你要特意把 fit_transform 提到 CV 外面才能犯这个错)
③ 它让 [交叉验证 / 网格搜索 / 上线] 三种场景共用同一个对象
第 ③ 条特别实用:GridSearchCV(pipe, param_grid) 会自动把预处理和超参数 在每一折内部一起调 —— 手写循环做不到这一点。
15.7 常见坑
① 以为缩放"提精度"               → +0.008008 是数值修正(rank_ 6/7),不是泛化提升
② 拿 named_steps["model"].coef_ 当原始系数 → 它是标准化尺度,要除以 scaler.scale_
③ 用 pipe.coef_                  → AttributeError
④ 在 train_test_split 之前做 fit  → 泄漏;可能测得出来,也可能完全测不出来
⑤ 给树模型加 scaler              → 无害但没用(差 ≤ 0.00001),白多一个环节
⑥ 给 KNN/SVR 不加 scaler         → KNN 掉 0.055、SVR 掉 0.062
⑦ 忘了 scaler 只 fit 一次        → 训练/上线两套预处理规则,模型上线即失效
⑧ 用 SVR 的默认 epsilon=0.1      → 标签量程只有 0.2 时,模型什么都不学(R² = -0.01806)
15.8 完整示例与输出
cd code
python demos/ch15-scaling-pipeline.py
真实输出(节选):
=== ① 先看现象:三种配置,同一份数据 ===
  不缩放              训练 R² = 0.942958   测试 R² = 0.942526
  StandardScaler   训练 R² = 0.959701   测试 R² = 0.950534
  MinMaxScaler     训练 R² = 0.959701   测试 R² = 0.950534

=== ② 真相:不是模型变强,是求解器把方向丢了 ===
  不缩放:rank_ = 6/7
          截断阈值 = tol × σmax = 1e-6 × 45644.2064 = 0.045644
          最小 σ = 0.034526 < 阈值 → 这个方向被当作噪声扔掉
     rank_ = 7/7   测试 R² = 0.950534
     系数(还原到原始单位)与「标准化解」的最大差 = 2.59e-13

=== ③ 哪些模型必须缩放,哪些完全不在乎 ===
  KNN(k=5)                  0.90001    0.95504  +0.05502
  决策树(depth=3)              0.92497    0.92497  +0.00000

=== ⑤ 泄漏对照:整表 fit_transform 到底错在哪 ===
  线性回归   :整表 fit_transform 0.95341±0.00742   Pipeline 0.95341±0.00742   差 +0.000000
    PCA(2)+KNN  整表 fit 0.85767±0.02021   Pipeline 0.93191±0.01781   差 -0.07424
本章练习
练习 1:缩放的贡献是"精度"还是"数值正确性"?
按设备划分(GroupShuffleSplit(test_size=0.2, random_state=42)):
- 用不缩放的
LinearRegression拟合 7 个特征,报训练/测试 R² 与rank_; - 套
Pipeline(StandardScaler + LinearRegression)再报一次; - 用
LinearRegression(tol=0)不缩放再报一次; - 回答:这三次里,哪一次"模型变强了"?
参考答案
import pandas as pd
from sklearn.linear_model import LinearRegression
from sklearn.metrics import r2_score
from sklearn.model_selection import GroupShuffleSplit
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler

FEATS = ["cycle", "mean_charge_voltage_v", "mean_temp_rise_c", "resistance_mohm",
         "coulombic_eff", "cap_fade_rate_ah_per_100", "temp_std_c"]

df = pd.read_csv("data/battery/soh_features.csv")
tr, te = next(GroupShuffleSplit(n_splits=1, test_size=0.2, random_state=42)
              .split(df[FEATS], df["soh"], groups=df["cell_id"]))
X_tr, y_tr = df[FEATS].iloc[tr], df["soh"].iloc[tr]
X_te, y_te = df[FEATS].iloc[te], df["soh"].iloc[te]

for name, model in [("不缩放", LinearRegression()),
                    ("StandardScaler", Pipeline([("s", StandardScaler()),
                                                 ("m", LinearRegression())])),
                    ("不缩放 + tol=0", LinearRegression(tol=0))]:
    model.fit(X_tr, y_tr)
    inner = model.named_steps["m"] if isinstance(model, Pipeline) else model
    print(f"{name:16s} 训练 R²={r2_score(y_tr, model.predict(X_tr)):.6f}"
f" 测试 R²={r2_score(y_te, model.predict(X_te)):.6f} rank_={inner.rank_}/7")期望输出:
不缩放              训练 R²=0.942958  测试 R²=0.942526  rank_=6/7
StandardScaler   训练 R²=0.959701  测试 R²=0.950534  rank_=7/7
不缩放 + tol=0      训练 R²=0.959701  测试 R²=0.950534  rank_=7/7
④ 回答:三次里没有任何一次"模型变强了"。
推理步骤:
第一步:三次用的是【同一个模型类、同一批特征、同一个训练集】
        → 假设空间完全相同

第二步:不缩放 + tol=0 和 StandardScaler 给出【完全一样】的
        rank_(7/7)和测试 R²(0.950534)
        → 它们解的是同一个最小二乘问题

第三步:既然第二条成立,那么"不缩放(默认)"那次的 0.942526
        不是"模型更弱",而是"求解器没算到最优解"
        (rank_ = 6/7 就是证据)
★ 三条结论
① "+0.008008"是数值修正,不是泛化提升
② 判据:训练 R² 和测试 R² 一起涨(0.942958→0.959701 与 0.942526→0.950534)
        → 一个无正则的线性模型不可能靠泛化让训练集也变准
③ 推荐的写法是【标准化】而不是【tol=0】:
   因为标准化同时解决"数值正确"和"系数可比"(第 14 章)
★ 一个可以带走的判断:
任何"我加了个预处理,分数涨了"的结论, 都要先问一句:训练集分数涨了吗? 涨了 → 先怀疑数值问题或泄漏,别急着归功于"更好的特征表示"。
练习 2:哪些模型必须缩放?
在同一划分上,对下面三个模型各跑"不缩放 vs Pipeline(StandardScaler)":
KNeighborsRegressor(n_neighbors=5)Ridge(alpha=100)DecisionTreeRegressor(max_depth=3, random_state=42)
报出测试 R² 与差值,并解释差别的来源。
参考答案
import pandas as pd
from sklearn.linear_model import Ridge
from sklearn.metrics import r2_score
from sklearn.model_selection import GroupShuffleSplit
from sklearn.neighbors import KNeighborsRegressor
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.tree import DecisionTreeRegressor

FEATS = ["cycle", "mean_charge_voltage_v", "mean_temp_rise_c", "resistance_mohm",
         "coulombic_eff", "cap_fade_rate_ah_per_100", "temp_std_c"]

df = pd.read_csv("data/battery/soh_features.csv")
tr, te = next(GroupShuffleSplit(n_splits=1, test_size=0.2, random_state=42)
              .split(df[FEATS], df["soh"], groups=df["cell_id"]))
X_tr, y_tr = df[FEATS].iloc[tr], df["soh"].iloc[tr]
X_te, y_te = df[FEATS].iloc[te], df["soh"].iloc[te]

for name, est in [("KNN(k=5)", KNeighborsRegressor(5)),
                  ("Ridge(alpha=100)", Ridge(alpha=100.0)),
                  ("决策树(depth=3)", DecisionTreeRegressor(max_depth=3, random_state=42))]:
    raw = r2_score(y_te, est.fit(X_tr, y_tr).predict(X_te))
    std = r2_score(y_te, Pipeline([("s", StandardScaler()), ("m", est)])
                   .fit(X_tr, y_tr).predict(X_te))
print(f"{name:18s} 不缩放 {raw:.5f} 标准化 {std:.5f} 差 {std - raw:+.5f}")期望输出:
KNN(k=5)           不缩放 0.90001   标准化 0.95504   差 +0.05502
Ridge(alpha=100)   不缩放 0.93033   标准化 0.95109   差 +0.02076
决策树(depth=3) 不缩放 0.92497 标准化 0.92497 差 +0.00000解释(三种模型,三种机制):
| 模型 | 机制 | 差 |
|---|---|---|
| KNN | 距离 = √Σ(xᵢ-yᵢ)²。cycle 差 100 圈贡献 10000,coulombic_eff 差 0.001 贡献 1e-6 → 距离被 cycle 独占 | +0.055 |
| Ridge | 惩罚项 Σwⱼ²。不缩放时量纲小的特征需要很大的系数才能起作用,于是被罚得最狠 → 那些特征等于被"压死" | +0.021 |
| 决策树 | 只比较"大于/小于阈值"。coulombic_eff * 1000 之后阈值也跟着乘 1000,划分完全一样 | 0.000 |
★ 一张判断表:
问:"这个模型会不会用到特征的【绝对大小】?"
    ├─ 会(距离、核函数、梯度、正则化惩罚)  → 必须缩放
    └─ 不会(只比较大小顺序)                → 不需要缩放
★ 一个补充验证(想深入可以做):
# 树对缩放不敏感,可以用"预测值是否逐点相同"来验证,比 R² 更严格
import numpy as np
import pandas as pd
from sklearn.model_selection import GroupShuffleSplit
from sklearn.preprocessing import StandardScaler
from sklearn.tree import DecisionTreeRegressor

FEATS = ["cycle", "mean_charge_voltage_v", "mean_temp_rise_c", "resistance_mohm",
         "coulombic_eff", "cap_fade_rate_ah_per_100", "temp_std_c"]

df = pd.read_csv("data/battery/soh_features.csv")
tr, te = next(GroupShuffleSplit(n_splits=1, test_size=0.2, random_state=42)
              .split(df[FEATS], df["soh"], groups=df["cell_id"]))
X_tr, y_tr, X_te = df[FEATS].iloc[tr], df["soh"].iloc[tr], df[FEATS].iloc[te]

tree_raw = DecisionTreeRegressor(max_depth=3, random_state=42).fit(X_tr, y_tr)
sc = StandardScaler().fit(X_tr)
tree_std = DecisionTreeRegressor(max_depth=3, random_state=42).fit(sc.transform(X_tr), y_tr)
print(np.abs(tree_raw.predict(X_te) - tree_std.predict(sc.transform(X_te))).max())
# 0.0   ← 完全逐点相同(第 16 章会用到这个结论)
练习 3:用 Pipeline 取系数并还原单位,再对照泄漏写法
- 用
Pipeline(StandardScaler + LinearRegression)在训练集上拟合; - 打印
named_steps的键、cycle的标准化系数、scaler 的mean_/scale_; - 把标准化系数除以
scale_还原回原始单位,并与LinearRegression(tol=0)的原始系数比较; - 用
GroupKFold(5)对比两种写法:整表fit_transform后再交叉验证 vs Pipeline 内部缩放。
参考答案
import numpy as np
import pandas as pd
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import GroupKFold, GroupShuffleSplit, cross_val_score
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler

FEATS = ["cycle", "mean_charge_voltage_v", "mean_temp_rise_c", "resistance_mohm",
         "coulombic_eff", "cap_fade_rate_ah_per_100", "temp_std_c"]

df = pd.read_csv("data/battery/soh_features.csv")
X, y, g = df[FEATS], df["soh"], df["cell_id"]
tr, _ = next(GroupShuffleSplit(n_splits=1, test_size=0.2, random_state=42)
             .split(X, y, groups=g))
X_tr, y_tr, g_tr = X.iloc[tr], y.iloc[tr], g.iloc[tr]

pipe = Pipeline([("s", StandardScaler()), ("m", LinearRegression())]).fit(X_tr, y_tr)
sc, md = pipe.named_steps["s"], pipe.named_steps["m"]
print(f"named_steps 键:{list(pipe.named_steps)}")
print(f"cycle 的标准化系数      :{md.coef_[0]:+.8f}")
print(f"scaler 学到的 mean/scale:{sc.mean_[0]:.4f} / {sc.scale_[0]:.4f}")
back = md.coef_[0] / sc.scale_[0]
print(f"除以 scale_ 还原回原始单位:{back:+.8f}")

fix = LinearRegression(tol=0).fit(X_tr, y_tr)
print(f"与 tol=0 原始系数({fix.coef_[0]:+.8f})的最大差:{abs(back - fix.coef_[0]):.2e}")

X_all = pd.DataFrame(StandardScaler().fit_transform(X), columns=FEATS)   # ← 整表,泄漏
leak = cross_val_score(LinearRegression(), X_all.iloc[tr], y_tr,
                       cv=GroupKFold(5), groups=g_tr)
ok = cross_val_score(Pipeline([("s", StandardScaler()), ("m", LinearRegression())]),
                     X_tr, y_tr, cv=GroupKFold(5), groups=g_tr)
print(f"整表 fit_transform + CV:{[round(v, 5) for v in leak]}  均值 {leak.mean():.5f}")
print(f"Pipeline 内部缩放 + CV :{[round(v, 5) for v in ok]} 均值 {ok.mean():.5f}")期望输出:
named_steps 键:['s', 'm']
cycle 的标准化系数      :-0.01328184
scaler 学到的 mean/scale:611.0568 / 347.4535
除以 scale_ 还原回原始单位:-0.00003823
与 tol=0 原始系数(-0.00003823)的最大差:2.17e-19
整表 fit_transform + CV:[0.95839, 0.9547, 0.9494, 0.94154, 0.963]  均值 0.95341
Pipeline 内部缩放 + CV :[0.95839, 0.9547, 0.9494, 0.94154, 0.963]  均值 0.95341
③ 关于 2.17e-19
标准化系数 ÷ scale_ = -0.01328184 / 347.4535 = -0.00003823
tol=0 的原始系数                            = -0.00003823
    ↓
差 2.17e-19 —— 这就是浮点数的"完全相同"注意:如果拿全部 7 个系数、用完整精度比,最大差是 2.59e-13(本章 15.3 的数字)。 两个数都是"机器精度级别",差异来自打印时保留几位小数。
④ 关于两个 CV 分数完全相同
这是本章最容易被误读的结果:
整表 fit_transform:0.95341
Pipeline 内部缩放  :0.95341
    ↓
"分数一样,所以没泄漏"          ← ❌ 错
    ↓
"泄漏确实发生了,但这个模型(带截距的线性回归)对特征的仿射变换等变,
  所以泄漏对最终预测没有影响"    ← ✅ 对
★ 那为什么还要用 Pipeline
① 换成 KNN / SVR / 神经网络 → 立刻有影响(15.4)
② 换成 PCA / SelectKBest    → 影响很大(PCA 那次差 0.07424)
③ 换成上线部署               → 你必须保存 scaler,
                              而 Pipeline 会把 scaler 和 model 一起序列化
④ 换成别人接手你的代码        → "结构上不可能错"比"我算过没影响"可靠得多
★ 一句话总结这一题:
"这次没影响"不是"这个写法对",只是"这个模型恰好宽容"。
面向工程实践:预处理是管道的一部分
① 一条生产管道的标准形状
from sklearn.pipeline import Pipeline
from sklearn.impute import SimpleImputer
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import Ridge

pipe = Pipeline([
    ("impute", SimpleImputer(strategy="median")),   # 缺失值(用训练集的中位数)
    ("scale", StandardScaler()),                     # 缩放(用训练集的均值和标准差)
    ("model", Ridge(alpha=1.0)),                     # 模型
])

# 训练 / 交叉验证 / 网格搜索 / 上线,全程共用这一个对象
pipe.fit(X_train, y_train)
scores = cross_val_score(pipe, X_train, y_train, cv=GroupKFold(5), groups=groups)

import joblib
joblib.dump(pipe, "model.joblib")     # scaler 和 model 一起存
★ 上线时的正确姿势:
pipe = joblib.load("model.joblib")
pipe.predict(new_df[FEATS])           # 预处理自动按训练时的参数执行
如果你只存了 model,就必须手动重建 scaler —— 这是生产事故的经典来源。
② 一张"这一步该不该进 Pipeline"的判据
问:"这一步用到数据里的数值吗?"
    ├─ 用到 → 必须进 Pipeline(否则就是泄漏)
    │         例:均值、方差、分位数、主成分、特征选择、目标编码
    └─ 没用到 → 可以放外面
              例:列名检查、dtype 校验、行数断言、
                   "把某列的单位从 V 改成 mV"(固定系数,与数据无关)
③ 三个必须写进文档的预处理事实
① scaler 是在【训练集】上 fit 的(写了 train_size / 划分方式)
② 上线时预处理参数随模型一起加载(不是重新 fit)
③ 预处理里没有用到标签 y,也没有用到测试集的分布
★ 第 ③ 条是"防泄漏"的完整定义,可以把 15.6 的两类错误一起挡住。
④ 一个可复用的自检函数
def check_leakage(pipe, X, y, groups, cv=None):
    """确认 Pipeline 在交叉验证里是【每折重新 fit】的。"""
    from sklearn.model_selection import cross_val_score, GroupKFold
    cv = cv or GroupKFold(5)

    scores = cross_val_score(pipe, X, y, cv=cv, groups=groups)
    print(f"逐折分数:{[round(float(s), 5) for s in scores]}")
    print(f"均值 {scores.mean():.5f} ± {scores.std():.5f}")

    # 如果分数方差异常小(±0.000x),先怀疑折之间泄漏了
    if scores.std() < 0.001:
        print("⚠️ 折间方差异常小,检查有没有在 CV 外面做预处理")
★ 为什么"方差异常小"是一个有效的泄漏信号:
折之间的差异来自"每折的训练数据不同"
    ↓
如果你在外面把整表处理过,所有折共享同一份预处理结果
    ↓
折之间的差异被人为抹平 → 方差变小、分数看起来"稳得可疑"
    ↓
第 11 章讲过这个现象,第 15 章给了它的机制
★ 最后一句:
Pipeline 不是"代码整洁",它是"把'不泄漏'从人的纪律变成代码的结构"。 人的纪律会忘,结构不会。