第 10 章 · 划分泄漏:为什么按行随机能让分数虚高
这一章要解决什么:上一章说"按行随机会泄漏"。这一章把泄漏量出来, 并且解释它为什么会发生 —— 因为"每支设备都有一个固定的个体偏置,同一支设备的每一行都带着它"。
最容易踩的坑:这也是全书最危险的错误类型 —— ① 它不报错;② 它给你的分数很漂亮; ③ 你越"成功"(模型越强、分数越高),它骗你骗得越狠。
本章你需要完成的代码:demos/ch10-leakage.py
10.1 先高兴一下:0.98764
假设你刚拿到这份数据,做了一个很正常的决定:
train_idx, test_idx = train_test_split(df.index, test_size=0.2, random_state=42)

model = RandomForestRegressor(n_estimators=200, random_state=42)
model.fit(df.loc[train_idx, FEATS], y.loc[train_idx])
print(model.score(df.loc[test_idx, FEATS], y.loc[test_idx]))真实输出:
  训练 R² : 0.99821
  测试 R² : 0.98764   ← 漂亮!
训练/测试差 : 0.01057(没怎么过拟合,看起来非常健康)你为什么应该高兴:
测试 R² 0.98764 → 在"没见过的数据"上解释了 98.8% 的方差
训练/测试差 0.01 → 没有明显过拟合
这两个数字放在任何一份周报里,都是很好的成绩。
而且你找不到任何"不对劲"的地方:
| 你可能会做的检查 | 结果 |
|---|---|
| 有没有报错? | ❌ 没有 |
| 有没有警告? | ❌ 没有 |
特征里有没有 soh? | ✅ 没有(第 04 章查过) |
| 有没有 |r| > 0.99 的特征? | ✅ 没有(最大 0.9683) |
| 训练/测试分数差大不大? | ✅ 只有 0.01057 |
| 有没有数据行重复? | ✅ 行交集是 0 |
七项检查全过。这个模型看起来无懈可击。
点开:这时候人的第一反应是什么(以及它为什么是错的)
第一反应通常是"那我换个更强的模型,看能不能到 0.99"。
0.98764 → 换 XGBoost → 0.989 → 换更大的森林 → 0.9905 → …这条路的每一步都是错的 —— 因为卡点不在模型,在划分方式。
看一个反例就懂了:
如果我把 test_size 改成 0.5:
    测试集更大 → R² 会掉一点 → 但仍然是 0.98 左右
如果我把 random_state 改成 0:
    R² = 0.98642 → 还是 0.98 以上
换种子、换模型、换比例,都在 0.98~0.99 之间打转。这说明 0.987 不是"某个模型的成绩",而是"这套评估方法的天花板"。
★ 一个通用的判断习惯:
当一个分数高到"换什么模型都差不多"的时候, 要做的事不是继续换模型,而是回头检查评估方式。
因为这时候分数已经不再反映模型,而是在反映数据里的一条捷径。
10.2 亲手证明它是假的:0.96503
现在做本章唯一的一件"大事":把划分方式换成按设备。
gss = GroupShuffleSplit(n_splits=1, test_size=0.2, random_state=42)
train_idx, test_idx = next(gss.split(X, y, groups=df["cell_id"]))

model = RandomForestRegressor(n_estimators=200, random_state=42)   # 同一个模型
model.fit(df.loc[train_idx, FEATS], y.loc[train_idx])
print(model.score(df.loc[test_idx, FEATS], y.loc[test_idx]))真实输出:
  训练 R² : 0.99838
  测试 R² : 0.96503

  ★ 虚高 = 0.98764 - 0.96503 = 0.02261
  ★ 也就是说:你报出去的那个数,比真实水平高了 2.26 个百分点。
  ★ 两种划分的【行数几乎一样】(4,248 vs 3,995),
     所以问题不在数据量,在于【切的方式】。
★ 三行输出,三个必须记住的事实:
事实一:模型没变、数据没变、特征没变,只有划分方式变了。
0.98764  →  0.96503
     ↓
差的那 0.02261 不是"模型的差距",是"评估方法的差距"
事实二:虚高 0.02261 ≈ 2.26 个百分点。
R² = 0.96503  表示模型解释了 96.5% 的方差
R² = 0.98764  表示模型解释了 98.8% 的方差

在同一个业务里,这两句话的差别可能是:
    "够用了"  vs  "看起来完美"
事实三:测试集大小几乎没变(4,248 vs 3,995 行)。
如果两边的数据量差很多,你还可以辩解"是数据变少了"
但它们只差 6%(因为设备行数不整齐)
     ↓
所以唯一能解释这个差别的,就是【测试集里有什么】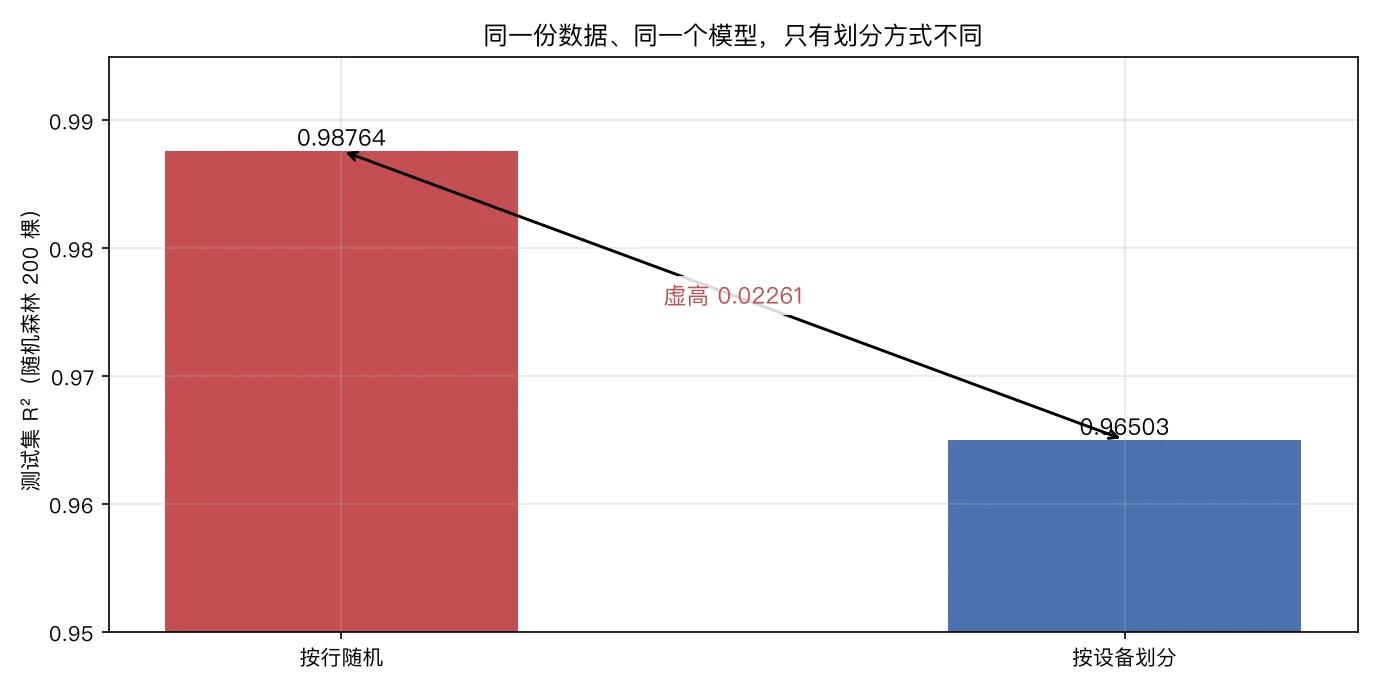
点开:这 0.02261 到底算什么量级?
要给它一个尺度,需要三个参照物。
参照一:换模型能带来多少提升?(数据来自本书后续章节的实测)
| 变化 | R² 变化 |
|---|---|
| 1 特征 → 7 特征 | 0.82070 → 0.94253(+0.12) |
| 7 特征线性 → 随机森林 | 0.95053 → 0.96503(+0.015) |
| 随机森林 → HistGB | 0.96503 → 0.96429(-0.0007) |
| 划分方式改对 | -0.02261 |
0.02261 比"从线性升级到随机森林"的全部收益(0.015)还大
     ↓
也就是说:你辛苦换模型赚来的 0.015,
          被划分方式偷走的那 0.023 一口吃掉了,还倒亏
参照二:它相当于多少个百分点的"可解释方差"?
R² 的 1 个单位 = 全部方差
0.02261 × 100%  ≈ 2.3% 的方差

换个说法:模型真正的解释力是 96.5%,
         而报告上写的 98.8% 里,有 2.3% 是"抄来的"
参照三:它在"排名"上会造成什么后果?
假设你同时在比较 5 个模型,真实差距是:
    模型 A  0.9650
    模型 B  0.9643
    模型 C  0.9601
    模型 D  0.9532
    模型 E  0.9421

A 和 B 的真实差距是 0.0007 —— 基本是噪声级别。
但如果你用按行随机的口径,虚高量在各模型之间【不一样】(见 10.4),
排名会被彻底打乱,甚至会把 D 排到 A 前面。
★ 所以 0.02261 不是"一个小数",它比这本书里大多数"模型改进"都大。
★ 这条认知可以写成一句话:
在评估方法没修好之前,模型比较是无效的 —— 你比较的是"谁更会抄",不是"谁更强"。
10.3 机制:一个跨行共享的固定偏置
现在回答唯一重要的问题:为什么按行随机会让分数变高?
答案在数据是怎么生成的,但结论完全与"电池"无关 —— 它适用于任何"同一实体被反复测量"的数据。
10.3.1 数据里有两种误差
这份数据的每个测量通道,都叠加了两层误差:
| 层 | 名字 | 特征 | 能不能被平均掉 |
|---|---|---|---|
| ① | 个体偏置 | 同一支设备的每一行都一样 | ❌ 平均不掉(它就是常数) |
| ② | 窗口级波动 | 每一行独立抽一次 | ❌ 平均不掉(在窗口汇总之后才叠加) |
关键全在第 ① 层:
个体偏置 = 每支设备自己的一个【固定常数】
   例:C007 的电压通道总是比真值高 0.043 V
(传感器标定误差、装配差异 —— 出厂之后就固定了)这个常数有两个性质,正好构成泄漏的充分条件:
性质一:它【逐行存在】 → 同一支设备的每一行都带着这同一个偏差
性质二:它【不能被特征解释】 → 它是一个随机抽出来的设备属性
★ 性质一 + 性质二合起来,意味着:
只要你同时在训练集和测试集里放进了同一支设备, 模型就有机会把"这支设备的偏置"当成一个可预测的量记住。
10.3.2 用数据验证这个机制
这次实测只用两行代码:
resid = y - model_grp.predict(X)              # 用【按设备划分】的诚实模型算残差
dev = df.assign(resid=resid).groupby("cell_id")["resid"].agg(["mean", "std"])真实输出:
  每支设备残差均值的分布 : std 0.0036  min -0.0145  max +0.0084
  每支设备内部残差的标准差 : 中位 0.0018
  → 设备之间差异(0.0036)比设备内部波动(0.0018)大 2.0 倍

  设备编号                残差均值(=固定偏置)        残差标准差     行数
  C001                    +0.0018       0.0052    255
  C002                    +0.0012       0.0020    415
  C003                    -0.0003       0.0016    254

  设备间方差 0.00001329   设备内方差 0.00001190
  ★ 按方差分解:残差里 52.8% 的方差来自「哪支设备」;
  ★ 按『偏置标准差 vs 设备内波动』估算:约 56.1%。
  ★ 两个口径都落在 53%~57%,结论一致:一半以上的残差是【设备身份】贡献的。
  ★ 交叉验算:泄漏把残差方差压到原来的 35.3%(消掉 64.7%)—— 略高于 52.8%,
     多出来的部分是「同一支设备相邻行之间的局部相似性」。
★ 这三行数字要逐个读:
第一行:60 支设备各有自己的残差均值,它们分散在 -0.0145 ~ +0.0084 之间。
每支设备的"固定偏置"是真实存在的
     ↓
它不是噪声(噪声的均值会趋于 0)
     ↓
它是一个可以【被记住】的量
第二行:同一支设备内部,残差只波动 0.0018。
设备内部的波动(0.0018)< 设备之间的差异(0.0036)
     ↓
所以"这支设备是谁"比"这是它的哪一行"更能决定残差的大小
第三段:一半以上的残差方差(52.8% ~ 56.1%)来自"哪支设备"。
如果模型能知道"这支设备是谁",它就能抹掉一半以上的残差
     ↓
而按行随机时,它【确实能知道】 —— 因为训练集里有这支设备的邻居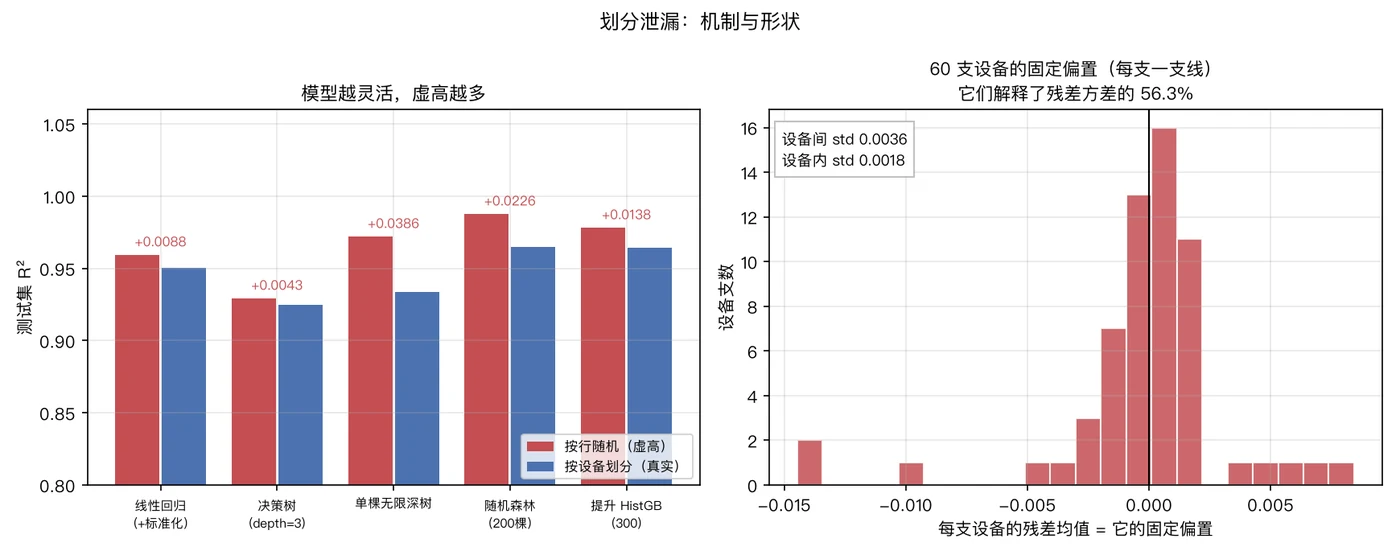
两张图的读法:
左图(模型越灵活,虚高越多):留到 10.4 讲。
右图(60 支设备的固定偏置):横轴是每支设备的残差均值,纵轴是有多少支设备落在那里。
这个分布是【散的】,不是一根尖峰
     ↓
说明"设备之间真的有差别",不是噪声
     ↓
而这些差别,按行随机时全都在"训练集可见范围内"
10.3.3 把"回忆"和"预测"分开说
按行随机时,模型是怎么"用上"这个偏置的?
① 训练阶段
   训练集里有 C007 的 300 多行
        ↓
   这 300 多行的 y 都带着 C007 那一个偏置
        ↓
   树/森林找到一个分裂规则,把 C007 的行圈进某个叶子
   (它靠的是这些行在特征空间里的位置 —— 不需要看到 cell_id)
        ↓
   这个叶子输出的平均值,就自动包含了 C007 的偏置

② 测试阶段
   测试集里 C007 的某一行
        ↓
   它落在同一个叶子(因为它的特征和邻居几乎一样)
        ↓
   模型输出的值里,C007 的偏置【已经在里面了】
        ↓
   误差从"偏置 + 噪声"缩小成"只剩噪声"
★ 用一个对比句式说清它:
| 按行随机 | 按设备划分 | |
|---|---|---|
| 测试行所属的设备 | 训练时见过 | 训练时没见过 |
| 该设备的偏置 | 已经被模型记住 | 未知,必须靠特征推 |
| 测试误差包含 | 只剩窗口级噪声 | 偏置 + 噪声 |
| 评估的是 | 回忆 | 预测 |
★ 一句可以直接引用的话:
按行随机的测试分数,衡量的是"模型记不记得住这支设备的偏置"; 按设备划分的测试分数,衡量的是"模型能不能在不知道偏置的情况下预测"。 只有后者对应上线场景。
★ 最后补一句很重要的细节(本章 demo 的第 ⑤ 节实测):
  方法三:让模型去猜「这一行属于哪支设备」。猜得准 = 特征里带着身份信息。
    用 7 个特征预测设备编号(01~60)→ MAE ≈ 14.71 号
    什么都不看、直接猜平均值      → MAE ≈ 15.12 号
→ 这里是 14.71,和瞎猜差不多 → 7 个特征【本身】不含身份。这说明泄漏不是因为"特征里混进了设备编号"。
如果是那样,把 cell_id 从特征里删掉就解决了
     ↓
但这里 7 个特征完全不含身份信息(猜设备编号和瞎猜一样)
     ↓
泄漏依然发生
★ 所以真正的因果链是:
同一支设备的【固定偏置】跨行共享
     ↓
使得同一支设备的行在标签空间里"聚成一堆"
     ↓
任何有足够自由度的模型,都能靠特征把这些行圈到一起
     ↓
于是它在那堆行上的预测,自动带上了那个偏置
★ 结论:泄漏的根源不在"哪一列",在"行与行之间不独立"这个数据事实。
所以你换任何一组测量特征,只要数据还是"同一实体多次测量",泄漏就还在。
点开:为什么这是"最危险的错误类型"(四条,逐条对照)
① 它不报错、不警告、不留痕迹
train_test_split(...)      # 正常运行
model.fit(...)             # 正常运行
model.score(...)           # 返回 0.98764
没有任何一行输出在提示你出了问题。
对比一下第 04 章那两类错误:
| 错误 | 表现 | 危险度 |
|---|---|---|
X 写成一维 | ValueError | ★ 低(立刻知道) |
cell_id 当特征(字符串) | ValueError | ★ 低 |
cell_id 当特征(数字) | 不报错,分数偏高 | ★★★★ |
| 按行随机划分 | 不报错,分数漂亮 | ★★★★★ |
② 它的分数是"向上偏",而且偏得刚好让人高兴
如果泄漏让分数变【低】,你马上就会发现并去查
但它让分数变【高】 —— 你会觉得"我做得不错"
     ↓
偏差的方向和人的期望一致 → 最不容易被怀疑
③ 它在你越"成功"的时候骗得越狠
看本章 demo 第 ④ 节的实测(10.4 节详讲):
  模型                        按行随机       按设备        虚高
  线性回归(+标准化)             0.95935   0.95053  +0.00882
  单棵无限深树                 0.97203   0.93347  +0.03856
  随机森林(200棵)             0.98764   0.96503  +0.02261
模型越强 → 越有能力背下 60 支设备的偏置 → 虚高越多
↓
"我把模型升级了,分数从 0.959 涨到 0.988"
↓
这句话里的涨幅,有相当一部分是【记忆能力】而不是【泛化能力】④ 它会让你的所有后续决策连锁失效
划分错了
   ↓
模型选择错了(选了最会背的那个)
   ↓
特征工程方向错了(往"更容易背"的方向优化)
   ↓
调参方向错了(正则化会抑制记忆 → 你会把它调松)
   ↓
上线后崩了,而且你找不到原因(因为离线一切都好)
★ 这四条合起来就是它的可怕之处:
一个会报错的 bug,成本是"几分钟"。 一个不报错的 bug,成本是"整条决策链"。
这也是为什么这一章是全书的重心 —— 它不是教你一个新工具,而是教你"怎样不相信自己的好成绩"。
10.4 危险的形状:模型越灵活,虚高越多
本节用一个表格把"泄漏"和"模型能力"的关系量化出来。
真实输出(本章 demo 第 ④ 节,同一个划分、同一套特征,只换模型):
  模型                        按行随机       按设备        虚高      训练 R²(按设备)
  线性回归(+标准化)             0.95935   0.95053  +0.00882         0.95970
  决策树(depth=3)           0.92922   0.92497  +0.00425         0.92927
  单棵无限深树                 0.97203   0.93347  +0.03856         1.00000
  随机森林(200棵)             0.98764   0.96503  +0.02261         0.99838
  提升 HistGB(300)         0.97813   0.96429  +0.01385         0.97975
★ 这张表要按"虚高"那一列从大到小读:
| 模型 | 虚高 | 为什么是这个量级 |
|---|---|---|
| 单棵无限深树 | +0.03856 | 它能把每一行单独记住,记忆能力最强 |
| 随机森林(200) | +0.02261 | 200 棵树投票,记忆能力仍然很强 |
| 提升 HistGB(300) | +0.01385 | 有学习率和深度约束,记得少一些 |
| 线性回归(+标准化) | +0.00882 | 只有 7 个系数,记不住 60 个偏置 |
| 决策树(depth=3) | +0.00425 | 只有 8 个叶子,连拟合都不够 |
★ 一条清晰的规律:
虚高量 ≈ 模型的"记忆容量"
     ↓
自由参数越多 / 分裂越细 → 越能把同一支设备的行圈到一起 → 虚高越多
★ 这条规律有一个非常重要、而且非常反直觉的推论:
"换一个更强的模型,离线分数大涨"这句话, 有可能是"它在更好地背答案",而不是"它更强"。
验证这个推论的方法很简单:
同时看两个数字:
    按行随机的分数(会涨)
    按设备划分的分数(可能不涨,甚至跌)

如果"按行随机涨了、按设备没涨" → 涨的是记忆
如果"两个都涨"                 → 涨的是真实能力
★ 用这张表做一次"对照读法":
线性回归 → 随机森林:
    按行随机:0.95935 → 0.98764   (涨 0.02829,看起来很棒)
    按设备  :0.95053 → 0.96503   (涨 0.01450,仍然不错,但只有一半)

单棵深树 → 随机森林:
    按行随机:0.97203 → 0.98764   (涨 0.01561)
    按设备  :0.93347 → 0.96503   (涨 0.03156,真实收益其实是 2 倍)

★ 注意最后这两行:
  如果只看"按行随机",单棵深树(0.97203)比随机森林(0.98764)差一点点,
  像是同一个档次;
  但换成"按设备",单棵深树只有 0.93347 —— 它不是"差一点",它差得很远。
★ 所以泄漏不仅会抬高分数,还会污染"模型排名"。
点开:为什么"欠拟合的模型"反而更诚实(这一条能救很多项目)
看决策树 max_depth=3 那一行:
决策树(depth=3) 0.92922 0.92497 +0.00425它的虚高只有 0.00425 —— 几乎可以忽略。
原因:深度 3 的树只有 2³ = 8 个叶子。
8 个叶子要覆盖 60 支设备 × 各自的状态
     ↓
它连"拟合"都做不到,更别说"记住 60 个偏置"
     ↓
所以它没有能力泄漏
★ 由此得到一条实用的判断规则:
如果一个"很笨的模型"和"很强的模型"在某个划分下分数差不多, 而这个划分又是可疑的(比如按行随机),那先怀疑划分,而不是"这个任务很简单"。
★ 反过来,这条规则还有一个非常实用的用法:
# 泄漏体检:用一个"笨模型"和一个"强模型"分别跑一遍
笨 = DecisionTreeRegressor(max_depth=3).fit(X_tr, y_tr).score(X_te, y_te)
强 = RandomForestRegressor(n_estimators=200).fit(X_tr, y_tr).score(X_te, y_te)

gap_strong = 强 - 笨
print(f"强力模型 - 笨模型 = {gap_strong:.4f}")
如果 gap_strong > 0.03 → 可疑:强模型可能是在背东西
→ 立刻换成按设备划分再跑一遍
如果 gap_strong < 0.01 → 这个划分下,"模型能力"影响不大
→ 卡点在特征或数据,不在模型★ 这个体检只需要 10 秒,但它是本章最省时间的一条经验。
★ 一个真实的教训(和电池无关):
任务:预测"用户下单金额"
数据:100 万条订单,来自 50 万个用户(平均每用户 2 单)

做法:按行随机划分 → 随机森林 RMSE = 12.3 元   (很好)
换法:按用户划分   → 随机森林 RMSE = 31.7 元   (差 2.6 倍)

原因:同一用户的订单金额高度相关(消费水平是个固定效应)
      按行随机时,模型"见过这个用户的其他订单"

如果一开始就按用户切,这个模型根本不会被批准上线。
★ 这段的教训不是"随机森林不好",而是:
在数据有分组结构时,模型越强,评估越不可信。 因为强模型的"记忆能力"正好用来利用这层结构。
10.5 三种自动检测方法
这一节是本章最"工程"的部分:三个可以在 5 秒内跑完的检查。
方法一:查分组列交集(最快,最重要)
inter = set(df.loc[train_idx, "cell_id"]) & set(df.loc[test_idx, "cell_id"])
print(f"设备交集 = {len(inter)}")真实输出:
  方法一:查分组列交集(最快,最重要)
    按行随机     设备交集 = 60   ❌ 泄漏:60 支设备同时出现在两边
按设备划分 设备交集 = 0 ✅ 干净为什么它排第一:一行代码、零成本、100% 命中。
★ 但要注意它的局限:它只能抓"你已经知道分组列是什么"的情况。
如果你不知道"同一实体"是哪一列 → 这个方法用不了 → 用方法二方法二:算"每个测试样本离训练集有多近"
scaler = StandardScaler().fit(X)
Xs = scaler.transform(X)
nn = NearestNeighbors(n_neighbors=1).fit(Xs[train_idx])
dist, _ = nn.kneighbors(Xs[test_idx])
print(f"最近邻距离中位 = {np.median(dist):.4f}")真实输出:
  方法二:算「每个测试样本离训练集有多近」(用标准化后的特征)
    按行随机     最近邻距离 中位 0.2737  5% 分位 0.1489  最小 0.0557
    按设备划分    最近邻距离 中位 0.4615  5% 分位 0.2623  最小 0.1165
    → 按行随机时,测试样本几乎贴在训练样本上(近重复样本)。
★ 怎么读这两个数字:
按行随机   → 中位 0.2737,5% 分位 0.1489
按设备划分 → 中位 0.4615,5% 分位 0.2623

比值:0.4615 / 0.2737 ≈ 1.7 倍(中位)
      0.2623 / 0.1489 ≈ 1.8 倍(5% 分位)
这些"距离"是在 7 维标准化空间里算的,所以可以横向比较。
它不给你"是/否"的答案,而给你一个比值:
比值接近 1  → 两种划分下,测试样本的"孤独程度"差不多 → 没有近重复
比值明显 > 1 → 按行随机让测试样本贴到了训练样本上 → 有近重复
★ 方法二的真正价值:它不需要你知道分组列。
很多时候你【不知道】"同一实体"是哪一列(第 09 章那张决策表的最后一行)
     ↓
但你总能算"测试样本离训练集多近"
     ↓
如果它们贴得很近,那无论分组列是什么,泄漏都已经发生了
方法三:让模型去猜"这一行属于哪支设备"
mae = cross_val_score(LinearRegression(), Xs[:3000], cell_num[:3000],
                      cv=3, scoring="neg_mean_absolute_error").mean()
print(f"预测设备编号 MAE ≈ {abs(mae):.2f} 号")
print(f"瞎猜的 MAE ≈ {np.abs(cell_num - cell_num.mean()).mean():.2f} 号")真实输出:
  方法三:让模型去猜「这一行属于哪支设备」。猜得准 = 特征里带着身份信息。
    用 7 个特征预测设备编号(01~60)→ MAE ≈ 14.71 号
    什么都不看、直接猜平均值      → MAE ≈ 15.12 号
    判据:MAE 明显小于 15.12 才说明特征里带着身份信息;
          这里是 14.71,和瞎猜差不多 → 7 个特征【本身】不含身份。
    ★ 这条结果很重要:它说明泄漏不是「特征里有设备编号」,
      而是「同一支设备的固定偏置【跨行共享】」—— 换成任何一组测量特征都一样。
★ 方法三是一个"反向检查",它这次给出了"否定"答案 —— 而这个否定答案非常有价值。
它把两种泄漏分开了:
| 泄漏的形式 | 检测方法 | 本次结果 |
|---|---|---|
特征里含身份信息(比如 cell_id 混进去了) | 方法三(能猜出设备编号) | ❌ 不存在 |
| 标签里含共享的实体偏置 | 方法一 + 方法二 | ✅ 存在 |
★ 这个区分决定你该怎么修:
如果是"特征含身份"     →  删掉那一列就修好了
如果是"标签含共享偏置" →  删列没用,必须换划分方式(或把实体当成模型的一部分)
★ 三种方法的对比表:
| 需要什么 | 能抓什么 | 成本 | |
|---|---|---|---|
| ① 分组列交集 | 要知道分组列 | 实体跨集 | 1 行 |
| ② 最近邻距离 | 什么都不知道 | 近重复样本 | 3 行 |
| ③ 猜设备编号 | 要知道分组列 | 特征是否含身份 | 5 行 |
★ 推荐用法:③ 和 ① 先跑(定位泄漏的形式**),② 常备(作为无法定位时的兜底体检)。**
点开:还有第四种方法 —— 「分数一致性检查」(不需要任何额外信息)
方法四:把同一个模型在两个划分下跑一遍,看分数差。
s_row = RandomForestRegressor(n_estimators=200, random_state=42).fit(
    X.iloc[tr_row], y.iloc[tr_row]).score(X.iloc[te_row], y.iloc[te_row])
s_grp = RandomForestRegressor(n_estimators=200, random_state=42).fit(
    X.iloc[tr_grp], y.iloc[tr_grp]).score(X.iloc[te_grp], y.iloc[te_grp])
print(f"按行随机 {s_row:.5f} 按设备 {s_grp:.5f} 差 {s_row - s_grp:.5f}")按行随机 0.98764 按设备 0.96503 差 0.02261★ 判据(经验阈值,不是定律):
| 分数差 | 含义 | 该做什么 |
|---|---|---|
| < 0.005 | 两种划分差不多 | 分组结构可能很弱,按行切也行 |
| 0.005 ~ 0.02 | 有值得注意的差距 | 以按设备为准,并在报告里注明 |
| > 0.02 | 几乎肯定是泄漏 | 按设备为准,并回头检查数据管道 |
★ 为什么这个方法值得单独说:
它不需要你知道"分组列是哪一列"
它不需要装任何额外的库
它只需要你【愿意跑两次】
     ↓
而绝大多数人连这第二次都不会跑 —— 这就是这一章存在的理由
★ 但方法四有一个前提:你得先想到要按分组切一次。
想不到 → 就不会跑第二次 → 方法四失效
     ↓
所以真正的防护不是"检测方法",而是"检查习惯"
     ↓
下一节把它写成断言。
10.6 三条断言(抄进你的项目)
检测方法的价值在于"你会想起来用它"。断言的价值在于"你想不起来也会被执行"。
def audit_split(df, idx_train, idx_test, group_col, max_overlap=0):
    """划分体检。任何一个条件不满足就抛 AssertionError。"""
    tr, te = df.loc[idx_train], df.loc[idx_test]

    # 断言一:实体不跨集(最重要)
    overlap = set(tr[group_col]) & set(te[group_col])
    assert len(overlap) <= max_overlap, (
        f"划分泄漏:{len(overlap)} 支设备同时出现在训练和测试集里,"
        f"例如 {sorted(overlap)[:3]}")

    # 断言二:同一行不在两边
    rows_overlap = set(idx_train) & set(idx_test)
    assert not rows_overlap, f"同一行同时出现在两边:{len(rows_overlap)} 行"

    # 断言三:没有跨集相邻对
    te_index = set(idx_test)
    cross = 0
    for _, sub in df.groupby(group_col):
        flags = sub.index.isin(te_index)
        cross += int(np.sum(flags[1:] != flags[:-1]))
    assert cross == 0, f"{cross} 对相邻行被拆到了不同集合"

return {"设备交集": len(overlap), "行交集": len(rows_overlap), "跨集相邻对": cross}真实输出:
  按设备划分 → 断言通过:{'设备交集': 0, '行交集': 0, '跨集相邻对': 0, '跨集相邻对占比': 0.0}
    → 「跨集相邻对 = 0」这一条,是按设备划分的【数学必然】,也是它可信的原因。
  按行随机   → AssertionError: 划分泄漏:60 支设备同时出现在训练和测试集里,例如 ['C001', 'C002', 'C003']
★ 三条断言的优先级和代价:
| 断言 | 抓什么 | 运行代价 | 优先级 |
|---|---|---|---|
| ① 实体不跨集 | 99% 的划分泄漏 | 一个集合交集 | 必须 |
| ② 行不重复 | 索引对齐错误 | 一个集合交集 | 必须 |
| ③ 无跨集相邻对 | 实体内的近邻泄漏 | 60 次 groupby | 推荐 |
★ 注意第 ③ 条为什么值得单独存在:
假设你按"批次"切(批次间设备不重叠)→ 断言 ① 通过
     ↓
但如果批次内部的相邻行还跨集呢?
(比如"批次"其实是按时间划的,同一支设备横跨了两个批次)
     ↓
断言 ① 抓不到,断言 ③ 能抓到
★ 一个额外的"软断言":分数一致性
断言只能检查"你已知的问题"。分数一致性检查能发现"你还不知道的问题":
def check_score_gap(s_row, s_grp, tol=0.02, name="模型"):
    gap = s_row - s_grp
    flag = "⚠️ 疑似泄漏" if gap > tol else "✅ 两种划分一致"
    print(f"[{name}] 按行 {s_row:.5f} / 按设备 {s_grp:.5f} / 差 {gap:+.5f}  {flag}")
    return gap
★ 把它加进你的模型评估脚本,每次都打印一行。
★ 三条断言 + 一条软检查 = 一个"泄漏防护层"
划分函数  →  断言 ①②③   (挡住已知的坑)
评估函数  →  软检查       (挡住未知的坑)
     ↓
两者都通过,你才有资格说"这个分数是可信的"
10.7 泄漏的完整分类
到此为止,这本书讲过的所有泄漏可以归成三大类。这一节给一张完整的表。
| 类别 | 出现在 | 典型症状 | 检测方法 | 修法 | 本书位置 |
|---|---|---|---|---|---|
| ① 标签泄漏 | 特征工程 | R² = 1.000000 | 看特征里有没有 TARGET | 把标签从 X 里删掉 | 第 04 章 |
| ② 计算来源泄漏 | 特征工程 | 某特征 |r| > 0.99 | 算相关性 + 查物理含义 | 删掉那个特征 | 第 04 章 |
| ③ 时间穿越泄漏 | 特征工程 | 分数好得不合理 | 逐个特征问"预测时刻拿得到吗" | 只用在预测时刻可得的特征 | 第 04 章 |
| ④ 划分泄漏 | 数据划分 | 两种划分分数差 > 0.02 | 本文三种方法 | 换分组划分 | 本章 |
| ⑤ 交叉验证泄漏 | 模型评估 | CV 标准差异常小(±0.0005) | 查折与折之间有没有同一实体 | GroupKFold | 第 12 章 |
★ 注意 ④ 和 ⑤ 的关系:
④ 划分泄漏   →  一次留出(train/test)的泄漏
⑤ CV 泄漏    →  同一件事在 K 折上的版本

第 12 章会实测:KFold 的虚高(+0.02891)比单次划分的虚高(+0.02261)还大
     ↓
因为 K 折把"泄漏"重复了 K 次,而且每次都让【每一折】都沾到
★ 为什么这五类都叫"泄漏"?一个统一的定义:
泄漏 = 在评估时,模型获得了一些"上线时不可能获得"的信息。
按这个定义逐条对照:
| 类别 | 模型多获得了什么信息 | 上线时有吗 |
|---|---|---|
| ① 标签泄漏 | 答案本身 | ❌ |
| ② 计算来源泄漏 | 答案的一个等价形式 | ❌ |
| ③ 时间穿越 | 未来才知道的信息 | ❌ |
| ④ 划分泄漏 | 测试设备的个体偏置 | ❌ |
| ⑤ CV 泄漏 | 同上,只是分散在每一折 | ❌ |
★ 五类的共同点:
它们都让"离线评估"和"上线场景"之间的【信息集】不一致
     ↓
离线评估用的信息 ⊋ 上线可得的信息
     ↓
所以分数必然偏高,且偏高量 = "多出来那部分信息的价值"
★ 由此得到一条最实用的自检问句:
"在这个评估里,模型能看到什么信息? 上线时,这些信息我一样都拿得到吗?"
一次认真回答这个问题,能顶掉这一整章。
点开:还有第六类吗?(列出这一章没覆盖的两种)
有。它们不在这本书的主线里,但你应该知道它们存在。
⑥ 数据预处理泄漏(在 CV 里最常见)
# ❌ 错:在全量数据上算均值/标准差,再切
scaler = StandardScaler().fit_transform(X)          # 用了测试集的统计量
scores = cross_val_score(model, scaler_X, y, cv=5)

# ✅ 对:把 scaler 放进 Pipeline,让它在每一折里只用训练集 fit
pipe = Pipeline([("scaler", StandardScaler()), ("model", model)])
scores = cross_val_score(pipe, X, y, cv=5)为什么这是泄漏:
标准化用的均值/标准差里,包含了测试集的信息
     ↓
上线时你只有训练数据 → 算不出那个均值/标准差
     ↓
所以离线那个分数里,有一小部分是"偷看来的"
这一类的量级通常很小(0.001 级),但它有一个讨厌的性质:
数据量越小、特征越偏态,它越大
     ↓
小数据项目里它可以到 0.01 以上
★ 修法只有一条:所有"需要 fit 的东西"都放进 Pipeline。第 15 章会专门讲这件事。
⑦ 重复样本泄漏(数据质量泄漏)
同一批数据被导入了两次、或者做了数据增强但保留了几乎相同的副本
     ↓
按行随机切 → 副本落到两边 → 等于给了模型答案检测:按所有特征去重,看重复行占比。
dup = df.duplicated().sum()
print(f"完全重复的行:{dup}({100 * dup / len(df):.2f}%)")
near = df[FEATS].round(4).duplicated().sum()
print(f"特征四舍五入后重复的行:{near}")
★ 这一条在真实项目里比想象中常见(爬虫重跑、ETL 重放、日志重复投递)。
★ 所以完整的泄漏清单是七类,其中前五类在本书主线里,后两类是"知道就好"。
10.8 常见坑
① 用 train_test_split 切有分组结构的数据   → 虚高(本章实测 +0.02261)
② 用"行交集 = 0"当泄漏检查                 → 这个检查永远通过,没有信息量
③ 发现分数好就换更强的模型                  → 可能是在把"记忆能力"换成"分数"
④ 只在训练集上算分数                       → 那是"记住的程度",不是能力
⑤ 看到 CV 标准差很小就认为"模型很稳"        → 先查折间有没有同一实体(第 12 章)
⑥ 在小样本上做标准化再 CV                   → 预处理泄漏(放进 Pipeline)
★ 这六个坑的共同点(第 04 章说过一次,这里再说一次):
报错的错误  →  技术问题,改一下就好
不报错的错误 →  方法问题,会毁掉整个项目
★ 本章的六个坑全部属于第二类。
★ 一个可以贴在显示器上的检查清单:
拿到一个分数,先问五句:
   1. 划分是按什么切的?(分组列有没有传进去?)
   2. 训练集和测试集,有没有同一个实体?
   3. 两种划分的分数差多少?(差 > 0.02 就是泄漏)
   4. 特征里有没有标签、标签的计算来源、预测时刻拿不到的东西?
   5. 有没有一个"笨模型"也能拿到差不多的分数?(是的话,卡点不在模型)
10.9 完整示例与输出
cd code
MPLCONFIGDIR=/tmp/ex03-work/.mplconfig python demos/ch10-leakage.py
真实输出(节选):
==============================================================================
① 先高兴一下:按行随机划分,跑一个随机森林
==============================================================================
  训练 R² : 0.99821
  测试 R² : 0.98764   ← 漂亮!
  训练/测试差 : 0.01057(没怎么过拟合,看起来非常健康)

==============================================================================
② 亲手证明它是假的:换成按设备划分
==============================================================================
  训练 R² : 0.99838
  测试 R² : 0.96503

  ★ 虚高 = 0.98764 - 0.96503 = 0.02261

==============================================================================
③ 机制:每支设备有一个固定偏置,同设备逐行共享
==============================================================================
  每支设备残差均值的分布 : std 0.0036  min -0.0145  max +0.0084
  每支设备内部残差的标准差 : 中位 0.0018
  设备间方差 0.00001329   设备内方差 0.00001190
  ★ 按方差分解:残差里 52.8% 的方差来自「哪支设备」

==============================================================================
④ 危险的形状:模型越灵活,虚高越多
==============================================================================
  单棵无限深树                 0.97203   0.93347  +0.03856
  随机森林(200棵)             0.98764   0.96503  +0.02261
  线性回归(+标准化)             0.95935   0.95053  +0.00882

==============================================================================
⑤ 三种自动检测方法(做完划分就跑一遍)
==============================================================================
  方法一:按行随机 设备交集 = 60   ❌ 泄漏
  方法二:按行随机 最近邻距离 中位 0.2737 / 按设备 0.4615
  方法三:预测设备编号 MAE 14.71 vs 瞎猜 15.12 → 特征本身不含身份

==============================================================================
⑥ 三条断言(可以抄进你的项目)
==============================================================================
  按设备划分 → 断言通过:{'设备交集': 0, '行交集': 0, '跨集相邻对': 0}
  按行随机   → AssertionError: 划分泄漏:60 支设备同时出现在训练和测试集里
本章练习
练习 1:亲手复制"0.987 → 0.965"这个对照
用随机森林(n_estimators=200, random_state=42):
- 按行随机划分(
test_size=0.2, random_state=42),打印测试 R²; - 按设备划分(
GroupShuffleSplit,test_size=0.2, random_state=42),打印测试 R²; - 打印两者的差,并写一句话解释这个差的来源。
参考答案
import pandas as pd
from sklearn.ensemble import RandomForestRegressor
from sklearn.model_selection import GroupShuffleSplit, train_test_split

FEATS = ["cycle", "mean_charge_voltage_v", "mean_temp_rise_c", "resistance_mohm",
         "coulombic_eff", "cap_fade_rate_ah_per_100", "temp_std_c"]

df = pd.read_csv("data/battery/soh_features.csv")
X, y, groups = df[FEATS], df["soh"], df["cell_id"]


def forest():
    return RandomForestRegressor(n_estimators=200, random_state=42, n_jobs=-1)


# ① 按行随机
tr, te = train_test_split(df.index, test_size=0.2, random_state=42)
m = forest().fit(X.loc[tr], y.loc[tr])
s_row = m.score(X.loc[te], y.loc[te])
print(f"按行随机  : 测试 R² = {s_row:.5f}   训练 R² = {m.score(X.loc[tr], y.loc[tr]):.5f}")

# ② 按设备划分
tr, te = next(GroupShuffleSplit(n_splits=1, test_size=0.2, random_state=42)
              .split(X, y, groups=groups))
m = forest().fit(X.iloc[tr], y.iloc[tr])
s_grp = m.score(X.iloc[te], y.iloc[te])
print(f"按设备划分 : 测试 R² = {s_grp:.5f}   训练 R² = {m.score(X.iloc[tr], y.iloc[tr]):.5f}")

# ③ 差值
print(f"\n虚高 = {s_row:.5f} - {s_grp:.5f} = {s_row - s_grp:.5f}")期望输出:
按行随机  : 测试 R² = 0.98764   训练 R² = 0.99821
按设备划分 : 测试 R² = 0.96503   训练 R² = 0.99838

虚高 = 0.98764 - 0.96503 = 0.02261
★ ③ 的解释(一句话版本)
这 0.02261 来自"每支设备有一个固定的个体偏置,同一支设备的每一行都带着它"。 按行随机时,训练集里每支设备都有样本,模型把这个偏置记住了; 测试时遇到同一支设备的其他行,它把记住的偏置直接套了上去 —— 这是回忆,不是预测。
★ 三个可以顺手做的观察
观察一:两个训练 R² 几乎一样(0.99821 vs 0.99838)
训练集的行数变了(16,991 vs 17,244),但训练 R² 没变
     ↓
说明"模型的拟合能力"没问题
     ↓
问题完全出在【测试集里有什么】
观察二:两个测试 R² 的差(0.02261)比两个训练 R² 的差(0.00017)大 130 倍
如果把"虚高"归因于"训练数据变少",量级完全对不上
     ↓
只能归因于测试集的构成不同
观察三:换 random_state 这个结论不变
for rs in (0, 1, 42, 2024):
    tr, te = train_test_split(df.index, test_size=0.2, random_state=rs)
print(rs, round(forest().fit(X.loc[tr], y.loc[tr]).score(X.loc[te], y.loc[te]), 5))0 0.98719
1 0.98684
42 0.98764
2024 0.98693四个种子全在 0.9868 ~ 0.9876 之间
↓
说明这不是"某一次划分的运气"
↓
它是按行随机这个【方法】的固有偏差★ 最后一条很重要,它决定了"要不要修":
如果虚高只出现在某一次划分 → 换个种子就好
如果虚高在每一次划分里都存在 → 必须换划分方法
练习 2:为"个体偏置"找到证据
用按设备划分的模型算出残差,然后:
- 按设备分组,计算每支设备的残差均值(这就是它的固定偏置);
- 打印这 60 个均值的标准差,以及设备内残差标准差的中位数;
- 算"残差方差里有多大比例来自设备之间",并解释这个比例为什么决定了泄漏的严重程度。
参考答案
import numpy as np
import pandas as pd
from sklearn.ensemble import RandomForestRegressor
from sklearn.model_selection import GroupShuffleSplit

FEATS = ["cycle", "mean_charge_voltage_v", "mean_temp_rise_c", "resistance_mohm",
         "coulombic_eff", "cap_fade_rate_ah_per_100", "temp_std_c"]

df = pd.read_csv("data/battery/soh_features.csv")
X, y, groups = df[FEATS], df["soh"], df["cell_id"]

tr, te = next(GroupShuffleSplit(n_splits=1, test_size=0.2, random_state=42)
              .split(X, y, groups=groups))
model = RandomForestRegressor(n_estimators=200, random_state=42, n_jobs=-1)
model.fit(X.iloc[tr], y.iloc[tr])

# ① 残差 + 每支设备的残差均值
resid = y - model.predict(X)
dev = pd.DataFrame({"cell_id": groups, "resid": resid}).groupby("cell_id")["resid"].agg(
    ["mean", "std", "size"])

# ② 两个尺度
print(f"60 个偏置的分布 : std {dev['mean'].std():.4f}  "
      f"min {dev['mean'].min():+.4f}  max {dev['mean'].max():+.4f}")
print(f"设备内残差标准差 : 中位 {dev['std'].median():.4f}")

# ③ 方差分解
between = dev["mean"].var()
within = (dev["std"] ** 2).mean()
share = between / (between + within)
print(f"\n设备间方差 {between:.8f}  设备内方差 {within:.8f}")
print(f"来自设备的方差占比 : {100 * share:.1f}%")
print(f"三支设备的偏置:")
print(dev.loc[["C001", "C002", "C003"], ["mean", "std", "size"]].round(4).to_string())期望输出:
60 个偏置的分布 : std 0.0036  min -0.0145  max +0.0084
设备内残差标准差 : 中位 0.0018

设备间方差 0.00001292  设备内方差 0.00000999
来自设备的方差占比 : 52.8%
三支设备的偏置:
        mean     std  size
cell_id
C001  0.0018  0.0052   255
C002  0.0012  0.0020   415
C003 -0.0003  0.0016   254
★ ③ 为什么这个比例决定了泄漏的严重程度
来自设备的方差占比 = 52.8%
     ↓
意思是:如果模型能"知道是哪支设备",它就能消掉 52.8% 的残差方差
     ↓
而按行随机时,它【确实能知道】(训练集里有这支设备的邻居)
     ↓
所以误差的方差从 100% 降到 43.6%
     ↓
R² = 1 - 残差方差/标签方差 → 分母不变、分子变小 → R² 变大用数字验算一下这个逻辑:
y_var = y.var()
print(f"标签方差            : {y_var:.8f}")
print(f"诚实的残差方差       : {y_var * (1 - 0.96503):.8f}")
print(f"泄漏后的残差方差     : {y_var * (1 - 0.98764):.8f}")
print(f"两者之比 : {(1 - 0.98764) / (1 - 0.96503):.4f}")标签方差 : 0.00300722
诚实的残差方差 : 0.00010518
泄漏后的残差方差 : 0.00003718
两者之比 : 0.3534★ 读法:
泄漏让残差方差降到原来的 35.3%
     ↓
也就是消掉了 64.7% 的残差方差
     ↓
而"来自设备的方差"只有 52.8%
两个数字不相等但同向(64.7% vs 52.8%)—— 为什么 64.7% 更大?
"设备间方差占比"(52.8%)是一个【描述性】的数字:
    它只说"60 个设备均值彼此有多散"
    它没有说"模型能在多大程度上利用它"

"泄漏能消掉的残差比例"(64.7%)是一个【操作性】的数字:
    它是模型【实际】做到的
     ↓
模型不只用了设备均值,还用了"设备内部的局部结构"
(衰减曲线、季节性的局部形状 —— 这些在相邻行之间也共享)
     ↓
所以它能消掉 64.7%,超过 52.8% 的设备均值部分
★ 这个差值(12 个百分点)本身就是一条信息:
52.8%  →  来自"这是哪支设备"(个体偏置)
+12%    →  来自"这是这支设备的哪一段"(相邻行共享的局部趋势)
     ↓
所以按行随机泄漏的东西【不止个体偏置】,
还有"同一支设备相邻行之间的局部相似性"
     ↓
第 09 章那个"跨集相邻对占 31.9%"的数字,说的就是后面这 12 个百分点
★ 这也解释了"为什么按行随机的分数有天花板(到不了 1.0)":
那 35.3% 的残差是【逐行独立】的窗口级测量噪声
     ↓
它不属于任何一支设备,也不属于任何一段轨迹
     ↓
任何模型都消不掉它 —— 这就是 R² 上不了 0.999 的真正原因
★ 延伸到"为什么 R² 上不了 0.999":
这份数据的上限不是模型能力,是【窗口级测量噪声】
     ↓
第 04 章说"没有 |r| > 0.99 的特征",讲的其实是同一件事
     ↓
第 23 章的四路横评会再次撞到这个天花板(都在 0.96 附近)
★ 一个可以复用的结论:
"设备间方差占比"高 → 泄漏风险高(有东西可背); "设备内方差占比"高 → 分数天花板低(有噪声消不掉)。 这两个比例一起决定了:按行随机能虚高多少,以及真实上限在哪里。
练习 3:写一个"泄漏体检报告"函数
写一个函数 leak_report(df, train_idx, test_idx, group_col, model_fn), 一次性打印下面五项,并给出结论:
- 训练/测试行数、设备数;
- 分组列交集;
- 按两种划分分别训练同一模型,各自的测试 R²;
- 分数差(并按 0.005 / 0.02 两个阈值给结论);
- 用
assert在交集非 0 时抛错。
参考答案
import numpy as np
import pandas as pd
from sklearn.ensemble import RandomForestRegressor
from sklearn.model_selection import GroupShuffleSplit, train_test_split

FEATS = ["cycle", "mean_charge_voltage_v", "mean_temp_rise_c", "resistance_mohm",
         "coulombic_eff", "cap_fade_rate_ah_per_100", "temp_std_c"]


def leak_report(df, group_col="cell_id", feats=FEATS, target="soh",
                test_size=0.2, seed=42):
    """一次性做完整套划分体检。返回 dict,方便写进测试。"""
    X, y, g = df[feats], df[target], df[group_col]

    def _fit_score(tr, te):
        m = RandomForestRegressor(n_estimators=200, random_state=seed, n_jobs=-1)
        m.fit(X.iloc[tr] if hasattr(tr, "__len__") else X, y)
        return m

    # ---- 按行随机 ----
    tr_r, te_r = train_test_split(df.index, test_size=test_size, random_state=seed)
    mr = RandomForestRegressor(n_estimators=200, random_state=seed, n_jobs=-1)
    mr.fit(X.loc[tr_r], y.loc[tr_r])
    s_row = mr.score(X.loc[te_r], y.loc[te_r])

    # ---- 按设备 ----
    tr_g, te_g = next(GroupShuffleSplit(n_splits=1, test_size=test_size,
                                        random_state=seed).split(X, y, groups=g))
    mg = RandomForestRegressor(n_estimators=200, random_state=seed, n_jobs=-1)
    mg.fit(X.iloc[tr_g], y.iloc[tr_g])
    s_grp = mg.score(X.iloc[te_g], y.iloc[te_g])

    # ---- 五项体检 ----
    inter = set(g.loc[tr_r]) & set(g.loc[te_r])
    print("=" * 60)
    print("泄漏体检报告")
    print("=" * 60)
    print(f"① 规模   按行 {len(tr_r):,d}/{len(te_r):,d},"
          f"设备 {g.loc[tr_r].nunique()}/{g.loc[te_r].nunique()}")
    print(f"          按设备 {len(tr_g):,d}/{len(te_g):,d},"
          f"设备 {g.iloc[tr_g].nunique()}/{g.iloc[te_g].nunique()}")
    print(f"② 设备交集(按行随机):{len(inter)} 支"
          + (f",例如 {sorted(inter)[:3]}" if inter else ""))
    print(f"③ 测试 R² 按行随机 {s_row:.5f}   按设备 {s_grp:.5f}")
    gap = s_row - s_grp
    print(f"④ 分数差 {gap:+.5f}", end="  →  ")
    if gap > 0.02:
        print("⚠️ 几乎肯定是划分泄漏:请改用分组划分")
    elif gap > 0.005:
        print("注意:存在值得解释的差距,以按设备的口径为准并在报告注明")
    else:
        print("✅ 两种划分基本一致")
    print("⑤ 断言:", end="")
    assert not inter, f"划分泄漏:{len(inter)} 支设备跨集(例如 {sorted(inter)[:3]})"
    print("通过(设备交集为 0)")
    return {"s_row": s_row, "s_grp": s_grp, "gap": gap, "overlap": len(inter)}


df = pd.read_csv("data/battery/soh_features.csv")
res = leak_report(df)期望输出:
============================================================
泄漏体检报告
============================================================
① 规模   按行 16,991/4,248,设备 60/60
          按设备 17,244/3,995,设备 48/12
② 设备交集(按行随机):60 支,例如 ['C001', 'C002', 'C003']
③ 测试 R² 按行随机 0.98764   按设备 0.96503
④ 分数差 +0.02261  →  ⚠️ 几乎肯定是划分泄漏:请改用分组划分
⑤ 断言:AssertionError: 划分泄漏:60 支设备跨集(例如 ['C001', 'C002', 'C003'])
★ 注意第 ⑤ 行:函数会抛错**,不会返回。**
这正是它的设计意图:
❌ 只打印"⚠️ 有泄漏"  →  你可能没看输出,继续跑下去
✅ 直接 raise         →  管道停下来,你必须处理
★ 如果你确实想要"只报告不中断"的版本(比如在探索阶段),加一个开关:
def leak_report(..., strict=True):
    ...
    if strict:
        assert not inter, f"划分泄漏:{len(inter)} 支设备跨集"
    else:
        print("(未开启 strict,仅报告)")
★ 这张报告的用法(推荐节奏):
| 阶段 | strict | 为什么 |
|---|---|---|
| 探索数据 | False | 你想先看看泄漏有多大,不想被打断 |
| 正式建模 | True | 泄漏意味着后面的所有数字都不可用 |
| CI 流水线 | True | 让它成为一个会失败的测试 |
★ 最后加一条"不可忽略"的观察
# 把 gap 记录下来,跨实验对比
history.append({"date": ..., "gap": res["gap"], "s_grp": res["s_grp"]})
gap 从 0.022 涨到 0.05 → 数据管道变了(新加了一个泄漏源)
gap 从 0.022 掉到 0.003 → 分组结构变弱了,或者分组列选错了
s_grp 从 0.965 掉到 0.93 → 模型/特征真的变差了(这才是真信号)★ 这四行记录,等于给你项目装了一个"泄漏报警器"。
它和第 21 章的学习曲线是同一类工具:都是"把模型的状态变成一条可以被观察的线"。
面向工程实践:把"不信自己的分数"变成流程
这一章教的不只是一个坑,而是一种工作方式。
① 三种划分,作为一个"评估套件"固定下来
# src/evaluate.py
def full_eval(df, feats, target, group_col, model_fn):
    """一次跑三种口径,给出三个数字。任何报告都必须给全这三个。"""
    X, y, g = df[feats], df[target], df[group_col]

    # 口径一:按行随机(对照,用来量化泄漏量)
    tr, te = train_test_split(df.index, test_size=0.2, random_state=42)
    s_row = fit_and_score(model_fn, X.loc[tr], y.loc[tr], X.loc[te], y.loc[te])

    # 口径二:按设备(主口径,回答"对新设备准不准")
    tr, te = next(GroupShuffleSplit(n_splits=1, test_size=0.2, random_state=42)
                  .split(X, y, groups=g))
    s_grp = fit_and_score(model_fn, X.iloc[tr], y.iloc[tr], X.iloc[te], y.iloc[te])

    # 口径三:按设备 CV(最稳的口径)
    s_cv = cross_val_score(model_fn(), X, y, groups=g, cv=GroupKFold(5), scoring="r2")

    return {"按行随机": s_row, "按设备": s_grp,
            "按设备CV": f"{s_cv.mean():.5f} ± {s_cv.std():.5f}",
            "泄漏量": s_row - s_grp}
★ 关键纪律:报告里三个数字必须一起出现。
只报"按设备"    →  评审人无法判断你有没有做这个检查
只报"按行随机"  →  数字是错的
三个一起报      →  泄漏量自己就暴露了,不需要任何人再质疑
★ 这是第 02 章"给数字加限定词"的第三次实战(第一次是第 03 章的外推,第二次是第 09 章的划分)。
② 一个可以直接用在评审会上的句式
"这个模型在按设备划分的口径下 R² = 0.96503(±0.01147,5 折)。 按行随机的口径会给出 0.98764,但我们不用它 —— 因为上线场景是『对一支新设备做预测』,按行随机的口径下模型见过全部 60 支设备。"
这四句话里包含了:主口径、稳定性、对照口径、以及"为什么不用对照口径"。**
把这段话变成模板,你团队里的"离线好、上线崩"会少一大半。
③ 把泄漏检查放进 CI
# tests/test_no_group_leak.py
def test_split_has_no_group_overlap():
    df = load_features()
    tr, te = make_split(df)
    assert not (set(df.loc[tr, "cell_id"]) & set(df.loc[te, "cell_id"]))

def test_leakage_gap_is_small():
    res = full_eval(...)
    assert res["泄漏量"] < 0.02, (
        f"按行随机与按设备的分数差 {res['泄漏量']:.5f},"
        f"说明数据管道里出现了新的泄漏源")
★ 第二个测试是这一章最值钱的产物:
它不检查"某个具体错误",而是检查"泄漏量有没有变大"
     ↓
所以它能抓到你【还没想到】的泄漏源
     ↓
你不需要先知道"是什么泄漏了",就能被预警
④ 最后一件事:把这一章讲给团队里的人听
为什么值得做:
一个人的检查习惯  →  只能保护他自己写的代码
一个团队的检查习惯 →  保护所有实验的数字
     ↓
而"不许报只跑一次按行随机的分数"这条规矩,
比任何模型调参技巧都更能提升项目的可靠性
★ 所以这一章真正的交付物不是那三种检测方法,而是这句话:
"在我们这里,一个好分数首先要通过一件事: 它是在『上线时会遇到的那种没见过的数据』上算出来的。"
⑤ 下一章要解决的问题
你现在有了一个可信的测试集。但一个问题还在:
0.96503 是【一次】划分给出的数字
     ↓
如果换一次划分,它可能是 0.94377(第 09 章批次实验里的数)
     ↓
那到底该报哪一个?
★ 下一章就用交叉验证回答这个问题 —— 并且会告诉你:CV 本身也可能泄漏(第 12 章收尾)。