第 20 章 · 特征重要性:谁在替模型做决定(含三个陷阱)
这一章要解决什么:模型跑出 0.96503 之后,所有人都会问同一个问题 —— "是哪些特征在起作用?" 这一章给你两把尺子(内置重要性、置换重要性), 然后亲手把这两把尺子的三个陷阱都验证一遍。
最容易踩的坑:
- 把"重要性高"当成"因果关系"(相关是对称的,因果不是);
- 看到两个相关的特征重要性"一个 0.93、一个 0.01"就以为后者没用 (它们可能只是被随机分掉了);
- 用训练集上算出来的重要性去做决策(过拟合的树会带偏它)。
本章你需要完成的代码:demos/ch20-feature-importance.py
20.1 两把尺子:内置重要性 vs 置换重要性
先分清这两个东西,不然后面全是糊的:
| 内置重要性 | 置换重要性 | |
|---|---|---|
| 代码 | model.feature_importances_ | permutation_importance(...) |
| 怎么算 | 训练时统计"这个特征带来的方差下降",按贡献分摊 | 把这一列随机打乱,看分数掉多少 |
| 在哪算 | 训练集(训练过程的一部分) | 你传给它的任何数据集(通常给测试集) |
| 单位 | 无量纲,加起来永远等于 1 | 分数掉多少(R² 的话就是 R² 的损失) |
| 能不能为负 | 不能 | 能(打乱后反而更好 = 这列在捣乱) |
| 代价 | 零成本(训练时顺手算的) | 贵:每个特征 × 每个重复都要重新预测一遍 |
★ 一句话记住两者的区别:
内置重要性问的是"模型训练时用了谁"; 置换重要性问的是"拿掉谁会让模型变差"。
这一章的核心论点:
内置重要性 = 免费、好用、但会在三个地方骗你
置换重要性 = 贵一点、但能挡住其中两个陷阱
两个都不能告诉你"往哪边影响"
20.2 内置重要性:coulombic_eff 一家独大
真实输出(随机森林 200 棵,random_state=42,按设备划分):
  coulombic_eff                0.9263  ████████████████████████████████████████████████████████
  cycle                        0.0261  ██
  mean_temp_rise_c             0.0155  █
  cap_fade_rate_ah_per_100     0.0120  █
  mean_charge_voltage_v        0.0077
  temp_std_c                   0.0068
  resistance_mohm              0.0056
  合计 = 1.0000(归一化过,所以永远等于 1)
  最高 / 次高 = 35.5 倍 —— `coulombic_eff` 一家独大
★ 三个必须看懂的地方:
① "合计 = 1"是定义,不是发现
sklearn 把每个特征的贡献归一化了
   ↓
所以你永远看不到"这个特征贡献了 0.3 个 R²"这种说法
   ↓
【内置重要性只能横向比较,不能跨模型比较】
(换了特征集,分母就变了,数值全都会变)
② 一家独大本身要验证:是信号,还是森林的错觉?
做一个对照实验:把标签打乱再训练,模型就没东西可学了。
真实输出:
  一个必要的对照实验:把标签打乱再训练(模型没东西可学)
  打乱标签后:训练 R² = 0.85429  测试 R² = -0.00820
  重要性变成:max 0.1635 / min 0.0778 / 平均 0.1429(= 1/7 = 0.1429)
  → 没有信号时,重要性会平均分摊到每个特征上。
     所以「0.9263」这种一家独大,是真的有信号,不是森林的错觉。
★ 这个对照实验为什么值得做:
你看到 0.9263,第一个反应应该是:"这个数有多大意义?"
   ↓
打乱标签后 → 重要性退化成"平均分摊"(≈ 1/7 = 0.1429)
   ↓
说明 0.9263 是【真的】信号,不是算法的偏好
★ 顺便看另外两个数:
训练 R² = 0.85429(打乱标签之后!)
   ↓
森林在完全随机的标签上也能"学到"训练集
   ↓
这是"训练分不代表任何东西"的最极端例子
(第 17 章的 0.99838 也是同一类数字,只是没那么极端)

测试 R² = -0.00820
   ↓
负的 R² = 比"直接猜均值"还差
   ↓
这才是"模型没学到任何东西"的正确读数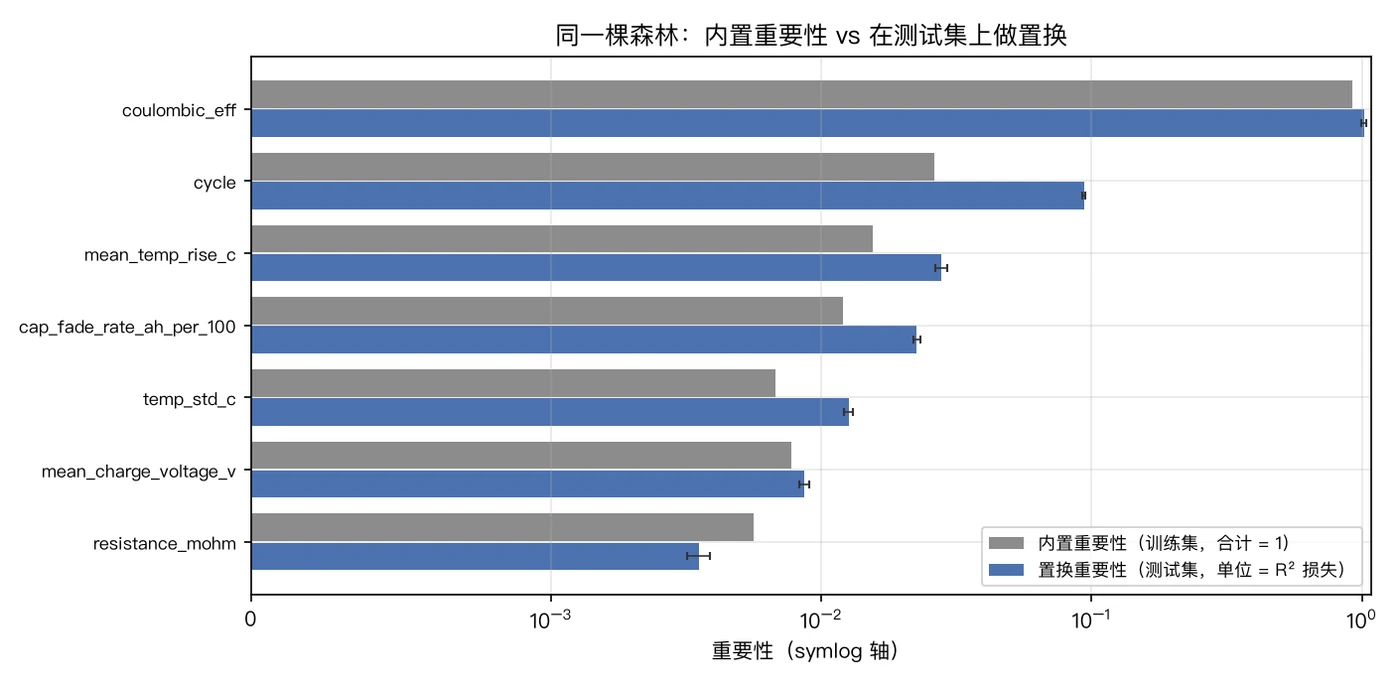
20.3 ★ 陷阱一:重要性不是因果
这是三个陷阱里最容易犯、后果最严重的一个。
20.3.1 最硬的证据:相关是"对称"的
真实输出:
  (a) 先看一个最硬的证据:相关是【对称】的,因果不是
    R²(coulombic_eff → soh) = 0.937603
    R²(soh → coulombic_eff) = 0.937603   ← 完全相等(= r² = 0.937603)
    → 让模型从 A 预测 B,和从 B 预测 A,得到的「重要性」是同一个数。
      所以重要性本身【不包含方向信息】,更不包含因果信息。
★ 这两行相等,直接判了"因果推断"的死刑:
如果 A 导致 B,那么"从 A 预测 B"应该比"从 B 预测 A"强得多
   ↓
实测:两个方向一模一样(0.937603)
   ↓
说明这个数字里【没有方向】,更没有因果为什么:单特征的 R² 就等于相关系数的平方(r² = 0.9683² = 0.937603)。 相关系数是对称的,所以 R² 也是对称的。
★ 那"重要性"到底回答了什么:
✅ "在【这份数据里】,模型能靠这个特征把 soh 预测到这个程度"
❌ "提高这个特征就能提高 soh"
❌ "这个特征导致了 soh 的变化"
20.3.2 一个混淆变量的合成实验
真实输出(500 个样本的假数据:气温 → 冰淇淋销量、气温 → 溺水人数):
  (b) 一个混淆变量的合成实验(500 个样本的假数据)
    corr(冰淇淋, 溺水) = 0.8757   ← 很高
    只看冰淇淋:coef = 0.2681   R² = 0.7669
    同时看气温:coef = 0.0066   R² = 0.7817
    → 冰淇淋的「重要性」很高,但把气温放进来之后,它对溺水的贡献几乎归零。
      这不代表冰淇淋和溺水无关 —— 它代表「冰淇淋没有【独立】的信息」。
★ 这三个数字讲了一个完整的故事:
| 模型 | 冰淇淋的系数 | R² |
|---|---|---|
| 只看冰淇淋 | 0.2681 | 0.7669 |
| 同时看气温 | 0.0066(缩小到 1/40) | 0.7817(几乎没变) |
① 只看冰淇淋:它"很重要"(coef 0.2681,R² 0.7669)
② 加上气温:冰淇淋的系数掉到 0.0066,而 R² 只从 0.7669 涨到 0.7817
   ↓
说明 R² 那 0.7669 里的绝大部分功劳,其实是【气温】的
   冰淇淋只是一个"温度的替代品"
★ 这张表的现实版(真实项目里到处是):
"客服工单数" 与 "用户流失" 相关 —— 因为不满意才会打电话
"广告曝光量" 与 "购买量"   相关 —— 因为想买的人会去搜
"某个传感器读数" 与 "故障" 相关 —— 因为它俩都被同一个物理量驱动
★ 纪律:
看到"某个特征重要性很高"时,追问一句: "它有没有可能只是另一个变量的替身?"
验证方法:把可疑的"那个变量"也放进模型,看它的重要性掉不掉。
20.3.3 回到这张表:重要性高 ≠ 你能改得动
真实输出:
  (c) 回到这张表:`cycle` 的重要性只有 0.0261,但它是唯一能被干预的量
    重要性回答的是「模型靠什么做决定」,不是「我该去改哪个变量」。
    这两件事经常不一样 —— 报告里把它们混起来讲,是会出事的。
★ 这句话在真实项目里的分量:
重要性排名:          可干预性排名:
1. coulombic_eff      (不可直接改 —— 它是设备状态的结果)
2. cycle              (可以改 —— 但它是时间,不是"参数")
3. mean_temp_rise_c   (可以改 —— 温控策略)
...

如果一份报告只写"coulombic_eff 最重要",
读者会去尝试"优化 coulombic_eff"—— 而这通常无从下手。
★ 一个正确的写法:
❌ "coulombic_eff 是最重要的特征(0.9263),所以应重点监控它。"
   ↑ 前半个是模型结论,后半个是业务建议,中间缺了因果论证

✅ "在这份数据上,模型主要依赖 coulombic_eff 做预测(0.9263)。
    它与健康度的相关是 +0.9683,方向是"越大越健康"。
    但要判断"改进它能不能改善健康度",需要控制实验,本数据做不到。"
20.4 ★ 陷阱二:相关特征会"分摊"重要性
这是三个陷阱里最容易被忽略的一个,因为它连"看起来错"都不像。
做法:把 coulombic_eff 原样复制一列(叫 copy),再训练同一个森林。
真实输出:
  数据版本                               coulombic_eff      copy        两者合计
  --------------------------------------------------------------------
  原样复制(相关 = 1.000000)                       0.4247    0.5016      0.9263   (r=1.000000)
  复制 + 1e-5 噪声                              0.0139    0.9153      0.9292   (r=0.999956)
  复制 + 1e-4 噪声                              0.9258    0.0019      0.9277   (r=0.995648)
  复制 + 1e-3 噪声                              0.9263    0.0014      0.9276   (r=0.728428)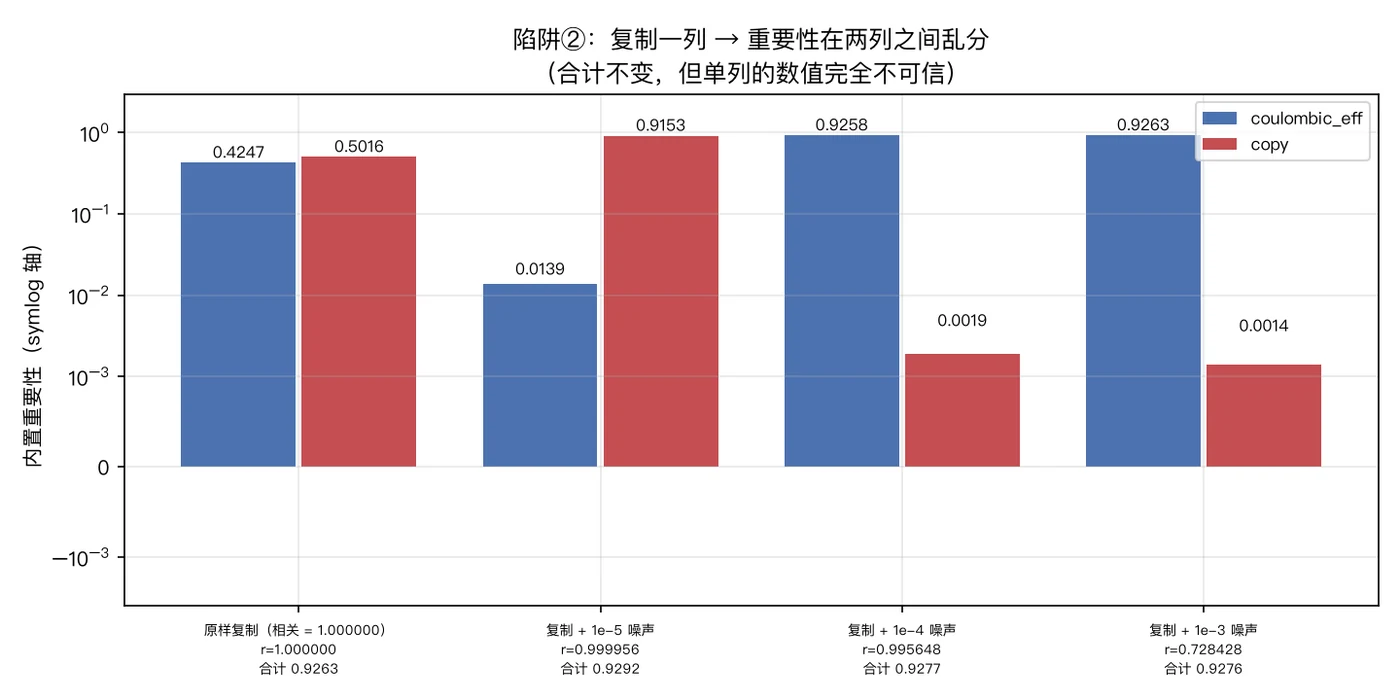
★ 这张表里有三件事在爆炸:
① 原样复制时,0.9263 被对半劈开
原来:coulombic_eff 0.9263
复制后:coulombic_eff 0.4247 + copy 0.5016 = 0.9263
   ↓
【合计完全没变】,但每一列的数字都掉了一半
   ↓
如果你只看单列,会得出"coulombic_eff 的重要性从 0.93 掉到 0.42"的错误结论
② 加一点点噪声,胜负立刻就分出来了 —— 而且是随机的
+1e-5 噪声(相关仍然 0.999956!):0.0139 / 0.9153
   ↓
人眼根本看不出这两列有任何区别,但重要性分配从"4:5"变成了"1:66"
   ↓
【谁赢是随机的】—— 取决于这点噪声、森林的种子
③ 噪声加到 1e-3,相关掉到 0.73
coulombic_eff 自己的取值只在 0.9937 ~ 0.9983(约 0.001 的跨度)
   ↓
所以 1e-3 的噪声已经和信号一样大了
   ↓
r 从 0.999956 掉到 0.728428
   ↓
这一行提醒你:评估"两列有多像"时,要拿噪声和【特征自己的标准差】比
★ 换种子验证"谁赢是随机的":
真实输出:
  同一个数据版本,只换森林的随机种子:
    seed=0   coulombic_eff 0.0090   copy 0.9200
    seed=1   coulombic_eff 0.0099   copy 0.9184
    seed=2   coulombic_eff 0.0051   copy 0.9238
    seed=42  coulombic_eff 0.0237   copy 0.9048
★ 四行看下来,结论只有一个:
在这份"几乎完全相同的两列"上,
"谁是重要的"这件事,在 0.005 ~ 0.024 之间乱跳。
   ↓
不要相信高相关特征【之间】的重要性排序
   ↓
只相信它们的【合计】
★ 可操作的三条做法:
| 做法 | 适用 |
|---|---|
| 把高相关的一组合并成一个"特征族",报合计 | 通用 |
| 只保留其中一个(哪个都行,因为信息冗余) | 想简化模型 |
| 用置换重要性 + 多次重复,看两列的误差棒是否重叠 | 想严谨一点 |
★ 一个必须提醒的例外:
"删掉一个没问题"只对【预测】成立
   ↓
如果你要做【解释】("到底是哪一个在起作用"),
高相关的两列放在一起就是无解的 ——
需要的是控制实验或者因果推断,不是特征重要性
20.5 ★ 陷阱三:内置重要性是在训练集上算的
这一节的实验设计很直接:
只用 800 行训练一棵【无限深】树(重度过拟合)
   ↓
再额外塞一列纯噪声 noise_col(均匀随机数,和 soh 毫无关系)
   ↓
然后分别用【训练集】和【测试集】做置换重要性真实输出:
  演示:只用 800 行训练一棵无限深树(重度过拟合),
        再额外塞一列纯噪声 noise_col,看重要性会不会被骗。
  这棵树:训练 R² = 1.00000   测试 R² = 0.91394   ← 典型的高方差

  特征                                内置(训练)      置换(训练)      置换(测试)
  ------------------------------------------------------------------
  coulombic_eff                     0.8697     +1.1938     +1.1430
  cycle                             0.0817     +0.1379     +0.1139
  mean_temp_rise_c                  0.0167     +0.0623     +0.0276
  cap_fade_rate_ah_per_100          0.0120     +0.0363     +0.0193
  mean_charge_voltage_v             0.0071     +0.0309     +0.0070
  temp_std_c                        0.0043     +0.0207     +0.0163
  resistance_mohm                   0.0055     +0.0171     -0.0009  ← 符号翻转!
  noise_col                         0.0030     +0.0089     -0.0010  ← 符号翻转!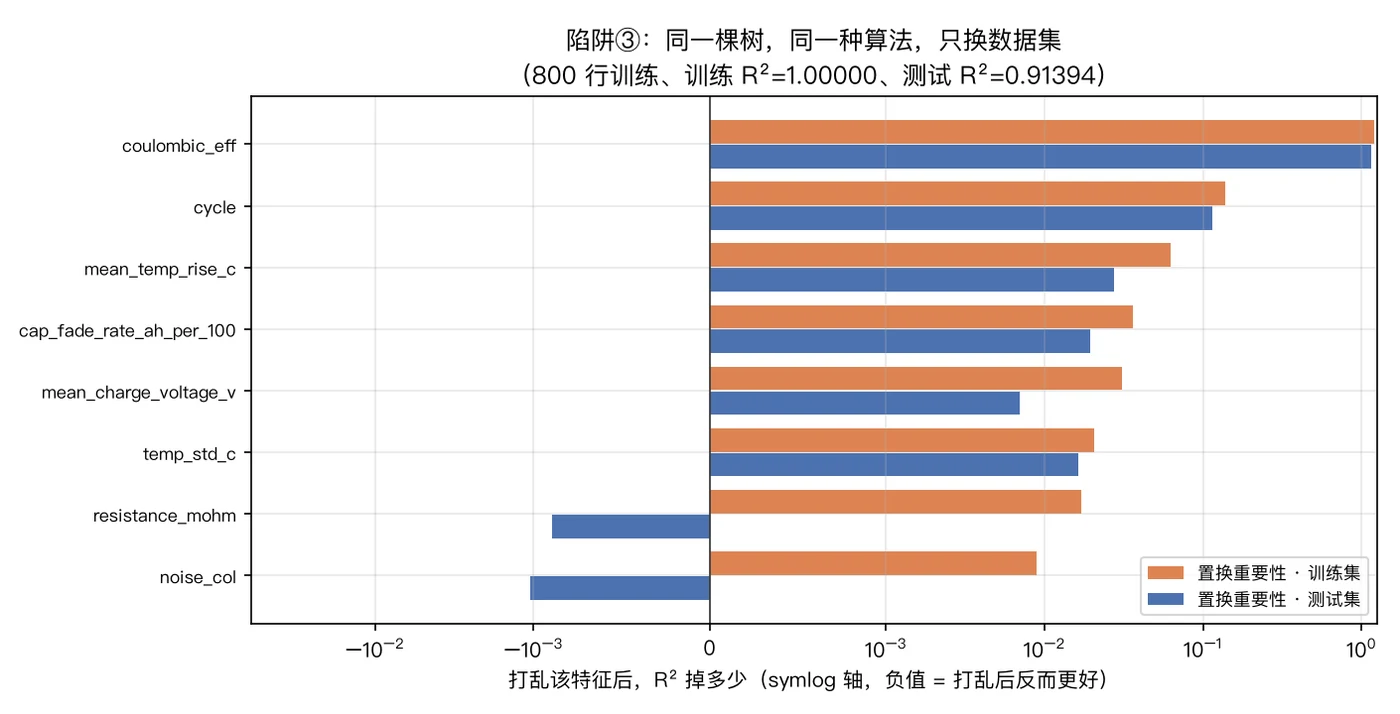
★ 这张表的杀招是最后两行:
noise_col(纯噪声):
   内置重要性 0.0030(看着很小,但它是正数)
   置换(训练集) +0.0089  ← 在训练集上"打乱它,R² 掉 0.0089"!看起来有点用
   置换(测试集) -0.0010  ← 在测试集上,打乱它反而更好
   ↓
【符号翻转】

resistance_mohm(真实特征):
   置换(训练集) +0.0171
   置换(测试集) -0.0009
   ↓
在这棵树眼里,它和噪声列是同一类东西
★ 为什么训练集上会这样:
这棵树的训练 R² = 1.00000 —— 它【把训练集背下来了】
   ↓
既然背下来了,那"打乱任何一列"都会让训练分掉一点
   (它记住的东西被破坏了)
   ↓
所以训练集上的置换重要性,衡量的是
"这个模型有多依赖这一列来记住训练集"
   ↓
而不是"这一列对【没见过的新数据】有没有用"
★ 注意"符号翻转"这个信号有多好用:
置换重要性为负 = 打乱这一列之后,模型反而更准
   ↓
含义:这一列在给模型添乱
   ↓
看到负数,先别怀疑代码,先怀疑这列是不是噪声/泄漏/两列重复
★ 顺便看 mean_charge_voltage_v 那一行:
置换(训练集) +0.0309 → 置换(测试集) +0.0070
   ↓
缩水到 1/4.4,但仍然是正的
   ↓
意思是:它有点用,但训练集高估了它的作用
这就是"虚高"的样子 —— 不是翻转,而是放大了。
20.6 处方:在测试集上做置换重要性
结论很简单:
要判断"这个特征对这个模型有没有用",就把打乱这件事, 发生在【模型没见过的数据】上。
真实输出(全量森林 200 棵;训练集侧的置换为了跑得快只用 4,000 行子样本):
                            内置(训练集)  置换(训练集4000行)  置换(测试集)  置换(测试集)标准差
  coulombic_eff             0.92630       1.07970  1.01702     0.01768
  cycle                     0.02611       0.11302  0.09380     0.00119
  mean_temp_rise_c          0.01546       0.04230  0.02785     0.00143
  cap_fade_rate_ah_per_100  0.01201       0.02553  0.02258     0.00067
  temp_std_c                0.00675       0.02122  0.01263     0.00052
  mean_charge_voltage_v     0.00774       0.01718  0.00865     0.00038
  resistance_mohm           0.00563       0.01132  0.00353     0.00035

  把 `coulombic_eff` 打乱,测试集 R² 掉 1.0170 → 原来的 R² 是 0.96503,
     打乱后是 -0.05199(模型基本瘫掉)
★ 三件事值得单独说:
① 单位变了,读法也变了
内置重要性:0.9263(无量纲,合计 = 1)
置换重要性:1.01702(单位 = R² 的损失)
   ↓
"把 coulombic_eff 打乱,测试集 R² 从 0.96503 掉到 -0.05199"
   ↓
这是一句【能被非技术同事听懂】的话
② "打乱后 R² 变成负数"这句话非常有力
0.96503 → -0.05199
   ↓
负 R² = 比"直接猜均值"还差
   ↓
说明这个模型【整个就架在 coulombic_eff 这一列上】
③ 用"均值 vs 标准差"判断"有没有用"
coulombic_eff:1.01702 ± 0.01768   → 均值是标准差的 58 倍 → 铁定有用
cycle:        0.09380 ± 0.00119   → 均值是标准差的 79 倍 → 有用
mean_temp:    0.02785 ± 0.00143   → 19 倍 → 有用
resistance:   0.00353 ± 0.00035   → 10 倍 → 弱,但还没到噪声水平
★ 判据(可操作):
均值 / 标准差 > 10  → 这个特征确实在起作用
均值 / 标准差 < 2   → 这个数字基本是噪声,别拿它做决策
均值 < 0            → 这一列在添乱,去查它
★ 但要注意置换重要性也有它自己的坑:
| 坑 | 表现 | 应对 |
|---|---|---|
| 相关特征仍然会互相"顶替" | A 打乱后 B 顶上,A 的重要性被低估 | 高相关的一组一起看合计 |
| 打乱会产生"不可能的数据" | 例如打乱后出现"电压 0.9V 且 cycle 1400"这种组合 | 对强相关特征要小心 |
| 不稳定 | 每次打乱的随机性会带来波动 | 多重复几次,看标准差 |
| 贵 | 每个特征 × 每个重复都要重跑预测 | 特征多时用子样本,或换 n_repeats |
20.7 重要性只告诉你"有没有用",不告诉你"往哪边"
最后一件事,也是最容易在汇报时被问住的:
真实输出(把一列从最小扫到最大,其他列固定在中位数):
  coulombic_eff(重要性 0.9263):
    取值 [0.9937 0.9951 0.996  0.9969 0.9983]
    预测 [0.8265 0.88   0.9307 0.9358 0.9381]   ↑ 越大越健康
  cycle(重要性 0.0261):
    取值 [  50.  318.  588.  870. 1440.]
    预测 [0.9386 0.9385 0.9307 0.8968 0.8947]   ↓ 越大越差
  resistance_mohm(重要性 0.0056):
    取值 [33.9295 44.613  51.9273 61.312  87.7078]
    预测 [0.9185 0.9182 0.9307 0.924  0.924 ]   → 基本没变化(它本来就不重要)
★ 三个读法:
① coulombic_eff:从 0.9937 涨到 0.9983(涨了 0.0046),预测从 0.8265 涨到 0.9381
   方向明确:↑ 越大越健康

② cycle:从 50 涨到 1440,预测从 0.9386 掉到 0.8947
   方向明确:↓ 越大越差
   ★ 重要性只有 coulombic_eff 的 1/35,但它的方向【完全不同】!

③ resistance_mohm:扫一遍基本是平的(0.9185 → 0.924,还上下跳)
   重要性 0.0056,本来就该是平的 —— 平是"不重要"的另一种写法

   ★ 注意它在中间的 0.9307 是"其他列取中位数"那一点的基准值
      (分位点扫描时"中位数"这一列正好是基准),不是趋势
★ 这张表回答了汇报里最常见的一个追问:
领导问:"你说 coulombic_eff 重要,那它是越大越好还是越小越好?"
   ↓
一张重要性条形图:答不出来(只有大小,没有正负)
这张扫描表:答得出来(而且三个特征的方向各不相同)
★ 一个便宜的通用做法:
med = X_tr.median()
for f in FEATS:
    grid = pd.DataFrame([med] * 5)
    grid[f] = np.quantile(X_tr[f], [0, .25, .5, .75, 1.0])
    pred = model.predict(grid)
    print(f, np.round(pred, 4))          # 看这 5 个数的走向
★ 但要说清楚它【不是】什么:
它展示的是"模型在数据里学到的关系",
不是"干预这个变量会带来什么后果"。
   ↓
要回答后者,需要控制实验(把别的东西固定住去改它)
   ↓
这两件事之间的鸿沟,就是"预测模型"和"因果模型"的鸿沟
20.8 常见坑
① 把重要性当因果
   → R²(A→B) = R²(B→A) = 0.937603,这个数字里没有方向

② 忽略混淆变量
   → 冰淇淋 vs 溺水的系数从 0.2681 掉到 0.0066(加上气温后)

③ 相信高相关特征之间的重要性排序
   → 复制一列后重要性从 0.9263 变成 0.4247 / 0.5016;换个种子又变

④ 用训练集上的重要性做决策
   → 800 行过拟合树上,纯噪声列换到 +0.0089,测试集上是 -0.0010

⑤ 只看均值、不看标准差
   → 置换重要性的标准差和均值一个量级时,那个数字没有意义

⑥ 把重要性当方向
   → coulombic_eff(↑)和 cycle(↓)重要性差 35 倍,方向相反

⑦ 跨模型比较内置重要性
   → 它归一化到"合计 = 1",换特征集就不能比了
★ 这七个坑里,④ 是最隐蔽的:
它不报错、结果看起来"正常"、还很有说服力("这个特征贡献最大")
   ↓
但它来自一个"已经把训练集背下来"的模型
   ↓
所以它描述的是【模型的记忆】,不是【数据的规律】
★ 而 ① 是后果最严重的:
一个错误的因果结论,可能让整个团队去优化一个"根本不重要"的指标
   ↓
而它是在一张正确的技术图表上得出来的
   ↓
技术正确 ≠ 结论正确
20.9 完整示例与输出
cd code
python demos/ch20-feature-importance.py真实输出(节选):
==============================================================================
第 20 章 · 特征重要性:谁在替模型做决定(含三个陷阱)
==============================================================================

=== ① 工具本身:训练集上的「方差下降」,加起来刚好等于 1 ===
  coulombic_eff                0.9263  ████…
  cycle                        0.0261  ██
  最高 / 次高 = 35.5 倍 —— `coulombic_eff` 一家独大
  打乱标签后:训练 R² = 0.85429  测试 R² = -0.00820
  重要性变成:max 0.1635 / min 0.0778 / 平均 0.1429(= 1/7 = 0.1429)

=== ② 陷阱一:重要性不是因果 ===
    R²(coulombic_eff → soh) = 0.937603
    R²(soh → coulombic_eff) = 0.937603   ← 完全相等
    只看冰淇淋:coef = 0.2681   R² = 0.7669
    同时看气温:coef = 0.0066   R² = 0.7817

=== ③ 陷阱二:相关特征会「分摊」重要性 ===
  原样复制(相关 = 1.000000)                       0.4247    0.5016      0.9263

=== ④ 陷阱三:内置重要性是在训练集上算的 ===
  noise_col                         0.0030     +0.0089     -0.0010  ← 符号翻转!

=== ⑤ 更稳的做法:在【测试集】上做置换重要性(全量森林) ===
  coulombic_eff             0.92630       1.07970  1.01702     0.01768

=== ⑥ 重要性只告诉你「有没有用」,不告诉你「往哪边」 ===
  coulombic_eff(重要性 0.9263):预测 [0.8265 0.88 0.9307 0.9358 0.9381]   ↑ 越大越健康
  cycle(重要性 0.0261):预测 [0.9386 0.9385 0.9307 0.8968 0.8947]   ↓ 越大越差
本章练习
练习 1:内置重要性 + 打乱标签的对照
- 训练随机森林(200 棵),打印 7 列的内置重要性(降序)和"最高 / 次高"的倍数;
- 把
y_tr随机打乱后训练同一个森林,打印它重要性的 max / min / 平均; - 打印打乱标签后的测试 R²;
- 回答:
coulombic_eff的 0.9263 可信吗?
参考答案
import numpy as np
import pandas as pd
from sklearn.ensemble import RandomForestRegressor
from sklearn.metrics import r2_score
from sklearn.model_selection import GroupShuffleSplit

FEATS = ["cycle", "mean_charge_voltage_v", "mean_temp_rise_c", "resistance_mohm",
         "coulombic_eff", "cap_fade_rate_ah_per_100", "temp_std_c"]

df = pd.read_csv("data/battery/soh_features.csv")
X, y, groups = df[FEATS], df["soh"], df["cell_id"]
tr, te = next(GroupShuffleSplit(n_splits=1, test_size=0.2,
                                random_state=42).split(X, y, groups=groups))
X_tr, X_te, y_tr, y_te = X.iloc[tr], X.iloc[te], y.iloc[tr], y.iloc[te]

rf = RandomForestRegressor(n_estimators=200, random_state=42, n_jobs=-1).fit(X_tr, y_tr)
imp = pd.Series(rf.feature_importances_, index=FEATS).sort_values(ascending=False)
for k, v in imp.items():
    print(f"  {k:<28s} {v:.4f}")
print(f"  最高 / 次高 = {imp.iloc[0] / imp.iloc[1]:.1f}")

rng = np.random.default_rng(42)
y_shuf = pd.Series(rng.permutation(y_tr.to_numpy()), index=y_tr.index)
rf_s = RandomForestRegressor(n_estimators=200, random_state=42, n_jobs=-1).fit(X_tr, y_shuf)
s = pd.Series(rf_s.feature_importances_, index=FEATS)
print(f"  打乱标签后:最高 {s.max():.4f} / 最低 {s.min():.4f} / 平均 {s.mean():.4f}")
print(f" 打乱标签后测试 R² = {r2_score(y_te, rf_s.predict(X_te)):.5f}")期望输出:
  coulombic_eff                0.9263
  cycle                        0.0261
  mean_temp_rise_c             0.0155
  cap_fade_rate_ah_per_100     0.0120
  mean_charge_voltage_v        0.0077
  temp_std_c                   0.0068
  resistance_mohm              0.0056
  最高 / 次高 = 35.5
  打乱标签后:最高 0.1635 / 最低 0.0778 / 平均 0.1429
  打乱标签后测试 R² = -0.00820(随机猜测的水平)
第 4 问的回答:
可信 —— 前提是"可信"指的是"它在预测上有用",不是"它是原因"。
证据是那个对照实验:标签完全打乱之后,重要性退化成平均分摊 (max 0.1635 / min 0.0778,均值 0.1429 = 1/7)。 这说明 0.9263 不是森林的偏好,而是数据里真有的关系。
但**"可信"到此为止**: 它不能推出"coulombic_eff 越高越好"(方向另外扫,见 20.7), 也不能推出"改进它就能提高健康度"(那是因果问题,见 20.3)。
★ 那个 -0.00820 要单独说一句
打乱标签后的测试 R² = -0.00820
   ↓
负 R² = 比"直接猜训练集均值"还差
   ↓
说明模型什么也没学到 —— 这是"没有信号"的正确读数
★ 注意训练分 0.85429 和测试分 -0.00820 的反差
同一份(随机标签的)数据上:
   训练 R² = 0.85429   ← 森林"学"得很像样
   测试 R² = -0.00820  ← 完全没用
   ↓
看到"训练分"时永远要问一句:测试分是多少?
练习 2:复制一列会怎样
- 原始 7 列:打印
coulombic_eff的重要性与测试 R²; - 加一列完全相同的
coulombic_eff_copy再训练:打印两列的重要性及合计、测试 R²; - 删掉原列、只留 copy:打印测试 R²(并和原始比);
- 对照:整列扔掉、不留副本:打印测试 R²;
- 回答:第 3 步的结果说明什么?第 4 步又说明什么?
参考答案
import pandas as pd
from sklearn.ensemble import RandomForestRegressor
from sklearn.metrics import r2_score
from sklearn.model_selection import GroupShuffleSplit

FEATS = ["cycle", "mean_charge_voltage_v", "mean_temp_rise_c", "resistance_mohm",
         "coulombic_eff", "cap_fade_rate_ah_per_100", "temp_std_c"]

df = pd.read_csv("data/battery/soh_features.csv")
X, y, groups = df[FEATS], df["soh"], df["cell_id"]
tr, te = next(GroupShuffleSplit(n_splits=1, test_size=0.2,
                                random_state=42).split(X, y, groups=groups))
X_tr, X_te, y_tr, y_te = X.iloc[tr], X.iloc[te], y.iloc[tr], y.iloc[te]


def fit(Xa, ya):
    return RandomForestRegressor(n_estimators=200, random_state=42,
                                 n_jobs=-1).fit(Xa, ya)


base = fit(X_tr, y_tr)
base_te = r2_score(y_te, base.predict(X_te))
print(f"① 原始 7 列:coulombic_eff "
      f"{base.feature_importances_[FEATS.index('coulombic_eff')]:.4f},测试 R² {base_te:.5f}")

X2 = X_tr.copy(); X2["coulombic_eff_copy"] = X_tr["coulombic_eff"]
X2_te = X_te.copy(); X2_te["coulombic_eff_copy"] = X_te["coulombic_eff"]
m2 = fit(X2, y_tr)
s2 = pd.Series(m2.feature_importances_, index=X2.columns)
print(f"② 复制成 8 列:{s2['coulombic_eff']:.4f} / {s2['coulombic_eff_copy']:.4f}"
      f"(合计 {s2['coulombic_eff'] + s2['coulombic_eff_copy']:.4f}),"
      f"测试 R² {r2_score(y_te, m2.predict(X2_te)):.5f}")

X3 = X_tr.drop(columns=["coulombic_eff"]).copy()
X3["coulombic_eff_copy"] = X_tr["coulombic_eff"]
X3_te = X_te.drop(columns=["coulombic_eff"]).copy()
X3_te["coulombic_eff_copy"] = X_te["coulombic_eff"]
m3 = fit(X3, y_tr)
r3 = r2_score(y_te, m3.predict(X3_te))
print(f"③ 只留 copy:测试 R² {r3:.5f}(与原始相差 {abs(base_te - r3):.5f})")

m4 = fit(X_tr.drop(columns=["coulombic_eff"]), y_tr)
r4 = r2_score(y_te, m4.predict(X_te.drop(columns=["coulombic_eff"])))
print(f"④ 整列扔掉:测试 R² {r4:.5f}(比原始低 {base_te - r4:.5f})")期望输出:
① 原始 7 列:coulombic_eff 0.9263,测试 R² 0.96503
② 复制成 8 列:0.4247 / 0.5016(合计 0.9263),测试 R² 0.96490
③ 只留 copy:测试 R² 0.96498(与原始相差 0.00004)
④ 整列扔掉:测试 R² 0.95095(比原始低 0.01408)
第 5 问的回答:
③ 说明:删掉"原列"、保留"副本",模型性能几乎没变(差 0.00004)。
原列和副本的信息完全一样
   ↓
所以"删掉哪一个"对预测毫无影响
   ↓
但两列各自的重要性会乱掉(②里是 0.4247 / 0.5016)
   ↓
【预测不受影响,解释被毁掉了】
④ 说明:如果整列扔掉(不留副本),测试 R² 掉 0.01408。
0.96503 → 0.95095
   ↓
这就是 coulombic_eff 对预测的【真实贡献】
   ↓
注意它是 0.01408,而不是内置重要性暗示的"0.9263 那么重要"
   ↓
两个数字的差别在于:
   内置重要性 0.9263 是"归一化后的占比"(无量纲)
   0.01408 是"R² 掉多少"(有量纲)
   ↓
【汇报时用后者】—— 它能被直接理解
★ 一个"用 R² 变化量说话"的模板:
❌ "coulombic_eff 的重要性是 0.9263,是最重要的特征。"
✅ "去掉 coulombic_eff 之后,测试 R² 从 0.96503 掉到 0.95095(-0.01408);
去掉其余任何一个特征,变化都小于 0.003。"第二种写法有三个好处:
① 单位明确(R² 的变化量)
② 有对比基准("其余任何一个 < 0.003")
③ 可以被复现(换个模型重跑一遍就能验证)
练习 3:置换重要性,训练集 vs 测试集
对同一个森林(200 棵)分别做两次置换重要性:
- 一次传
(X_tr, y_tr),一次传(X_te, y_te),n_repeats=5; - 打印两列结果,并算出"虚高倍数"(训练集 / 测试集),按测试集降序排;
- 回答:哪一列"虚高"得最厉害?这说明什么?
参考答案
import pandas as pd
from sklearn.ensemble import RandomForestRegressor
from sklearn.inspection import permutation_importance
from sklearn.model_selection import GroupShuffleSplit

FEATS = ["cycle", "mean_charge_voltage_v", "mean_temp_rise_c", "resistance_mohm",
         "coulombic_eff", "cap_fade_rate_ah_per_100", "temp_std_c"]

df = pd.read_csv("data/battery/soh_features.csv")
X, y, groups = df[FEATS], df["soh"], df["cell_id"]
tr, te = next(GroupShuffleSplit(n_splits=1, test_size=0.2,
                                random_state=42).split(X, y, groups=groups))
X_tr, X_te, y_tr, y_te = X.iloc[tr], X.iloc[te], y.iloc[tr], y.iloc[te]

rf = RandomForestRegressor(n_estimators=200, random_state=42, n_jobs=-1).fit(X_tr, y_tr)
p_tr = permutation_importance(rf, X_tr, y_tr, n_repeats=5, random_state=42,
                              n_jobs=-1).importances_mean
p_te = permutation_importance(rf, X_te, y_te, n_repeats=5, random_state=42,
                              n_jobs=-1).importances_mean
tbl = pd.DataFrame({"训练集置换": p_tr, "测试集置换": p_te}, index=FEATS)
tbl["虚高倍数"] = tbl["训练集置换"] / tbl["测试集置换"]
print(tbl.sort_values("测试集置换", ascending=False).round(5).to_string())期望输出:
                              训练集置换    测试集置换     虚高倍数
  coulombic_eff             1.06139  1.01702  1.04363
  cycle                     0.11228  0.09380  1.19696
  mean_temp_rise_c          0.04243  0.02785  1.52355
  cap_fade_rate_ah_per_100  0.02603  0.02258  1.15284
  temp_std_c                0.02194  0.01263  1.73675
  mean_charge_voltage_v     0.01785  0.00865  2.06303
  resistance_mohm           0.01120  0.00353  3.17519
  掉得最厉害的:coulombic_eff(测试集置换 1.0170)
  虚高最多的一列:resistance_mohm(3.18 倍)
第 3 问的回答:
虚高最厉害的是
resistance_mohm:训练集 0.01120,测试集 0.00353,虚高 3.18 倍。这说明它对模型的"表面贡献"大部分来自训练集; 换成没见过的设备,它能提供的帮助只剩三分之一。
★ 注意这个模式和重要性高低的关系:
coulombic_eff(最重要):虚高 1.04 倍 —— 几乎不虚高
resistance_mohm(最不重要):虚高 3.18 倍 —— 虚高最多
   ↓
【越不重要的特征,训练集和测试集的分歧越大】
   ↓
原因:真正重要的特征在哪份数据上都重要(信号强、稳定);
     边缘特征的作用本来就微弱,训练集上的那点贡献里
     有相当一部分是"记住了这批数据"的产物
★ 一个汇报时的组合拳
# ① 排名(谁大谁小)
print(tbl.sort_values("测试集置换", ascending=False).head(3))
# ② 稳定性(这个排名靠不靠得住)
print(tbl["测试集置换"] / tbl["测试集置换"].std())      # 见 demo 的 ⑤ 段
# ③ 真实代价(去掉它 R² 掉多少)
#    就是"测试集置换"那一列
★ 最后一条纪律:
凡是"重要性",一律按【测试集上的置换重要性】来报, 并且带上标准差。 内置重要性只用来做一次快速体检,不用来下结论。
面向工程实践:把特征重要性变成一份"能过评审"的结论
① 一份合格的特征重要性报告长什么样
| 特征 | 测试集置换重要性 (ΔR²) | 标准差 | 方向 | 备注 |
|---|---|---|---|---|
| coulombic_eff | 1.01702 | 0.01768 | ↑ 越大越健康 | 与 cycle 弱相关 (r=?) |
| cycle | 0.09380 | 0.00119 | ↓ 越大越差 | 可干预(排产) |
| mean_temp_rise_c | 0.02785 | 0.00143 | — | 与 temp_std_c 相关,看合计 |
| ... | | | | |四列缺一不可:
数值   → 谁在起作用
标准差 → 这个排名靠不靠得住
方向   → 它是越大越好还是越小越好(20.7)
备注   → 有没有相关的伙伴特征(20.4)
② 三个"汇报时会被问住"的问题,先自己答一遍
| 别人会问 | 你要能回答 |
|---|---|
| "这个重要性是因果关系吗?" | "不是。相关是对称的(r² = 0.937603 双向相等),要因果得做控制实验。" |
| "它和另一个特征高度相关,你怎么知道是它?" | "我不知道,也没法从这张表上知道。我只报它们的合计。" |
| "为什么这里的数字和上次不一样?" | "因为上次是内置重要性(训练集、无量纲),这次是测试集置换(ΔR²)。两个不能混着比。" |
③ 一个"特征重要性 ≠ 行动清单"的真实教训
一份报告的结论:"coulombic_eff 最重要(0.9263),建议重点监控。"
   ↓
三个月后:监控加了一堆传感器,模型分数一点没变
   ↓
原因:coulombic_eff 是【设备状态的结果】,不是可以拧的旋钮
     真正能拧的是温度、充放电策略、排产节奏 ——
     而它们的重要性看起来都只有 0.01 量级
★ 这两件事要说清楚:
① 模型靠什么预测(importance)
② 我能改什么(业务可控变量)
   ↓
两者之间隔着"因果"这道墙
   ↓
报告里把它们分开写,是最基本的诚实
④ 这一章在整个方法论里的位置
第 17~19 章:把分数做稳(Bagging 治方差、提升治偏差)
第 20 章:把"谁在起作用"说清楚(并且说清它不能说什么)
   ↓
到这一步,你已经能回答三个问题了:
   ① 这个分数可信吗?(划分纪律 + 交叉验证)
   ② 模型还有多少过拟合?(训练-测试差距)
   ③ 是哪些特征在起作用、能不能信?(本章)
   ↓
剩下的一件事:分数还能不能往上走(第 21 章的学习曲线)