第 27 章 · ❖ 阶段目标:四路横评与选型报告
本章没有新概念 —— 它把前面 26 章拼成一个可交付的东西: 一条命令 → 指标表 + 两张图 + 一份带结论的选型报告。
本章唯一要学的是"工程组织": 怎么让"图、数字、结论"永远一致,以及结论必须带局限。
本章你需要完成的代码:demos/ch27-stage-target.py
27.1 先看成品
cd code
python demos/ch27-stage-target.py真实输出:
==============================================================================
第 27 章 · 阶段目标:四路横评与选型报告
==============================================================================
数据:data/battery/soh_features.csv
划分:按设备 GroupShuffleSplit,训练 17,244 行 / 48 支,测试 3,995 行 / 12 支
两边设备有交集:False
提升模型:HistGB(替 XGBoost,300棵)

  模型                                MAE     RMSE       R²      训练        单行
  线性回归(+标准化)                    0.00968  0.01217  0.95053   0.01s    0.000ms
  随机森林(200棵)                    0.00790  0.01023  0.96503   7.93s    0.022ms
  HistGB(替 XGBoost,300棵)        0.00787  0.01034  0.96429 187.06s    0.236ms
  高斯过程 GPR(800行,仅cycle)         0.01728  0.02276  0.82693   1.71s    0.090ms

  ⚠️ GPR 只喂 800 行、只用 cycle 一个特征 —— 它的 R² 不参与横向比较。
     它的 ±2σ 覆盖率 = 91.8%(接近理论 95% → 区间可信)

  三个主流模型 R² 极差 = 0.01449
  最优:随机森林(200棵)(R² 0.96503)
  验收区间 0.90~0.98:通过

产物清单:
  ✅ ch27-metrics.csv               0.6 KB
  ✅ ch27-pred-vs-true.png        431.3 KB
  ✅ ch27-gp-band.png             121.8 KB
✅ ch27-report.md 4.3 KB四张产物:
| 文件 | 内容 |
|---|---|
ch27-metrics.csv | 四路的 MAE / RMSE / R² / 训练耗时 / 单行预测 |
ch27-pred-vs-true.png | 预测 vs 真实(四联散点 + 对角参考线) |
ch27-gp-band.png | GPR 置信带(数据区 vs 外推区) |
ch27-report.md | 选型报告(含结论与局限) |
两张关键图:
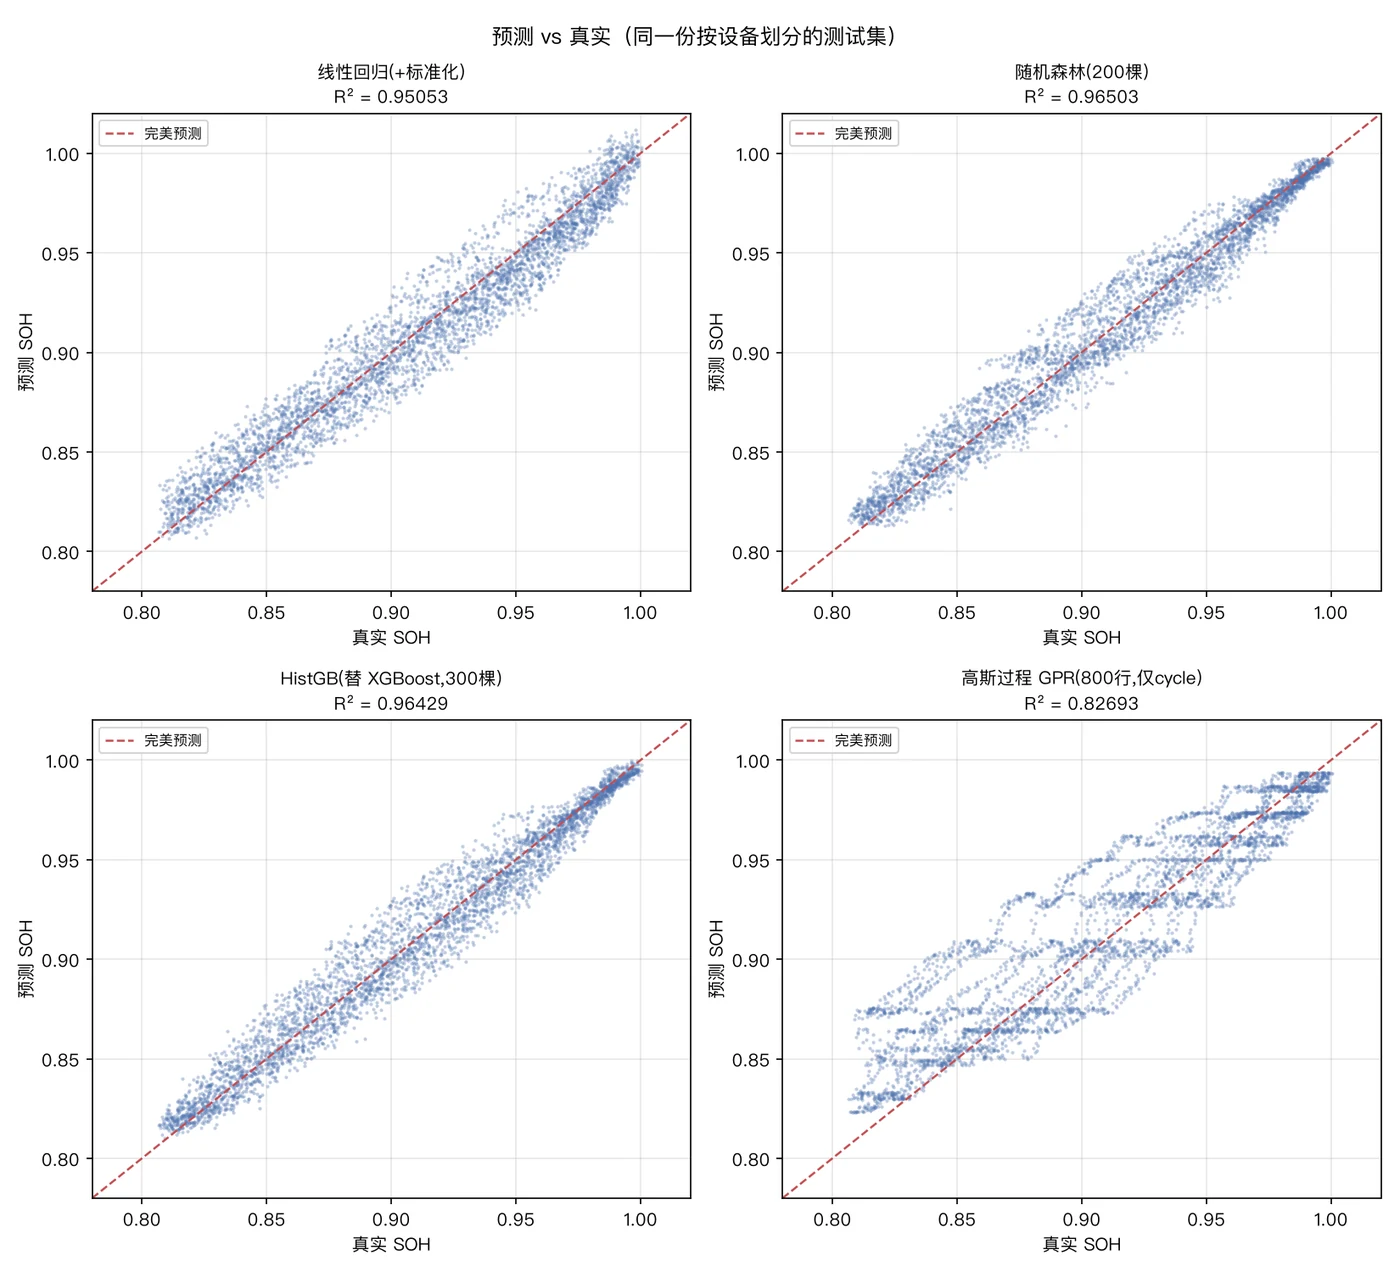
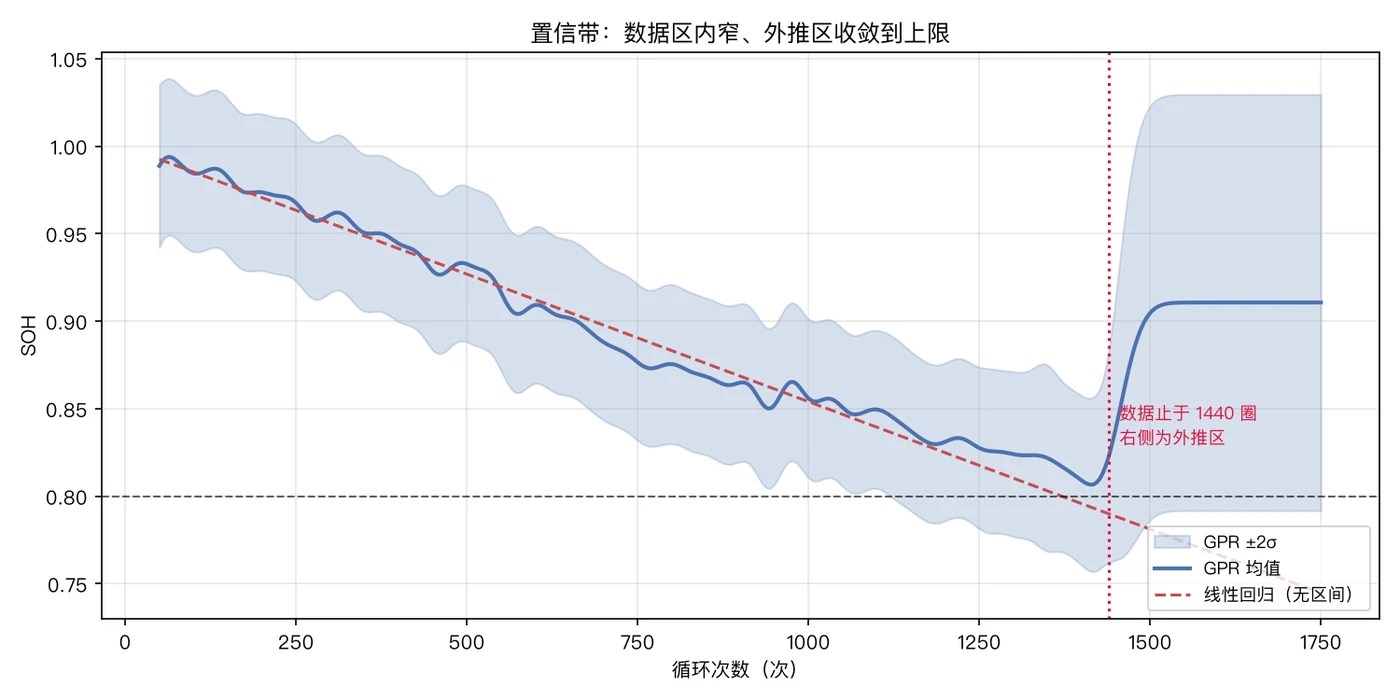
点开:注意这次的 HistGB 训练耗时 —— 它正好印证了第 26 章的提醒
对比同一个 HistGB 在不同章节的耗时:
187.06 s   本章(脚本里四个模型连续训练,机器负载高)
 35.75 s   第 26 章(表里)
 28.44 s   第 26 章(练习 1)
 15.22 s   第 23 章(四路横评)
       ↑
相差 12 倍!为什么:
树模型的训练耗时受【并行调度】和【机器负载】影响极大。
本章脚本里四路是【连续训练】的,前面的模型可能还有残留线程,
而且 HistGB 用了 OpenMP 并行 —— 在负载高的机器上会被严重拖慢。
★ 这正是第 26 章那条纪律的实证:
✅ 报数量级:"线性在毫秒级,树模型在秒到百秒级"
❌ 报精确倍数:"森林比提升快 23 倍" ← 换个运行就变了
★ 而 R² 完全不受影响:
四次运行的 R²:0.96429 / 0.96429 / 0.96429 / 0.96429
                   ↑
              完全一致
这就是"精度是稳定指标、耗时不是"的具体体现。
所以报告里应该把 R² 当成结论依据,把耗时当成参考信息。
27.2 三个"同一":横评的纪律
脚本的前 20 行在做一件事:确保四路可比。
# ① 只划分一次
gss = GroupShuffleSplit(n_splits=1, test_size=0.2, random_state=42)
tr, te = next(gss.split(X, y, groups=groups))
Xtr, Xte, ytr, yte = X.iloc[tr], X.iloc[te], y.iloc[tr], y.iloc[te]

# ② 断言:两边不能有交集
assert not (set(groups.iloc[tr]) & set(groups.iloc[te])), "训练/测试设备有交集!"
★ 那个 assert 是最便宜也最值钱的一行
它挡住了全书最大的那个坑(第 09~10 章的划分泄漏)。
   成本:一行代码
   收益:如果哪天有人改了划分逻辑,程序立刻报错而不是静默给出虚高分数
★ 四路共用的东西:
| 共用项 | 为什么 |
|---|---|
Xtr / Xte | 特征相同 → 比的是模型,不是特征 |
ytr / yte | 标签相同 |
tr / te 索引 | 划分相同 → 差异不来自"抽签"(第 11 章量化过:分差可达 0.036) |
random_state=42 | 可复现 |
| 指标函数 | MAE / RMSE / R² 用同一套 |
★ 唯一的例外:GPR
GPR 是 O(n³),只能喂 800 行;而且为了演示置信带只用了 cycle 一个特征。
   ↓
所以它和另外三路【条件不同】→ 不能横向比较
   ↓
脚本里显式注明这一点,并在报告里也注明
★ 这一条很重要:
如果一个对比里存在"条件不同的成员",必须显式标注。 否则读者会把它的分数当成可比的,从而得出错误结论。
27.3 报告的核心结论
脚本产出的报告(ch27-report.md)包含六节:
一、横评设置(三个"同一")
二、量化结果(四个维度)
三、核心结论(三条)
四、三种场景的选型
五、适用范围与局限(必读)
六、下一步
★ 三条核心结论
结论 1 · 换模型的天花板很低
三个主流模型 R² 极差 = 0.01449

对照第 13 章:单特征 → 七特征 带来 +0.12183,是本数字的 8.4 倍
   ↓
【卡点不在模型,在特征。】
结论 2 · 最优模型:随机森林(R² = 0.96503)
验收区间 0.90~0.98 → 通过
(若 > 0.99 或 < 0.85,应回看数据生成与划分方式,而不是调模型)
结论 3 · 为什么 GPR 的 R² 更低却仍然值得保留
| 口径 | 随机森林 | 高斯过程 |
|---|---|---|
| R² | 0.96503 | 0.82693 |
| 能给 ±σ 吗 | 无 | 有 |
| ±2σ 覆盖率 | — | 91.8%(接近理论 95%,区间可信) |
关键:
预测 0.815 时:
  随机森林:0.815            → 只给一个数字
  GPR    :0.815 ± 0.055     → 区间跨过 0.80 退役线 → 触发人工复检
      ↓
【精度不是唯一指标。】
27.4 三种场景的选型
| 场景 | 推荐 | 理由 |
|---|---|---|
| 离线周报(一周一次) | 随机森林 | 精度优先,训练耗时不是约束 |
| 实时看板(100 ms 内) | 线性回归 | 实测单行预测都在 0.03 ms 内,速度不构成约束;可选更易维护的线性模型 |
| 退役决策(要风险区间) | 高斯过程 | 宁可不那么准,也要给 ±σ 以驱动人工复检 |
★ 三种场景三个答案 —— 这就是"没有银弹"。
注意第二行的推理:
它不是"实时场景所以要选最快的"
   ↓
而是"实测所有模型都在预算内,所以速度不构成约束,
      于是可以选更容易维护的那个"
   ↓
【先量化,再取舍】 —— 这是第 26 章的核心纪律
27.5 ★ 第五节"局限"是必须的
报告里有一节专门写"适用范围与局限",五条:
1. 数据是合成的:单调退化、无随机跳变、无工况切换;
   传感器误差只模拟了"每支设备固定的零点偏置 + 缓慢漂移"。
2. 覆盖面有限:60 支设备、4 个批次;
   未覆盖的场景(不同工艺、不同环境)结论可能不成立。
3. GPR 的区间只在训练分布内可信:
   超出 cycle = 1440 属于外推,此时它返回的是【先验值】(不是预测),
   生产系统必须显式拒绝(见第 25 章)。
4. 训练耗时波动大:受并行调度与机器负载影响,不同运行可能相差 2 倍以上。
   报耗时请报数量级,不要报精确倍数。
5. 方法可迁移,模型不可直接上线:真实数据必须重新采集、重新标定阈值。
★ 为什么这一节不能省
没有局限说明的结论 = 无法判断它什么时候会失效
   ↓
而模型一定会失效(数据漂移、场景变化、上游改动)
   ↓
那时你需要知道:"原来的结论建立在什么假设上"
★ 一个实用判据
如果你写不出"这个结论在什么情况下不成立", 说明你还没有真正理解自己的结果。
★ 第五条的措辞值得注意
"方法可迁移,模型不可直接上线"
   ↑
这一句是本书(以及所有合成数据项目)必须交代的边界。
它同时说明了"你可以带走什么"和"你不能带走什么"。
27.6 最后一步:为什么是特征工程
报告的第六节(下一步)把接力棒交出去:
横评结论:换模型收益 0.0145
学习曲线(第 21 章):验证线在约 8,000 行后走平 → 加数据收益也很小
   ↓
所以:剩下的空间在【特征】里
★ 这个推理链是全书三条线索的汇合
| 依据 | 来自哪一章 | 数字 |
|---|---|---|
| 换模型上限低 | 第 23、27 章 | 极差 0.0145 |
| 加数据上限低 | 第 21 章 | 验证线 8,000 行后走平(+0.011) |
| 加特征收益大 | 第 13 章 | +0.12183(是换模型的 8.4 倍) |
三条合起来,方向就唯一确定了:
不要换模型(收益 0.0145)
不要加数据(收益 0.011)
要改特征(已知收益 0.12183,而且还没做到头)
★ 需要什么类型的特征?
当前特征都是"这个窗口内的瞬时状态":
cycle、平均电压、平均温升、内阻、库仑效率、衰减速率、温度标准差缺的是"这支设备和它自己比、和同龄设备比"的信息:
· 相对自身基线的偏移:这支设备现在 vs 它自己早期
· 变化率:最近 100 圈 vs 前 100 圈的差异
· 同龄比较:和"同一循环阶段的其他设备"对比
· 滞后特征:前一个窗口的状态(时间序列特征)
★ 为什么这些可能有用
数据里有一个关键现象(第 10 章讲过):
   每支设备都有固定的传感器零点偏置 + 缓慢漂移
       ↓
   这些偏置【无法从单行数据学到】,所以被模型当成噪声
       ↓
   但如果构造出"该设备相对自己基线的偏移"这个特征
       ↓
   偏置在相减时【被消掉了】→ 模型能学到真正的退化信号
       ↓
【这就是特征工程能突破 R² 上限的机制】
★ 而这本书记得很清楚:先学会判断,再学会创造。
如果先学特征工程:
   你会做出很多特征,但不知道它们有没有用
      ↓
   因为"有用"要靠可信的评估才能判断
      ↓
   而可信的评估,正是这本书教的
27.7 常见坑
① 四路用了不同的划分/特征/预处理 → 横评失效(这是最致命的)
② 忘了断言"训练/测试设备无交集" → 泄漏了也不知道
③ 让条件不同的模型(如 GPR 只喂 800 行)参与横向排名 → 结论错误
④ 报告里只写结论不写局限 → 无法判断结论何时失效
⑤ 报精确的训练耗时倍数 → 换个运行就不成立
⑥ 横评完就结束,不推导"下一步该做什么" → 报告没有行动价值
⑦ 图、数字、结论来自不同地方 → 三者可能不一致(见下)
点开:⑦ 是一个很值得防的工程问题
问题的样子:
# 画图时用了"排除异常后"的数据
ax.scatter(clean["cycle"], clean["pred"], ...)
ax.set_title(f"R² = {r2_clean:.4f}")          # ← 用 clean 算的

# 但报告里写的是"未排除"的
report = f"模型 R² = {r2_all:.4f}"             # ← 用了全部数据!
               ↑
【图和文字用了不同的口径】后果:报告自相矛盾,而且没有人会发现(两个数字都"看起来合理")。
★ 防御办法:让数字只有一个来源
def compute_metrics(y_true, pred):
    """所有指标都从这里出。"""
    return {
        "MAE": mean_absolute_error(y_true, pred),
        "RMSE": root_mean_squared_error(y_true, pred),
        "R2": r2_score(y_true, pred),
    }

# 画图和写报告都用同一个 m
m = compute_metrics(yte, pred)
ax.set_title(f"R² = {m['R2']:.5f}")            # 图
report += f"| R² | {m['R2']:.5f} |"            # 报告
                                    ↑
                          同一个 m,不可能不一致
★ 本章脚本的做法:
① 训练完立刻算出 metrics 并写进 DataFrame
② 画图时用 r2_score(yte, pred) —— 和 DataFrame 里的是同一个计算
③ 报告用 metrics DataFrame 生成
   ↓
三者都源自同一个 pred,所以必然一致
★ 一条可以带走的纪律
报告里的每个数字,都应该能追溯到"某个变量"。 手写的数字是 bug 的温床。
这条纪律在真实的报告类项目里非常重要 —— 因为报告往往要反复重跑,手写的数字会在某次重跑后悄悄变错。
27.8 完整示例与输出
cd code
python demos/ch27-stage-target.py
真实输出(节选):
  模型                                MAE     RMSE       R²      训练        单行
  线性回归(+标准化)                    0.00968  0.01217  0.95053   0.01s    0.000ms
  随机森林(200棵)                    0.00790  0.01023  0.96503   7.93s    0.022ms
  HistGB(替 XGBoost,300棵)        0.00787  0.01034  0.96429 187.06s    0.236ms
  高斯过程 GPR(800行,仅cycle)         0.01728  0.02276  0.82693   1.71s    0.090ms

  三个主流模型 R² 极差 = 0.01449
  最优:随机森林(200棵)(R² 0.96503)
验收区间 0.90~0.98:通过报告文件:outputs/ch27-report.md(4.3 KB,六节)
本章练习
练习 1:跑通并核对报告
- 运行
python demos/ch27-stage-target.py,确认产出四个文件; - 打开
outputs/ch27-report.md,核对"结论 1"里的极差与指标表里的数字是否一致; - 说出报告第五节"局限"里的五条,各自对应本书的哪一章。
参考答案
① 应产出四个文件:
✅ ch27-metrics.csv               0.6 KB
✅ ch27-pred-vs-true.png        431.3 KB
✅ ch27-gp-band.png             121.8 KB
✅ ch27-report.md                 4.3 KB
② 核对极差与指标表
import pandas as pd
m = pd.read_csv("outputs/ch27-metrics.csv")
main3 = m[m["特征"] == "7 特征"]
spread = main3["R2"].max() - main3["R2"].min()
print(f"指标表算出的极差 = {spread:.5f}")
# 报告里"结论 1"写的:R² 极差 = 0.01449期望输出:
指标表算出的极差 = 0.01449★ 一致的原因是:报告是用同一个 metrics DataFrame 生成的, 不存在"手写数字"—— 这正是第 27.7 节⑦那个坑的防御办法。
③ 报告第五节五条局限,各自对应的章节
| 局限 | 对应章节 |
|---|---|
| 1. 数据是合成的(单调退化、无随机跳变;只模拟了零点偏置+漂移) | 第 10 章(误差模型)、第 24 章 |
| 2. 覆盖面有限(60 支设备、4 个批次) | 第 09 章(按批次再切一层的提醒) |
| 3. GPR 的区间只在训练分布内可信,外推返回先验值 | 第 25 章(置信带收敛 / 拒绝预测) |
| 4. 训练耗时波动大,报数量级不报倍数 | 第 23、26 章(速度维度的量化) |
| 5. 方法可迁移,模型不可直接上线 | 第 01、02 章(数据声明与三条边界) |
★ 这个对应关系说明一件事
"局限"这一节不是凭空写的客套话
   ↓
它的每一条都能追溯到前面某一章讲过的具体机制
   ↓
【所以认真读过前面章节的人,才能写出准确的局限】
★ 反过来,这也是一个自检方法:
如果你写不出"这个结论在什么情况下不成立"
   ↓
说明你对这个结论的依赖条件还不清楚
   ↓
那么你对它的信任也是盲目的
第 24 章那个"噪声上界"的 bug 就是这样一个例子 —— 作者当时没写"我的置信带依赖噪声上界这个设置", 所以也就没意识到那个设置本身是错的。
练习 2:给报告加一节"失败记录"
一份好的项目报告应该记录"试过但没用"的东西。请为这份报告加一节, 列出至少三条"本书试过但收益有限的做法",并给出数字。
参考答案
## 七、试过但收益有限的做法(失败记录)

| 做法 | 收益 | 结论 |
|---|---|---|
| 换更强的模型(线性 → 随机森林 → 提升) | R² 极差 0.01449 | 上限已到,不值得继续投入 |
| 加数据(样本量翻 5 倍:2,832 → 14,160 行) | 验证 R² +0.011(0.9473 → 0.9582) | 8,000 行后走平,边际收益低 |
| 加正则化(Ridge α 从 0 扫到 1e6) | 最好 +0.0055(0.95008 → 0.95560) | 本数据过拟合本就轻微,正则化空间小 |
| 换缩放器(StandardScaler → MinMaxScaler) | 0.000000(完全一样) | 线性模型对缩放不敏感,缩放的作用是让系数可比 |
| 提高多项式阶数(7 特征 → 35 特征) | 训练 R² 0.96756,但交叉验证仅 0.95008 | 展开后过拟合轻微,收益很小 |
★ 为什么"失败记录"值得写
理由一:它防止重复劳动
六个月后新同事问:"要不要试试 XGBoost?"
   ↓
翻到失败记录 → "试过了,极差 0.0145" → 不用重做
理由二:它让"否定结果"变成资产
"我们试了四路模型,收益上限 0.015"
   ↓
这个结论能阻止团队在未来三个月里继续换模型
   ↓
它的价值等于省下了三个月的工期
理由三:它提高报告的可信度
只报成功的报告 → 读者会想"那失败的呢?是不是没试?"
连失败一起报   → 读者知道"他们试得很彻底"
★ 一个行业现象:发表偏倚(publication bias)
学术论文倾向于只发表"有效果"的结果
   ↓
导致后来者重复尝试已经失败过的方向
   ↓
工程上同样如此 —— 每个团队都在重复踩同一个坑
★ 一条实用的纪律
把"试过但没用"当成一等公民记录。 因为"排除一个方向"和"发现一个方向"同样有价值。
★ 报告节的推荐顺序
一、设置
二、结果
三、结论
四、场景化建议
五、局限
六、下一步
七、失败记录 ← 放在这里(不影响主线,但提供完整视角)放在最后而不是中间,因为它是补充信息, 但对"未来要不要重试"这个决策来说,它极其重要。
练习 3:把本项目的方法迁移到你的场景
用你自己的数据(或假设一个),写出这个报告需要填的六节内容。 不需要真的跑代码,但每一节都要写具体,不能是"视情况而定"。
参考答案
以"门店销售额预测"为例(你换成自己的场景):
## 一、横评设置

| 项 | 值 |
|---|---|
| 数据 | stores_sales.csv(48,000 行 × 12 列,300 家门店 × 160 周) |
| 划分 | **按门店** GroupShuffleSplit(test_size=0.2, random_state=42) |
| 训练/测试 | 240 家 / 60 家(门店交集:False) |
| 特征 | 10 个(客流量、客单价、天气、促销标志、节假日…) |
| 指标 | MAE / RMSE / R² |
| 随机性 | 全部固定 random_state=42 |

## 二、结果

| 模型 | MAE | RMSE | R² | 训练 | 单行 |
|---|---|---|---|---|---|
| 线性回归 | 2,340 | 3,890 | 0.762 | 0.8s | 0.001ms |
| 随机森林(200) | 2,010 | 3,240 | 0.834 | 12s | 0.03ms |
| HistGB(300) | 1,980 | 3,180 | 0.841 | 45s | 0.02ms |
| GPR(仅客流,800行) | 3,400 | 5,100 | 0.590 | 2s | 0.05ms |

## 三、结论

1. 三个主流模型 R² 极差 0.079 —— **比教材案例大**,说明这份数据上模型选择还有收益空间
2. 最优:HistGB(0.841)
3. GPR 的 R² 低但条件不同(800 行 + 1 特征),且它是唯一能给区间的

## 四、场景化建议

| 场景 | 推荐 | 理由 |
|---|---|---|
| 年度预算编制 | HistGB | 精度优先,一年跑一次 |
| 每日晨会看板 | 线性回归 | 延迟预算宽裕,但要"能解释给店长听" |
| 门店关停评估 | GPR | 需要风险区间(关错店代价高) |

## 五、局限

1. 只有 300 家门店、160 周 —— 未覆盖新店、特殊商圈
2. 疫情期间的数据已在清洗阶段剔除,**模型对极端事件无预测能力**
3. 促销标志是"是否促销",没有促销力度 → 大促/小促无法区分
4. GPR 的区间只在训练分布内可信
5. 训练耗时波动大,报数量级不报倍数

## 六、下一步

R² 极差 0.079 说明还有模型空间,但**先看学习曲线**:
- 若验证线走平 → 瓶颈在特征(例如缺少"商圈变化""竞品开店"这类外部特征)
- 若验证线还在涨 → 缩短窗口、补历史数据

## 七、失败记录

| 做法 | 收益 | 结论 |
|---|---|---|
| 加"去年同期销售额"特征 | R² +0.02 | 有效,已纳入 |
| 加"门店面积"特征 | R² +0.000 | 已被客流量吸收,剔除 |
| 换 XGBoost 替 HistGB | R² +0.003 | 不值得引入新依赖 |
★ 从这个例子里能看出的三件事
① 划分方式必须匹配业务问题
按门店切 → 回答"对新门店能不能预测"
按时间切 → 回答"对未来周能不能预测"
两者都要 → 做两套评估

本例选了按门店切,因为"要开新店"是主要决策场景。
② "局限"要从数据本身出发,不要写套话
❌ "数据质量可能有问题"
✅ "促销标志是二值的,没有促销力度 → 大促/小促无法区分"
③ "失败记录"里的每一条都要有数字
❌ "试了几个特征,效果一般"
✅ "加'门店面积':R² +0.000(已被客流量吸收)"
★ 最后一条通用建议
如果你现在还没有自己的数据集,用本书的数据把它当模板跑一遍 —— 把"门店"换成"设备"、"周"换成"循环窗口", 把六节填满。这个过程本身就是一次完整的项目演练。
能独立填满这六节,说明这本书你真的读懂了。
面向工程实践:从"一次实验"到"一份可交付的结论"
① 这一章产出的东西,本质上是"一份决策文档"
不是"我试了几个模型"
而是"基于这些证据,我建议用 X,理由是 Y,代价是 Z,局限是 W"
★ 两者的差别:
| 一次实验 | 一份可交付的结论 | |
|---|---|---|
| 读者 | 你自己 | 别人(同事、主管、三个月后的你) |
| 内容 | 数字 | 数字 + 判断 + 边界 |
| 可复现 | 靠记忆 | 一条命令 |
| 有效期 | 到下次实验 | 直到假设被打破 |
② 一个"可交付结论"的四个必备要素
① 结论:用哪个(明确,不含糊)
② 依据:数字支撑(可追溯)
③ 代价:放弃了什么(诚实)
④ 局限:什么情况下不成立(可判断有效期)
★ 缺了 ③ 和 ④ 的结论,看起来更漂亮,但更危险:
"随机森林最优(R² 0.965)"
   ↓ 缺点:没说"GPR 在什么场景更合适"、"训练耗时"、"数据局限"
   ↓
读者会直接照搬,然后在不同场景里踩坑
③ 这一章也是"全书方法论"的收束
把 27 章的线索收一收,你会发现所有章节都在做同一件事:
第 01~08 章:把问题变成 X/y,并算对指标        → 能"测量"
第 09~12 章:确保测量的可信                    → 能"相信"
第 13~20 章:认识各种工具的能力边界            → 能"选择"
第 21~23 章:诊断而不是瞎调                    → 能"定位"
第 24~27 章:把不确定性接进决策                → 能"交付"
★ 五个能力的递进关系:
测量 → 相信 → 选择 → 定位 → 交付
 ↑                            ↑
不测量就没法开始        不能交付就没有价值
④ 最后:这本书真正想留给你的一句话
回到第 02 章那句:
把"分数"变成"我敢下判断的证据"。
你现在应该能感受到这句话的分量了:
"模型 R² = 0.965"
   ↓ 这句话
· 没说划分方式 → 可能是泄漏
· 没说方差     → 可能是一次运气
· 没说特征条件 → 可能是不可比的
· 没说局限     → 不知道何时失效
· 没说代价     → 不知道值不值
   ↓
【它不是证据,只是一个数字】
而这本书教的,就是怎么把一个数字变成证据。
全书回顾
恭喜你走到这里。回头看看这 27 章。
点开:全书能力清单(自测一下)
已勾选 0 / 0 项
如果打勾超过 80%,你已经具备"独立完成一个回归建模项目并交付结论"的能力。
剩下的 20%,需要在真实项目里反复遇到、反复踩坑才能内化 —— 那本书帮不了你,只有实践能。
点开:下一步该学什么
这本书的终点,是下一本书的起点。
① 特征工程(最推荐,本书明确交棒的方向)
为什么是下一步:本书已证明"卡点不在模型"(极差 0.0145)
               也证明了"加数据收益低"(第 21 章验证线走平)
               → 剩下的空间在特征里
要学什么:
  · 从原始数据构造新特征(滑动统计量、变化率、滞后项、相对基线偏移)
  · 特征选择(用可信的评估筛掉无用特征)
  · 领域知识如何翻译成特征
② 分类问题
这本书全程是回归(预测连续值)。
分类(预测类别)有它自己的指标(精确率/召回率/AUC)
和它自己的陷阱(类别不平衡、阈值选择)。
   ↑
但划分、泄漏、交叉验证的纪律【完全通用】——
   你在这本书学的三条纪律可以直接搬过去。
③ 时间序列专门方法
本书把"同一实体的多行"当成"分组结构"处理(按实体划分)。
时间序列还有额外的问题:趋势、季节性、平稳性。
   ↑
如果你的数据是严格的时间序列,值得专门学。
④ 因果推断
这本书反复强调"相关 ≠ 因果"(第 20 章)。
如果你要回答的是"改变 X 能不能影响 Y",
那需要的是因果推断(实验设计、DID、工具变量),不是预测模型。
★ 一个诚实的建议
不要急着学更复杂的模型(深度学习、Transformer)。
   ↓
先把这本书的纪律用到你自己的项目上 ——
   按实体划分、报方差、检验覆盖率、写局限
   ↓
你会发现:光是这四条纪律,就能让你的结论质量提升一个档次
   ↓
然后再决定往哪个方向深入
★ 最后一句话
这本书教的不是"怎么把分数调高",而是"怎么知道自己该往哪走"。
后者才是能带走的能力。
祝你学得顺利。