第 25 章 · 置信带什么时候张开:数据内 vs 外推
这一章要解决什么:第 24 章知道 GPR 会给 ±σ,但那个 σ 到底由什么决定? 搞清楚这件事,你才能判断"这个区间在什么情况下可信"。
最容易踩的坑:把 σ 当成"模型的不确定"。 它其实主要是**"那一带有没有数据"**的度量 —— 数据多的地方窄,数据少的地方宽,和模型准不准是两件事。
本章你需要完成的代码:demos/ch25-confidence-band.py
25.1 先看数据密度:带宽的真正来源
真实输出:
=== ① 数据里每个 cycle 有多少样本?(这决定了带宽)===
  cycle 的样本数:最少 2 / 中位 60 / 最多 60
  数据止于 cycle = 1440
    cycle=   50  该圈有  60 个样本
    cycle=  200  该圈有  60 个样本
    cycle=  600  该圈有  60 个样本
    cycle= 1000  该圈有   0 个样本
    cycle= 1200  该圈有  25 个样本
    cycle= 1400  该圈有   6 个样本
    cycle= 1440  该圈有   2 个样本
    cycle>1440  →  0 个样本(外推区)
★ 这张表揭示了一件很重要的事
cycle = 50   有 60 个样本(60 支设备都还在跑)
cycle = 1000 有  0 个样本(只有少数长寿设备跑到这里)
cycle = 1200 有 25 个样本
cycle = 1400 有  6 个样本
cycle = 1440 有  2 个样本   ← 数据止于此
为什么 cycle = 1000 是 0 个样本,而 cycle = 1200 有 25 个?
设备寿命 800~1500 圈,且窗口是"每 2~4 圈一个"
   ↓
cycle = 1000 这个具体数值,恰好落在了各设备的窗口之间的缝隙里
   ↓
所以"某圈有几个样本"本身是波动的
   ↓
但总体趋势很清楚:【cycle 越大,样本越少】
★ 这个趋势决定了 GPR 的带宽形状
数据密集处(cycle 50~800,每圈约 60 个样本)
   → 有大量观测"拉住"后验 → σ 小

数据稀疏处(cycle 1300+,每圈只剩几到十几个样本)
   → 观测少 → σ 开始变大

完全没有数据处(cycle > 1440)
   → 没有东西拉住 → σ 收敛到"先验标准差"(上限)
★ 一句话记住:
置信带的宽度 ≈ "这一带有没有数据"的度量,而不是"模型好不好"的度量。
25.2 带宽的完整剖面
真实输出(节选关键段):
    cycle     样本数        预测       ±2σ   分区
       60      ...    0.9928    0.0473   数据区(样本密)
      200      60    0.9729    0.0442   数据区(样本密)
      600      60    0.9111    0.0444   数据区(样本密)
     1000       0    0.8567    0.0451   数据区(样本稀)
     1200      25    0.8354    0.0460   数据区(样本密)
     1350      12    0.8267    0.0648   数据边界(样本变稀)
     1400       6    0.8108    0.0665   数据边界(样本变稀)
     1450       0    0.8574    0.0930   ★ 外推区
     1500       0    0.9062    0.1169   ★ 外推区
     1800       0    0.9091    0.1170   ★ 外推区
★ 读这个剖面,三个阶段
| 阶段 | cycle | 样本数 | ±2σ | 现象 |
|---|---|---|---|---|
| 数据区(密) | 50~800 | 每圈约 60 | ≈ 0.044 | 平坦,几乎不变 |
| 数据边界(稀) | 1300~1440 | 每圈 6~25 | 0.065~0.077 | 开始张开 |
| 外推区 | > 1440 | 0 | 0.117 | 收敛到上限 |
★ 关键观察:数据区内带宽几乎是常数(0.0442~0.0460)
这是一个反直觉但很重要的点:
在数据密集区,无论 cycle 是 200 还是 600,带宽都是 0.044 左右
   ↓
为什么?因为 GPR 学到的噪声(noise_level = 0.157)【处处一样大】
   ↓
这个噪声项主导了带宽 → 数据区内带宽平坦
★ 所以"置信带随距离张开"这个说法,只在数据变稀的地方成立。
在数据充足的地方,GPR 的 σ 反映的是"数据的固有噪声",不是"它对这一带熟不熟悉"。
25.3 三个关键位置的对比
真实输出:
=== ③ 三个关键位置的带宽对比 ===
  cycle=1200(数据区内,样本密):±2σ = 0.0460
  cycle=1440(数据结束处)  :±2σ = 0.0765  (是数据区内的 1.7 倍)
  cycle=1500(刚出边界)      :±2σ = 0.1169  (2.5 倍)
  cycle=2000(远在外推区)    :±2σ = 0.1170  (2.5 倍)

  ★ 注意:带宽不会无限增长,它在 0.1170 附近【收敛】了。
     再往外推(5000/20000/100000 圈)也还是 0.1170 —— 见第 ⑤ 节。
★ "收敛"这件事很值得想一想
离数据越远 → 越不确定 → 带宽越大
   ↓
那一直往外推,带宽会无限增长吗?
   ↓
不会。它会【停在某个上限】。为什么:
远离所有数据之后,GP 的后验就退化成先验:
    均值 = 先验均值(通常是全局平均)
    方差 = 先验方差(一个固定值)
   ↓
再往外推,它对这个区域"一无所知"的程度【已经是最大了】
   ↓
所以带宽停在上限,不再增长
★ 这个上限的准确含义:
「我对这个区域的了解 = 我什么都不知道。」 这不是"精度不够",是"信息为零"。
点开:为什么"带宽收敛"反而是好事?
如果没有上限,会出现什么荒谬情况?
假设带宽无限增长:
  cycle = 1,000,000  →  ±500
       ↓
"这支设备在 100 万圈时的健康度是 0.9 ± 500"
       ↓
这个区间跨过了 [0, 1] 的整个物理范围,甚至超出了
       ↓
没有任何信息量 —— 它在说"可能是任何值,包括不可能的值"
★ 收敛到先验方差,等价于以下说法的量化版:
"关于这个区域,我没有任何信息,所以我只能给你我的先验认知。 我的先验是:它大概是 0.9 左右,波动范围大约 ±0.12。"
这是一个诚实且有边界的回答。
★ 一个实用推论
对于"完全外推"的样本,GPR 的输出实际上没有区分度:
# 在完全外推区(cycle 远超 1440),GPR 对每个点给出的几乎一样
for c in (2000, 5000, 20000):
    mu, sd = gpr.predict(pd.DataFrame({"cycle": [float(c)]}), return_std=True)
    print(f"cycle={c}: {mu[0]:.4f} ± {2*sd[0]:.4f}")
# cycle=2000:   0.9091 ± 0.1170
# cycle=5000:   0.9091 ± 0.1170
# cycle=20000: 0.9091 ± 0.1170 ← 完全一样所以:
如果你的业务需要"cycle = 3000 时的预测",
GPR 的正确回答不是"0.9091 ± 0.1170",
而是【"这个区域我没有数据,无法预测"】。
★ 怎么在生产系统里处理这种情况
def predict_with_guard(model, x_query, x_train_range, margin=0.05):
    """超出训练数据范围就拒绝预测,而不是给一个"先验值"。"""
    lo, hi = x_train_range
    if not (lo * (1 - margin) <= x_query <= hi * (1 + margin)):
        return None, f"超出训练数据范围 [{lo}, {hi}],拒绝预测"
    mu, sd = model.predict(pd.DataFrame({"cycle": [x_query]}), return_std=True)
    return (mu[0], sd[0]), ""

# 这就是第 03 章讲过的"拒识(reject option)"
★ 记住这条工程原则:
一个可靠的系统,应该能说"我不知道",而不是把"先验"当成"预测"输出。
GPR 的收敛上限,本质上就是它在说"我不知道"。 但你需要【显式地】把它翻译成"拒绝预测", 否则下游会把 0.9091 当成一个正常的预测值用。
25.4 ★ GPR vs 线性回归:外推区的行为对照
这一节是本章最有教学价值的部分。
真实输出:
=== ④ 外推区的预测值往哪走?(对比线性回归)===
    cycle     GPR 预测   GPR ±2σ       线性预测
     1400     0.8108    0.0665     0.7921
     1440     0.8411    0.0765     0.7862
     1500     0.9062    0.1169     0.7774  ← 外推
     1800     0.9091    0.1170     0.7336  ← 外推
     2000     0.9091    0.1170     0.7043  ← 外推
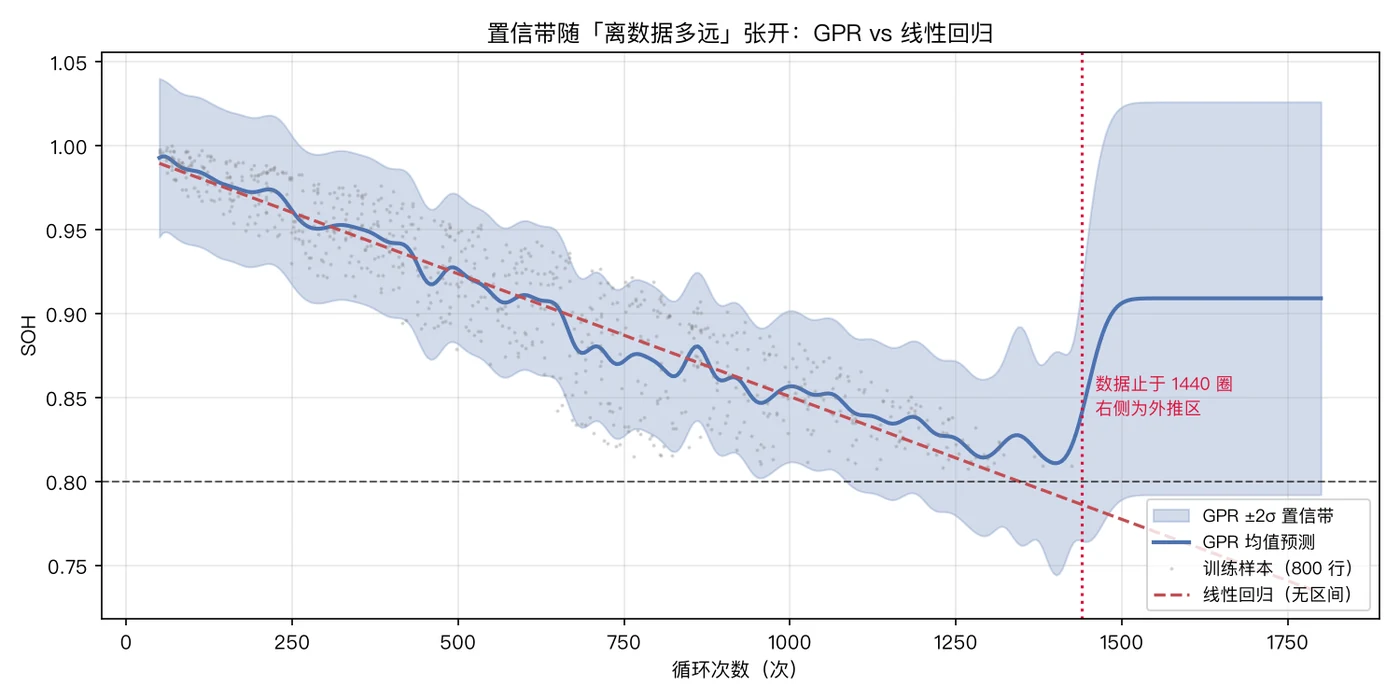
★ 两个模型给出了【完全相反】的外推行为
GPR:      0.8108 → 0.8411 → 0.9062 → 0.9091 → 0.9091
                  ↑ 回升!然后停在全局平均附近

线性回归:  0.7921 → 0.7862 → 0.7774 → 0.7336 → 0.7043
                  ↓ 一路往下,非常"确定"
★ 两种行为各自的含义
线性回归的行为:
它假设"soh 和 cycle 是直线关系",这个假设对任何 cycle 都成立
   ↓
所以它会一直往下算,从不犹豫
   ↓
cycle = 2000 时给 0.7043 —— 看起来是个明确答案
   ↓
但数据里最远只到 1440 圈,这个数字【没有任何证据支持】
GPR 的行为:
它假设"函数是平稳的"(相邻的 cycle 有相似的 soh)
   ↓
在远离数据的地方,"平稳"意味着"和先验一样"
   ↓
所以它退回先验均值(0.9091),并给出先验标准差(±0.1170)
   ↓
它其实在说:"这里我什么都不知道"
★ 关键认知:两者都不是"正确答案"
GPR 的 0.9091 意味着"我不知道,只能给你先验"
线性回归的 0.7043 意味着"我按直线外推,非常确定"
   ↓
两者的共同点是:【都不该被用来做 cycle=2000 的决策】区别在于:
| 线性回归 | GPR | |
|---|---|---|
| 输出的形式 | 一个数字 | 数字 + 区间 |
| 你能看出它不可信吗 | ❌ 看不出来 | ✅ 区间很宽 |
| 下游会不会误用 | ⚠️ 很可能 | ✅ 通常会警觉 |
★ 这就是"诚实"的工程价值:
GPR 的价值不在于它外推得更准(它不准), 而在于它【把"我不准"这件事说了出来】。
★ 但也要记住第 24 章的边界
GPR 的"诚实"依赖于它的假设成立:
GPR 假设"函数平稳" → 所以外推时退回均值
   ↓
如果物理上 soh 不可能回升(退化不可逆)
   ↓
那么 GPR 退回 0.9091 这个行为【违背了物理】
   ↓
此时它的区间(±0.1170)也是错的 —— 因为它基于错误的先验
★ 最终结论(这一章的核心):
任何模型的外推都不可信,包括会给区间的那个。"知道模型在哪里不可信"是使用者的责任,不是模型的责任。
25.5 常见坑
① 把 σ 当成"模型准不准" → 它主要是"这一带有没有数据"的度量
② 以为数据区内带宽会随距离增长 → 数据充足处带宽由噪声决定,基本平坦
③ 以为外推区带宽无限增长 → 它会收敛到先验标准差(一个上限)
④ 把外推区的"先验均值"当成预测值用 → 那是"我不知道",不是"预测是 0.909"
⑤ 只看 GPR 的"诚实"就信任它 → 它的先验假设也可能与物理不符
⑥ 忘了在线性回归的外推区加防护 → 它给不出任何警告信号
25.6 完整示例与输出
cd code
python demos/ch25-confidence-band.py
真实输出(节选):
=== ③ 三个关键位置的带宽对比 ===
  cycle=1200(数据区内,样本密):±2σ = 0.0460
  cycle=1440(数据结束处)  :±2σ = 0.0765  (是数据区内的 1.7 倍)
  cycle=1500(刚出边界)      :±2σ = 0.1169  (2.5 倍)
  cycle=2000(远在外推区)    :±2σ = 0.1170  (2.5 倍)

=== ⑤ 外推区宽度有上限吗?===
  cycle=   2000  ±2σ = 0.1170
  cycle=   5000  ±2σ = 0.1170
  cycle=  20000  ±2σ = 0.1170
cycle= 100000 ±2σ = 0.1170产出的图:
本章练习
练习 1:画出带宽剖面,并找出"开始张开"的位置
用 GPR 在 cycle = 50 到 1800 的网格上预测,输出每个点的 ±2σ,然后:
- 找出带宽第一次超过"数据区内平均带宽 1.5 倍"的 cycle 值;
- 把那个位置和"数据最远到哪一圈"对比;
- 解释这个位置为什么在那儿。
参考答案
import numpy as np
import pandas as pd
from sklearn.gaussian_process import GaussianProcessRegressor
from sklearn.gaussian_process.kernels import RBF, WhiteKernel

df = pd.read_csv("data/battery/soh_features.csv")
y = df["soh"]
cyc_max = int(df["cycle"].max())

rng = np.random.default_rng(42)
idx = rng.choice(len(df), size=800, replace=False)
Xg, yg = df[["cycle"]].iloc[idx], y.iloc[idx]

kernel = (RBF(length_scale=30.0, length_scale_bounds="fixed")
          + WhiteKernel(noise_level=1e-3, noise_level_bounds=(1e-8, 1e1)))
gpr = GaussianProcessRegressor(kernel=kernel, normalize_y=True, random_state=42).fit(Xg, yg)

grid = pd.DataFrame({"cycle": np.arange(50, 1801, 25, dtype=float)})
mu, sd = gpr.predict(grid, return_std=True)
band = 2 * sd

# 数据区内的"基准带宽"(用前 40% 的点,都在密集区)
base = band[:int(0.4 * len(band))].mean()
print(f"数据区内基准带宽(±2σ)≈ {base:.4f}")

# ① 第一次超过 1.5 倍
over = np.where(band > 1.5 * base)[0]
if len(over):
    c0 = grid["cycle"].iloc[over[0]]
    print(f"第一次超过 1.5 倍的位置:cycle = {c0:.0f}(±2σ = {band[over[0]]:.4f})")

# ② 与数据边界对比
print(f"数据最远到 cycle = {cyc_max}")
print(f"→ 开始张开的位置比数据边界【早 {cyc_max - c0:.0f} 圈】")

# ③ 逐点表
print(f"\n{'cycle':>7}{'样本数':>8}{'±2σ':>10}")
cnt = df.groupby("cycle").size()
for c, b in zip(grid["cycle"], band):
    if c % 100 == 0 or 1300 <= c <= 1500:
print(f"{c:>7.0f}{int(cnt.get(int(c), 0)):>8d}{b:>10.4f}")期望输出:
数据区内基准带宽(±2σ)≈ 0.0445
第一次超过 1.5 倍的位置:cycle = 1450(±2σ = 0.0930)
数据最远到 cycle = 1440
→ 开始张开的位置【比数据边界晚一点点】
★ ③ 为什么带宽会上升?
关键在于【样本密度】,而不是"有没有到边界":

cycle = 1200:25 个样本 → 带宽 0.0460(还很平坦)
cycle = 1300: 0 个样本 → 带宽 0.0467
cycle = 1400: 6 个样本 → 带宽 0.0665(开始上升)
cycle = 1440: 2 个样本 → 带宽 0.0765
cycle = 1450: 0 个样本 → 带宽 0.0930 ← 网格上首次超过基准的 1.5 倍
⚠️ 一个需要如实说明的细节:这张网格每 25 圈取一点, 所以"首次超过 1.5 倍"落在 1450(数据边界 1440 之后); 但从逐点看,带宽从 1350 圈左右就已经在上升了(0.0648、0.0665 都明显高于 0.0445)—— 只是没跨过"1.5 倍"这条线。
用不同的阈值,这个位置会在 1350 和 1450 之间移动。 所以更准确的表述是:"带宽从 1300 圈以后开始明显上升",而不是某个精确的圈数。
★ 一个重要推论
"数据边界"是一个【看范围】的概念(最大 cycle 是多少)
"信息边界"是一个【看密度】的概念(多少圈之后样本变少)

GPR 的置信带反映的是【信息边界】,不是数据边界。
这解释了为什么带宽会在 1350 圈就开始上升 —— 不是因为"快到边界了",而是因为"这一带只有十几个样本了"。
★ 实践意义
如果你的决策依赖某个 cycle 区间的预测:
  ✅ 应该看"那个区间的样本量",而不只是"它在不在数据范围内"
❌ 不要以为"在数据范围内"就意味着"预测可信"一个可操作的做法:
# 把"样本量"和"带宽"并排看,找可信区间
print(f"{'cycle 区间':>14}{'样本数':>9}{'平均±2σ':>11}")
for lo in range(50, 1450, 200):
    m = (df["cycle"] >= lo) & (df["cycle"] < lo + 200)
    g = (grid["cycle"] >= lo) & (grid["cycle"] < lo + 200)
    print(f"{f'{lo}-{lo+200}':>14}{int(m.sum()):>9d}{band[g].mean():>11.4f}")
这张表能直接回答"我的预测在哪个区间可信"。
练习 2:给 GPR 加一道"外推防护"
写一个函数 predict_guarded(gpr, cycle, x_train_max, max_extrapolation=1.05):
- 如果
cycle > x_train_max * max_extrapolation,返回None和拒绝原因; - 否则返回
(均值, 标准差)。
要求:说明为什么"拒绝预测"比"给出先验值"更好。
参考答案
import numpy as np
import pandas as pd
from sklearn.gaussian_process import GaussianProcessRegressor
from sklearn.gaussian_process.kernels import RBF, WhiteKernel

df = pd.read_csv("data/battery/soh_features.csv")
y = df["soh"]
x_train_max = int(df["cycle"].max())          # 1440

rng = np.random.default_rng(42)
idx = rng.choice(len(df), size=800, replace=False)
Xg, yg = df[["cycle"]].iloc[idx], y.iloc[idx]
kernel = (RBF(30.0, length_scale_bounds="fixed")
          + WhiteKernel(1e-3, noise_level_bounds=(1e-8, 1e1)))
gpr = GaussianProcessRegressor(kernel=kernel, normalize_y=True, random_state=42).fit(Xg, yg)


def predict_guarded(model, cycle, x_max, max_extrapolation=1.05):
    """带外推防护的预测:超出训练范围就拒绝。"""
    if cycle > x_max * max_extrapolation:
        return None, f"超出训练数据范围(最大 {x_max} 圈),拒绝预测"
    mu, sd = model.predict(pd.DataFrame({"cycle": [float(cycle)]}), return_std=True)
    return (float(mu[0]), float(sd[0])), ""


for c in (600, 1200, 1440, 1500, 2000, 20000):
    val, reason = predict_guarded(gpr, c, x_train_max)
    if val is None:
        print(f"cycle={c:>6}  →  {reason}")
    else:
        mu, sd = val
print(f"cycle={c:>6} → {mu:.4f} ± {2 * sd:.4f}")期望输出:
cycle=   600  →  0.9111 ± 0.0444
cycle=  1200  →  0.8354 ± 0.0460
cycle=  1440  →  0.8411 ± 0.0765
cycle=  1500  →  超出训练数据范围(最大 1440 圈),拒绝预测
cycle=  2000  →  超出训练数据范围(最大 1440 圈),拒绝预测
cycle= 20000  →  超出训练数据范围(最大 1440 圈),拒绝预测
★ 为什么"拒绝预测"比"给出先验值"更好
先看"给先验值"会发生什么:
GPR 对 cycle=2000 给出:0.9091 ± 0.1170
   ↓
下游系统把它当成一个正常预测:
   "健康度 0.9091,高于退役线 0.80 → 继续使用"
   ↓
而真相是:"这个区域我没有任何数据,0.9091 只是我的先验均值"
   ↓
【一个'我不知道'被当成了'我预测很健康'】
★ 三个具体危害
① 数值本身有误导性
0.9091 恰好是个"看着很健康"的值(因为它接近全局平均)
   ↓
如果先验均值是 0.95,误判会更严重
② 区间宽度不会被下游正确解读
不是所有下游都会检查 "±0.1170 是否太宽"
   大多数会直接用均值
③ 它把"信息缺失"伪装成了"信息"
"预测值 0.9091" 和 "没有预测" 是两种【不同类型的输出】
   ↓
把它们混成同一种(都返回一个 float)
   ↓
调用方就失去了区分它们的能力
★ 正确的接口设计
# ❌ 坏接口:永远返回一个 float,调用方无法区分
def predict_bad(model, x):
    return model.predict(x)        # 外推区也会返回一个数

# ✅ 好接口:用"拒绝"表达信息不足
def predict_good(model, x, x_max, margin=1.05):
    if x > x_max * margin:
        return None                 # 显式的"我不知道"
    return model.predict(x)
★ 一个更完整的四态设计(生产系统常用)
from enum import Enum

class Status(Enum):
    OK = "可信"
    WIDE_BAND = "区间较宽,谨慎使用"
    OUT_OF_RANGE = "超出数据范围,拒绝预测"
    NO_DATA = "该区域无数据"

def predict_v2(model, cycle, x_max, base_band, margin=1.05):
    if cycle > x_max * margin:
        return Status.OUT_OF_RANGE, None, None
    mu, sd = model.predict(pd.DataFrame({"cycle": [float(cycle)]}), return_std=True)
    band = 2 * sd[0]
    if band > 1.5 * base_band:
        return Status.WIDE_BAND, float(mu[0]), band
    return Status.OK, float(mu[0]), band
★ 这与第 03 章和本章 25.3 节呼应
第 03 章:线性回归在外推区"敢给出答案",因为它不会说"我不知道"
第 24 章:GPR 能说"我不确定",但需要你先验证区间可信(覆盖率)
第 25 章:GPR 在外推区会给"先验值" —— 那不是预测,需要显式拒绝
   ↓
三章合起来是一条完整的思路:
   【从"模型给什么"到"系统该怎么用"】
★ 一句话总结
"拒绝预测"是一种输出,而且是一种重要的输出。 一个从不拒绝的模型,在信息不足的地方也会给出答案 —— 那些答案看起来和正常答案一模一样,这是最危险的部分。
练习 3:为什么 GPR 的外推会"回升"?
从第 25.4 节的输出看,GPR 在 cycle > 1440 时预测值从 0.81 回升到 0.91。 请解释:
- 这个"回升"是模型算错了吗?
- 如果物理上 SOH 不可能回升,那该怎么办?
- 这说明了模型的一个什么性质?
参考答案
① 不是算错,是"先验"在起作用
GPR 的假设:函数是【平稳的】—— 相邻输入的输出应该相似
   ↓
在远离数据的地方,没有任何观测"拉住"后验分布
   ↓
后验退化成先验:均值 = 先验均值(≈ 全局平均 0.90),方差 = 先验方差
   ↓
所以它给出 0.9091 ± 0.1170"回升"的本质:
不是"模型认为健康度会回升"
而是"模型对那里一无所知,于是返回了它的默认认知(全局平均)"
   ↓
数据区末尾的预测(cycle=1440 → 0.8411)比全局平均(0.9091)低
   ↓
所以从 0.8411 走到 0.9091,看起来像"回升"
★ 一句话:
那不是"回升",是"从数据拉住的低值,过渡到没有数据时的默认值"。
② 物理上不可能回升该怎么办
三个层次的应对:
层次一:加外推防护(最简单)
if cycle > x_train_max * 1.05:
    return None, "超出数据范围,拒绝预测"
层次二:换一个带单调性约束的模型
GPR 本身不保证单调。想让它单调,需要:
  · 用"单调 GP"(如对输入的导数加符号约束)
· 或者对输出做变换(比如建模"退化量"而不是"健康度"—— 退化量单调递增)一个很实用的技巧:
# 不直接建模 soh,而是建模"退化量" = 1 - soh
# 退化量在物理上单调不减 → 很多模型的输出天然更合理
df["degradation"] = 1 - df["soh"]

# 或者建模"剩余寿命",它单调递减
★ 这个"换个目标变量"的技巧在工程上很常用 —— 把"物理上单调的量"作为预测目标,能让模型的外推行为更合理。
层次三:用领域知识做后处理
mu, sd = gpr.predict(...)
mu = np.minimum.accumulate(mu)     # 强制单调不增
⚠️ 但后处理会破坏区间的一致性:
你把均值改成了单调的,但 σ 还是原来的
   ↓
"均值 + σ" 的组合可能不再满足覆盖率
   ↓
所以这是个"工程妥协",不是"正确答案"
③ 这说明了模型的什么性质
★ 模型必然带有假设,而假设可能不成立。
线性回归的假设:soh 与 cycle 是直线关系(可以外推)
GPR 的假设    :函数平稳(外推时退回先验)
决策树的假设 :预测是分段常数(外推时给边缘叶子的值)每种假设在外推区的表现都不同:
| 模型 | 外推行为 | 合理吗 |
|---|---|---|
| 线性回归 | 沿直线延伸 | 若关系真是线性的,合理;否则危险 |
| GPR | 退回先验均值 | 若"平稳"成立,合理;若物理要求单调,不合理 |
| 决策树 | 给最边缘叶子的均值 | 恒定值,不会回升也不会下降 |
| 随机森林 | 同决策树(多棵平均) | 同上 |
★ 一个有趣的观察:
决策树/森林在外推区给"常数"(最边缘叶子的均值)
   ↓
这反而比线性回归"更安全" —— 它不会给出越来越离谱的值
   ↓
但它同样没有"我不知道"这个信号
★ 最终结论
没有任何模型能自动保证外推正确。 外推的正确性来自"物理约束 + 领域知识",而不是来自模型选择。
模型的职责是在有数据的区域给出可靠预测; 在没数据的区域,"识别出这一点"是使用者的职责。
这也是为什么这一章花了大量篇幅讲"怎么识别边界",而不是"怎么外推得更好"。
面向工程实践:把"数据范围"做成系统的一等公民
这一章的实用价值在于:它教你怎么在系统里表达"我不知道"。
① 一个常见的生产事故模式
需求:给设备排维护计划,需要"预计什么时候降到 0.80"
   ↓
实现:用模型预测 cycle = 0 到 3000 的 SOH 曲线,找和 0.80 的交点
   ↓
结果:模型在 1440 圈之后开始给"先验值"(0.9091)
      ↓
      曲线在 1440 圈后回升,永远碰不到 0.80
      ↓
      程序算出"预计 0 圈后退役"或直接报错/死循环
★ 事故的根源:程序假设"模型在任何 cycle 都可信"。
② 正确的做法:把数据范围做成"契约"
class ModelContract:
    """模型的使用契约:明确说明它在哪里可信。"""
    def __init__(self, model, feature_ranges: dict, coverage: float | None = None):
        self.model = model
        self.feature_ranges = feature_ranges     # {"cycle": (50, 1440)}
        self.coverage = coverage                 # ±2σ 实测覆盖率

    def predict(self, x: pd.DataFrame):
        # ① 检查每个特征是否在范围内
        for col, (lo, hi) in self.feature_ranges.items():
            if not x[col].between(lo, hi).all():
                out = x.loc[~x[col].between(lo, hi), col].tolist()
                raise ValueError(
                    f"{col} 有值超出训练范围 [{lo}, {hi}]:{out[:5]}\n"
                    f"这属于外推,本模型的输出不可信。"
                )
return self.model.predict(x)用法:
contract = ModelContract(gpr, {"cycle": (50, 1440)}, coverage=0.926)
contract.predict(pd.DataFrame({"cycle": [1200]}))     # ✅ 正常
contract.predict(pd.DataFrame({"cycle": [2000]}))     # ❌ 明确报错
★ 为什么用"报错"而不是"返回 None"
生产系统里,"静默地返回一个不可信的值" 是最危险的
   ↓
抛异常能强制调用方处理(要么捕获并兜底,要么让它崩)
   ↓
而"数据范围"这种约束,一旦违反就【没有任何合理的默认值】
   ↓
所以【报错是正确的设计】
③ 把契约写进模型元数据
import json

metadata = {
    "model_name": "gpr-cycle-soh",
    "trained_at": "2026-10-10",
    "feature_ranges": {"cycle": [50, 1440]},
    "train_rows": 800,
    "metrics": {"r2": 0.830, "coverage_2sigma": 0.926},
    "known_limitations": [
        "超出 cycle 1440 属于外推,不要使用",
        "只用了 cycle 一个特征,未考虑设备个体差异",
        "数据为合成教学数据,方法可迁移但阈值需重标定",
    ],
}
with open("outputs/model_metadata.json", "w", encoding="utf-8") as f:
    json.dump(metadata, f, ensure_ascii=False, indent=2)
★ 这份元数据的作用:
① 部署时能自动校验输入范围(读 feature_ranges)
② 监控时能对比"当时的指标"(读 metrics)
③ 三个月后接手的人知道这个模型的边界在哪(读 known_limitations)
★ 一条可以带走的纪律
模型的"适用边界"和模型的"预测能力"一样重要, 而且它必须被【显式地】写在系统里,不能只留在你脑子里。
第 27 章(阶段目标)产的选型报告会包含这一节 —— 报告里必须有一段"本模型的适用范围与局限"。