第 19 章 · 梯度提升:串行纠错
这一章要解决什么:森林治不了欠拟合(第 17 章那个 0.89407)。 提升(Boosting)是另一条路 —— 它一棵接一棵地学上一轮还差的部分, 所以它能降偏差。但它也带来两个新陷阱: 早停会悄悄吃掉你的"树数",以及**"提升一定比森林准"这个说法在本数据上根本不成立**。
最容易踩的坑:
- 打开早停(sklearn 的提升在样本量 > 10000 时默认就开着)之后去调
max_iter, 结果 600 和 1200 得到完全相同的模型,于是得出结论"树数不重要";- 只报一个"树数",不报学习率 ——
n_estimators和learning_rate必须一起说才有意义;- 以为"更强的算法一定给更高的分" —— 本数据上森林 0.96503、提升 0.96429,打平。
本章你需要完成的代码:demos/ch19-gradient-boosting.py
19.1 一句话说清它和森林的区别
这两条路的差别,可以用一句话概括:
| 随机森林 | 梯度提升 | |
|---|---|---|
| 树与树的关系 | 独立、并行 | 串联、后一棵依赖前一棵 |
| 每棵树学什么 | 直接从数据学 y | 学上一轮的残差(还差多少) |
| 聚合方式 | 预测取平均 | 预测相加(累加) |
| 主要治什么 | 方差 | 偏差 |
| 加树会不会变坏 | 不会(只会饱和) | 会(加多了过拟合) |
| 树的形状 | 深树(无限深也行) | 浅树(通常 max_depth=3~6) |
"串行"这个词是要害:
森林:第 1 棵树和第 200 棵树之间没有任何关系
      → 可以并行种(n_jobs=-1 真的能用上多核)

提升:第 3 棵树必须等第 2 棵树的预测算出来,才知道残差是什么
      → 只能一棵一棵来,天然是串行的
      → 所以提升的训练时间通常比森林长(这一点第 ⑤ 段会量到)
点开:"残差"就是"还差多少",一行代码看懂
假设你要预测 soh,真实值 y。第一步:什么都不学,先猜训练集的均值。
f = np.full(len(y_tr), y_tr.mean())      # 第 0 轮的"模型"
resid = y_tr - f # 残差 = 真实值 - 当前预测真实输出(本数据):
第 0 轮(什么都不学,直接猜训练集均值 0.9087):训练 R² 0.00000 测试 R² -0.00002R² ≈ 0 是对的:R² 的分母就是"用均值预测的误差", 所以"只会猜均值"的模型,R² 定义上就是 0。
第二步:训练一棵小树去拟合"残差"。
h = DecisionTreeRegressor(max_depth=2, random_state=42).fit(X_tr, resid)
f = f + learning_rate * h.predict(X_tr)   # 只走一小步
注意 learning_rate(学习率):它不是"优化技巧", 它是**"我一次只信这棵新树的一部分"**:
learning_rate = 1.0  → 完全相信每棵新树(容易冲过头)
learning_rate = 0.05 → 只走 5% 的一步(慢,但稳)
这就是为什么"树数"和"学习率"必须一起调 —— 它们共同决定"总共走了多远"。
★ 一个关键区别:
决策树:  一步到位(一次分裂就把训练误差往下压)
提升:    分很多小步走(每步只降一点,但方向是"上一轮的残差")
   ↓
小步走的好处:每一步都基于"上一轮真实的错误",
             所以它能把偏差一点点磨掉
19.2 手写 5 轮提升:亲眼看到"残差一轮轮变小"
这一节的代码在 demos/ch19-gradient-boosting.py 的第 ① 段。
做法:起点是训练集均值,然后用 5 棵 max_depth=2 的小树,每棵去拟合上一轮的残差 (学习率 0.3,故意放大一点,让 5 轮之内就能看出效果)。
真实输出:
  第 0 轮(什么都不学,直接猜训练集均值 0.9087):训练 R² 0.00000  测试 R² -0.00002
  第 1 轮:残差 std 0.05487 → 训练 R² 0.45260  测试 R² 0.45281
  第 2 轮:残差 std 0.04059 → 训练 R² 0.68388  测试 R² 0.68174
  第 3 轮:残差 std 0.03085 → 训练 R² 0.80376  测试 R² 0.80145
  第 4 轮:残差 std 0.02431 → 训练 R² 0.86963  测试 R² 0.86696
  第 5 轮:残差 std 0.01981 → 训练 R² 0.90487  测试 R² 0.90093
★ 这张表里有三件事值得看:
① 残差在变小:
0.05487 → 0.04059 → 0.03085 → 0.02431 → 0.01981
   ↓
每加一棵树,"还差多少"就少一点
   ↓
这就是"纠错"的字面意思
② 训练分和测试分几乎一样:
第 3 轮:训练 0.80376 / 测试 0.80145(差 0.00231)
第 5 轮:训练 0.90487 / 测试 0.90093(差 0.00394)
   ↓
和单棵深树(训练 1.00000 / 测试 0.93347)形成鲜明对比
   ↓
【浅树 + 小步走】天然不容易过拟合
③ 5 轮就冲到 0.90,剩下 0.06 花了 295 轮
5 轮   (手写,lr=0.3)   测试 0.90093
300 轮 (HistGB,lr=0.05)测试 0.96429
   ↓
前几轮拿到的是"最容易的那部分",
后面的每一分都越来越贵
★ 一个可以直接对照的直觉:
森林     = 请 200 个独立的人各答一遍,然后取平均
提升     = 请一个人答,然后请第二个人只改"第一个人错的那些题",
           再请第三个人改"前两个人还剩的错"……
   ↓
所以提升是【团队接力】,森林是【独立投票】
19.3 换成 sklearn 的提升:双路兜底写法
这一节的代码在 demos/ch19-gradient-boosting.py 的第 ② 段。
为什么需要"双路兜底":xgboost 不是 sklearn 自带的, 换一台机器可能没装。一个健壮的 demo 不应该因为"没装 xgboost"就跑不起来。
try:
    from xgboost import XGBRegressor as GB
    GB_KW = {"n_estimators": 300, "learning_rate": 0.05, "max_depth": 4}
    GB_NAME = "XGBoost"
except Exception:                                              # ← 关键:兜底
    from sklearn.ensemble import HistGradientBoostingRegressor as GB
    GB_KW = {"max_iter": 300, "learning_rate": 0.05, "max_depth": 4,
             "early_stopping": False}          # ★ HistGB 必须关早停,否则"树数不起作用"
    GB_NAME = "HistGB(替 XGBoost)"
★ 这段代码里有四个知识点,逐个说:
| 写法 | 为什么这么写 |
|---|---|
try / except Exception | 没装 xgboost 时自动退回 sklearn,demo 不炸 |
as GB(同一个别名) | 上层代码只认 GB,两个实现接口统一 |
max_iter 对应 n_estimators | 两家的参数名不同,含义相同(都是"最多几棵树") |
early_stopping=False | sklearn 的 HistGB 默认在样本量 > 10000 时自动开早停 → 你的树数会被悄悄截断 |
真实输出:
提升实现:HistGB(替 XGBoost)  参数 {'max_iter': 300, 'learning_rate': 0.05, 'max_depth': 4, 'early_stopping': False}

=== ② 换成 sklearn 的提升(本项目用双路兜底写法) ===
  HistGB(替 XGBoost) 300 棵(lr=0.05, depth=4):训练 R² 0.97975  测试 R² 0.96429  差距 0.01547
  实际用了几棵树:n_iter_ = 300
★ 和森林对照着看这三个数(森林的数据来自第 17 章):
| 模型 | 训练 R² | 测试 R² | 训练-测试差距 |
|---|---|---|---|
| 随机森林 200 棵 | 0.99838 | 0.96503 | 0.03335 |
| HistGB 300 棵(lr=0.05) | 0.97975 | 0.96429 | 0.01547 |
两件事同时发生:
① 测试分几乎一样:0.96503 vs 0.96429(差 0.00074)
② 但提升的过拟合差距只有森林的一半不到:0.01547 vs 0.03335
   ↓
提升的收益不是"更高的分",是"同样的分、更小的过拟合"
19.4 ★ 陷阱:早停打开时,"树数"根本不是你以为的那个数
这是本章最重要的"看起来对但其实错"。
先看:
真实输出:
=== ③ ★ 陷阱:early_stopping 开着时,「树数」根本不是你以为的那个数 ===
   max_iter |   es=True 用树   es=True 测试R² |   es=False 用树   es=False 测试R²
  --------------------------------------------------------------------------
        100 |          100        0.96162 |           100         0.96172
        300 |          300        0.96423 |           300         0.96429
        600 |          451        0.96432 |           600         0.96383
       1200 |          451        0.96432 |         (见第 ⑤ 段)
★ 盯着最后两行:
es=True 时:
   max_iter=600  → 实际只种了 451 棵 → 测试 0.96432
   max_iter=1200 → 实际只种了 451 棵 → 测试 0.96432   ← 完全一样
这就是"我把树数从 600 调到 1200,分数一点没变"的真正原因:
不是模型饱和了(森林才是饱和)
   ↓
是早停在第 451 棵就喊停了,后面 749 棵【根本没长出来】
   ↓
你改的参数被早停悄悄吃掉了
★ 那早停是好事还是坏事?
| 场景 | 早停 | 理由 |
|---|---|---|
| 调参 / 做实验 | 关掉(early_stopping=False) | 你必须控制"用了几棵树",否则参数名不副实 |
| 上线训练 | 开着 | 它帮你省掉"树数调到几"这件事,还会防止过拟合 |
★ 一个把这个坑变成纪律的写法:
gb.fit(X_tr, y_tr)
print(f"你要的树数 = {gb.max_iter if hasattr(gb, 'max_iter') else gb.n_estimators}")
print(f"实际用的树数 = {gb.n_iter_}")        # ← 每次训练完都打印一下
真实输出(第 ③ 段那段表的最后一列):
es=False 时:max_iter=600 → 实际 600 棵 → 测试 0.96383★ 注意这个 0.96383:它比 300 棵的 0.96429 更低。
森林加树:0.96503(200 棵)→ 0.96510(500 棵)  几乎不动
提升加树:0.96429(300 棵)→ 0.96383(600 棵)  【往下走】
   ↓
这是两条路最重要的行为差别:
森林加树只会"不再变好";提升加树会"变得不好"为什么会"变得不好":因为提升是串行地降偏差, 每加一棵树都在往同一个方向推;推过头了,就开始拟合噪声了。
19.5 learning_rate 与 n_estimators 必须一起调
这一节的代码在 demos/ch19-gradient-boosting.py 的第 ④ 段。
先说结论:
"我的提升模型用了 300 棵树"这句话,单独说是没有意义的。 必须说"300 棵树,学习率 0.05"。
因为这两个参数共同决定"总共走了多远":
总位移 ≈ 学习率 × 树数
   lr=0.05 × 300 棵 = 15
lr=0.30 × 50 棵 = 15 ← 大致同一个量级这不是精确等式(每棵树的大小不同),但它解释了为什么大 lr + 少树和小 lr + 多树 能到达同一片区域。
真实输出(为了不让你等太久,这一段只用训练集的 1/3 来扫;趋势与全量一致):
  lr\n              10          25          50         100         300
  lr=0.05     0.59795     0.86889     0.94752     0.95911     0.96312
  lr=0.1      0.82402     0.94833     0.95799     0.95983     0.96505
  lr=0.3      0.95297     0.95819     0.96137     0.96460     0.96470
  lr=0.5      0.95636     0.96222     0.96431     0.96498     0.96274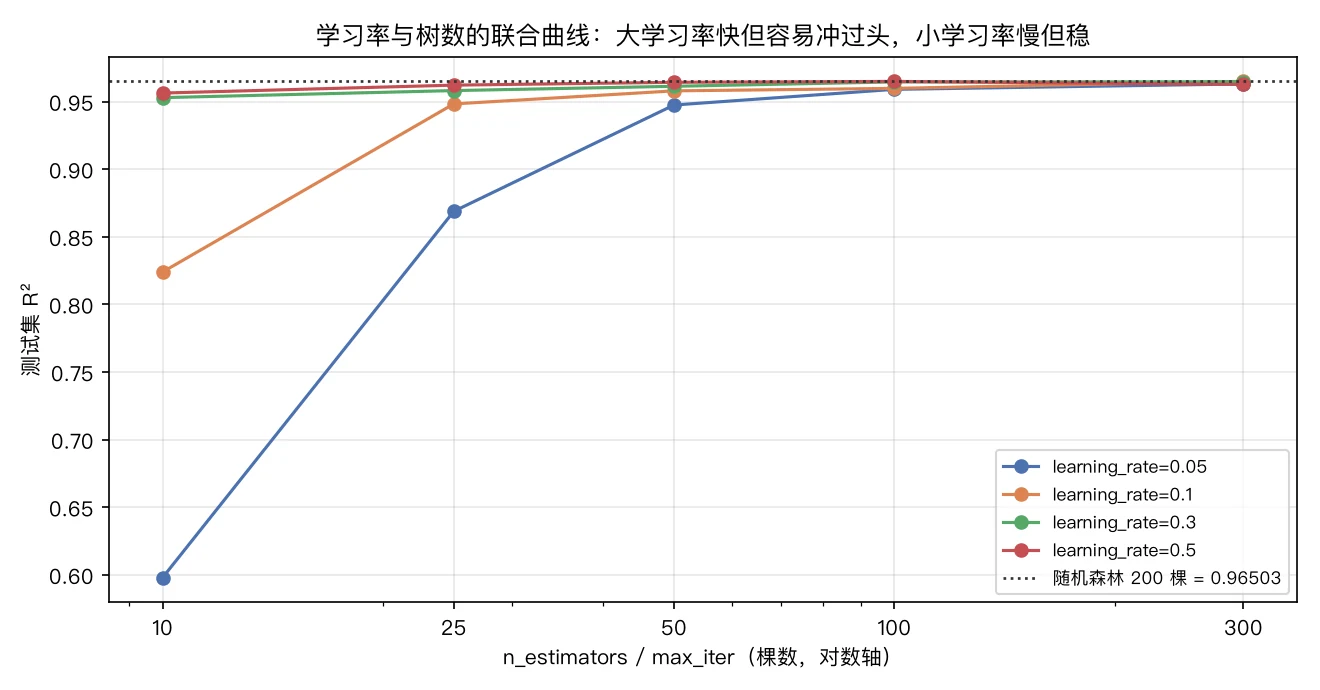
★ 从这张表里要读出三件事:
① 同一个分数可以从多条路到达(表格里"斜着"看)
② 大学习率会"冲过头":
lr=0.5 时,树数一多,测试分反而往下掉
   ↓
因为它每一棵都走一大步,很快就从"欠拟合"走过了"刚好"到达"过拟合"
   ↓
调参经验:学习率越小,需要的树越多,但越不容易翻车
③ 网格搜索必须搜二维,不能一维扫
# ❌ 只扫树数(固定一个随手选的学习率)
for n in (100, 300, 500): ...

# ✅ 两个一起扫
for lr in (0.02, 0.05, 0.1, 0.3):
    for n in (100, 300, 600): ...
★ 一个可操作的起点(表格数据的常见默认值):
| 参数 | 建议起点 | 什么时候动 |
|---|---|---|
learning_rate | 0.05 ~ 0.1 | 想更快收敛 → 调大;看到测试分抖 → 调小 |
n_estimators / max_iter | 300 起 | 关掉早停后按"测试分不再涨"来定 |
max_depth | 3 ~ 6(浅树) | 想要更强表达力 → 加深度,但要盯测试分 |
19.6 ★ "提升一定比森林准"是错的
这一节是本章的反直觉结论,也是全书的转折点之一。
真实输出:
=== ⑤ ★ 森林 vs 提升:本数据上几乎打平 ===
  随机森林 200 棵(无限深)     训练 0.99838  测试 0.96503  差距 0.03335
  HistGB 300 棵 lr=0.05 d=4     训练 0.97975  测试 0.96429  差距 0.01547
  HistGB 300 棵 lr=0.06 d=4     训练 0.98081  测试 0.96394  差距 0.01687
  → 两者测试差 0.00074。在「对没见过的设备」这个问题上,
     「提升一定比森林准」是错的 —— 它们打平了。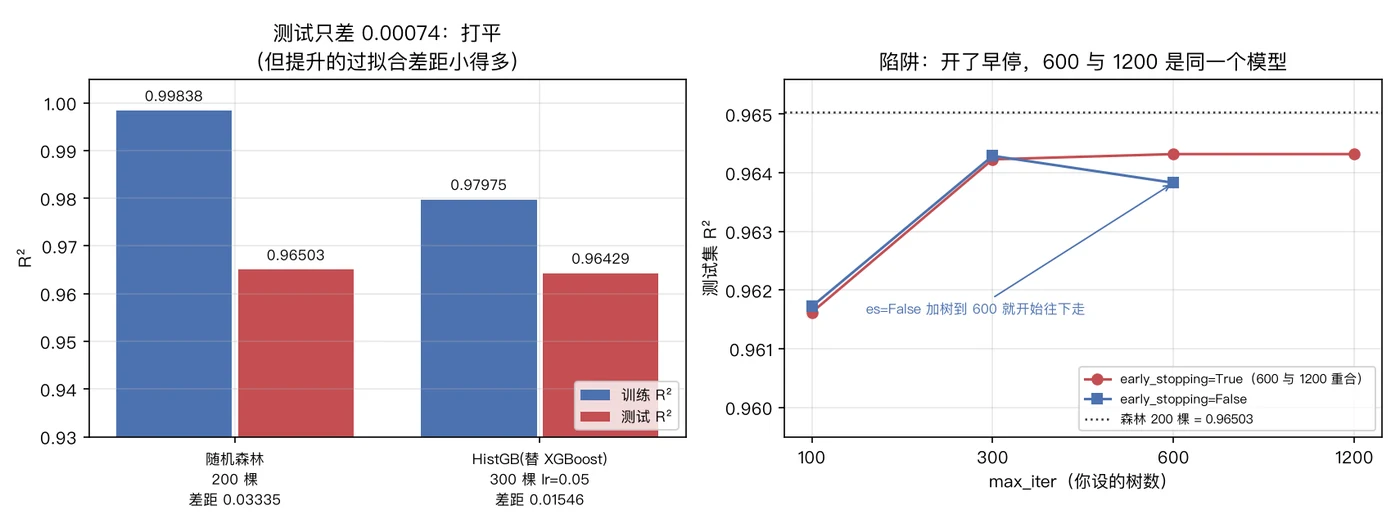
★ 这个结论要小心表述(不然就变成另一个错误的断言):
❌ "提升比森林差"
   → 本数据上差 0.00074,这个量级比随机种子的波动还小,不能这么说

❌ "提升一定比森林准"
   → 本数据上直接被打平,也不能这么说

✅ "在本数据、本特征集、本划分下,两者测试分几乎相同(0.96503 vs 0.96429),
    提升的优势体现在过拟合差距更小(0.03335 → 0.01547)"
★ 换一组参数,结论会翻过来一点点(第 18 章实测的另一组配置):
HistGB 300 棵(learning_rate=0.1、max_depth=3)→ 测试 0.96558
随机森林 200 棵(无限深)                     → 测试 0.96503
   ↓
这一组里提升反而高了 0.00055两组合起来看,才是完整的结论:
在这个数据上,"谁更高"取决于具体参数,差别都在 ±0.001 以内。 能站得住的结论只有一句:这两条路在本数据上打平。
★ 为什么它们会打平?答案在数据里,不在算法里
这份数据的误差有两层(第 04 章讲过):
   ① 每支设备固定的个体偏置(逐圈存在)
   ② 每个窗口一次的测量波动
   ↓
这一层"每个窗口一次的测量波动"是【不可约误差】
   ↓
任何模型都消不掉它
   ↓
所以 R² 在 0.96 附近就封顶了 ——
   谁先撞到天花板,谁就先停下来
★ 这就是全书那句"数据决定上限"的具体形式:
模型换了一轮(线性 → 森林 → 提升),测试分从 0.95053 到 0.96503
   ↓
第一次换(线性 → 森林)涨了 0.0145,值得
第二次换(森林 → 提升)涨了 0.0000,不值
   ↓
卡点不在模型
★ 那提升还有没有用?有,但用法变了:
| 场景 | 选谁 | 理由 |
|---|---|---|
| 想要一个稳的基线 | 森林 | 默认参数就不容易翻车,加树不会变坏 |
| 想要"同样的分、更小的过拟合" | 提升 | 本数据上差距 0.01547 vs 0.03335 |
| 特征几百个、关系复杂 | 提升 | 它的偏差优势在更复杂的问题上才显出来 |
| 数据量很大、要训练快 | 森林(n_jobs=-1) | 并行;提升是串行的 |
★ 最后一个必须记住的数字:
森林 0.96503 vs 提升 0.96429
   ↓
为了让测试分涨 0.0007,你换了整个算法
而学习曲线(第 21 章)显示:
   训练数据从 2,832 行加到 14,160 行,测试分从 0.9474 涨到 0.9581
   8000 行之后就走平了
   ↓
两个方向的收益都要用同一把尺子量:
   "换算法"和"加数据"都已经接近零收益了
   ↓
这就是第 27 章要下的结论
19.7 常见坑
① 开着早停去调 max_iter
   → 600 与 1200 得到完全相同的模型(都是 451 棵),结论"树数没用"是错的

② 只报树数,不报学习率
   → "用了 300 棵树"没有意义,必须说"300 棵 + lr=0.05"

③ 把提升的树设成"越多越好"
   → 300 棵 0.96429 → 600 棵 0.96383,测试分在往下走

④ 忘了 early_stopping=False 就去做参数研究
   → "树数不起作用"这个结论有一半来自参数被截断

⑤ 相信"提升一定比森林准"
   → 本数据 0.96503 vs 0.96429,打平;真正决定上限的是特征 + 噪声

⑥ 拿没关早停的训练耗时去和森林比速度
   → 提升用了 451 棵、森林用了 200 棵,比的是两个不同的模型
★ 其中 ① 和 ④ 是同一个坑的两种表现:
sklearn 的 HistGB 在样本量 > 10000 时默认 early_stopping="auto" → 开
   ↓
你的 max_iter 只是一个【上限】,不是"实际用了多少"
   ↓
不打印 n_iter_,你根本不知道模型里到底有几棵树一个健壮的打印习惯:
gb.fit(X_tr, y_tr)
print(f"设置树数 {gb.max_iter},实际 {gb.n_iter_} 棵,测试 R² {r2_score(y_te, gb.predict(X_te)):.5f}")
19.8 完整示例与输出
cd code
python demos/ch19-gradient-boosting.py真实输出(节选):
==============================================================================
第 19 章 · 梯度提升:串行纠错
==============================================================================
数据:21239 行 / 60 支设备;按设备划分,训练 17244 行 / 48 支,测试 3995 行 / 12 支
提升实现:HistGB(替 XGBoost)  参数 {'max_iter': 300, 'learning_rate': 0.05, 'max_depth': 4, 'early_stopping': False}

=== ① 直觉:残差就是「还差多少」 ===
  第 5 轮:残差 std 0.01981 → 训练 R² 0.90487  测试 R² 0.90093

=== ② 换成 sklearn 的提升(本项目用双路兜底写法) ===
  HistGB(替 XGBoost) 300 棵(lr=0.05, depth=4):训练 R² 0.97975  测试 R² 0.96429  差距 0.01547

=== ③ ★ 陷阱:early_stopping 开着时,「树数」根本不是你以为的那个数 ===
        600 |          451        0.96432 |           600         0.96383
       1200 |          451        0.96432 |         (见第 ⑤ 段)

=== ⑤ ★ 森林 vs 提升:本数据上几乎打平 ===
  随机森林 200 棵(无限深)     训练 0.99838  测试 0.96503  差距 0.03335
  HistGB 300 棵 lr=0.05 d=4     训练 0.97975  测试 0.96429  差距 0.01547
本章练习
练习 1:手写提升,比较两个学习率
自己实现 3 轮提升(不许用 HistGradientBoostingRegressor), 起点是训练集均值,每轮用一棵 max_depth=2 的小树拟合残差:
learning_rate = 0.1,打印每一轮的测试 R²;learning_rate = 0.5,打印每一轮的测试 R²;- 回答:为什么大学习率在前几轮涨得更快?它有什么风险?
参考答案
import numpy as np
import pandas as pd
from sklearn.metrics import r2_score
from sklearn.model_selection import GroupShuffleSplit
from sklearn.tree import DecisionTreeRegressor

FEATS = ["cycle", "mean_charge_voltage_v", "mean_temp_rise_c", "resistance_mohm",
         "coulombic_eff", "cap_fade_rate_ah_per_100", "temp_std_c"]

df = pd.read_csv("data/battery/soh_features.csv")
X, y, groups = df[FEATS], df["soh"], df["cell_id"]
tr, te = next(GroupShuffleSplit(n_splits=1, test_size=0.2,
                                random_state=42).split(X, y, groups=groups))
X_tr, X_te, y_tr, y_te = X.iloc[tr], X.iloc[te], y.iloc[tr], y.iloc[te]

for lr in (0.1, 0.5):
    f_tr = np.full(len(y_tr), y_tr.mean())
    f_te = np.full(len(y_te), y_tr.mean())
    line = []
    for rnd in range(3):
        resid = y_tr - f_tr
        h = DecisionTreeRegressor(max_depth=2, random_state=42).fit(X_tr, resid)
        f_tr = f_tr + lr * h.predict(X_tr)
        f_te = f_te + lr * h.predict(X_te)
        line.append(r2_score(y_te, f_te))
print(f"lr={lr:<4} 3 轮测试 R²:" + " ".join(f"{v:.5f}" for v in line))期望输出:
lr=0.1  3 轮测试 R²:0.16882  0.30571  0.41734
lr=0.5  3 轮测试 R²:0.66524  0.85240  0.90831
第 3 问的回答:
① 大学习率前几轮涨得快,因为每棵树都被完整地采信了一部分:
lr=0.1:第 1 轮只走 10% 的一步 → 测试 0.16882
lr=0.5:第 1 轮走 50% 的一步   → 测试 0.66524
   ↓
同一棵小树,learning_rate 越大,那一步迈得越远
   ↓
同一棵树,learning_rate 越大,那一步迈得越远
② 风险是"冲过头":
小学习率:步子小,走得到但走得慢,可以走到更靠后的位置(更精细)
大学习率:几轮就把"容易的部分"吃完了,之后继续走就会冲到过拟合区
          (第 19.4 段的实测:lr=0.5 时树数一多,测试分反而下降)
★ 一个"两阶段的直觉":
提升的每一轮都在做同一件事:拟合"当前还差的部分"
   ↓
前几轮拟合的是"大头"(谁都能拟合,所以大 lr 涨得快)
后几轮拟合的是"边角"(需要小步慢走)
   ↓
所以实践里的选择是:小学习率 + 多棵树(用时间换精度)
★ 和 demo 里手写的那 5 轮对一下(demo 用 lr=0.3)
本题 lr=0.5(3 轮):0.66524 → 0.85240 → 0.90831
demo lr=0.3(5 轮):0.45281 → 0.68174 → 0.80145 → 0.86696 → 0.90093
   ↓
lr=0.5 的【前 3 轮】就已经超过了 lr=0.3 的【前 5 轮】(0.90831 vs 0.90093)
   ↓
同一个"走了多远",大学习率用更少的树就能达到
⚠️ 但别把这条推成"大学习率更好":
本题只跑了 3 轮,两个 lr 都还在"往上走"的阶段
   ↓
继续加轮数,lr=0.5 会先到顶、然后往下掉(过拟合)
而 lr=0.3 还能再走一段
   ↓
第 19.5 段的网格(lr=0.5 在 300 棵时掉到 0.96274)就是这个现象
★ 一句话:
学习率和树数共同决定"总位移"。 想知道谁更好,必须把两个参数放在一起扫(19.5 段)。
练习 2:把早停陷阱钉死
对 max_iter ∈ {200, 600, 1200},分别用 early_stopping=True 和 False 训练, 打印「实际用了几棵树」和「测试 R²」。然后回答:
- 哪几行的结果是完全相同的?为什么?
- 如果我想研究"树数对分数的影响",应该用哪一组设置?
- 上线训练时,你会用哪一组设置?
参考答案
import pandas as pd
from sklearn.ensemble import HistGradientBoostingRegressor
from sklearn.metrics import r2_score
from sklearn.model_selection import GroupShuffleSplit

FEATS = ["cycle", "mean_charge_voltage_v", "mean_temp_rise_c", "resistance_mohm",
         "coulombic_eff", "cap_fade_rate_ah_per_100", "temp_std_c"]

df = pd.read_csv("data/battery/soh_features.csv")
X, y, groups = df[FEATS], df["soh"], df["cell_id"]
tr, te = next(GroupShuffleSplit(n_splits=1, test_size=0.2,
                                random_state=42).split(X, y, groups=groups))
X_tr, X_te, y_tr, y_te = X.iloc[tr], X.iloc[te], y.iloc[tr], y.iloc[te]

for n in (200, 600, 1200):
    m_on = HistGradientBoostingRegressor(max_iter=n, learning_rate=0.05, max_depth=4,
                                         early_stopping=True, random_state=42)
    m_on.fit(X_tr, y_tr)
    m_off = HistGradientBoostingRegressor(max_iter=n, learning_rate=0.05, max_depth=4,
                                          early_stopping=False, random_state=42)
    m_off.fit(X_tr, y_tr)
    print(f"max_iter={n:>5}  es=True: {m_on.n_iter_:>4} 棵  "
          f"测试 {r2_score(y_te, m_on.predict(X_te)):.5f}  |  "
          f"es=False: {m_off.n_iter_:>4} 棵  "
f"测试 {r2_score(y_te, m_off.predict(X_te)):.5f}")期望输出:
max_iter=  200  es=True:  200 棵  测试 0.96358  |  es=False:  200 棵  测试 0.96370
max_iter=  600  es=True:  451 棵  测试 0.96432  |  es=False:  600 棵  测试 0.96383
max_iter= 1200 es=True: 451 棵 测试 0.96432 | es=False: 1200 棵 测试 0.96176三个回答:
① es=True 的 600 与 1200 完全相同(都是 451 棵,0.96432)。
早停在第 451 棵触发(内部验证集连续 10 轮没有改善)
   ↓
max_iter 只是【上限】;600 和 1200 都超过 451,所以结果一样
② 研究树数的影响 → 必须 early_stopping=False。
③ 上线训练 → 用 early_stopping=True。
| 场景 | 设置 | 理由 |
|---|---|---|
| 做实验 / 写报告 | False | 参数名和实际行为一致,可复现 |
| 上线 | True | 省掉调树数这件事,还顺便防过拟合 |
★ 附带收获:es=False 时 1200 棵掉到 0.96176
300 棵 0.96429 → 600 棵 0.96383 → 1200 棵 0.96176
   ↓
这就是"提升加树会变坏"的完整证据链
   ↓
对比森林:200 棵 0.96503 → 500 棵 0.96510(几乎不动,不会变坏)
★ 一条报告纪律:
❌ "我们用了 1200 棵树的提升模型"(如果开着早停,实际只有 451 棵)
✅ "max_iter 设 1200、early_stopping=True,实际收敛于 451 棵;
    若关掉早停,同样设 1200 棵会过拟合到 0.96176"
第二种写法多了两行字,但它把"参数"和"实际发生了什么"分清了 —— 这就是第 19.4 节那个坑的完整答案。
练习 3:森林 vs 提升,用同一把尺子量
训练两个模型(同一份划分、同一套特征):
- 随机森林 200 棵(无限深);
- HistGB 300 棵(
learning_rate=0.05、max_depth=4、early_stopping=False)。
打印每个模型的训练 R²、测试 R²、差距,以及两者的测试分差。然后回答: "提升比森林准"这句话在本数据上成立吗?如果不成立,该怎么说?
参考答案
import pandas as pd
from sklearn.ensemble import HistGradientBoostingRegressor, RandomForestRegressor
from sklearn.metrics import r2_score
from sklearn.model_selection import GroupShuffleSplit

FEATS = ["cycle", "mean_charge_voltage_v", "mean_temp_rise_c", "resistance_mohm",
         "coulombic_eff", "cap_fade_rate_ah_per_100", "temp_std_c"]

df = pd.read_csv("data/battery/soh_features.csv")
X, y, groups = df[FEATS], df["soh"], df["cell_id"]
tr, te = next(GroupShuffleSplit(n_splits=1, test_size=0.2,
                                random_state=42).split(X, y, groups=groups))
X_tr, X_te, y_tr, y_te = X.iloc[tr], X.iloc[te], y.iloc[tr], y.iloc[te]

models = {
    "随机森林 200 棵": RandomForestRegressor(n_estimators=200, random_state=42, n_jobs=-1),
    "HistGB 300 棵": HistGradientBoostingRegressor(max_iter=300, learning_rate=0.05,
                                                   max_depth=4, early_stopping=False,
                                                   random_state=42),
}
out = {}
for name, m in models.items():
    m.fit(X_tr, y_tr)
    a, b = r2_score(y_tr, m.predict(X_tr)), r2_score(y_te, m.predict(X_te))
    out[name] = (a, b)
    print(f"{name:<18s} 训练 {a:.5f}  测试 {b:.5f}  差距 {a - b:.5f}")
ra, rb = out["随机森林 200 棵"]
ga, gb = out["HistGB 300 棵"]
print(f"测试分差 {abs(rb - gb):.5f};过拟合差距差 {abs((ra - rb) - (ga - gb)):.5f}")期望输出:
随机森林 200 棵     训练 0.99838  测试 0.96503  差距 0.03335
HistGB 300 棵       训练 0.97975  测试 0.96429  差距 0.01547
测试分差 0.00074;过拟合差距差 0.01788
第 3 问的回答:
不成立。 在本数据上:
森林 0.96503 vs 提升 0.96429,测试分差 0.00074
   ↓
这个差比"换一个随机种子"带来的波动(第 17 章量到单棵树极差 0.00282)还小
   ↓
说"提升更准"是过度解读该怎么说:
在本数据、本特征集、本划分下,随机森林与梯度提升的测试 R² 几乎相同 (0.96503 vs 0.96429,差 0.00074)。 提升的优势不体现在分数上,而体现在过拟合更小: 训练-测试差距 0.01547(森林 0.03335),少了 0.01788。
这说明在本数据上,"换算法"这条路的收益已经接近零, 瓶颈在特征与不可约噪声(第 27 章的结论)。
★ 一个值得记住的"边际收益递减"图景:
线性回归  0.95053
   ↓ 换模型(+0.01450)   ← 值得
随机森林  0.96503
   ↓ 换模型(+0.00000)   ← 不值得
梯度提升  0.96429
   ↓ 换模型(?)
下一本书:特征工程
★ 最后一条提醒:别把这一题当成"提升没用"
本数据 17k 行、7 个特征、关系近似线性 —— 是提升【最没有优势】的场景
   ↓
换成"特征几百个、关系高度非线性、样本几十万"的问题
提升的偏差优势会明显得多
   ↓
结论永远是带条件的:
   "在这个数据上打平" ≠ "提升永远不行"
面向工程实践:什么时候真的该上提升
① 先问三个问题,再决定要不要换算法
① 我的森林是不是已经和线性模型差不了多少?
     是 → 卡点在特征,换提升也没用(本数据就是这样)
     否 → 关系确实非线性,提升值得试

② 我的训练-测试差距大不大?
     大(> 0.03)→ 提升的"低过拟合"特性会有用
     小           → 提升的优势体现不出来

③ 我能不能接受"训练是串行的"?
     不能(要求几分钟内重训完)→ 森林/线性
     能                        → 提升
② 提升在生产上的三个真实代价
| 代价 | 表现 | 应对 |
|---|---|---|
| 训练是串行的 | 加核没用,n_jobs 帮不上 | 用 hist 类实现(sklearn 的 HistGB / LightGBM) |
| 参数多且互相耦合 | lr × 树数 × 深度 一起调 | 先定 lr,再定树数,最后微调深度 |
| 早停会改变"实际模型" | 报告里的树数和实际不符 | 训练后打印 n_iter_,写进模型卡 |
★ 关于 n_jobs 那一条,值得展开:
森林:n_jobs=-1 有效(树与树独立)
  真实输出:n_jobs=1 → 77.85s,n_jobs=-1 → 7.82s(第 17 章实测,约 10 倍)

提升:树与树串联,n_jobs=-1 基本无效
  它并行的是"特征分箱"和"直方图统计"(hist 实现的优势所在)
③ 一个"该停下来"的信号
你在做的事                    测试分的增量
─────────────────────────────────────────
把森林从 200 棵加到 500 棵      +0.00007
把森林换成提升                  +0.00000
把学习率从 0.05 调到 0.06       -0.00035
加一万行训练数据(第 21 章)    +0.01070(2,832 行 → 14,160 行)
─────────────────────────────────────────
                                        ↑
                        当换算法已经比加数据还便宜不动分数时,
                        说明该去改特征了
★ 这就是第 27 章要正式下的结论。第 19 章的任务是让你亲眼看到"换算法"这条路的尽头在哪里。