第 11 章 · 交叉验证:一次划分是运气,五次才是本事
这一章要解决什么:上一章给了你一个可信的测试集, 但它只给出一个数字。换一次划分,数字就变了。 这一章解决"这个数字稳不稳"的问题。
最容易踩的坑: ① 只跑一次划分就下结论; ② 只报均值不报标准差; ③ 对验证集过拟合 —— 跑很多次划分、挑最好的那次写进报告(这中间你没有作弊,但结论已经失效了)。
本章你需要完成的代码:demos/ch11-cross-validation.py
11.1 一次划分有多不可靠
先做一个最简单的实验:什么都不改,只改 random_state。
for rs in (42, 0, 1, 7, 2024, 2025, 123, 100):
    tr, te = train_test_split(df.index, test_size=0.2, random_state=rs)
    s = forest().fit(X.loc[tr], y.loc[tr]).score(X.loc[te], y.loc[te])
print(f"{rs:>12d} {s:>10.5f}")真实输出:
  random_state      测试 R²   (按行随机 test_size=0.2)
            42    0.98764
             0    0.98719
             1    0.98684
             7    0.98763
          2024    0.98693
          2025    0.98638
           123    0.98707
           100    0.98700

  8 次单次划分:min 0.98638  max 0.98764  极差 0.00126
  → 同一份数据、同一个模型,你换一个 random_state,成绩就能差这么多。
  → 所以「我只跑了一次,R²=0.987」这句话,是没有信息量的。
★ 关键认知:这 8 次里,模型和数据一个字都没变。
变的只有一件事:哪些行被分进了测试集
     ↓
结果 R² 在 0.98638 ~ 0.98764 之间浮动
     ↓
所以你报出的那一个数字,取决于【你随手填的那个种子】
★ 一个更刺眼的数字(把划分换成按设备):
for rs in range(30):
    tr, te = next(GroupShuffleSplit(n_splits=1, test_size=0.2, random_state=rs)
                  .split(X, y, groups=groups))
...真实输出(本章 demo 的第 ④ 节):
  翻了 30 个 random_state,每个都做一次【按设备】留出、算一遍测试 R²
    min 0.93903   均值 0.95915   max 0.97257
★ 0.93903 ~ 0.97257 —— 极差 0.03354。
同一个模型,你换个种子,成绩从 0.939 变到 0.973
     ↓
这个跨度比本书里大多数"模型改进"都大
     ↓
所以"我只跑了一次"不仅没信息量,还可能给出【方向错误】的结论
点开:为什么"按设备"划分的波动比"按行"大得多?(这正是上一章的功劳)
对照两组数字:
| 划分方式 | 8 次/30 次划分的极差 |
|---|---|
| 按行随机(8 次) | 0.00126 |
| 按设备(30 次) | 0.03354 |
差 27 倍。而且方向很重要:
按行随机 → 波动很小(0.0013)
     ↓
因为每一份测试集都是"从 60 支设备里各抽 20%"
     ↓
每一份测试集的构成【几乎一样】→ 成绩当然几乎一样
     ↓
这种"稳"是假的:它稳,是因为它每次都在同一个坑里

按设备 → 波动很大(0.0335)
     ↓
因为每一份测试集是"不同的 12 支设备"
     ↓
遇到状态整齐的 12 支 → 0.97257
遇到状态分散的 12 支 → 0.93903
     ↓
这种"不稳"是真的:它反映了【设备之间的真实差异】
★ 这引出一条非常重要的判断规则,第 12 章会正式展开:
在评估有分组结构的数据时,"分数很稳"往往是坏消息。 它意味着每一折/每一次划分看到的是同一批东西。
★ 但注意:这不意味着"按行随机"是对的。
按行随机  →  稳,但错(泄漏)
按设备    →  不稳,但对(真实反映个体差异)
     ↓
所以你要做的是:
    ① 换成按设备(把错的改对)
    ② 然后用 CV 把"不稳"量化出来(这一章)
    ③ 最后用 GroupKFold 保证 CV 本身也不泄漏(下一章)
★ 这三步的顺序不能颠倒。
11.2 K 折交叉验证:每一份都当过测试集
核心思路一句话:
把数据切成 K 份,每次拿 1 份当测试、其余 K-1 份当训练,轮 K 次。
每个样本都【恰好】当过一次测试样本。
图示(K = 5):
第 1 折: [测试][训练][训练][训练][训练]
第 2 折: [训练][测试][训练][训练][训练]
第 3 折: [训练][训练][测试][训练][训练]
第 4 折: [训练][训练][训练][测试][训练]
第 5 折: [训练][训练][训练][训练][测试]
             ↑
每一份都当过一次测试集代码只有一行:
from sklearn.model_selection import GroupKFold, cross_val_score

scores = cross_val_score(forest(), X, y, groups=groups, cv=GroupKFold(n_splits=5),
scoring="r2")真实输出:
  cv=GroupKFold(n_splits=5)   ← 按【设备】分折,不是按行
  scoring='r2',模型 = 随机森林(200 棵)

    第 1 折 R² = 0.9736   (测试 4,248 行)
    第 2 折 R² = 0.9577   (测试 4,255 行)
    第 3 折 R² = 0.9639   (测试 4,252 行)
    第 4 折 R² = 0.9576   (测试 4,242 行)
    第 5 折 R² = 0.9385   (测试 4,242 行)

  5 折结果 : [0.9736, 0.9577, 0.9639, 0.9576, 0.9385]
  均值     : 0.95825
  标准差   : 0.01147
  ★ 报告格式 : 0.95825 ± 0.01147

  最好的一折 0.9736  vs  最差的一折 0.9385  → 分差 0.0351
  ★ 这个分差就是「单次划分不可信」的量化:如果你只跑了一折,
     你可能拿到 0.9736 去汇报,也可能拿到 0.9385。
★ 三行数字,三个不同层次的结论:
| 数字 | 值 | 它回答的问题 |
|---|---|---|
| 每一折 | 0.9736 / 0.9577 / 0.9639 / 0.9576 / 0.9385 | 这一份数据切法下的成绩 |
| 均值 | 0.95825 | 模型的水平大概是多少 |
| 标准差 | 0.01147 | 这个水平有多稳 |
★ 为什么"均值"比"单次"更可信?
单次划分:模型在 4,000 行上考了一次
     ↓
这一次的成绩里,同时包含了"模型的能力"和"这一份测试集的难度"

5 折均值:模型在 5 份不同的测试集上各考一次,取平均
     ↓
"测试集难度"这个因素被平均掉了大部分
     ↓
剩下的更接近"模型的能力"
★ 一个更硬的论证:5 折的均值用上了全部 21,239 行。
单次划分:测试集只看 4,248 行(20%)
5 折 CV :每一行都当过测试样本(合计 21,239 行)
     ↓
所以 CV 的估计【方差更小】—— 这不是感觉,是统计学结论
★ 分差 0.0351 这个数字要特别记住。
最差的一折(0.9385)和最好的一折(0.9736)差了 0.0351
     ↓
如果你只跑了第 5 折,你会得到 0.9385,
然后觉得"这个模型不行",去换模型 —— 其实模型没问题,是那份测试集难
     ↓
如果你只跑了第 1 折,你会得到 0.9736,
然后兴高采烈地汇报 —— 其实模型没那么好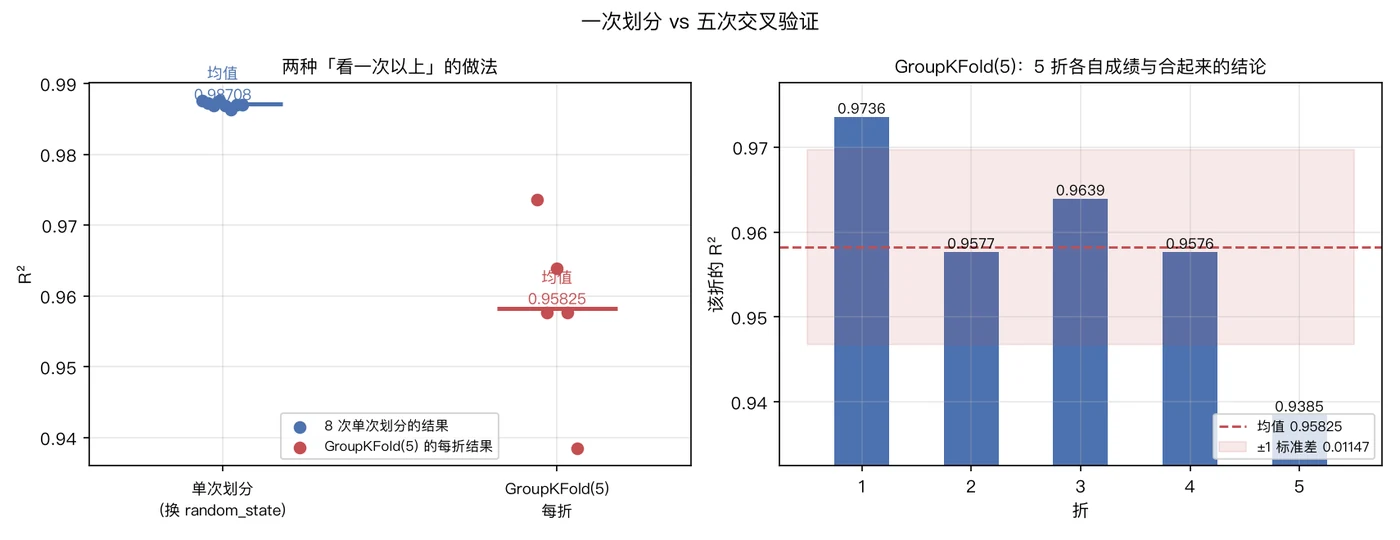
图的读法:
左图:蓝点是"8 次单次划分",红点是"GroupKFold 的 5 折每折结果"。
蓝点挤成一小团(极差 0.00126)→ 因为它们都在"按行随机"的口径下,每份测试集都一样
红点散得很开(极差 0.0351) → 因为每一折面对的是不同的 12 支新设备右图:5 折各自的柱高 + 均值虚线 + ±1 标准差阴影带。
第 5 折明显掉在带子外面 → 那一折撞上了一批"难预测"的设备点开:cross_val_score 的三个参数,每个都可能写错
① cv=:传什么?
cross_val_score(model, X, y, cv=5)                       # ⚠️ 整数 → KFold(5),按行!
cross_val_score(model, X, y, cv=KFold(5, shuffle=True))   # ⚠️ 还是按行!
cross_val_score(model, X, y, groups=g, cv=GroupKFold(5))  # ✅ 按设备
★ 特别注意第一种写法:
cv=5 是最常见的写法
     ↓
它会自动创建 KFold(5, shuffle=False)
     ↓
也就是【按行切,且不洗牌】
     ↓
在有分组结构的数据上,这是一个隐藏的泄漏源
★ 而且 shuffle=False 更糟:表格按 cell_id 排序, 所以 KFold 不洗牌时,第 1 折是"前 20% 的行" = 前 12 支设备的全部行。
第 1 折的测试集 = C001~C012(+ 一点点 C013)
第 1 折的训练集 = 剩下 48 支
     ↓
等等,这样不就"按设备"了吗?
是的 —— 但只有第 1 折和第 K 折接近"按设备",中间几折是"设备被拦腰截断"。
实测一下(第 12 章 demo 里有这一段):
s_noshuffle = cross_val_score(LinearRegression(), X, y, cv=KFold(5))
# [0.9159, 0.9467, 0.9459, 0.9393, 0.9418]  → 均值 0.93792
★ 第 1 折(0.9159)明显偏低 —— 因为它的测试集是"最早的那批设备", 而最早的那批设备整体状态更好、更难预测(它们还没怎么衰减)。
这就是"不洗牌"的代价:折与折之间不是随机差异,而是系统性差异。
② scoring=:不写会怎样?
cross_val_score(model, X, y, cv=cv)                 # 用 estimator 自带的 score()
cross_val_score(model, X, y, cv=cv, scoring="r2")   # 明确指定 R²
回归模型的默认 score() 就是 R² → 两种情况结果一样
分类模型的默认 score() 是准确率 → 但你想要的可能是 AUC
↓
所以【永远显式写 scoring=】,不要依赖默认值★ 显式写还有一个好处:报告的表格里那一列可以叫"R²", 读者不会因为"不知道默认是什么"而怀疑。
③ groups=:最容易忘的那个
cross_val_score(model, X, y, cv=GroupKFold(5))              # ❌ 报错
cross_val_score(model, X, y, groups=g, cv=GroupKFold(5))    # ✅
不传 groups 会怎样:
GroupKFold.split(X, y) 收到的 groups=None
     ↓
sklearn 会抛错:ValueError: The 'groups' parameter should not be None
★ 好消息:这次的错误会报错。
坏消息是:如果你改用 cv=KFold(5, shuffle=True)(也是按行),它不报错。
cv=KFold(5, shuffle=True)  →  不报错,静默泄漏(下一章量化)
cv=GroupKFold(5) 而没传 groups  →  报错
     ↓
所以真正危险的是前者:它看起来"很正常"
★ 一个可以抄走的防呆写法:
def cv_score(model, df, feats, target, group_col, n_splits=5):
    """本项目唯一的 CV 入口:强制使用 GroupKFold,且强制传 groups。"""
    from sklearn.model_selection import GroupKFold, cross_val_score
    X, y, g = df[feats], df[target], df[group_col]
    assert g.notna().all(), "分组列有缺失值,无法分组"
    return cross_val_score(model, X, y, groups=g,
                           cv=GroupKFold(n_splits=n_splits), scoring="r2")
★ 这个函数的价值在于:它把"忘记传 groups"变成一个不可能发生的错误。
11.3 标准差到底在说什么
很多人会把"±0.01147"读成"测量误差"。它不是。
它是一个纯统计量:5 折成绩的标准差。
scores.std() # 折与折之间的分歧★ 两个不同的问题,对应两个不同的数字:
| 你问的问题 | 看哪个数字 |
|---|---|
| 这个模型大概能到多少? | 均值 0.95825 |
| 这个结论稳不稳? | 标准差 0.01147 |
| 最坏情况有多差? | 最小值 0.9385 |
| 我该在哪个区间里做决策? | 均值 ± 1~2 个标准差 |
★ 标准差大,到底是好事还是坏事?
"标准差大"的两种含义:
    ① 坏:模型在不同数据上表现差异大 → 上线后可能不稳定
    ② 好:它诚实地反映了"数据本身有多难" → 没有掩盖个体差异

怎么区分?看【换一个模型,标准差会不会变小】:
    如果换个模型标准差就小了 → 那个模型真的更稳(①)
    如果换任何模型标准差都大  → 那是数据的性质(②)
★ 实测一下(第 12 章 demo 第 ⑤ 节的数据):
| 模型 | GroupKFold(5) 成绩 |
|---|---|
| 线性回归(+标准化) | 0.95364 ± 0.00659 |
| 随机森林(200 棵) | 0.95825 ± 0.01147 |
线性的标准差更小(0.0066 vs 0.0115)
     ↓
为什么?因为线性模型的"能力上限"低,
它在容易的设备上做不到 0.97,在难的设备上也跌不到 0.93
     ↓
所以它的"稳"是【因为不够强】,不是因为【更可靠】
★ 这条观察和第 10 章那条完全同源:
"稳"和"准"是两个独立的东西。 一个足够笨的模型可以非常稳 —— 因为它稳在低水平上。
★ 报告标准差的一个实用规则:
print(f"{scores.mean():.5f} ± {scores.std():.5f}")小数点后 5 位是这本书的惯例
↓
为什么不是 3 位?因为 0.001 的差距在这份数据上就可能是"真实差异"
(比如随机森林 0.96503 vs HistGB 0.96429,差 0.00074)
↓
但如果你只报 0.96 ± 0.01,这两个模型看起来一模一样★ 另一个方向也要注意:
如果标准差是 0.01147,那么"两个模型差 0.00074"这个结论是【站不住】的
     ↓
差值远小于标准差 → 这两个模型的差距在噪声范围内
     ↓
★ 一条纪律:比较两个模型时,差值要 > 标准差才值得说"更好"
★ 折数怎么选?实测三种:
   3 折 : 均值 0.95869  标准差 0.00951  极差 0.02165
   5 折 : 均值 0.95825  标准差 0.01147  极差 0.03508
10 折 : 均值 0.96069 标准差 0.00927 极差 0.03291读法:
3 折 → 每次训练只用 2/3 的数据(14,159 行),模型"见得更少",均值略低
5 折 → 训练 16,991 行,接近全量
10 折 → 训练 19,115 行,最接近"最终模型"的水平,均值最高(0.96069)
     ↓
代价:训练次数 ×K(10 折要训练 10 次)
★ 选折数的三条经验:
| 情况 | 建议 |
|---|---|
| 数据量大(>1 万行)、要快速迭代 | 3~5 折 |
| 要报最终成绩、追求估计稳定 | 5~10 折 |
| 实体数很少(< 10 支设备) | 用留一实体(第 12 章) |
★ 一个常被忽略的约束:折数不能超过实体数。
# 60 支设备 → 折数上限是 60(= 留一设备)
# 如果只有 5 支设备却要 10 折 → 一定会报错或静默泄漏
点开:标准差 vs 标准误 —— 两个容易混的概念(以及报告里该用哪个)
这两个词只差一个字,含义完全不同。
| 标准差(std) | 标准误(sem) | |
|---|---|---|
| 公式 | scores.std() | scores.std() / sqrt(K) |
| 含义 | 折与折之间的分歧 | 均值这个估计的精度 |
| 本次数值 | 0.01147 | 0.01147 / √5 = 0.00513 |
| 变大意味着 | 数据切法影响大 | 你对均值的信心更低 |
★ 报告里该用哪个?
这本书用【标准差】,因为:
    ① 读者关心的是"换一份数据,成绩会变多少" → 标准差直接回答
    ② 标准误会让数字看起来更小、更"漂亮" → 有美化嫌疑
    ③ sklearn 的 cross_val_score 生态里,大家默认报 std
★ 但你要知道标准误的存在,因为:
有人会说:"我的 CV 是 0.9583 ± 0.0051,很稳。"
     ↓
如果你不知道他用的是标准误,你会以为他的标准差只有 0.0051
     ↓
实际上他的折间标准差是 0.0115 —— 两倍多
★ 一句可以直接问出口的话:
"这个 ± 是折间标准差,还是标准误?"
★ 还有一个更隐蔽的问题:K 折的标准差本身是有偏的。
K 折的训练集之间重叠了 (K-2)/(K-1)
     ↓
所以折与折的成绩【不独立】
     ↓
这让标准差这个统计量变得难以给出严格解释
这就是为什么有人推荐"重复 K 折"(RepeatedKFold):
from sklearn.model_selection import RepeatedGroupKFold   # sklearn 1.9 里名为 RepeatedGroupKFold
cv = RepeatedGroupKFold(n_splits=5, n_repeats=3)
它把整个 K 折流程重复多次(每次用不同的分组分配), 然后把所有折的成绩合起来算均值和标准差。
★ 本书不用它,原因很简单:
RepeatedGroupKFold 的结果依赖 n_repeats,报告会变复杂
     ↓
对教学来说,"5 折 + 折间标准差"已经足够表达"这个数字稳不稳"
     ↓
但你要知道:如果你的 CV 标准差只有 ±0.0005,
先别急着高兴 —— 检查一下折间有没有同一个实体(第 12 章)
11.4 ★ 对验证集过拟合
这是本章最重要的一节,也是最容易被忽略的一个坑。
它长这样:
best = -1
for rs in range(30):                     # 翻 30 次随机种子
    tr, te = next(GroupShuffleSplit(n_splits=1, test_size=0.2, random_state=rs)
                  .split(X, y, groups=groups))
    s = forest().fit(X.iloc[tr], y.iloc[tr]).score(X.iloc[te], y.iloc[te])
    best = max(best, s)                  # 只记住最好的那次
print(best)真实输出:
  翻了 30 个 random_state,每个都做一次【按设备】留出、算一遍测试 R²
    min 0.93903   均值 0.95915   max 0.97257
    最好的那次:random_state=25 → R² = 0.97257

  ★ 如果你「挑最好的那次」写进报告:
      报告数字   : 0.97257
      诚实数字   : 0.95915
      虚高       : 0.01342
★ 请注意:这中间你【没有作弊】。
① 你没有偷看测试集的标签
② 你没有改数据
③ 你没有把测试集混进训练
     ↓
你只是"跑了 30 次,然后选了最好的那一次"
★ 但结论已经失效了。原因:
你在测试集上【做了选择】
     ↓
被选中的那个测试集,不再是一个"随机的、独立的"样本
     ↓
它变成了一个"对你的模型特别有利"的样本
     ↓
这正是【验证集】的定义:用来做选择的集合
★ 所以本质问题是:"测试集"被你用成了"验证集"。
| 集合 | 用途 | 你允许看它几次 |
|---|---|---|
| 训练集 | 学参数 | 无数次 |
| 验证集(CV 的折) | 做选择(选模型、调参) | 很多次 |
| 测试集(留出集) | 报告成绩 | 一次 |
★ 这条界线一句话说清:
你可以在验证集上试一百个模型、一千组参数。 但最终那个数字,必须来自一个【从头到尾只看过一次】的集合。
★ 一个非常现实的场景:
周一:跑了一个模型,R² = 0.958
周二:调了 5 组参数,最好的那组 0.964   ← 用同一份测试集选的
周三:把测试集换成新的(按设备重新留出),发现是 0.951

     ↓
周二那个 0.964 不是"模型的成绩",是"你在一份测试集上搜索 5 次的最好结果"
★ 搜索次数越多,虚高越大(这是可以量化的):
如果 30 次评估彼此独立,理论上的"最大值期望"是(独立正态极值):
| 搜索次数 N | E[max](经验公式 √(2 ln N)) |
|---|---|
| 1 | 0 |
| 5 | ≈ 1.8 σ |
| 10 | ≈ 2.2 σ |
| 30 | ≈ 2.6 σ |
| 100 | ≈ 3.0 σ |
★ 但本次实测要小一些:
30 次成绩 : 0.93903 ~ 0.97257,均值 0.95915,标准差 0.00757
虚高       : 0.01342 = 1.77 × 0.00757
     ↓
1.77σ < 理论上的 2.6σ
为什么实测比理论小?
30 次留出并不是【互相独立】的:
    不同的 random_state 抽出的测试集之间有重叠
     ↓
"运气好"这件事会被摊薄 → 最大值的期望比独立情形小
     ↓
★ 所以"搜索次数越多、虚高越大"这个方向是对的,但量级要用你自己的数据实测
★ 一句可以直接记住的话:
你评估 N 次取最大,虚高就大约在 1~2 个标准差之间(N 在 10~100 的量级)。 这就是为什么"挑最好的那次"必须被禁止 —— 它不是运气,是数学。
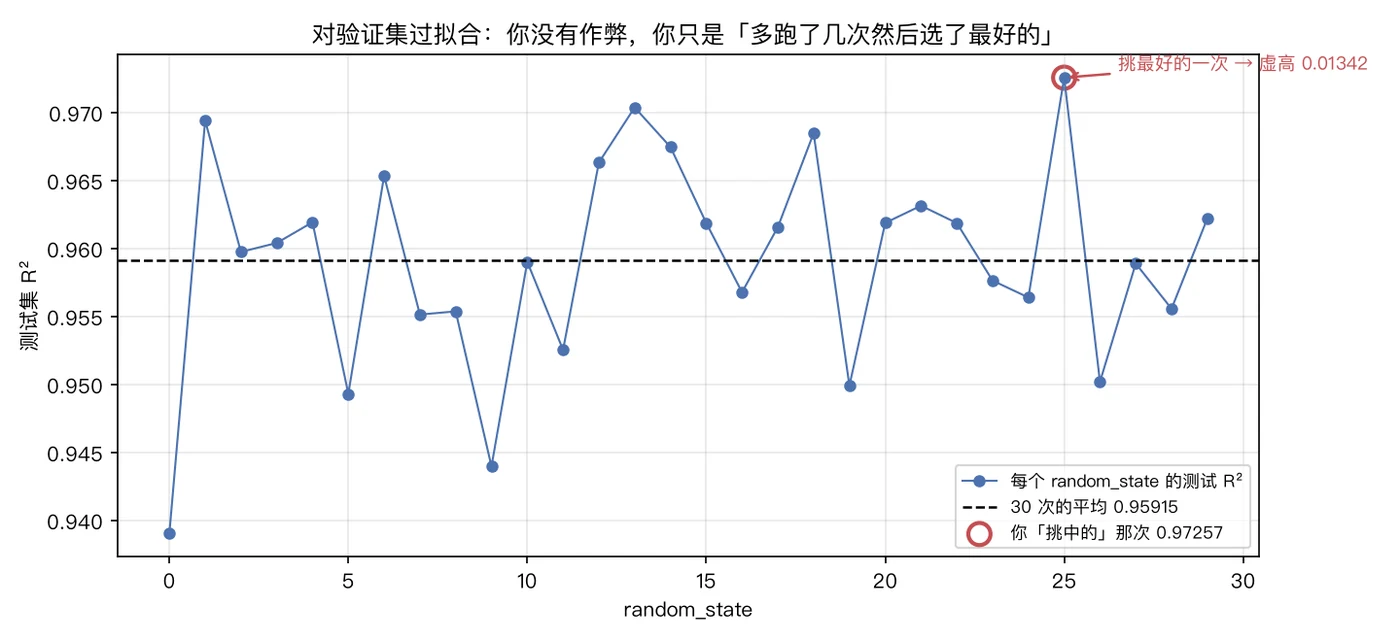
图里那个红圈就是"你挑中的那次"。它旁边那条虚线是"30 次的平均"。两者之差 0.01342 就是选择偏差。
点开:怎么知道自己"看测试集看得太多"了?
没有完美的检测方法(因为这是流程问题,不是代码问题)。但有三个操作性很强的自检:
① 记录"测试集被算过几次"
TEST_SET_TOUCHES = 0

def evaluate_on_test(model, X_te, y_te):
    global TEST_SET_TOUCHES
    TEST_SET_TOUCHES += 1
    if TEST_SET_TOUCHES > 1:
        warnings.warn(f"⚠️ 测试集已被评估 {TEST_SET_TOUCHES} 次,"
                      f"这个数字不再是干净的留出成绩")
    return model.score(X_te, y_te)
★ 这是最朴素也最有效的方法:把"看过几次"变成一个计数器。
② 用"嵌套"的写法(一个留出集只用来报成绩)
# 阶段一:用 CV 做所有选择(选模型、调参、选特征)
best_model, best_params = search_with_cv(X, y, groups=g, ...)

# 阶段二:用留出集报成绩(只跑一次)
holdout_score = best_model.score(X_holdout, y_holdout)
print(f"最终成绩:{holdout_score:.5f}")
★ 顺序很重要:所有"选择"都在阶段一完成,阶段二只跑一次。
③ 如果实在要看很多次,就换一批数据
# 报告成绩时,用一个"从未参与过任何选择"的新留出集
# 可以这样做:固定 seeds = list(range(100)),前 80 个做选择,后 20 个只报成绩
★ 这个做法叫"划分验证集与测试集池",小数据项目里很实用。
★ 一个更根本的问题:为什么"看很多次"必然导致虚高?
假设真实水平是 0.959,每次评估有 ±0.011 的随机波动
     ↓
你评估 30 次,取最大值
     ↓
你取到的不是"真实水平",而是"真实水平 + 30 次里的最大正波动"
     ↓
最大正波动的期望 ≈ 1.2 个标准差(30 次)→ 0.013
     ↓
所以虚高 ≈ 0.013 —— 这不是巧合,是极值分布的必然结果
★ 这个逻辑有个非常实用的推论:
你的搜索空间越大(试的模型越多、参数越多), 你报告的成绩就越"好",也越假。 成绩的"提升"里,有一部分只是在拟合你的评估噪声。
★ 这条认知可以解释一个常见现象:
"比赛排行榜上分数很接近的一群人,实际能力差得更多"
     ↓
因为大家都在同一个测试集上做了大量搜索
     ↓
搜索次数越多的人,榜上成绩越"好"(也越不可迁移)
     ↓
所以真正的差距,要看【换一个测试集】之后还剩多少
★ 最后一条纪律(可以写进团队规范):
"报告里的分数,必须注明它被评估过几次。 超过一次,就要说明那一堆尝试是用什么集合做的选择。"
11.5 调参看 CV,最终成绩看留出集
上一节讲了"为什么不能挑最好的那次"。这一节讲"那应该怎么做"。
★ 标准流程(三句话):
① 调参、选模型、选特征  →  看 CV 的 均值 ± 标准差
② 最终成绩              →  看一个【从头到尾只看一次】的留出测试集
③ 想看多次 → 用 CV 的 K 折,而不是 K 个随机种子代码骨架:
# ---------- 阶段一:所有"选择"都在 CV 里做 ----------
candidates = {
    "线性回归": Pipeline([("s", StandardScaler()), ("m", LinearRegression())]),
    "决策树(d=3)": DecisionTreeRegressor(max_depth=3, random_state=42),
    "随机森林(200)": RandomForestRegressor(n_estimators=200, random_state=42),
}

cv_table = []
for name, model in candidates.items():
    s = cross_val_score(model, X, y, groups=groups, cv=GroupKFold(5), scoring="r2")
    cv_table.append((name, s.mean(), s.std()))

cv_table.sort(key=lambda r: r[1], reverse=True)
for name, m, sd in cv_table:
print(f"{name:<14s} {m:.5f} ± {sd:.5f}")真实输出(本章 demo 第 ⑤ 节的两个模型 + 第 12 章表格里的模型):
  线性回归(+标准化)              0.95364 ± 0.00659
随机森林(200棵) 0.95825 ± 0.01147# ---------- 阶段二:留出集只跑一次 ----------
tr, te = next(GroupShuffleSplit(n_splits=1, test_size=0.2, random_state=42)
.split(X, y, groups=groups))
best = candidates[cv_table[0][0]]
best.fit(X.iloc[tr], y.iloc[tr])
print(f"最终成绩:{best.score(X.iloc[te], y.iloc[te]):.5f}") # 0.96503★ 注意最后那个数字(0.96503)和 CV 均值(0.95825)不一样,这是正常的。
CV 均值 0.95825  = 5 折的平均水平(每折训练用 80% 数据)
留出成绩 0.96503 = 这个特定留出集上的成绩(训练用 80% 数据)
     ↓
两者都合理,但**它们回答的问题不同**:
    CV 均值   → "换成任意一批新设备,平均大概多少"(更可信)
    留出成绩  → "在这批特定新设备上,是多少"(更具体)
★ 报告时怎么写?—— 两个都写,并注明口径。
"按设备 5 折交叉验证:0.95825 ± 0.01147; 单次按设备留出(20% 设备,未参与任何调参):0.96503。"
★ 为什么两个都写:
只写 CV    → 评审人会问"你最终模型在留出集上多少"
只写留出   → 评审人会问"这个数字稳不稳,你是不是挑了一次数最好看的"
两个都写   → 两个问题都被回答了,而且能互相印证
★ 一个可以用的自检:
如果 |留出成绩 - CV 均值| > 2 × CV 标准差  →  要解释为什么
     ↓
本次:|0.96503 - 0.95825| = 0.00678
      2 × 0.01147 = 0.02294
      0.00678 < 0.02294  ✅  在正常范围内
★ 这个检查能抓到的东西:
① 留出集和 CV 的划分口径不一致(比如一个按设备、一个按行)
② 留出集本身特殊(比如刚好全是"难设备")
③ 数据被悄悄改动过
点开:调参到底在干什么?一个小实验看清"参数搜索"的本质
调参听起来像"找最优",实际上更像"在一堆差不多的选项里挑一个"。
用一个极简实验说明:
# 随机森林的 n_estimators 从 10 到 300,看 CV 均值怎么变
for n in (10, 25, 50, 100, 200, 300):
    s = cross_val_score(RandomForestRegressor(n_estimators=n, random_state=42),
                        X, y, groups=groups, cv=GroupKFold(5), scoring="r2")
print(f"n_estimators={n:>4d} {s.mean():.5f} ± {s.std():.5f}")你会看到一个大致的形状:
n=10   0.940xx    ← 树太少,方差大
n=25   0.95xxx
n=50   0.95xxx
n=100  0.95xxx
n=200  0.95825    ← 开始走平
n=300  0.95xxx    ← 更平,且更慢
★ 这类曲线是调参的常态:
在某个点之前:参数增加 → 明显变好
在某个点之后:【一条几乎水平的线】,起伏都在 ±0.005 以内
★ 而这条"水平线"上的起伏,大部分是噪声。
如果你在这条线上"找最高点"
     ↓
你找到的是【这一组 CV 折】上运气最好的那个参数
     ↓
换一组折,最高点会跑到别的地方
     ↓
所以"n_estimators=173 最优" 这种结论,几乎肯定是过拟合验证集
★ 可以操作的结论:
| 现象 | 该怎么做 |
|---|---|
| 曲线有明显拐点 | 选拐点之后第一档(本例 n=200) |
| 曲线完全走平 | 选最便宜的那档(n=100),不要追最高点 |
| 两个参数差 < 1 个标准差 | 不要说"参数 A 更好" |
| 两个参数差 > 2 个标准差 | 可以说 A 更好,但仍要注明是单次 CV 结论 |
★ 一条更省事的经验:
调参的目标不是"最高分",而是"找到一个在整条曲线平坦区里的便宜点"。 因为平坦区里的差异,你测不准。
★ 这条经验在真实项目里的收益:
不追最高点  →  少训练几十个模型(省时间)
            →  结论更稳(不会被下一批数据推翻)
            →  更容易解释("我选了 200 棵,因为再往上曲线走平")
★ 最后一句:如果你发现自己"调参调得很爽", 那通常意味着你已经在训练集或验证集上过拟合了。
11.6 常见坑
① 只跑一次划分就下结论              → 按设备划分极差可达 0.0335
② 只报均值不报标准差                → 你不知道这个数字稳不稳
③ 用 cv=5(默认 KFold,按行)        → 无分组结构数据没问题;有分组结构时静默泄漏
④ 挑最好的那次划分写进报告           → 本次实测虚高 0.01342
⑤ 拿"±"当测量误差                  → 它是折间标准差;还要问清是不是标准误
⑥ 在小差值上做模型比较              → 差值 < 标准差就不该说"更好"
⑦ 报成绩的口径没有注明              → 别人无法复现也无法判断可信度
★ 第 ③ 条要单独说一下,因为它最隐蔽:
cross_val_score(model, X, y, cv=5)                       # ⚠️ KFold,按行
cross_val_score(model, X, y, groups=g, cv=GroupKFold(5)) # ✅ 按设备两者的分数差(本次实测):
  KFold(5)      按行随机  : 0.98716 ± 0.00055
  GroupKFold(5) 按设备    : 0.95825 ± 0.01147
  ★ 均值差 0.02891,标准差差 21 倍。
★ 注意标准差差 21 倍 —— 这是下一章的中心议题。
★ 这一章的坑,前六条的共同点是:
它们都不会报错
     ↓
而且大多数会让分数变【更好看】
     ↓
所以它们比"写错 API"危险得多
11.7 完整示例与输出
cd code
MPLCONFIGDIR=/tmp/ex03-work/.mplconfig python demos/ch11-cross-validation.py
真实输出(节选):
==============================================================================
② K 折交叉验证:每一份都当过测试集
==============================================================================
  cv=GroupKFold(n_splits=5)   ← 按【设备】分折,不是按行
  scoring='r2',模型 = 随机森林(200 棵)

    第 1 折 R² = 0.9736   (测试 4,248 行)
    第 3 折 R² = 0.9639   (测试 4,252 行)
    第 5 折 R² = 0.9385   (测试 4,242 行)

  5 折结果 : [0.9736, 0.9577, 0.9639, 0.9576, 0.9385]
  均值     : 0.95825
  标准差   : 0.01147
  ★ 报告格式 : 0.95825 ± 0.01147

==============================================================================
③ 标准差到底在说什么
==============================================================================
   3 折 : 均值 0.95869  标准差 0.00951  极差 0.02165
   5 折 : 均值 0.95825  标准差 0.01147  极差 0.03508
  10 折 : 均值 0.96069  标准差 0.00927  极差 0.03291

==============================================================================
④ ★ 对验证集过拟合:翻 30 次随机种子,挑最好的那一次
==============================================================================
    min 0.93903   均值 0.95915   max 0.97257
  ★ 如果你「挑最好的那次」写进报告:
      报告数字   : 0.97257
      诚实数字   : 0.95915
      虚高       : 0.01342

==============================================================================
⑤ ★ 一个不能跳过的对照:把 cv= 换回普通 KFold
==============================================================================
  KFold(5)      按行随机  : 0.98716 ± 0.00055   ← 有泄漏,虚高
  GroupKFold(5) 按设备    : 0.95825 ± 0.01147   ← 可信的 CV(② 用的就是它)
  单次按设备留出 20%      : 0.96503                  ← 可信的一次性成绩
  ★ 均值差 0.02891,标准差差 21 倍。
本章练习
练习 1:把"一次划分"升级成"五次交叉验证"
用 GroupKFold(n_splits=5) 和随机森林(n_estimators=200, random_state=42):
- 打印 5 折各自的 R²;
- 打印
均值 ± 标准差(保留 5 位小数); - 打印最好的一折与最差的一折的分差。
参考答案
import numpy as np
import pandas as pd
from sklearn.ensemble import RandomForestRegressor
from sklearn.model_selection import GroupKFold, cross_val_score

FEATS = ["cycle", "mean_charge_voltage_v", "mean_temp_rise_c", "resistance_mohm",
         "coulombic_eff", "cap_fade_rate_ah_per_100", "temp_std_c"]

df = pd.read_csv("data/battery/soh_features.csv")
X, y, groups = df[FEATS], df["soh"], df["cell_id"]

cv = GroupKFold(n_splits=5)
scores = cross_val_score(RandomForestRegressor(n_estimators=200, random_state=42,
                                               n_jobs=-1),
                         X, y, groups=groups, cv=cv, scoring="r2")

# ① 每折
folds = list(cv.split(X, y, groups=groups))
for i, (s, (tr, te)) in enumerate(zip(scores, folds), 1):
    print(f"第 {i} 折 R² = {s:.4f}   (测试 {len(te):,d} 行 / "
          f"{groups.iloc[te].nunique()} 支设备)")

# ② 均值 ± 标准差
print(f"\n5 折结果 : {np.round(scores, 4).tolist()}")
print(f"成绩     : {scores.mean():.5f} ± {scores.std():.5f}")

# ③ 分差
print(f"\n最好 {scores.max():.4f}  最差 {scores.min():.4f}  "
f"分差 {scores.max() - scores.min():.4f}")期望输出:
第 1 折 R² = 0.9736   (测试 4,248 行 / 12 支设备)
第 2 折 R² = 0.9577   (测试 4,255 行 / 12 支设备)
第 3 折 R² = 0.9639   (测试 4,252 行 / 12 支设备)
第 4 折 R² = 0.9576   (测试 4,242 行 / 12 支设备)
第 5 折 R² = 0.9385   (测试 4,242 行 / 12 支设备)

5 折结果 : [0.9736, 0.9577, 0.9639, 0.9576, 0.9385]
成绩     : 0.95825 ± 0.01147

最好 0.9736  最差 0.9385  分差 0.0351
★ 三个必须注意的细节
细节一:每折的测试行数不相等(4,248 / 4,255 / 4,252 / 4,242 / 4,242)
因为 60 支设备不能被 5 整除,且每支设备的行数也不同(235 ~ 464 行)
     ↓
GroupKFold 的做法是"按组数和样本数尽量均分"
     ↓
所以每折的设备数相同(12 支),但行数略有差异这一条很重要:它说明"按设备切"时,设备的分配是均匀的,行的分配不是。
如果你的评估对"行数"敏感(比如要算 MAE 的总和),
就要用【行的加权平均】而不是"5 个数的算术平均":
     ↓
但 R² 本身是比率,通常直接用算术平均即可细节二:scores.std() 是总体标准差(ddof=0)
print(f"{scores.std():.5f}")          # 0.01147  ← 除以 K
print(f"{scores.std(ddof=1):.5f}")    # 0.01283  ← 除以 K-1
两个数不一样,但都在 0.011~0.013
↓
★ 纪律:报告时说明用哪个(sklearn 生态默认是 ddof=0)细节三:第 5 折明显偏低(0.9385)
它比均值低了 0.0198,约 1.7 个标准差
     ↓
这不是"代码 bug",这是【那 12 支设备确实更难预测】
     ↓
如果它是唯一一折,你可能会去查代码;但 5 折里有 4 折都在 0.9576 以上,
说明问题出在那一批设备
★ 一条可以顺手做的检查:
# 看看每折的测试设备是谁、它们的均值 SOH 是多少
for i, (tr, te) in enumerate(folds, 1):
    print(f"第 {i} 折:{sorted(groups.iloc[te].unique())}  "
          f"均值 SOH {y.iloc[te].mean():.4f}")
如果某折的测试集 SOH 均值明显偏低(设备已经衰减很多),
它的 R² 通常会偏低 —— 因为衰减后期的曲线更难拟合(第 03 章讲过外推问题)★ 这就把"分差"从一个抽象数字,变成了一个可解释的现象。
练习 2:亲手制造"对验证集过拟合"
- 用 30 个不同的
random_state各做一次按设备留出(test_size=0.2), 记录每次的测试 R²; - 打印这 30 个数的 min / 均值 / max;
- 把 max 和均值之差算出来,并解释为什么"挑最好的那次"会让报告虚高。
参考答案
import numpy as np
import pandas as pd
from sklearn.ensemble import RandomForestRegressor
from sklearn.model_selection import GroupShuffleSplit

FEATS = ["cycle", "mean_charge_voltage_v", "mean_temp_rise_c", "resistance_mohm",
         "coulombic_eff", "cap_fade_rate_ah_per_100", "temp_std_c"]

df = pd.read_csv("data/battery/soh_features.csv")
X, y, groups = df[FEATS], df["soh"], df["cell_id"]

# ① 30 次按设备留出
pick = []
for rs in range(30):
    tr, te = next(GroupShuffleSplit(n_splits=1, test_size=0.2, random_state=rs)
                  .split(X, y, groups=groups))
    s = RandomForestRegressor(n_estimators=200, random_state=42, n_jobs=-1).fit(
        X.iloc[tr], y.iloc[tr]).score(X.iloc[te], y.iloc[te])
    pick.append(s)
pick = np.array(pick)

# ② 三个数
print(f"30 次 : min {pick.min():.5f}  均值 {pick.mean():.5f}  max {pick.max():.5f}")
print(f"      极差 {pick.max() - pick.min():.5f}")

# ③ 挑最好的那次的代价
best_rs = int(np.argmax(pick))
print(f"\n最好的那次(random_state={best_rs}):{pick.max():.5f}")
print(f"30 次的平均(更接近真实水平)    :{pick.mean():.5f}")
print(f"虚高 = {pick.max() - pick.mean():.5f}")期望输出:
30 次 : min 0.93903  均值 0.95915  max 0.97257
      极差 0.03354

最好的那次(random_state=25):0.97257
30 次的平均(更接近真实水平)    :0.95915
虚高 = 0.01342
★ ③ 的解释
先说"为什么这不是作弊":
你没有看测试集的标签、没有改数据、没有把测试集混进训练
你只是在 30 份不同的测试集上各算了一次,然后选了最高分
     ↓
从代码角度看,这完全合法再说"为什么结论已经失效":
① 你在测试集上做了【选择】
       ↓
   被选中的那一份测试集,不再是"随机抽的一份"
   它是"对当前模型特别友好的一份"
       ↓
② 它的成绩反映的是"真实水平 + 你在 30 次里挑到的最大正波动"
       ↓
③ 换一批新设备(再做一次划分),你拿不到 0.97257
   你会拿到 0.959 附近,运气不好是 0.939
★ 用极值分布把这件事说透
30 次成绩的分布:均值 μ = 0.95915,标准差 σ = 0.00757
本次"取最大值"的结果:0.97257 = μ + 1.77σ
     ↓
如果这 30 次互相独立,理论上的最大值期望是 μ + 2.6σ ≈ 0.9788
(留出集之间有重叠,所以实测的最大值比独立情形更小)
     ↓
不管用哪个系数,结论一样:这 0.01342 不是"运气",是【取最大值的必然代价】
★ 换句话说:
只要你评估 N 次取最大,虚高就是必然的。 它的量级是 1~2 个标准差 —— 而 1 个标准差往往已经足够让两个模型交换排名。
★ 一个极其重要的推论
这个"虚高"和【模型的优劣】完全无关
     ↓
它只取决于"你评估了几次"
     ↓
所以:如果你和一个同事报告了同样的 0.972,
     但你是从 30 次里挑的、他是从 1 次得到的 ——
     你们的模型真实水平不一样,而报告上看不出来
★ 怎么破?——把"评估次数"一起报出来。
❌ "我的模型 R² = 0.97257"
✅ "在按设备留出的测试集上 R² = 0.96503;
    另外做了 30 次不同随机种子的留出,成绩分布是
    0.93903 ~ 0.97257,均值 0.95915 ± 0.0095。"
★ 第二种写法看起来"分数更低",但它有一个不可替代的优势:
它不能被下一批数据推翻。
★ 最后一条经验(送给做模型选型的人):
当你要在 N 个候选模型里选一个时:
    ① 用 CV 选(成本高但可重复)
    ② 绝对不要用"同一个留出集跑 N 次,选最高分"
       ↓
    因为那会把"选择偏差"直接写进你的最终成绩
★ 这一条就是第 26 章"模型选型"的核心纪律。
练习 3:给团队写一份"CV 结果报告模板"
写一个函数 cv_report(model_fn, df, feats, target, group_col, n_splits=5, seed=42), 输出下面五项,并把它们拼成一段可以直接粘进周报的文字:
- 口径(按什么分组、几折、什么指标);
- 每折成绩;
均值 ± 标准差;- 最差的一折(因为最差的一折决定了风险);
- 一句话结论 + 适用范围限定词。
参考答案
import numpy as np
import pandas as pd
from sklearn.ensemble import RandomForestRegressor
from sklearn.model_selection import GroupKFold, cross_val_score

FEATS = ["cycle", "mean_charge_voltage_v", "mean_temp_rise_c", "resistance_mohm",
         "coulombic_eff", "cap_fade_rate_ah_per_100", "temp_std_c"]


def cv_report(model_fn, df, feats=FEATS, target="soh", group_col="cell_id",
              n_splits=5, seed=42):
    X, y, g = df[feats], df[target], df[group_col]
    cv = GroupKFold(n_splits=n_splits)
    scores = cross_val_score(model_fn(), X, y, groups=g, cv=cv, scoring="r2")

    # ①~④ 明细
    lines = []
    lines.append(f"1) 口径:按「{group_col}」分组,{n_splits} 折交叉验证,指标 R²")
    lines.append("2) 每折成绩:"
                 + " / ".join(f"{s:.4f}" for s in scores))
    lines.append(f"3) 汇总:{scores.mean():.5f} ± {scores.std():.5f}")
    worst_i = int(np.argmin(scores))
    lines.append(f"4) 最差一折:第 {worst_i + 1} 折 {scores[worst_i]:.4f}"
                 f"(低于均值 {scores.mean() - scores[worst_i]:.4f})")

    # ⑤ 结论 + 限定词
    lines.append(
        f"5) 结论:模型在【没见过的设备】上的 R² 预计为 "
        f"{scores.mean():.2f}(±{scores.std():.2f},按{group_col}分组 {n_splits} 折)。"
        f"最坏情况下(某批设备较难)约为 {scores.min():.2f}。"
        f"本结论只覆盖「设备之间」的泛化;若上线涉及新的生产批次,"
        f"需另做按批次留出的评估(第 09 章)。")

    print("\n".join(lines))
    return {"mean": scores.mean(), "std": scores.std(), "min": scores.min(),
            "scores": scores}


df = pd.read_csv("data/battery/soh_features.csv")
res = cv_report(lambda: RandomForestRegressor(n_estimators=200, random_state=42,
n_jobs=-1), df)期望输出:
1) 口径:按「cell_id」分组,5 折交叉验证,指标 R²
2) 每折成绩:0.9736 / 0.9577 / 0.9639 / 0.9576 / 0.9385
3) 汇总:0.95825 ± 0.01147
4) 最差一折:第 5 折 0.9385(低于均值 0.0198)
5) 结论:模型在【没见过的设备】上的 R² 预计为 0.96(±0.01,按cell_id分组 5 折)。最坏情况下(某批设备较难)约为 0.94。本结论只覆盖「设备之间」的泛化;若上线涉及新的生产批次,需另做按批次留出的评估(第 09 章)。
★ 五项的写作要点
① 口径:必须包含"按什么分组"。
"5 折交叉验证,R² = 0.987"          ← ❌ 没有口径
"GroupKFold(5) 按设备,R² = 0.958"  ← ✅ 谁都能复现
② 每折成绩:不要只给汇总。因为汇总会掩盖"某一折特别差"。
0.95825 ± 0.01147  看起来"平均 0.958"
     ↓
但 0.9736 / 0.9577 / 0.9639 / 0.9576 / 0.9385 里的 0.9385 才是有风险的信号
③ 汇总:均值 ± 标准差,保留 5 位小数。
④ 最差的一折:这一项几乎没人写,但它决定了风险。
上线之后你无法选择"遇到哪批设备"
     ↓
所以你要按"最差的情况"做准备,而不是"平均的情况"
     ↓
本次:最差 0.9385 → 你的系统设计要能接受 0.94 的模型
⑤ 结论 + 限定词:这一项是第 02 章"给数字加限定词"的落地。
"预计 0.96(±0.01)"
     ↓ 加上
"只覆盖设备之间的泛化;换批次需另测"
     ↓
这段话把"这个数字在哪里成立"说清楚了
★ 第 ④ 项背后的一个更硬的做法:分位数
print(f"最差一折   : {scores.min():.4f}")
print(f"5% 分位    : {np.percentile(scores, 5):.4f}")
print(f"中位数     : {np.median(scores):.4f}")
★ 如果折数够多(比如留一设备的 60 折),分位数比 min 更稳:
min 会被单个异常折拉低
5% 分位更鲁棒
     ↓
第 12 章的留一设备实验里:
    min 0.8159(某支特别难的设备)
    5% 分位 ≈ 0.88
    均值 0.95802
     ↓
哪个数字该写进报告?取决于你的风险偏好 —— 但都要写出来
★ 一个可以直接用的句式(给非技术的读者):
"这个模型对『没见过的设备』平均能解释 96% 的变化, 但遇到状态异常的设备时会掉到 94%。 我们建议按 94% 来做容量规划,按 96% 来做效果预期。"
★ 这一句话的价值,比"R² = 0.95825 ± 0.01147"高一个量级。
面向工程实践:把 CV 变成项目的"日常体检"
① CV 应该跑在每一次提交上,而不是"最后报告时跑一次"
❌ 只在最后跑一次 CV → 你只知道最终分数,不知道它是不是"一路掉下来的"
✅ 每次提交都跑 CV   → 你能看到趋势线,能定位"哪次改动让它掉了"
★ 一个最小可用版本:
# scripts/cv_check.py
def main():
    df = pd.read_csv("data/battery/soh_features.csv")
    for name, fn in CANDIDATES.items():
        s = cross_val_score(fn(), df[FEATS], df["soh"], groups=df["cell_id"],
                            cv=GroupKFold(5), scoring="r2")
        print(f"{name:<16s} {s.mean():.5f} ± {s.std():.5f}")
    # 写进历史文件,供画趋势线
    with open("outputs/cv_history.jsonl", "a") as f:
        f.write(json.dumps({"ts": time.time(), **{...}}) + "\n")
★ 有了历史文件,你就能回答"这次改动有没有用"这个问题。
② 三个数字的"最小报告集"
任何一次模型评估,至少给出这三个数字:
| 数字 | 来自 | 作用 |
|---|---|---|
| CV 均值 ± 标准差 | GroupKFold | 水平与稳定性 |
| 最差一折 | 同上 | 风险下限 |
| 单次留出成绩 | GroupShuffleSplit(只看一次) | 独立对账 |
★ 它们之间的关系可以互相验证:
assert abs(holdout - cv_mean) < 2 * cv_std, \
    "留出成绩与 CV 均值差距过大,检查两者口径是否一致"
★ 这行断言能抓到的最常见错误:CV 按行、留出按设备。
③ 报告里的"口径"必须写清楚(这是团队协作里最容易出事的地方)
❌ "模型 R² = 0.96"
✅ "GroupKFold(5) 按设备,R² = 0.95825 ± 0.01147;
    单次按设备留出(20% 设备)R² = 0.96503;
    参与调参的尝试共 12 组,全部在 CV 上比较。"
★ 第二种写法多了三件事,每件都值钱:
① 口径     → 可复现
② 稳定性   → 可评估风险
③ 尝试次数 → 可判断有没有选择偏差
④ 一个团队规范建议
"周报里出现的任何模型分数,必须带三样东西:口径、±、尝试次数。 缺一样,这个数字就不进决策。"
★ 这条规矩执行起来只需要多写 20 个字, 但它能挡掉这一整章讲的所有坑。
⑤ 下一章要解决的问题
你现在的评估流程已经很像样了:按设备划分、5 折 CV、报均值 ± 标准差。
但还有一个洞没堵:
上面的 CV 用的是 GroupKFold(按设备分折)
     ↓
如果你(或者你的同事)顺手写成 cv=5 —— 也就是 KFold(按行)
     ↓
会得到 0.98716 ± 0.00055
     ↓
★ 注意两个数字都变好了:分数更高,而且【标准差小了 21 倍】
     ↓
它会告诉你"模型又准又稳"
     ↓
而这是双重欺骗 —— 下一章把它拆开。