第 16 章 · 决策树回归:第一个"非线性"模型
这一章要解决什么:换掉那条直线,用一个完全不同的模型 —— 它不会外推,不关心缩放,给出的预测是阶梯, 而且它第一次让你亲眼看到"训练完美"是怎么变成"测试变差"的。
最容易踩的坑: ① 以为树的输出是连续曲线 —— 它只有几个常数(分段常数); ② 以为"深度越大越好" —— 不限深度时训练 R² = 1.00000、测试 R² 掉到 0.93347; ③ 把
feature_importances_当成"特征在物理上有多重要" —— 它只说"这棵树在它上面切了几刀"。
本章你需要完成的代码:demos/ch16-decision-tree.py
16.1 树在做一件完全不同的事
线性模型和决策树的区别,不是"谁更强",而是"它们怎么描述世界":
| 线性回归 | 决策树 | |
|---|---|---|
| 预测形式 | ŷ = w₁x₁ + … + w₇x₇ + b | 一层层 if / else,落到一个叶子的常数 |
| 输出形状 | 连续的直线/平面 | 阶梯(分段常数) |
| 参数是什么 | 8 个数(系数 + 截距) | 一堆分裂阈值 + 每个叶子的均值 |
| 特征缩放 | 影响数值稳定性(第 15 章) | 完全不影响 |
| 外推 | 会一路延伸下去 | 出了训练范围还是那个常数 |
| 可解释性 | 每个特征的系数 | 每个特征的"切了几刀" |
树的工作方式,一句话:
① 找一个特征和一个阈值,把数据分成两半(让两半的标签尽可能分开)
② 对每一半重复 ①,直到满足停止条件(比如深度到 3)
③ 每个叶子(不再分裂的那一块)的预测值 = 落到这里的训练样本的【平均值】
★ 第 ③ 步是理解"阶梯"的关键:
叶子里的样本 soh 各不相同
    ↓
树不会为它们各给一个预测
    ↓
它给【同一个数字】:这一块的平均值
    ↓
所以每一块的预测是常数 → 图上就是台阶一个生活化的对照:
线性回归:像一条橡皮筋,从数据里穿过去,还能继续拉长
决策树  :像往墙上钉几块水平木板,每块木板高度不同
          → 站到木板范围内,它告诉你木板的高度
          → 站到范围外,它还是告诉你最边上那块木板的高度
16.2 第一个不是直线的模型
真实输出:
=== ① 第一个不是直线的模型 ===
  线性   (cycle)          :训练 R² = 0.83732   测试 R² = 0.82070
  决策树 (cycle, depth=3) :训练 R² = 0.83676   测试 R² = 0.82766   叶子 8 个
  决策树 (7 特征, depth=3):训练 R² = 0.92927   测试 R² = 0.92497   叶子 8 个
→ 同样的 8 个叶子,只看 cycle 就能超过直线;7 个特征再往上抬一档。三个模型,读懂三件事:
① 只用 cycle 时,树(0.82766)比直线(0.82070)略好
直线:一个斜率,从头到尾
树  :8 级台阶
    ↓
台阶能贴合"前期掉得慢、后期掉得快"这种形状,直线不能
    ↓
但只好了 0.007 —— 说明这份数据的曲线形状【本来就接近直线】
② 同样的 8 个叶子,加上 7 个特征后涨到 0.92497
8 个叶子是"表达能力的上限"
    ↓
只看 cycle 时,8 个叶子只能沿一个轴切 8 段
看 7 个特征时,同样 8 个叶子可以在 7 个轴上切
    ↓
0.82766 → 0.92497,涨了 0.097
    ↓
★ 结论:限制树的不只是深度,还有"它能看几个特征"
③ 训练 R²(0.92927)和测试 R²(0.92497)只差 0.0043
depth=3 的树还处在【欠拟合】的一侧
    ↓
它连训练集都没记住,当然也不会过拟合
    ↓
16.5 会看到把这个深度放开之后发生什么
点开:树是怎么选出"第一个问题"的?(不写公式版)
树在每个节点做的事,本质上是一次"最优的一刀"搜索:
对每个特征:
  对每个候选阈值:
    把数据分成两半
    算"两半内部有多纯"(常用方差:两半的加权方差之和)
  记住最好的那一个阈值
在所有特征里,选出"让不纯度下降最多"的那一刀"纯"的意思是:
如果一刀切下去,左边全是 soh≈0.83、右边全是 soh≈0.96
    → 两边都很"纯" → 这一刀很好

如果一刀切下去,左右两边都是 soh 从 0.80 到 1.00 混在一起
    → 两边都不纯 → 这一刀没用
★ 用这个机制解释三个现象:
| 现象 | 原因 |
|---|---|
| 树不需要缩放 | 它只比较"大于/小于阈值",把特征乘以 1000,阈值也跟着变 |
| 树对共线性"不敏感但会独吞" | 两个高相关特征里,先被选中的那个会一直用下去(因为它每次都能降低不纯度) |
| 树容易过拟合 | 只要一直切下去,总能把每个训练样本单独切进一个叶子 |
最后一条就是 16.5 的主题。
16.3 树长什么样:8 个 if-else
树最讨人喜欢的一点:它可以把整个模型打印出来。
真实输出:
=== ② 树长什么样:8 个叶子就是 8 个 if-else ===
        叶子( 2286 行)→ 预测 0.82549   条件:coulombic_eff <= 0.9959 且 coulombic_eff <= 0.9951 且 coulombic_eff <= 0.9947
        叶子( 1825 行)→ 预测 0.84947   条件:coulombic_eff <= 0.9959 且 coulombic_eff <= 0.9951 且 coulombic_eff >  0.9947
        叶子( 2383 行)→ 预测 0.87415   条件:coulombic_eff <= 0.9959 且 coulombic_eff >  0.9951 且 coulombic_eff <= 0.9956
        叶子( 1909 行)→ 预测 0.89885   条件:coulombic_eff <= 0.9959 且 coulombic_eff >  0.9951 且 coulombic_eff >  0.9956
        叶子( 1871 行)→ 预测 0.91983   条件:coulombic_eff >  0.9959 且 coulombic_eff <= 0.9969 且 coulombic_eff <= 0.9963
        叶子( 2325 行)→ 预测 0.94114   条件:coulombic_eff >  0.9959 且 coulombic_eff <= 0.9969 且 coulombic_eff >  0.9963
        叶子( 2207 行)→ 预测 0.98460   条件:coulombic_eff >  0.9959 且 coulombic_eff >  0.9969 且 cycle <= 187.0000
        叶子( 2438 行)→ 预测 0.96447   条件:coulombic_eff >  0.9959 且 coulombic_eff >  0.9969 且 cycle >  187.0000
  注意:这一版 depth=3 的树,7 个特征里只用到 2 个:['cycle', 'coulombic_eff']
★ 把这一堆 if-else 压缩成一句话:
先看 coulombic_eff 落在哪个区间(7 个阈值把它切成 6 段)
其中最高的一段里,再看 cycle 是否超过 187
    ↓
一共 8 个区间 → 8 个常数
这棵树的前两次分裂,全都发生在 coulombic_eff 上:
第 1 刀:coulombic_eff <= 0.9959
第 2 刀(左枝):coulombic_eff <= 0.9951
第 2 刀(右枝):coulombic_eff <= 0.9969
…
第 3 刀才第一次用 cycle(而且只在一个小角落:cycle <= 187)
★ 三个可以直接读出来的事实:
| 事实 | 数字 | 说明 |
|---|---|---|
| 只用了 7 个特征里的 2 个 | ['cycle', 'coulombic_eff'] | 其余 5 个"一刀都没用上" |
| 每刀都切在数据的一小段上 | 0.9947 ~ 0.9969 | 全是 coulombic_eff 的第 3 位小数 |
| 叶子大小都差不多 | 1825 ~ 2438 行 | 没有出现"几个样本一个叶子"的碎片 |
★ 第 2 条值得多想一秒:
coulombic_eff 的全部取值范围:0.9937 ~ 0.9983(全距 0.0046)
树的 7 个阈值却全部落在 0.9947 ~ 0.9969 这 0.0022 的区间里
    ↓
说明【绝大多数训练数据】都挤在这条窄缝里
    ↓
这也解释了为什么它和标签的相关系数高达 0.9683(第 04 章)
    —— 一个取值如此集中的量,本身就像"当前状态的读数"
★ 怎么自己打印这棵树:
tree = DecisionTreeRegressor(max_depth=3, random_state=42).fit(X_train, y_train)

# ① 阈值与结构:tree.tree_ 里有 children_left / feature / threshold / value
# ② 更省事的办法:export_text(纯文本规则)
from sklearn.tree import export_text
print(export_text(tree, feature_names=FEATS, max_depth=3))
16.4 阶梯 vs 直线
这是一张必须亲眼看的图。
真实输出:
=== ③ 阶梯:同一段数据,两种预测形状 ===
  cycle 单特征树:400 个网格点上只有 8 个不同预测值
  7 特征树      :400 个网格点上只有 7 个不同预测值
  线性模型      :400 个网格点上是 400 个不同预测值
  → 树给出的是【几个常数】,不是一条连续曲线。这就是'分段常数'。
  7 特征树在 coulombic_eff 轴上的台阶高度:[0.82549 0.84947 0.87415 0.89885 0.91983 0.94114 0.96447]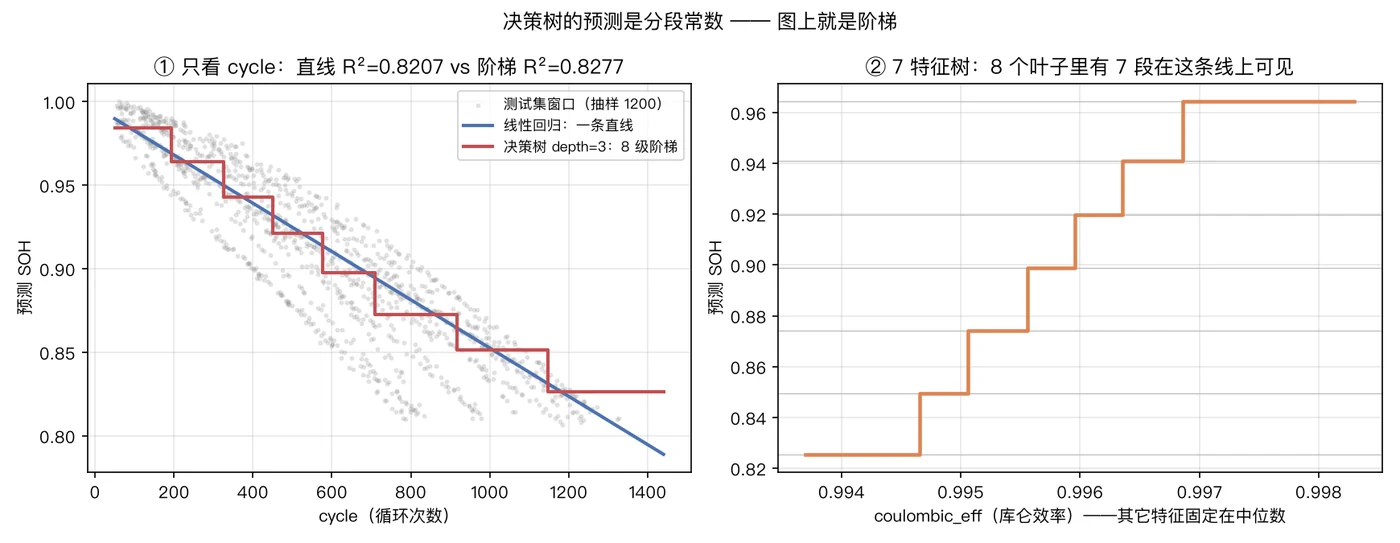
★ 三种模型在同一个网格上的"自由度":
| 模型 | 400 个网格点上的不同预测值 | 含义 |
|---|---|---|
| 线性模型 | 400 | 每个点都可能不同(一条直线) |
| 7 特征树 depth=3 | 7 | 只有 7 个常数 |
| cycle 单特征树 depth=3 | 8 | 只有 8 个常数 |
★ 从图里能读出两件事
① 左边那张图:树是"楼梯",直线是"斜坡"
直线:预测随 cycle 平滑下降
树  :同一个台阶内的所有 cycle,预测完全一样
    ↓
数据里那些"同一台设备相邻窗口 soh 只差 0.0003"的细节(第 03 章)
在树上被抹平成了同一个数
② 右边那张图:7 特征树的台阶是"沿着 coulombic_eff"的
7 个台阶在 coulombic_eff 的 0.9947 ~ 0.9969 之间
    ↓
第 8 个叶子去了哪里?
    ↓
它藏在最右边那一段的【内部】:cycle <= 187 的窗口预测 0.98460,
cycle > 187 的预测 0.96447
    ↓
所以"沿 coulombic_eff 扫一遍"只能看到 7 段,
第 8 段要用 cycle 才能切出来
★ 阶梯带来的两个实际后果
| 后果 | 说明 |
|---|---|
| 同一段里没有分辨力 | 两个 coulombic_eff = 0.99520 和 0.99525 的窗口,预测值完全一样 |
| 不会外推 | 出训练范围后还是边界那个常数(不会像直线那样一路降下去) |
★ 第二条其实是优点:
第 03 章讲过:直线会给出 cycle = 3000 时 soh = 0.5583 这种没有依据的答案
    ↓
树不会:它只会重复见过的某一档常数
    ↓
但代价是:它也无法告诉你"超出范围后趋势会怎样"
★ 树的"阶梯"和"偏差-方差"的关系
台阶越少(深度越小)→ 阶梯越粗 → 偏差大、方差小(欠拟合)
台阶越多(深度越大)→ 阶梯越细 → 偏差小、方差大(过拟合)
    ↓
"选多少个台阶"就是这一章剩下的唯一问题
16.5 ★ max_depth:唯一真正重要的旋钮
真实输出:
=== ④ max_depth:唯一真正重要的旋钮 ===
   max_depth      叶子数      训练 R²      测试 R²        差距
           1        2    0.71398    0.71063  +0.00335
           2        4    0.88745    0.88319  +0.00426
           3        8    0.92927    0.92497  +0.00430
           4       16    0.94607    0.93794  +0.00813
           5       32    0.95573    0.94433  +0.01139
           8      256    0.97268    0.95916  +0.01352
        None    16774    1.00000    0.93347  +0.06653 (不限深度)
  → 深度 1→3:训练和测试一起涨(欠拟合在缓解)
    深度 3→8:训练继续涨,测试涨得慢(开始记噪声)
    不限制深度:训练 1.00000,测试掉头向下 —— 偏差-方差的第一现场(第 18 章)
★ 这张表要分三段读
第一段:深度 1 → 3(欠拟合在缓解)
训练 0.71398 → 0.92927(+0.21529)
测试 0.71063 → 0.92497(+0.21434)
    ↓
两边【同步上涨】,差距几乎不变(+0.00335 → +0.00430)
    ↓
说明:这段时间模型是在学"真规律",不是学噪声
第二段:深度 3 → 8(开始记噪声)
训练 0.92927 → 0.97268(+0.04341)
测试 0.92497 → 0.95916(+0.03419)
差距 +0.00430 → +0.01352(涨了 3 倍)
    ↓
测试集还在涨(这份数据样本多,还能撑住更深的树)
但"训练涨得比测试快"这个信号已经出现了
第三段:不限深度(崩了)
叶子数 16774   ← 训练集有 17,244 行
训练 R² 1.00000
测试 R² 0.93347   (比 depth=8 的 0.95916 差 0.02569)
    ↓
16774 个叶子 / 17244 行 ≈ 每行一个叶子
    ↓
它不是"学会了规律",是"把答案抄下来了"
★ 这是本章最重要的一个"看起来对但其实错":
"把深度调大总没坏处,最差也就是不涨"
    ↓
错。不限深度时测试 R² 掉到 0.93347,
比 depth=8 低 0.02569,也比 depth=5 的 0.94433 低。
    ↓
而且训练 R² 是 1.00000 —— 完美。它完美地背下了训练集。
★ 判断"过拟合开始了"的两个信号:
| 信号 | 本章的数字 |
|---|---|
| 训练 R² 接近 1.0 | 不限深度时 = 1.00000 |
| 训练/测试差距快速扩大 | +0.00430(depth=3)→ +0.06653(不限深度) |
★ 这正好和线性模型的形态相反:
第 13 章的 7 特征线性回归:训练 0.94296 / 测试 0.94253(差 0.00043)
    ↓
参数太少(8 个),学不动,也背不下来
    ↓
第 16 章的树(不限深度):训练 1.00000 / 测试 0.93347(差 0.06653)
    ↓
参数太多(16774 个叶子),学得太细,把噪声也背下来了
    ↓
★ 中间那个"刚刚好"的位置,就是偏差-方差权衡
第 18 章会把这张表画成一条完整的曲线,并给出"怎么找那个位置"的方法。
点开:为什么这份数据上 depth=8 还没过拟合?(一个诚实的补充)
上面的表里,测试 R² 在 depth 1→8 之间一直在涨,没有出现"先涨后跌"的完整弧线。
depth:   1       3       5       8       None
测试 R²: 0.71063 0.92497 0.94433 0.95916 0.93347
↑ 一直涨到这里 ↑ 才崩这说明两件事:
① 这份数据的"噪声地板"不算低,而样本量很大(17,244 行)
17,244 行 / 256 个叶子 ≈ 每个叶子 67 行
    ↓
平均 67 个样本取平均 → 噪声被平均掉很多
    ↓
所以深一点的树还能受益
② 真正的崩溃发生在"每行一个叶子"的那一刻
depth=8:256 个叶子,每个叶子 67 行   → 测试 0.95916  ✅
不限深度:16774 个叶子,每叶子 ≈1 行  → 测试 0.93347  ❌
    ↓
拐点不在"多深",而在"叶子里的样本还够不够平均"
★ 所以不要背"深度越小越好",要背这条:
看训练/测试的差距,而不是看深度本身。 差距开始扩大 = 你已经在为噪声买单。
另外两条实际经验:
| 做法 | 效果 |
|---|---|
用 min_samples_leaf 限制叶子最小样本数 | 比调 max_depth 更直接地"防止每叶子一行" |
| 用随机森林(第 17 章)把很多棵中等深度的树平均 | 同一份数据上测试 R² 能推到 0.96 以上 |
第 17 章会看到:森林解决的不是"单棵树不够深",而是"单棵树太依赖它挑中的那几刀"。
16.6 树不需要缩放
这是第 15 章留下的问题,现在有了答案。
真实输出:
=== ⑤ 树不需要缩放:它只看大小顺序 ===
  原始 vs 标准化:最大预测差 = 0.000e+00   测试 R² 0.92497 vs 0.92497
  → 树在每个特征上只问'大于还是小于某个阈值',把一个特征乘以 1000 不改变顺序,
     所以阈值会跟着变,划分完全一样。这和第 15 章的 KNN 形成对照。
★ 0.000e+00 的意思是"逐点完全相同",不是"差不多":
tree_raw = DecisionTreeRegressor(max_depth=3, random_state=42).fit(X_train, y_train)
sc = StandardScaler().fit(X_train)
tree_std = DecisionTreeRegressor(max_depth=3, random_state=42).fit(sc.transform(X_train), y_train)

np.abs(tree_raw.predict(X_test) - tree_std.predict(sc.transform(X_test))).max()
# 0.0 ← 3995 个测试样本,预测值一个都不差为什么"一模一样"而不是"几乎一样":
树在每个节点问的是:coulombic_eff <= 0.9959 ?
    ↓
把这一列乘以 1000:coulombic_eff_scaled <= 995.9 ?
    ↓
同一个样本,两条判断的结果【完全相同】(只是阈值也乘了 1000)
    ↓
所以分裂结构一样、叶子一样、预测值一样
★ 和 KNN 的对照(同一个划分,实测):
| 模型 | 不缩放 | 标准化 | 差 |
|---|---|---|---|
| 决策树(depth=3) | 0.92497 | 0.92497 | +0.00000 |
| KNN(k=5) | 0.90001 | 0.95504 | +0.05502 |
★ 一条可以直接用在工作里的判断:
这个模型会不会用到特征的【绝对大小】?
    ├─ 会(距离、核、梯度、正则化惩罚)→ 必须缩放
    └─ 不会(只比较大小顺序)          → 不需要缩放
★ 那为什么还有人给树加 scaler?
① 管道统一(Pipeline 里所有模型用同一条流水线)→ 无害,但多一步计算
② 混淆了"树不需要缩放"和"数据不需要清洗"→ 这是两件事
   缺失值、异常值、类别编码,树一样要处理
③ 用 `max_features` 按比例采样特征时,缩放不改变任何东西 → 加了也没用
★ 一个反过来的提醒:
"树不需要缩放"只说明它对【单调变换】不敏感
    ↓
它并不因此更稳健:连续特征上一个微小的扰动,
可能让阈值从 0.9959 挪到 0.9958,整棵树的形状就变了
    ↓
这就是单棵树"不稳定"的来源,也是随机森林存在的理由(第 17 章)
16.7 树天生自带特征重要性
真实输出:
=== ⑥ 树天生自带特征重要性(第 20 章展开)===
  特征                           importance
  coulombic_eff                    0.9903
  cycle                            0.0097
  mean_charge_voltage_v            0.0000
  mean_temp_rise_c                 0.0000
  resistance_mohm                  0.0000
  cap_fade_rate_ah_per_100         0.0000
  temp_std_c                       0.0000
  → depth=3 的树几乎只用 coulombic_eff;'重要'说的是'这棵树用它切了几刀',
     不等于'这个特征在物理上重要'(第 20 章专门讲这个区别)。
★ feature_importances_ 是什么
它统计的是:每个特征带来的"不纯度下降"占全部下降的比例
    ↓
用 16.3 的规则数就明白了:
  coulombic_eff 切了 7 刀    → 0.9903
  cycle         切了 1 刀    → 0.0097
  其余 5 个特征  切了 0 刀    → 0.0000
★ 三个必须知道的限制(第 20 章会专门展开)
| 限制 | 本章的证据 |
|---|---|
| 它只反映"这棵树"的选择,不是数据的性质 | 换一个 random_state,重要性会变(树本身就不稳定) |
| 高相关特征之间会"独吞" | cycle 0.0097 不是因为 cycle 没用,而是因为 coulombic_eff 先切了(13.5 共线性) |
| 它偏向"取值连续的、能切很多刀的特征" | coulombic_eff 的取值有 47 个不同值,正好适合切细刀 |
★ 一个重要的反例(对照第 14 章):
标准化系数排序(第 14 章):coulombic_eff 0.0289 > cycle 0.0133 > …
树的重要性排序(这一章)  :coulombic_eff 0.9903 > cycle 0.0097 > 其余 0
    ↓
两种"重要性"的【相对差距】完全不同:
  系数角度:coulombic_eff 只比 cycle 高 2.17 倍
  树角度  :coulombic_eff 比 cycle 高 102 倍
    ↓
因为它们回答的问题不同:
  系数问:"这个特征动一个标准差,预测动多少?"
  树问  :"这棵树的切分里,它贡献了多少?"
★ 所以正确的说法是:
✅ "在这棵 depth=3 的树里,99.03% 的不纯度下降来自 coulombic_eff"
❌ "coulombic_eff 比其他特征重要 102 倍"
❌ "coulombic_eff 是最重要的物理量"
16.8 常见坑
① 以为树给出连续预测          → 400 个网格点只有 7~8 个不同预测值(阶梯)
② 以为深度越大越好            → 不限深度:训练 1.00000 / 测试 0.93347
③ 用训练 R² 挑深度            → 它总是越深越高(不限深度时 = 1.00000)
④ 给树加 scaler 期待提升      → 逐点预测完全相同(0.000e+00)
⑤ 把 feature_importances_ 当物理结论 → 它只说"切了几刀",高相关特征会独吞
⑥ 忘记录 random_state         → 单棵树每次结果都不一样(不稳定)
⑦ 用树做外推                  → 出训练范围后它只会重复边界那个常数
16.9 完整示例与输出
cd code
python demos/ch16-decision-tree.py
真实输出(节选):
=== ① 第一个不是直线的模型 ===
  线性   (cycle)          :训练 R² = 0.83732   测试 R² = 0.82070
  决策树 (cycle, depth=3) :训练 R² = 0.83676   测试 R² = 0.82766   叶子 8 个
  决策树 (7 特征, depth=3):训练 R² = 0.92927   测试 R² = 0.92497   叶子 8 个

=== ③ 阶梯:同一段数据,两种预测形状 ===
  cycle 单特征树:400 个网格点上只有 8 个不同预测值
  7 特征树      :400 个网格点上只有 7 个不同预测值
  线性模型      :400 个网格点上是 400 个不同预测值

=== ④ max_depth:唯一真正重要的旋钮 ===
           3        8    0.92927    0.92497  +0.00430
           8      256    0.97268    0.95916  +0.01352
        None    16774    1.00000    0.93347  +0.06653 (不限深度)

=== ⑤ 树不需要缩放:它只看大小顺序 ===
  原始 vs 标准化:最大预测差 = 0.000e+00   测试 R² 0.92497 vs 0.92497
本章练习
练习 1:扫一遍 max_depth,找出最好的深度
用 7 个特征、按设备划分(GroupShuffleSplit(test_size=0.2, random_state=42)), 对 max_depth ∈ {1, 2, 3, 4, 5, 8, None} 各拟合一棵 DecisionTreeRegressor(random_state=42):
- 打印叶子数、训练 R²、测试 R²、两者差距;
- 回答:扫过的这些值里哪个最好?
- 回答:"不限深度"那次发生了什么?
参考答案
import pandas as pd
from sklearn.metrics import r2_score
from sklearn.model_selection import GroupShuffleSplit
from sklearn.tree import DecisionTreeRegressor

FEATS = ["cycle", "mean_charge_voltage_v", "mean_temp_rise_c", "resistance_mohm",
         "coulombic_eff", "cap_fade_rate_ah_per_100", "temp_std_c"]

df = pd.read_csv("data/battery/soh_features.csv")
tr, te = next(GroupShuffleSplit(n_splits=1, test_size=0.2, random_state=42)
              .split(df[FEATS], df["soh"], groups=df["cell_id"]))
X_tr, y_tr = df[FEATS].iloc[tr], df["soh"].iloc[tr]
X_te, y_te = df[FEATS].iloc[te], df["soh"].iloc[te]

print(f"{'depth':>6s} {'叶子':>7s} {'训练 R²':>10s} {'测试 R²':>10s} {'差距':>9s}")
for d in (1, 2, 3, 4, 5, 8, None):
    tree = DecisionTreeRegressor(max_depth=d, random_state=42).fit(X_tr, y_tr)
    train_r2 = tree.score(X_tr, y_tr)
    test_r2 = r2_score(y_te, tree.predict(X_te))
    print(f"{str(d):>6s} {tree.get_n_leaves():>7d} {train_r2:>10.5f}"
f" {test_r2:>10.5f} {train_r2 - test_r2:>+9.5f}")期望输出:
 depth      叶子      训练 R²      测试 R²        差距
     1       2    0.71398    0.71063  +0.00335
     2       4    0.88745    0.88319  +0.00426
     3       8    0.92927    0.92497  +0.00430
     4      16    0.94607    0.93794  +0.00813
     5      32    0.95573    0.94433  +0.01139
     8     256    0.97268    0.95916  +0.01352
  None   16774    1.00000    0.93347  +0.06653
② 扫过的值里 max_depth=8 最好(测试 R² = 0.95916)。
★ 但要说得完整一点:
"在扫过的 {1,2,3,4,5,8,None} 里,depth=8 的测试 R² 最高(0.95916)"
    ↓
不能扩展成"最优深度就是 8"
    ↓
因为没扫 6、7、9、10,也没有扫 min_samples_leaf 这类别的限制
这正是第 21~23 章要解决的"怎么选"问题:把搜索过程写清楚,结论只覆盖搜过的范围。
③ "不限深度"那次:训练 R² = 1.00000,测试 R² 掉到 0.93347。
证据链:
叶子数 16774,训练集 17,244 行
    ↓
平均每个叶子 17244 / 16774 ≈ 1.03 行
    ↓
每个叶子几乎就是一个训练样本 → 预测值 = 那一行的 soh
    ↓
训练 R² = 1.00000(完美)
    ↓
但它学到的不是"规律",是"这张表"
    ↓
换 12 支没见过的设备 → 0.93347,比 depth=8 低 0.02569
★ 训练/测试差距这一列是本章最有用的一个数:
| 差距 | 状态 | 该做什么 |
|---|---|---|
| +0.003 ~ +0.004(depth 1~3) | 欠拟合一侧 | 可以继续加深 |
| +0.008 ~ +0.014(depth 4~8) | 接近合适 | 用验证集确认 |
| +0.067(不限深度) | 过拟合 | 必须限制复杂度 |
★ 一条纪律:
别用训练 R² 挑超参数 —— 它永远偏向更复杂的模型(这里是"更深")。 要用没见过的数据挑(验证集或交叉验证,第 11~12 章)。
练习 2:数一数这棵树用了几个特征、切了几刀
用 DecisionTreeRegressor(max_depth=3, random_state=42) 在同一划分上拟合:
- 打印叶子数与用到的特征(
feature_importances_ > 0); - 打印每个特征的 importance;
- 沿
coulombic_eff扫 400 个点(其它特征固定在训练集的中位数), 报出不同预测值的个数与台阶高度; - 打印这棵树用到的全部阈值。
参考答案
import numpy as np
import pandas as pd
from sklearn.model_selection import GroupShuffleSplit
from sklearn.tree import DecisionTreeRegressor

FEATS = ["cycle", "mean_charge_voltage_v", "mean_temp_rise_c", "resistance_mohm",
         "coulombic_eff", "cap_fade_rate_ah_per_100", "temp_std_c"]

df = pd.read_csv("data/battery/soh_features.csv")
tr, _ = next(GroupShuffleSplit(n_splits=1, test_size=0.2, random_state=42)
             .split(df[FEATS], df["soh"], groups=df["cell_id"]))
X_tr, y_tr = df[FEATS].iloc[tr], df["soh"].iloc[tr]

tree = DecisionTreeRegressor(max_depth=3, random_state=42).fit(X_tr, y_tr)
used = [c for c, v in zip(FEATS, tree.feature_importances_) if v > 0]
print(f"叶子数 = {tree.get_n_leaves()}   用到的特征 = {used}")
print("importance: " + "  ".join(f"{c}={v:.4f}"
                                for c, v in zip(FEATS, tree.feature_importances_) if v > 0))

# 沿 coulombic_eff 扫一遍,其它特征固定在中位数
grid = pd.DataFrame({c: np.full(400, X_tr[c].median()) for c in FEATS})
grid["coulombic_eff"] = np.linspace(df["coulombic_eff"].min(), df["coulombic_eff"].max(), 400)
pred = tree.predict(grid)
print(f"沿 coulombic_eff 扫 400 个点,只有 {len(np.unique(np.round(pred, 8)))} 个不同预测值:")
print(f"  {np.unique(np.round(pred, 5))}")

th = tree.tree_.threshold[tree.tree_.feature >= 0]
print(f"阈值:{[round(float(v), 4) for v in np.unique(th)]}")期望输出:
叶子数 = 8   用到的特征 = ['cycle', 'coulombic_eff']
importance: cycle=0.0097  coulombic_eff=0.9903
沿 coulombic_eff 扫 400 个点,只有 7 个不同预测值:
  [0.82549 0.84947 0.87415 0.89885 0.91983 0.94114 0.96447]
阈值:[0.9947, 0.9951, 0.9956, 0.9959, 0.9963, 0.9969, 187.0]
★ 三个可以直接读出来的结论
① 8 个叶子,但沿 coulombic_eff 只能看到 7 个台阶
第 8 个叶子要靠 cycle 才能切出来(cycle <= 187 / cycle > 187)
    ↓
所以"在 coulombic_eff 轴上扫一遍"只看到 7 段
    ↓
同理:在 cycle 轴上扫一遍,你也会漏掉那 6 个 coulombic_eff 台阶
★ 这是一条重要的读图纪律:
树的"阶梯图"只在"它切过的那条轴"上才是完整的。 二维扫一遍、或者固定其它特征,都可能漏掉某些台阶。
② 7 个阈值里的 6 个是 coulombic_eff 的,而且挤在 0.0022 的宽度里
0.9947, 0.9951, 0.9956, 0.9959, 0.9963, 0.9969   ← 6 个 coulombic_eff 阈值
187.0                                            ← 1 个 cycle 阈值
③ 阈值是"数据的分位数",不是"物理的整数"
树不会切在 0.9950 这种"好看的数"上
    ↓
它切在"能让两半最纯"的那一点
    ↓
所以阈值看起来"很随机"(0.9947、0.9956…)——
    它们其实是训练数据在这一维上的分位点
★ 这带来一个实际后果:
换一批训练数据(哪怕只是换个 random_state 划分),
这些阈值就会变,叶子数也可能变
    ↓
单棵树是"不稳定"的模型
    ↓
第 17 章的随机森林就是为这件事设计的
练习 3:证明树不需要缩放(并和第 15 章的 KNN 对照)
- 在同一划分上,用原始特征和标准化后的特征各拟合一棵
max_depth=3的树; - 比较两者在测试集上的逐点预测差与 R²;
- 换成
KNeighborsRegressor(n_neighbors=5)做同样的比较; - 用一句话解释为什么两者结论相反。
参考答案
import numpy as np
import pandas as pd
from sklearn.metrics import r2_score
from sklearn.model_selection import GroupShuffleSplit
from sklearn.neighbors import KNeighborsRegressor
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.tree import DecisionTreeRegressor

FEATS = ["cycle", "mean_charge_voltage_v", "mean_temp_rise_c", "resistance_mohm",
         "coulombic_eff", "cap_fade_rate_ah_per_100", "temp_std_c"]

df = pd.read_csv("data/battery/soh_features.csv")
tr, te = next(GroupShuffleSplit(n_splits=1, test_size=0.2, random_state=42)
              .split(df[FEATS], df["soh"], groups=df["cell_id"]))
X_tr, y_tr = df[FEATS].iloc[tr], df["soh"].iloc[tr]
X_te, y_te = df[FEATS].iloc[te], df["soh"].iloc[te]

sc = StandardScaler().fit(X_tr)
t_raw = DecisionTreeRegressor(max_depth=3, random_state=42).fit(X_tr, y_tr)
t_std = DecisionTreeRegressor(max_depth=3, random_state=42).fit(sc.transform(X_tr), y_tr)
diff = np.abs(t_raw.predict(X_te) - t_std.predict(sc.transform(X_te))).max()
print(f"决策树 最大预测差 = {diff:.3e}   测试 R² "
      f"{r2_score(y_te, t_raw.predict(X_te)):.5f} vs "
      f"{r2_score(y_te, t_std.predict(sc.transform(X_te))):.5f}")

k_raw = KNeighborsRegressor(5).fit(X_tr, y_tr)
k_std = Pipeline([("s", StandardScaler()), ("m", KNeighborsRegressor(5))]).fit(X_tr, y_tr)
print(f"KNN   测试 R² = {r2_score(y_te, k_raw.predict(X_te)):.5f} vs "
f"{r2_score(y_te, k_std.predict(X_te)):.5f}")期望输出:
决策树 最大预测差 = 0.000e+00   测试 R² 0.92497 vs 0.92497
KNN   测试 R² = 0.90001 vs 0.95504
④ 一句话解释
树只比较"大于/小于阈值",缩放是单调变换,把阈值一起乘过去,判断结果不变; KNN 要把各维的差值平方相加,缩放直接改变了"哪一维主导距离",所以结果完全不同。
把两者并排看:
| 决策树 | KNN | |
|---|---|---|
| 用到特征的方式 | 逐维比较阈值 | 所有维的差值的平方和 |
| 对单调变换 | 完全不变 | 变化很大 |
| 最大预测差 / 差值 | 0.000e+00 | 0.90001 → 0.95504(+0.05502) |
| 要不要缩放 | 不需要 | 必须 |
★ 一个容易混的点:
"树不需要缩放" ≠ "树对数据质量不敏感"

树一样会被这些问题伤害:
  · 缺失值(sklearn 的树不支持 NaN,HistGB 才支持)
  · 异常值(一个离群点可能独占一个叶子)
  · 类别的编码方式(one-hot 之后,多值类别会"更容易被选中")
★ 判断表(第 15 章 + 第 16 章合并版):
| 模型 | 缩放 | 依据 |
|---|---|---|
| 线性回归(无正则) | 建议(数值稳定性) | 第 15 章:rank_ 6/7 |
| Ridge / Lasso | 必须 | 惩罚项看系数尺度 |
| KNN / SVM / SVR | 必须 | 距离/核 |
| 神经网络 | 必须 | 梯度尺度 |
| 决策树 / 森林 / 提升 | 不需要 | 只比较大小顺序 |
| 高斯过程 | 必须 | 核的 length_scale 是各向同性距离 |
面向工程实践:什么时候第一选择就是树
① 树(和它的集成)在表格数据上的三个优势
| 优势 | 说明 |
|---|---|
| 不用想缩放 | 少一整类预处理错误(第 15 章那些坑全绕过了) |
| 非线性 + 交互项自动 | 它天然能表达"coulombic_eff 高 且 cycle 小的时候特别健康"这种组合 |
| 对单调变换免疫 | 取对数、开方、换单位都不改变结果(只要单调) |
② 树的三个代价(这一章亲眼看过的)
| 代价 | 数字 |
|---|---|
| 预测是阶梯,段内没有分辨力 | 400 个网格点只有 7~8 个不同预测值 |
| 单棵树不稳定 | 阈值是数据分位点,换一批数据(甚至换 random_state)就变 |
| 不限深度就会背答案 | 训练 1.00000 / 测试 0.93347 |
★ 第 ② 条是"必须知道"的,因为它在工程上意味着:
"模型昨天说 0.9124,今天说 0.9187"
    ↓
对【线性模型】来说这通常意味着数据变了
    ↓
对【单棵树】来说,这可能只是"训练集多了一行、某个阈值挪了 0.0001"造成的
    ↓
→ 单棵树的输出不适合做"逐日对比"的监控指标
③ 一个初始配置的起点(可直接抄)
from sklearn.tree import DecisionTreeRegressor

tree = DecisionTreeRegressor(
    max_depth=4,            # 先从 4 附近开始(本章 3~5 都合理)
    min_samples_leaf=20,    # 比 max_depth 更直接地防止"每叶子一行"
    random_state=42,        # 可复现(单棵树必须固定)
)
★ 为什么给 min_samples_leaf 而不只给 max_depth:
max_depth 限制的是"切的次数"
min_samples_leaf 限制的是"每个叶子里还剩多少样本"
    ↓
真正让模型记住噪声的,是"叶子里只剩一两行"
    ↓
所以 min_samples_leaf 是更对齐问题本质的那个旋钮
④ 一张"选不选树"的判断表
| 你的情况 | 建议 |
|---|---|
| 特征都是数值、量纲差很多、不想做预处理 | 树/森林是省事的起点 |
| 需要"平滑的预测曲线"或"外推趋势" | 树不行(阶梯 + 不外推),用线性/GPR |
| 需要"每个特征有多少影响"的稳定结论 | 单棵树不行(不稳定),用第 20 章的排列重要性 |
| 需要"预测值逐日可比" | 单棵树不适合(阈值微动 → 输出跳变),森林/提升更稳 |
★ 最后一句:
树的价值在于"你几乎不需要为它准备数据",代价是"它给出的答案不连续、不稳定"。 第 17 章会看到:把很多棵树平均起来,正好能治"不稳定"这个病 —— 但治不了"阶梯"。