第 13 章 · 多特征线性回归:从 1 列到 7 列
这一章要解决什么:把
FEATS从["cycle"]换成 7 个特征, 看同一套fit()代码能多拿到多少,以及"多拿到"这件事该怎么量。最容易踩的坑: ① 用百分比说收益,却不说清是哪把尺子 —— 同一对模型可以是 68%、43% 或 36%; ② 以为"加特征一定更好" —— 测试集上不是,未缩放时甚至会在某一列暴跌; ③ 加完 7 列就以为拿到了 7 份信息 —— 其中三个特征在说同一件事。
本章你需要完成的代码:demos/ch13-multi-feature-linear.py
13.1 只改了一个列表
从第 06 章到第 12 章,我们一直用一个特征(cycle)在跑:
FEATS = ["cycle"]
X, y = df[FEATS], df["soh"]
model.fit(X, y)
model.score(X, y)
现在把它换成 7 个:
FEATS = ["cycle", "mean_charge_voltage_v", "mean_temp_rise_c", "resistance_mohm",
         "coulombic_eff", "cap_fade_rate_ah_per_100", "temp_std_c"]
X, y = df[FEATS], df["soh"]
model.fit(X, y)          # ← 这一行没变
model.score(X, y) # ← 这一行也没变真实输出:
整表 shape = (21239, 9),设备 60 支
划分:按设备 GroupShuffleSplit(test_size=0.2, random_state=42)
  训练 17,244 行 / 48 支   测试 3,995 行 / 12 支
  两边设备有交集:False

=== ① 一行代码的差别:FEATS 列表换个长度 ===
  FEATS = 1 列  → X.shape = (21239, 1)
  FEATS = 7 列  → X.shape = (21239, 7)
  下面两个模型,fit / predict / score 的代码一模一样,只有 FEATS 不同。
★ 这就是 scikit-learn 接口统一的价值:
换特征个数   :只改 FEATS 列表
换模型       :只改 LinearRegression() → RandomForestRegressor()
换数据       :只改 df
换预处理     :套一层 Pipeline(第 15 章)

四件事互相独立,代码的"动词"永远是 fit / predict / score。
7 个特征分别是什么:
| 特征 | 量纲 | 含义 |
|---|---|---|
cycle | 次 | 窗口结束时的循环次数 |
mean_charge_voltage_v | V | 窗口内平均充电电压 |
mean_temp_rise_c | ℃ | 窗口内平均温升 |
resistance_mohm | mΩ | 窗口内直流内阻 |
coulombic_eff | — | 库仑效率 |
cap_fade_rate_ah_per_100 | Ah / 100 次 | 容量衰减速率 |
temp_std_c | ℃ | 窗口内温升标准差 |
记住"量纲"这一列 —— 第 14 章整章都在讲它带来的麻烦。
13.2 两行代码,两份结果
真实输出:
=== ② 两种模型:同一套代码,两份结果 ===
  1 列 cycle  训练 R² = 0.83732   测试 R² = 0.82070   MAE = 0.01691   RMSE = 0.02317
  7 列        训练 R² = 0.94296   测试 R² = 0.94253   MAE = 0.01082   RMSE = 0.01312
R² 提升:+0.12183把这张表读成三句话:
| 观察 | 数字 | 说明 |
|---|---|---|
| 测试 R² 涨了 | 0.82070 → 0.94253 | 加 6 个特征确实有用 |
| MAE 降了 | 0.01691 → 0.01082 | 平均偏 1.69 个百分点 → 1.08 个百分点 |
| 训练 ≈ 测试 | 0.94296 vs 0.94253 | 没有过拟合 |
第三句最容易被忽略,但它决定了后面几章的走向:
训练 R² 0.94296,测试 R² 0.94253,差 0.00043
    ↓
这个模型在训练集上"没有背答案"
    ↓
说明瓶颈【不在模型容量】,而在数据里那部分学不到的东西
    (第 10 章讲过的:每行一次的测量波动 + 每支设备固定的偏置)
点开:为什么线性模型的训练/测试差距这么小?
因为线性模型"太笨",笨到背不下训练集。
它只能表达:soh = w₁x₁ + w₂x₂ + … + w₇x₇ + b
    ↓
7 个权重 + 1 个截距 = 8 个参数
    ↓
用 17,244 行数据去定 8 个数 —— 数据多到它想"背"也背不动
    ↓
所以它在训练集上拿到的分数,几乎就是它在任何数据上的水平
对照第 16 章:决策树不限深度时,训练 R² = 1.00000、测试 R² = 0.93347。 那才是"参数多到能背下训练集"的样子。
★ 一条判断纪律:
| 训练/测试差距 | 说明 | 该做什么 |
|---|---|---|
| 很小(< 0.01)且测试分低 | 欠拟合 —— 模型太简单 | 换更强的模型 / 加特征 |
| 很大(> 0.05)且训练分高 | 过拟合 —— 模型太灵活 | 限制复杂度 / 加数据 |
| 都很低 | 数据本身有噪声上限 | 别调模型了,去查数据 |
第 21 章的学习曲线会把这三行变成一张可操作的图。
13.3 ★ 同一个改进,三把尺子量出三个百分比
先看输出:
=== ③ 同一个改进,三把尺子量出三个百分比 ===
  MSE   0.000537 → 0.000172   降  67.9%
  RMSE  0.023168 → 0.013117   降  43.4%
  MAE   0.016912 → 0.010820   降  36.0%
  R²    0.82070 → 0.94253   升 0.12183
→ 说'误差降了 68%'和说'误差降了 36%',用的是同一对模型。这是本章第一个"看起来对但其实错":
✅ "从 1 列换到 7 列,平方误差(MSE)降了 67.9%"
✅ "从 1 列换到 7 列,平均绝对误差(MAE)降了 36.0%"
❌ "从 1 列换到 7 列,误差降了 68%" ← 少了一个词,读者会理解成 MAE 降 68%为什么三个百分比差这么多:
| 指标 | 它放大什么 | 对"大误差"的态度 |
|---|---|---|
| MSE | 误差的平方 | 一个差 0.1 的样本 = 100 个差 0.01 的样本 |
| RMSE | MSE 开根号 | 仍然偏袒大误差,但量纲回到原单位 |
| MAE | 误差的绝对值 | 所有样本一视同仁 |
翻译成人话:
MSE 降 67.9%:说明"大的那些错误"被干掉得更多
MAE 降 36.0%:说明"剩下的那些小错误"还在(每个样本平均还偏 1.08 个百分点)
★ 一条纪律(这本书会一直用):
说百分比的时候,必须说清分母是什么、尺子是哪把。
"误差降了 68%" 不是一句完整的话。 "平方误差降了 67.9%"才是。
点开:为什么"R² 从 0.82 到 0.94"听起来比"MAE 降 36%"更像大进步?
因为 R² 的分母是"用均值预测的平方误差",它也带着平方的偏好。
# 1 列模型的 MSE     = 0.000537
# 用均值预测的 MSE   = ?  ← 这就是 R² 的分母
R² 的定义:
         模型 MSE
R² = 1 - ──────────
均值 MSE反推第一步:0.82070 = 1 - 0.000537 / 均值MSE → 均值 MSE ≈ 0.002995
反推第二步:7 列模型 0.94253 = 1 - 0.000172 / 0.002995 ✓(对得上)
所以那 0.12 的 R² 提升,本质是"残余的平方误差从 18% 降到 5.7%":
0.82070 → 模型消灭了 82.1% 的平方误差,剩 17.9%
0.94253 → 模型消灭了 94.3% 的平方误差,剩 5.7%

剩下的误差:17.9% → 5.7%,确实降了 68%看清楚了吗:那个 68% 和 R² 的 0.12 是同一件事, 而 MAE 的 36% 是另一件事 —— 它问的是"典型样本错了多少",不放大任何东西。
两个都对,只是回答的问题不同。
★ 什么时候用哪把尺子:
| 场景 | 优先看 | 理由 |
|---|---|---|
| 报告"模型好不好" | RMSE / R² | 和大误差较劲,惩罚漏判 |
| 报告"用户会感觉到多差" | MAE | 用户感受到的是平均偏差,不是平方 |
| 比较两个模型的规格 | 三个都报 | 只报一个好听的 = 选择性汇报 |
这本书后面的横评(第 23 章)会三个一起报。
13.4 加特征不是稳赚:收益是怎么递减的
一个自然的想法:既然 1 列 → 7 列涨了 0.12,那 7 列 → 20 列是不是还能涨?
先做一个受控实验:按"和标签的相关系数从大到小"一列一列加进去。
order = df[FEATS].corrwith(df["soh"]).abs().sort_values(ascending=False).index.tolist()真实输出:
=== ④ 一列一列加进去:收益是怎么递减的 ===
  加特征的顺序(按 |r| 从大到小):
    coulombic_eff → cycle → resistance_mohm → mean_charge_voltage_v → temp_std_c → mean_temp_rise_c → cap_fade_rate_ah_per_100

       加到第几列  新增特征                           未缩放 R²     标准化 R²
           1  coulombic_eff                 0.93423    0.93423   (rank 1/1)
           2  cycle                         0.93568    0.93568   (rank 2/2)
           3  resistance_mohm               0.85018    0.93597   (rank 2/3)
           4  mean_charge_voltage_v         0.91964    0.94565   (rank 3/4)
           5  temp_std_c                    0.93636    0.95136   (rank 4/5)
           6  mean_temp_rise_c              0.94311    0.95016   (rank 5/6)
           7  cap_fade_rate_ah_per_100      0.94253    0.95053   (rank 6/7)
  → 第一列(coulombic_eff)单独就拿到 0.93423;后面 6 列加起来只再加 +0.01631。
  → 第 6 列(mean_temp_rise_c):训练 R² 0.95062 → 0.95782(涨),测试 R² 0.95136 → 0.95016(跌 -0.00121)。
  → 未缩放那一列在 k=3 处掉到 0.85018,不是'特征有害',看 rank 列。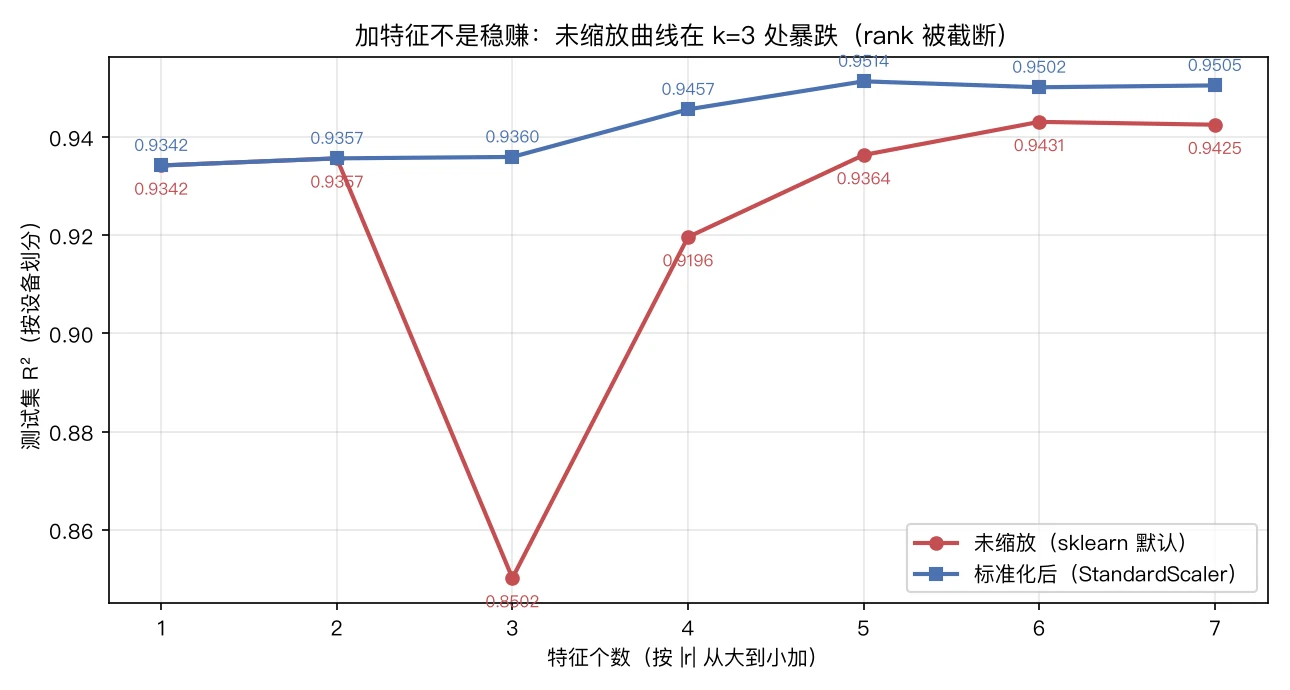
这张表里有三个独立的发现。
发现一:收益递减得非常厉害
第 1 列 coulombic_eff  →  0.93423   ← 一步拿到 98.3% 的最终成绩
后 6 列加起来          →  +0.01631  ← 只剩 1.7%
★ 这不奇怪,但非常重要:
当最强的那一列 |r| = 0.9683 时,
它一个人就解释掉了大部分方差;
剩下的 6 列能补的,是"它没覆盖到的那一小块"。推论:如果一个项目只允许你加 1 个特征,选相关性最强的那个; 但如果你已经有 7 个,再加第 8 个之前,先问它和已有的 7 个相关吗(见 13.5)。
发现二:测试集上,加特征不保证变好
看第 5 → 第 6 步(加 mean_temp_rise_c):
训练 R²:0.95062 → 0.95782   涨了(模型确实用上了这一列)
测试 R²:0.95136 → 0.95016   跌了 -0.00121
★ 这两行必须一起读:
| 训练集 | 测试集 | |
|---|---|---|
| 加特征后 | 数学上不可能变差 | 完全可能变差 |
| 原因 | 新特征 ⊇ 旧特征:最多把新权重设成 0 | 新权重是在训练集上定的,可能只是拟合了噪声 |
所以"训练 R² 涨了"不能作为"这个特征有用"的证据 —— 它是免费的。
能作为证据的只有一个:在没见过的设备上,测试 R² 涨了。
发现三:未缩放那条曲线,有一次莫名其妙的暴跌
未缩放:k=2 是 0.93568,加第 3 列(resistance_mohm)后掉到 0.85018; 标准化后:同一步只是 0.93568 → 0.93597。
同一个特征、同一份数据,两条曲线差了 0.086。 看括号里的 rank:
未缩放:rank 2/3   ← 传进去 3 个特征,求解器只当 2 个用
标准化:rank 3/3
★ 这不是"resistance_mohm 有害",这是数值问题。
第 15 章会用一节的篇幅拆开它(tol=1e-6 的奇异值截断)。 现在只需要记住这条纪律:
在相信一条曲线的形状之前,先看它的
rank_和量纲。 一个"加特征反而变差"的结论,先怀疑是数值问题,再怀疑是统计问题。
点开:如果我只想加一个特征,该选哪个?
三种常见的选法,各有各的坑:
| 选法 | 怎么做 | 坑 |
|---|---|---|
| 按相关性 | corrwith(y).abs().sort_values() | 忽略特征之间的冗余(13.5) |
| 逐步向前 | 每次加一个"让测试分涨最多"的 | 用测试集选特征 = 选择泄漏(第 10 章) |
| 领域知识 | 问"物理上哪个是原因" | 需要真的懂业务 |
★ 第二条是这份数据上最容易犯的错:
# ❌ 用测试集挑特征
best = max(FEATS, key=lambda c: score_on_test(FEATS[:i] + [c]))
# ↑ 你在用测试集做决策,测试集就不再是"没见过的数据"了正确做法:特征选择必须放进交叉验证的每一折内部 (Pipeline + SelectKBest,第 15 章给写法), 或者固定用训练集内部的验证折来选。
第 20 章会用特征重要性把这个话题讲完。
13.5 多重共线性:三个特征在说同一件事
真实输出:
=== ⑤ 多重共线性:三个特征在说同一件事 ===
  相关 r(cycle          , resistance_mohm) = +0.8658
  相关 r(cycle          , coulombic_eff  ) = -0.9264
  相关 r(resistance_mohm, coulombic_eff  ) = -0.8987
  VIF(方差膨胀因子,>5 就该留心,>10 说明系数已经不稳):
    coulombic_eff              VIF =  16.71
    cycle                      VIF =  11.21
    resistance_mohm            VIF =   5.05
    temp_std_c                 VIF =   3.10
    mean_charge_voltage_v      VIF =   2.51
    mean_temp_rise_c           VIF =   2.04
    cap_fade_rate_ah_per_100   VIF =   1.78
什么叫 VIF:
VIF(cycle) = 用其它 6 个特征去预测 cycle 的 R²,再算 1 / (1 - 那个 R²)
= 这个特征"有多少信息是别人已经说过的"读数:
| VIF | 含义 |
|---|---|
| ≈ 1 | 这个特征和别人几乎不重叠 |
| 5 ~ 10 | 开始重叠,系数开始不稳 |
| > 10 | 系数的大小和符号都可能随样本变化 |
这份数据里有三个特征落在 > 10 或接近的位置:coulombic_eff 16.71、cycle 11.21、resistance_mohm 5.05。
为什么这不是"数据坏了",而是"数据本来就是这样":
设备老化 → 库仑效率下降(coulombic_eff 变差)
        → 内阻上升(resistance_mohm 变大)
        → 循环次数增加(cycle 变大)

这三件事【同时发生】,所以它们在统计上必然高度相关。
★ 关键区分:共线性对"预测"和"解释"的伤害完全不同
| 你要做的事 | 共线性有害吗 | 为什么 |
|---|---|---|
| 预测(给一行数据,算 soh) | 基本无害 | 只要未来数据的相关结构与训练时一致,预测照样准(本章测试 R² 0.94253 就是证据) |
| 解释(说"是 cycle 让 soh 下降的") | 严重有害 | 三个特征在抢同一份功劳,系数会乱跳、甚至符号反转 |
符号反转的真实现场(第 14 章细讲,先看数字):
只用 resistance_mohm(单特征):coef = -0.00442195   ← 负号:内阻越大越差 ✓
7 个特征一起(数值可靠解)    :coef = +0.00011642   ← 符号反了 ✗
★ 所以本章的结论要分两层说:
✅ "7 个特征的线性模型,在没见过的设备上 R² = 0.94253"
❌ "从系数看,内阻每升高 1 mΩ,健康度上升 0.0001"

第二句话不是"精度不够",而是"这个系数没有物理意义"。
点开:VIF 怎么算、怎么用(附一段可复制的代码)
手撕 VIF:
import pandas as pd
from sklearn.linear_model import LinearRegression

FEATS = ["cycle", "mean_charge_voltage_v", "mean_temp_rise_c", "resistance_mohm",
         "coulombic_eff", "cap_fade_rate_ah_per_100", "temp_std_c"]

df = pd.read_csv("data/battery/soh_features.csv")

for c in FEATS:
    others = [o for o in FEATS if o != c]
    r2 = LinearRegression().fit(df[others], df[c]).score(df[others], df[c])
print(f"{c:26s} VIF = {1 / (1 - r2):6.2f}")三个必须知道的细节:
① VIF 是"相对于当前这组特征"算的
同一个 cycle,在 7 个特征里的 VIF 是 11.21, 只拿 ["cycle", "resistance_mohm", "coulombic_eff"] 这三列算,是 7.35。
VIF 不是一个特征的固有属性,而是"这组特征里它有多余"的度量。
→ 报表里写 VIF 必须写清"在哪些特征之间算的"。
② 修 VIF 的办法是"删",不是"调参"
删掉共线特征中的一个  → VIF 立刻下降
加正则化(Ridge)      → 系数变稳,但系数的大小不再等于"效应大小"(第 22 章)
加数据                 → 没用:共线性是数据生成过程决定的
③ 树模型"不怕共线性",但它会把功劳随机分给其中一个
# 第 16 章会看到:depth=3 的树把 0.9903 的 importance 全给了 coulombic_eff
# 那 cycle 就只有 0.0097 —— 不是 cycle 不重要,是树"先挑了一个用"
这就是第 20 章"特征重要性也会骗人"的开场。
13.6 同一个划分错误,不同模型看到的不一样
第 09~12 章的核心是"必须按设备划分"。这一节看它在分数上留下的痕迹有多大。
真实输出:
=== ⑥ 同一个划分错误,不同模型看到的不一样 ===
  线性回归           按行随机 = 0.94442   按设备 = 0.94253   虚高 +0.00190
  随机森林(200)      按行随机 = 0.98764   按设备 = 0.96503   虚高 +0.02261
  → 同一个错误(按行随机),线性模型只虚高 0.002,森林虚高 0.023。
     分数看起来正常,不代表划分是对的。
★ 这是本章第二个"看起来对但其实错",而且它比第一个更危险:
你按行随机划分,得到 R² = 0.94442
    ↓
你心想:"0.944 挺正常啊,没有那种 0.99 的离谱分数"
    ↓
你上线了
    ↓
真相:这个 0.944 里有一部分是"记住了同一支设备的邻居"
换成没见过的设备,掉到 0.94253为什么线性模型"看不出"这个错误:
线性模型只能给每个特征一个权重
    ↓
它没法表达"这是第 7 支设备的第 300 行,它上一行 soh = 0.906"
    ↓
所以它"想作弊也作不了大弊" → 虚高只有 0.002
换成随机森林(第 17 章)就完全不同:
森林可以切出很细的规则:"电压在 3.59~3.61 且内阻在 45~47"
    ↓
这几乎就是"某一支设备"的身份证
    ↓
于是它把每支设备的个体偏置(第 10 章讲的第 ① 层误差)记了下来
    ↓
按行随机:0.98764      按设备:0.96503      虚高 0.02261
★ 结论(这条要刻进本能):
"分数看起来正常"永远不能证明划分是对的。 划分对不对,只能靠看代码:
groups=传了吗?测试集里有训练集的设备吗?
一个可复制的体检:
print("两边设备有交集:", bool(set(df.iloc[tr]["cell_id"]) & set(df.iloc[te]["cell_id"])))
# 两边设备有交集:False      ← 必须是 False
13.7 常见坑
① 说"误差降了 68%"不说尺子     → 同一对模型是 68%(MSE) / 43%(RMSE) / 36%(MAE)
② 以为加特征一定更好           → 训练集上必然不差,测试集上 0.95136 → 0.95016
③ 看到"加特征反而变差"就删特征  → 先看 rank_:未缩放时 rank 2/3,是数值问题(第 15 章)
④ 把 7 个系数当成 7 份信息      → VIF > 10 的三个特征在说同一件事(第 14 章)
⑤ 用测试集挑特征               → 选择泄漏,测试集从此不再是"没见过的"
⑥ 分数正常就以为划分没错       → 按行随机的线性模型只虚高 0.002,看不出异常
13.8 完整示例与输出
cd code
python demos/ch13-multi-feature-linear.py
真实输出(节选):
=== ② 两种模型:同一套代码,两份结果 ===
  1 列 cycle  训练 R² = 0.83732   测试 R² = 0.82070   MAE = 0.01691   RMSE = 0.02317
  7 列        训练 R² = 0.94296   测试 R² = 0.94253   MAE = 0.01082   RMSE = 0.01312
  R² 提升:+0.12183

=== ③ 同一个改进,三把尺子量出三个百分比 ===
  MSE   0.000537 → 0.000172   降  67.9%
  RMSE  0.023168 → 0.013117   降  43.4%
  MAE   0.016912 → 0.010820   降  36.0%

=== ⑤ 多重共线性:三个特征在说同一件事 ===
  相关 r(cycle          , coulombic_eff  ) = -0.9264
    coulombic_eff              VIF =  16.71
    cycle                      VIF =  11.21
    resistance_mohm            VIF =   5.05

=== ⑦ 一个伏笔:未缩放时 sklearn 丢掉了方向 ===
  7 个特征,实际解出 rank_ = 6
  截断阈值 tol*σmax = 0.045644,最后一个 σ = 0.034526 → 被切掉

结论:从 1 列到 7 列,测试 R² 0.82070 → 0.94253;
      平方误差降 67.9%,RMSE 降 43.4%,MAE 降 36.0% —— 同一对模型。
本章练习
练习 1:把"收益"量成一句话
用 soh_features.csv,按设备划分(GroupShuffleSplit(test_size=0.2, random_state=42)):
- 分别用
["cycle"]和 7 个特征拟合线性回归,报出 R² / MAE / RMSE / MSE; - 算出 MSE、RMSE、MAE 各自的下降百分比;
- 用一句话把结论写出来(必须带限定词:划分方式、尺子、数字)。
参考答案
import pandas as pd
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_absolute_error, mean_squared_error, r2_score
from sklearn.model_selection import GroupShuffleSplit

FEATS = ["cycle", "mean_charge_voltage_v", "mean_temp_rise_c", "resistance_mohm",
         "coulombic_eff", "cap_fade_rate_ah_per_100", "temp_std_c"]

df = pd.read_csv("data/battery/soh_features.csv")
tr, te = next(GroupShuffleSplit(n_splits=1, test_size=0.2, random_state=42)
              .split(df[FEATS], df["soh"], groups=df["cell_id"]))
y_tr, y_te = df["soh"].iloc[tr], df["soh"].iloc[te]


def evaluate(feats):
    model = LinearRegression().fit(df[feats].iloc[tr], y_tr)
    pred = model.predict(df[feats].iloc[te])
    return {"R2": r2_score(y_te, pred),
            "MAE": mean_absolute_error(y_te, pred),
            "RMSE": mean_squared_error(y_te, pred) ** 0.5,
            "MSE": mean_squared_error(y_te, pred)}


one, seven = evaluate(["cycle"]), evaluate(FEATS)
for k in ("R2", "MAE", "RMSE", "MSE"):
    print(f"1 列 {k:5s} = {one[k]:.6f}   7 列 {k:5s} = {seven[k]:.6f}")
print(f"R² 提升 {seven['R2'] - one['R2']:+.5f}")
for k in ("MSE", "RMSE", "MAE"):
print(f"{k:5s} 降 {100 * (one[k] - seven[k]) / one[k]:.1f}%")期望输出:
1 列 R2    = 0.820696   7 列 R2    = 0.942526
1 列 MAE   = 0.016912   7 列 MAE   = 0.010820
1 列 RMSE  = 0.023168   7 列 RMSE  = 0.013117
1 列 MSE   = 0.000537   7 列 MSE   = 0.000172
R² 提升 +0.12183
MSE   降 67.9%
RMSE  降 43.4%
MAE   降 36.0%
③ 一句话结论:
在按设备划分(48 支训练 / 12 支测试)下,把特征从 1 列(
cycle)扩到 7 列, 测试 R² 从 0.82070 升到 0.94253; 平方误差降 67.9%、RMSE 降 43.4%、平均绝对误差降 36.0% —— 换句话说,单行预测的平均偏差从 1.69 个百分点降到 1.08 个百分点。
★ 为什么第 3 问要求"带限定词"
❌ "误差降了 68%"
   → 读者默认理解成"平均误差",而平均误差(MAE)只降了 36%

✅ "在按设备划分下,平方误差降 67.9%,平均绝对误差降 36.0%"
   → 谁都能复核,谁都不会误解
这就是第 02 章说的"给数字加限定词"在第一个实战例子里的样子。
练习 2:亲手制造一次"加特征反而变差"
只用 ["coulombic_eff", "cycle", "resistance_mohm"] 三列:
- 用
LinearRegression()默认参数拟合,报rank_与测试 R²; - 换成
Pipeline([("scaler", StandardScaler()), ("model", LinearRegression())]),再报一次; - 用
LinearRegression(tol=0)不缩放再报一次; - 回答:这三条结果说明"
resistance_mohm这个特征有害"吗?
参考答案
import pandas as pd
from sklearn.linear_model import LinearRegression
from sklearn.metrics import r2_score
from sklearn.model_selection import GroupShuffleSplit
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler

FEATS3 = ["coulombic_eff", "cycle", "resistance_mohm"]
ALL = ["cycle", "mean_charge_voltage_v", "mean_temp_rise_c", "resistance_mohm",
       "coulombic_eff", "cap_fade_rate_ah_per_100", "temp_std_c"]

df = pd.read_csv("data/battery/soh_features.csv")
tr, te = next(GroupShuffleSplit(n_splits=1, test_size=0.2, random_state=42)
              .split(df[ALL], df["soh"], groups=df["cell_id"]))
y_tr, y_te = df["soh"].iloc[tr], df["soh"].iloc[te]

model = LinearRegression().fit(df[FEATS3].iloc[tr], y_tr)
print(f"未缩放(sklearn 默认):rank_ = {model.rank_}/3  "
      f"测试 R² = {r2_score(y_te, model.predict(df[FEATS3].iloc[te])):.5f}")

pipe = Pipeline([("s", StandardScaler()), ("m", LinearRegression())]).fit(df[FEATS3].iloc[tr], y_tr)
print(f"标准化               :rank_ = 3/3  "
      f"测试 R² = {r2_score(y_te, pipe.predict(df[FEATS3].iloc[te])):.5f}")

fix = LinearRegression(tol=0).fit(df[FEATS3].iloc[tr], y_tr)
print(f"未缩放 + tol=0       :rank_ = {fix.rank_}/3  "
f"测试 R² = {r2_score(y_te, fix.predict(df[FEATS3].iloc[te])):.5f}")期望输出:
未缩放(sklearn 默认):rank_ = 2/3  测试 R² = 0.85018
标准化               :rank_ = 3/3  测试 R² = 0.93597
未缩放 + tol=0       :rank_ = 3/3  测试 R² = 0.93597
④ 回答:不是。三条结果指向同一个结论 —— 这是数值问题,不是统计问题。
证据一:rank_ —— 传进去 3 个特征,默认参数下只当 2 个用。 证据二:tol=0 把截断关掉,R² 立刻回到 0.93597,和标准化那条曲线完全一致。 证据三:标准化和 tol=0 给出同一个答案 —— 说明"正确答案"只有一个,默认参数那条是错的。
★ 如果只看到第一行,会得出什么结论
"加了 resistance_mohm,R² 从 0.93568 掉到 0.85018 —— 这个特征有害!"
    ↓
删掉它
    ↓
其实什么都没修好,你只是绕开了数值问题
    ↓
换个数据集、换批特征,同样的坑会在别的地方再炸一次
★ 一条可迁移的排查顺序:
"加特征/加预处理之后,分数反而跌了"
    ├─ 先看 rank_ 是不是小于特征数        ← 数值问题(本章)
    ├─ 再看特征的量纲差几个数量级          ← 数值问题(第 14 章)
    ├─ 再看新特征和旧特征的相关性           ← 共线性(13.5)
    └─ 都不是,才是真的统计现象
这个顺序的关键是:先排除"我算错了",再解释"数据说了什么"。
练习 3:给"这三个特征在说同一件事"提供证据
只考虑 cycle、resistance_mohm、coulombic_eff 三列:
- 打印两两相关系数;
- 算这三列各自的 VIF;
- 再和本章正文里"7 个特征一起算"的 VIF(11.21 / 5.05 / 16.71)比一比,解释为什么数字不一样。
参考答案
import pandas as pd
from sklearn.linear_model import LinearRegression

COLS = ["cycle", "resistance_mohm", "coulombic_eff"]

df = pd.read_csv("data/battery/soh_features.csv")

for i, u in enumerate(COLS):
    for v in COLS[i + 1:]:
        print(f"r({u}, {v}) = {df[u].corr(df[v]):+.4f}")

for c in COLS:
    others = [o for o in COLS if o != c]
    r2 = LinearRegression().fit(df[others], df[c]).score(df[others], df[c])
print(f"VIF({c:15s}) = {1 / (1 - r2):.2f}")期望输出:
r(cycle, resistance_mohm) = +0.8658
r(cycle, coulombic_eff) = -0.9264
r(resistance_mohm, coulombic_eff) = -0.8987
VIF(cycle          ) = 7.35
VIF(resistance_mohm) = 5.42
VIF(coulombic_eff  ) = 9.57
③ 为什么和正文里的 11.21 / 5.05 / 16.71 不一样
只放 3 列时:能"抢功劳"的替身只有 2 个  → VIF 小(7.35 / 5.42 / 9.57)
放 7 列时:  能"抢功劳"的替身有 6 个    → VIF 大(11.21 / 5.05 / 16.71)
★ VIF 不是一个特征的固有属性,而是"在当前这组特征里,它有多余":
| 说法 | 对不对 |
|---|---|
"cycle 的 VIF 是 11.21" | ❌ 不完整 |
"在 7 个特征这组里,cycle 的 VIF 是 11.21" | ✅ |
"只放这 3 列时,cycle 的 VIF 是 7.35" | ✅ |
所以报表里写 VIF,必须带上"在哪些特征之间算的"。
④ 三个特征的相关系数都在 0.87~0.93 之间,含义很直白:
任意两个的 |r| > 0.86
    ↓
用其中一个去预测另一个,R² 已经 > 0.75
    ↓
它们在解释同一件事:设备在老化的路上走了多远
    ↓
所以"谁的系数大"这个问题,在这三个特征之间是没有唯一答案的(第 14 章)
★ 顺带一个反直觉的点:
这三列互相高相关,但三列一起用仍然比单用一列好(测试 R² 0.93597 > 0.93423)。 共线性不等于冗余 —— 它只让系数的解释不可靠,不必然让预测变差。
面向工程实践:什么时候该加特征
这一章的动作很简单(改一个列表),但它对应的是项目里成本最高的决策。
① 加特征的三条判据
① 它在预测时刻拿得到吗?        ← 拿不到就是时间穿越(第 04 章)
② 它和标签的关系在测试集上也成立吗? ← 只看训练集分数会骗你
③ 它和已有特征相关吗?           ← VIF > 10 就要想清楚"我加它是为了什么"
② 三种目的,三种做法
| 目的 | 该看的数字 | 加特征的收益 |
|---|---|---|
| 提高预测精度 | 测试集 RMSE / MAE | 往往递减得很快(98.3% 在前 1 列) |
| 让模型可解释 | 标准化系数(第 14 章) | 加共线特征会让解释变差 |
| 让模型能外推 | 需要结构性的新信息 | 加噪声特征毫无帮助 |
★ 一个常见的项目事故:
有人说:"我加了 20 个特征,R² 从 0.94 涨到 0.96!"
    ↓
问三个问题:
  ① 划分方式是什么?        → "随机划分的"        ← 第 09 章的问题
  ② 测试集和训练集有交集吗? → "有同一支设备"      ← 虚高
  ③ 20 个特征里 VIF 最大多少? → "有个 80"        ← 系数已经不能解释
    ↓
结论:这个 0.96 不可用于决策,虽然它"看起来更高了"
③ 一个可复用的检查脚本骨架
def report_feature_set(df, feats, tr, te, target="soh"):
    """加特征之前先跑这个:一张表说清这个特征集值不值得用。"""
    from sklearn.linear_model import LinearRegression
    from sklearn.metrics import mean_absolute_error, r2_score
    import numpy as np

    X_tr, y_tr = df[feats].iloc[tr], df[target].iloc[tr]
    X_te, y_te = df[feats].iloc[te], df[target].iloc[te]
    model = LinearRegression().fit(X_tr, y_tr)
    pred = model.predict(X_te)

    print(f"特征数 {len(feats)}   rank_ {model.rank_}   测试 R² {r2_score(y_te, pred):.5f}"
          f"   MAE {mean_absolute_error(y_te, pred):.5f}")

    # 共线性体检
    for c in feats:
        others = [o for o in feats if o != c]
        r2 = LinearRegression().fit(df[others], df[c]).score(df[others], df[c])
        vif = 1 / (1 - r2)
        if vif > 5:
            print(f"  ⚠️ VIF({c}) = {vif:.2f}")

    # 缩放敏感性体检(第 15 章)
    from sklearn.pipeline import Pipeline
    from sklearn.preprocessing import StandardScaler
    pipe = Pipeline([("s", StandardScaler()), ("m", LinearRegression())]).fit(X_tr, y_tr)
    print(f"  标准化后测试 R² {r2_score(y_te, pipe.predict(X_te)):.5f}")
★ 这个脚本的每一行都对应本章的一个坑:
rank_            → 数值问题(k=3 暴跌那次)
VIF              → 共线性(13.5)
标准化后 R²      → 量纲问题(第 14/15 章)
划分方式(tr/te)→ 泄漏(第 09~12 章)
★ 最后一句:加特征的收益递减得非常快,而加"错的特征"的代价是无限的。
1 列  →  0.93423
7 列  →  0.95053(后 6 列只贡献 +0.01631)
    ↓
如果你要再花两周做特征工程,先回答:
"这两周能拿到的,是第二个 coulombic_eff,还是第 8 个和已有特征相关 0.9 的东西?"