第 14 章 · 系数的读法:符号、大小、量纲
这一章要解决什么:
model.coef_是一串数字,但它不是一份重要性排行榜。 这一章要建立的纪律是:先看符号,再看量纲,最后才敢看大小。最容易踩的坑: ① 直接按
coef_的绝对值排重要性 —— 量纲差 6 个数量级,排名是假的; ② 把系数当成相关性 —— 同一个cycle,单特征系数和多特征系数差 3.82 倍; ③ 以为系数至少是"稳定的" —— 这份数据的系数表自己在抖(coulombic_eff的系数 在 +0.006146 和 +27.005353 之间,取决于求解器怎么算)。
本章你需要完成的代码:demos/ch14-coefficient-reading.py
14.1 一个系数要读三样东西
线性模型的预测公式是:
ŷ = w₁x₁ + w₂x₂ + … + w₇x₇ + bw 就是 coef_。读它要按顺序问三个问题:
| 顺序 | 问题 | 为什么是这个顺序 |
|---|---|---|
| ① | 符号是正还是负? | 它回答"这个特征变大时,预测往哪边走" —— 和量纲无关,永远可读 |
| ② | 它的单位是什么? | w 的单位 = (标签单位)/(特征单位)—— 不写单位,这个数没有意义 |
| ③ | 和其他系数比大小,可比吗? | 只有把所有特征放到同一把尺子上才能比 |
★ 第 ③ 步是最容易被跳过的一步。
coef_ = [..., -0.0000382, ..., +27.0053535, ...]
                 ↑                  ↑
        "cycle 的系数好小,       "coulombic_eff 的系数好大,
         它大概不重要"              它最重要"
这两句判断都是错的 —— 因为它们把不同单位的数字直接比了大小。
一个生活化的类比:
"我的体重比身高大,所以体重更重要"
    ↓
体重 65(公斤)、身高 1.72(米)
    ↓
不是体重更重要,是你把两个不同单位的数字直接比了。
    ↓
换算成同一个单位(都变成"厘米"或者"占平均值的比例")才有意义。
14.2 打印一张系数表
真实输出:
=== ① 打印一张系数表(这就是最容易读错的东西)===
  intercept_ = -25.709307
  特征                                       系数         单位        ×1σ        ×全距
  cycle                           -0.00003823          次   -0.01328   -0.05313
  mean_charge_voltage_v           -0.05841803          V   -0.00497   -0.02707
  mean_temp_rise_c                -0.00173585          ℃   -0.00667   -0.04068
  resistance_mohm                 +0.00011642         mΩ   +0.00126   +0.00626
  coulombic_eff                  +27.00535348          —   +0.02888   +0.12422
  cap_fade_rate_ah_per_100        -0.26194258    Ah/100次   -0.00340   -0.02496
  temp_std_c                      -0.03002753          ℃   -0.00415   -0.02252
  (×1σ = 系数 × 该特征一个标准差,是把系数翻译成'合理一步'的走法)
这张表有四列数字,只有后两列是可以比的。
★ 先看符号(第 ① 步,永远可读):
cycle            -0.00003823   负 → 循环越多,健康度越低        ✓ 符合直觉
resistance_mohm  +0.00011642   正 → 内阻越大,健康度越【高】?   ✗ 与直觉相反(14.4 解释)
coulombic_eff   +27.00535348   正 → 库仑效率越高,健康度越高     ✓ 符合直觉
★ 再看单位(第 ② 步):
| 系数 | 单位 | 说人话 |
|---|---|---|
cycle: -0.00003823 | soh / 次 | 每多循环 1 圈,健康度下降 0.00003823 |
cap_fade: -0.26194258 | soh / (Ah/100次) | 衰减速率每多 1 Ah/100次,健康度下降 0.2619 |
coulombic_eff: +27.00535348 | soh / (效率) | 效率每提高 1.0(从 0 到 1),健康度上升 27.0 |
看清楚第三个了吗:coulombic_eff 的系数 27.0 的单位是"效率从 0 变成 1" —— 而这个特征的实际取值只在 0.9937 ~ 0.9983 之间(全距 0.0046)。
它的系数说:"效率提高 1.0,soh 涨 27"
    ↓
但它一辈子只变动 0.0046
    ↓
27.00535348 × 0.0046 = 0.1242   ← 这就是"×全距"那一列
★ 第 ③ 步:换成同一把尺子
"×1σ"和"×全距"两列,就是把每个系数翻译成"这个特征在数据里真实走一步,能带来多少 soh 变化"。
×1σ 列 = 系数 × 该特征的标准差   ← 单位统一成"soh"
×全距 = 系数 × 该特征的极差 ← 单位也是"soh"换算之后,两个数字立刻可比了:
| 特征 | 原始系数 | ×1σ(= 标准化系数) |
|---|---|---|
coulombic_eff | +27.00535348 | +0.02888 |
cap_fade_rate_ah_per_100 | -0.26194258 | -0.00340 |
| 比值 | 103.1 倍 | 8.5 倍 |
★ 同一对特征,"差 103 倍"和"差 8.5 倍"是同一份数据。
点开:为什么"标准化系数"和"×1σ"是同一个东西
标准化系数 = 先把特征减均值除标准差,再拟合得到的系数。
推导很简单:设 z = (x - μ) / σ,那么 x = σz + μ,代入
ŷ = w·x + b = w(σz + μ) + b = (wσ)·z + (wμ + b)所以:标准化系数 = w × σ ← 就是"×1σ"那一列代码里的一一对应:
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LinearRegression

pipe = Pipeline([("scaler", StandardScaler()), ("model", LinearRegression())]).fit(X_tr, y_tr)
std_coef = pipe.named_steps["model"].coef_          # 标准化系数
back = std_coef / pipe.named_steps["scaler"].scale_ # 还原回原始单位 = 原始系数注意最后一行:标准化系数除以 scale_ 就回到原始单位。 所以"标准化"没有产生新信息,它只是换了个坐标系,让数字可比。
它还是唯一能让"读系数"这件事变得安全的操作 —— 因为 14.6 节会看到, 不缩放时的原始系数本身就算不准。
14.3 ★ 坑一:按原始系数大小排重要性
这是本章的核心。先看错误做法给出的排名:
真实输出:
=== ② 坑一:按原始系数大小排重要性(错的)===
  第 1 名  coulombic_eff              |系数| = 27.00535348
  第 2 名  cap_fade_rate_ah_per_100   |系数| = 0.26194258
  第 3 名  mean_charge_voltage_v      |系数| = 0.05841803
  第 4 名  temp_std_c                 |系数| = 0.03002753
  第 5 名  mean_temp_rise_c           |系数| = 0.00173585
  第 6 名  resistance_mohm            |系数| = 0.00011642
  第 7 名  cycle                      |系数| = 0.00003823
  → 按这张表,cycle 排在最后一名:|-0.00003823|
    它和第一名 coulombic_eff |27.00535348| 差 706,461 倍。
再看正确做法给出的排名:
=== ③ 标准化之后再看(对的)===
  标准化 R²(同一划分)= 0.95053
  第 1 名  coulombic_eff              标准化系数 = +0.028881
  第 2 名  cycle                      标准化系数 = -0.013282   ← 从最后一名升到第二名
  第 3 名  mean_temp_rise_c           标准化系数 = -0.006670
  第 4 名  mean_charge_voltage_v      标准化系数 = -0.004971
  第 5 名  temp_std_c                 标准化系数 = -0.004154
  第 6 名  cap_fade_rate_ah_per_100   标准化系数 = -0.003403   ← 从第二名掉到倒数第二名
  第 7 名  resistance_mohm            标准化系数 = +0.001261
  → cycle 与 coulombic_eff 的差距:原始系数 706,461 倍 → 标准化后 2.17 倍。
  → 唯一能让系数可比的动作是:把它们放到同一把尺子上(这里是 σ)。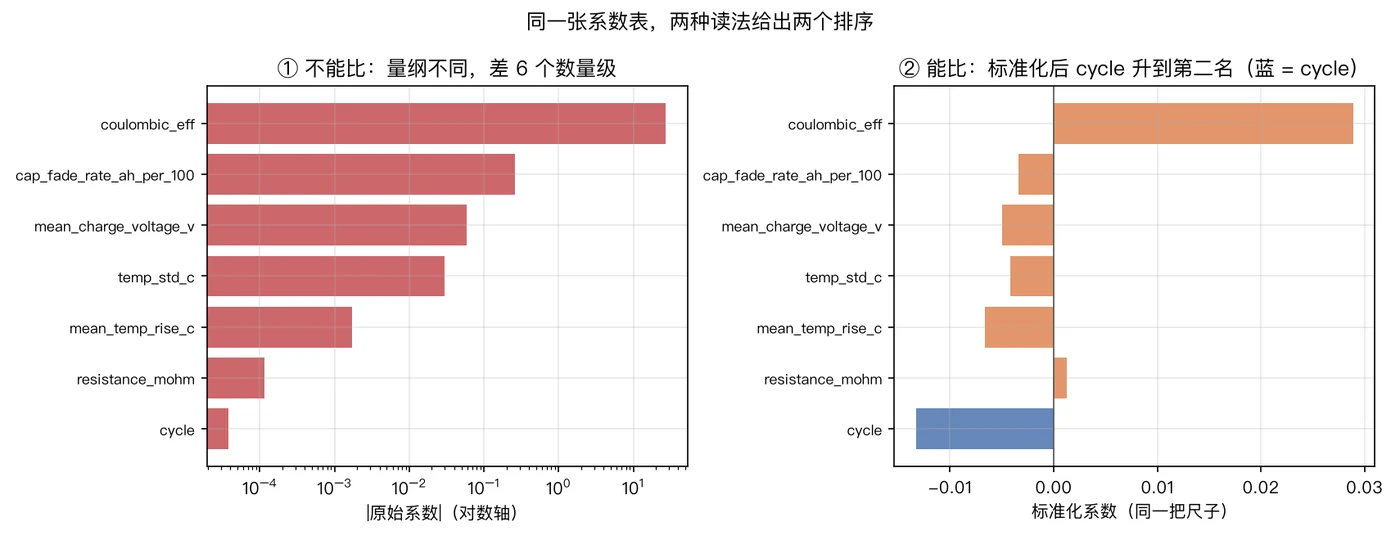
★ 把两个排名并排放,就是这一章的全部:
| 特征 | 原始系数排名 | 标准化系数排名 | 变化 |
|---|---|---|---|
coulombic_eff | 1 | 1 | 稳 |
cap_fade_rate_ah_per_100 | 2 | 6 | 掉了 4 名 |
mean_charge_voltage_v | 3 | 4 | ↓1 |
temp_std_c | 4 | 5 | ↓1 |
mean_temp_rise_c | 5 | 3 | ↑2 |
resistance_mohm | 6 | 7 | ↓1 |
cycle | 7(最后) | 2 | 升了 5 名 |
「cycle 与 coulombic_eff 谁更重要?」这个问题的完整回答
问题:cycle 的系数是 -0.00003823,coulombic_eff 的系数是 +27.00535348,
      是不是 coulombic_eff 重要得多?
    ↓
错误回答:"对,差 70 万倍,coulombic_eff 碾压。"
    ↓
正确回答:
  "不能这样比 —— 这两个系数的单位不同。
   cycle 的单位是 soh/次,coulombic_eff 的单位是 soh/效率。
   换成同一把尺子(各乘自己的标准差)之后,
   两者相差 2.17 倍,coulombic_eff 略强。"
量纲差多少?
| 特征 | 取值范围 | 全距 |
|---|---|---|
cycle | 50 ~ 1440 | 1390 |
coulombic_eff | 0.9937 ~ 0.9983 | 0.0046 |
两者的"典型变化幅度"相差 1,390 / 0.0046 ≈ 302,174 倍
    ↓
所以它们的系数天然相差几万倍,这与"谁重要"毫无关系
★ 用第二把尺子交叉验证(这一步很关键)
万一"除以标准差"是一种任意的选择呢?换一把尺子看看:
| 特征 | ×1σ | ×全距 |
|---|---|---|
coulombic_eff | +0.02888(第 1) | +0.12422(第 1) |
cycle | -0.01328(第 2) | -0.05313(第 2) |
mean_temp_rise_c | -0.00667(第 3) | -0.04068(第 3) |
cap_fade_rate_ah_per_100 | -0.00340(第 6) | -0.02496(第 5) |
resistance_mohm | +0.00126(第 7) | +0.00626(第 7) |
★ 两把尺子给出几乎相同的排名 —— 这才是"cycle 排第二"可信的原因。
如果换一把尺子排名就天翻地覆 → 说明排名不稳定,不能下结论
如果换一把尺子排名基本不变   → 说明这个结论对尺子的选择不敏感
这条"换个方式再算一遍"的习惯,会在第 23~26 章反复出现。
点开:那"系数大 = 重要"这句话,什么时候是对的?
它在一种情况下是对的:所有特征已经被放到同一把尺子上了。
# 已经把特征标准化过
pipe = Pipeline([("scaler", StandardScaler()), ("model", LinearRegression())])
pipe.fit(X, y)
coef = pipe.named_steps["model"].coef_
# ↑ 现在可以直接比大小了但即使这样,还有两个前提:
| 前提 | 如果不满足 |
|---|---|
| 特征之间不高度相关 | 系数会互相"抢功劳",大小不可解释(14.5) |
| 模型没有正则化 | 带惩罚的模型会主动压缩系数(第 22 章) |
★ 三个条件全满足,才可以说"标准化系数大 = 这个方向影响大":
① 同一把尺子(标准化)      ← 本章
② 特征之间没有强共线性       ← 14.5
③ 模型没有正则化             ← 第 22 章
缺任何一条,都只能说"这个系数是多少",不能说"这个特征多重要"。
14.4 ★ 坑二:把系数当相关性
同一个特征 cycle,两个系数:
真实输出:
=== ④ 坑二:把系数当'相关性'(方向对了,大小不对)===
  只用 cycle      :coef = -0.00014620 → 每 100 圈 1.462 个百分点
  7 个特征一起看  :coef = -0.00003823 → 每 100 圈 0.382 个百分点
  → 同一个特征,两个系数差 3.82 倍。
     第一个问的是'总的看,循环越多越差多少';
     第二个问的是'在其它特征都一样的前提下,多循环几圈差多少'。
与 soh 的相关系数:r(cycle, soh) = -0.9137 (系数不能当相关性读)两个系数都是对的,它们回答的是两个不同的问题:
| 模型 | 问题 | 答案 |
|---|---|---|
只用 cycle | "循环多的设备,健康度低多少?"(边际效应) | 每 100 圈 1.462 个百分点 |
| 7 个特征一起 | "在库仑效率、内阻都一样的前提下,多循环几圈差多少?"(条件效应) | 每 100 圈 0.382 个百分点 |
★ 为什么条件效应小了 3.82 倍:
只用 cycle:把 cycle 当成老化的【唯一代表】
    ↓ 所以它一个人扛下了全部 1.462 个百分点

7 个特征:cycle、coulombic_eff、resistance_mohm 都在描述"老化的程度"
    ↓ 已经有人(coulombic_eff)把大部分信息说完了
    ↓ 留给 cycle 的,只是"效率相同的情况下,多循环几圈"的那一小部分
这就是 13.5 节共线性的直接后果。
★ 一个必须记住的翻译纪律:
❌ "每多循环 100 圈,健康度下降 1.462 个百分点"       ← 缺了前提
✅ "如果只看 cycle 这一列,每多循环 100 圈,健康度平均低 1.462 个百分点"
✅ "如果同时看这 7 个特征(即在其它特征相同时),每多循环 100 圈,健康度低 0.382 个百分点"
★ 为什么"系数 ≠ 相关性"
相关系数 r | 回归系数 w | |
|---|---|---|
| 有没有量纲 | 没有(永远 ∈ [-1, 1]) | 有(标签单位/特征单位) |
| 单变量 | r 和 w 同号 | —— |
| 多变量 | r 不考虑其它变量 | w 是"控制其它变量后"的效应 |
| 符号一致吗 | 不一定! | 见下一节 |
下一节就是"符号不一致"的真实现场。
14.5 ★ 坑三:共线性让系数不可解释
真实输出:
=== ⑤ 坑三:多重共线性(三个特征在说同一件事)===
                                     cycle  resistance_m  coulombic_ef
  cycle                            +1.0000       +0.8658       -0.9264
  resistance_mohm                  +0.8658       +1.0000       -0.8987
  coulombic_eff                    -0.9264       -0.8987       +1.0000
  VIF(coulombic_eff             ) =  16.71   ← >5,系数已经不稳
  VIF(cycle                     ) =  11.21   ← >5,系数已经不稳
  VIF(resistance_mohm           ) =   5.05   ← >5,系数已经不稳
  VIF(temp_std_c                ) =   3.10
  VIF(mean_charge_voltage_v     ) =   2.51
  VIF(mean_temp_rise_c          ) =   2.04
  VIF(cap_fade_rate_ah_per_100  ) =   1.78
  符号反转的例子(resistance_mohm):
    单独用 resistance_mohm     :coef = -0.00442195  (负号:内阻越大越差 ✓)
    7 个特征一起(数值可靠解) :coef = +0.00011642  (符号反了 ✗)
    → 它的'独立作用'已经被 cycle / coulombic_eff 解释完了,剩下的是噪声。
★ 这个符号反转不是 bug,是共线性的必然结果。
r(resistance_mohm, soh) = -0.8784        ← 单独看:内阻和健康度强负相关
    ↓
但 r(resistance_mohm, coulombic_eff) = -0.8987   ← 内阻和效率几乎是一条直线的两端
    ↓
模型看到的是:
   "效率低" 这一个信息,已经足够解释健康度下降
   "内阻高" 这一个信息,和"效率低"是同一件事
    ↓
模型把功劳判给了 coulombic_eff(因为它的 |r| 更高一点)
    ↓
留给 resistance_mohm 的系数,是"在效率相同的前提下,内阻还多解释了什么"
    ↓
答案:几乎什么都没有(+0.00011642,而且符号是正的)
★ 关键区分:共线性伤害的是"解释",不是"预测"
| 你要回答的问题 | 这份共线性数据能不能用 |
|---|---|
| "这支设备的 soh 是多少?" | ✅ 能,测试 R² = 0.95053 |
| "内阻每升高 1 mΩ,soh 变化多少?" | ❌ 不能,符号都反了 |
| "哪个特征对预测最有用?" | ⚠️ 要看第 20 章的特征重要性,而且也要小心 |
★ 一个实用的判据:
VIF > 10 的特征,它的系数:
  ① 大小不可信(随样本抖动)
  ② 符号可能不可信(就像这里的 resistance_mohm)
  ③ 但"把它放进模型"仍然可能有用(预测层面)

→ 所以:可以留着它做预测,但不能拿它的系数去写结论。
14.6 ★ 坑四:这张系数表自己就在抖
这是本章最深的一层,也是通向第 15 章的钩子。
真实输出:
=== ⑥ 坑四:这张系数表自己就在抖 ===
  sklearn 默认(tol=1e-6)    rank_ = 6/7   coulombic_eff 系数 = +0.006146
  同一次拟合,cond 放宽        rank_ = 7/7   coulombic_eff 系数 = +27.005353
  两者差 26.9992 —— 同一个模型、同一份数据、同一个划分。
→ 在讨论'谁的系数大'之前,先确认这张表本身可信。第 15 章给出机制和修法。同一个模型、同一份数据、同一个训练集,coulombic_eff 的系数可以是:
+0.006146   (sklearn 默认 tol=1e-6)
+27.005353  (tol=0)
★ 差 26.9992,是 4,394 倍。
这比 14.3 节的"量纲问题"更让人不安:
14.3 的问题:数字可比吗?         → 换把尺子就能修
14.6 的问题:数字本身算对了吗?    → 要动数值设置,或干脆标准化
而且它和 13.4 节那次"加特征暴跌到 0.85018"是同一个原因:
未缩放的特征量纲差 6 个数量级
    ↓
设计矩阵条件数 cond = 3.795e+06
    ↓
sklearn 的 LinearRegression 默认 tol=1e-6,会把小于 tol × σmax 的奇异方向截断
    ↓
rank_ = 6(传进去 7 个特征,只当 6 个用)
    ↓
系数的"最优解"变成了另一个问题的解 → 系数值当然不同
★ 所以读系数的完整流程应该是:
① 先标准化(或至少确认 rank_ == 特征数)
② 再看符号
③ 再看标准化系数的大小
④ 最后检查共线性(VIF)是否允许你解释它
第 15 章会把第 ① 步讲透。
点开:怎么快速体检"这张系数表能不能信"
三个一行检查:
model = LinearRegression().fit(X_tr, y_tr)

# ① 秩:传进去几个特征,就用上了几个?
print(f"rank_ = {model.rank_} / {X_tr.shape[1]}")        # 必须相等

# ② 条件数:量纲是不是差太多?
import numpy as np
print(f"cond = {np.linalg.cond(X_tr.to_numpy()):.3e}")     # > 1e4 就要警惕

# ③ 交叉验证:换个数值路径,系数会不会变?
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler
pipe = Pipeline([("s", StandardScaler()), ("m", LinearRegression())]).fit(X_tr, y_tr)
back = pipe.named_steps["m"].coef_ / pipe.named_steps["s"].scale_
print("两条路径的系数最大差:", np.abs(model.coef_ - back).max())这份数据上的真实结果:
rank_ = 6 / 7              ← 第 ① 条就已经报警了
cond = 3.795e+06           ← 第 ② 条也报警
两条路径的系数最大差:26.9992   ← 第 ③ 条坐实了
★ 三条检查全部指向同一个结论:这张表不能用原始系数去解释。
修法有两个,效果一样:
# 方法 A:标准化(推荐 —— 顺手解决"可比性")
Pipeline([("scaler", StandardScaler()), ("model", LinearRegression())])

# 方法 B:关掉截断(治标)
LinearRegression(tol=0)
为什么推荐 A:它一次解决两个问题(数值正确 + 系数可比)。 第 15 章会给出 tol=0 和标准化在数值上等价的证据(系数最大差 2.59e-13)。
14.7 常见坑
① 按 coef_ 绝对值排重要性        → 量纲差 30 万倍,cycle 会假摔到最后一名
② 拿系数当相关性读               → 单特征 1.462 vs 多特征 0.382 个百分点/100圈
③ 忽略共线性直接解释符号          → resistance_mohm 的符号会反转
④ 以为系数是"稳定"的             → coulombic_eff: +0.006146 还是 +27.005353,取决于 tol
⑤ 忘了说前提                    → "每 100 圈降 1.462 个百分点"必须补"只看 cycle 时"
⑥ 标准化后忘了还原单位            → 标准化系数的单位是 "soh / 1σ",不是原始单位
14.8 完整示例与输出
cd code
python demos/ch14-coefficient-reading.py
真实输出(节选):
=== ① 打印一张系数表(这就是最容易读错的东西)===
  特征                                       系数         单位        ×1σ        ×全距
  cycle                           -0.00003823          次   -0.01328   -0.05313
  coulombic_eff                  +27.00535348          —   +0.02888   +0.12422
  cap_fade_rate_ah_per_100        -0.26194258    Ah/100次   -0.00340   -0.02496

=== ② 坑一:按原始系数大小排重要性(错的)===
  第 7 名  cycle                      |系数| = 0.00003823

=== ③ 标准化之后再看(对的)===
  第 2 名  cycle                      标准化系数 = -0.013282   ← 从最后一名升到第二名
  → cycle 与 coulombic_eff 的差距:原始系数 706,461 倍 → 标准化后 2.17 倍。

=== ⑤ 坑三:多重共线性(三个特征在说同一件事)===
    单独用 resistance_mohm     :coef = -0.00442195  (负号:内阻越大越差 ✓)
    7 个特征一起(数值可靠解) :coef = +0.00011642  (符号反了 ✗)

=== ⑥ 坑四:这张系数表自己就在抖 ===
  sklearn 默认(tol=1e-6)    rank_ = 6/7   coulombic_eff 系数 = +0.006146
  同一次拟合,cond 放宽        rank_ = 7/7   coulombic_eff 系数 = +27.005353
本章练习
练习 1:把"系数大 = 重要"亲手推翻
用 7 个特征按设备划分拟合线性回归(数值可靠解用 LinearRegression(tol=0)):
- 按原始系数的绝对值排序,打印名次;
- 换成
Pipeline(StandardScaler + LinearRegression),按标准化系数排序,打印名次; - 找出排名变化最大的那个特征,报出它在两个排序里的名次。
参考答案
import pandas as pd
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import GroupShuffleSplit
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler

FEATS = ["cycle", "mean_charge_voltage_v", "mean_temp_rise_c", "resistance_mohm",
         "coulombic_eff", "cap_fade_rate_ah_per_100", "temp_std_c"]

df = pd.read_csv("data/battery/soh_features.csv")
tr, _ = next(GroupShuffleSplit(n_splits=1, test_size=0.2, random_state=42)
             .split(df[FEATS], df["soh"], groups=df["cell_id"]))
X_tr, y_tr = df[FEATS].iloc[tr], df["soh"].iloc[tr]

raw = LinearRegression(tol=0).fit(X_tr, y_tr)
for i, (c, co) in enumerate(sorted(zip(FEATS, raw.coef_), key=lambda t: -abs(t[1])), 1):
    print(f"原始第 {i} 名  {c:26s} {abs(co):.8f}")

pipe = Pipeline([("s", StandardScaler()), ("m", LinearRegression())]).fit(X_tr, y_tr)
std = pipe.named_steps["m"].coef_
order_std = [c for c, _ in sorted(zip(FEATS, std), key=lambda t: -abs(t[1]))]
for i, (c, co) in enumerate(sorted(zip(FEATS, std), key=lambda t: -abs(t[1])), 1):
    print(f"标准化第 {i} 名 {c:26s} {co:+.6f}")

print(f"cycle 原始排名 7/7,标准化排名 {order_std.index('cycle') + 1}/7")
print(f"cycle:coulombic 原始差 {abs(raw.coef_[4] / raw.coef_[0]):,.0f} 倍 → "
f"标准化差 {abs(std[4] / std[0]):.2f} 倍")期望输出:
原始第 1 名  coulombic_eff              27.00535348
原始第 2 名  cap_fade_rate_ah_per_100   0.26194258
原始第 3 名  mean_charge_voltage_v      0.05841803
原始第 4 名  temp_std_c                 0.03002753
原始第 5 名  mean_temp_rise_c           0.00173585
原始第 6 名  resistance_mohm            0.00011642
原始第 7 名  cycle                      0.00003823
标准化第 1 名 coulombic_eff              +0.028881
标准化第 2 名 cycle                      -0.013282
标准化第 3 名 mean_temp_rise_c           -0.006670
标准化第 4 名 mean_charge_voltage_v      -0.004971
标准化第 5 名 temp_std_c                 -0.004154
标准化第 6 名 cap_fade_rate_ah_per_100   -0.003403
标准化第 7 名 resistance_mohm            +0.001261
cycle 原始排名 7/7,标准化排名 2/7
cycle:coulombic 原始差 706,461 倍 → 标准化差 2.17 倍
③ 变化最大的是 cycle:从第 7 名(最后)升到第 2 名。
★ 为什么"第 7 名 → 第 2 名"这件事这么有教育意义
原始系数的单位:soh / 次
    cycle 一次变化 1(一圈),影响小得看不见
    coulombic_eff 一次变化 1(效率从 0 到 1),影响被放大 27 倍

但 coulombic_eff 在数据里一辈子只变化 0.0046,
而 cycle 会变化 1390。
    ↓
把"真实会走多远"乘回去,排名就翻转了。
★ 一句可以直接写进报告的结论
在按设备划分的训练集上,7 个特征的标准化系数绝对值排序为
coulombic_eff(0.0289) >cycle(0.0133) >mean_temp_rise_c(0.0067) > …cycle的原始系数(0.0000382)看似最小,是因为它的单位是"次"; 按各自一个标准差折算后它是第二位,与coulombic_eff只差 2.17 倍。
练习 2:把系数翻译成人话(两种问法)
用 cycle 一个特征和用 7 个特征,分别拟合:
- 报出两种情况下
cycle的系数; - 翻译成"每 100 圈,soh 变化几个百分点";
- 解释为什么两个数字不一样,以及各自该在什么场合使用。
参考答案
import pandas as pd
from sklearn.linear_model import LinearRegression

FEATS = ["cycle", "mean_charge_voltage_v", "mean_temp_rise_c", "resistance_mohm",
         "coulombic_eff", "cap_fade_rate_ah_per_100", "temp_std_c"]

df = pd.read_csv("data/battery/soh_features.csv")

one = LinearRegression().fit(df[["cycle"]], df["soh"])
print(f"只用 cycle    :coef = {one.coef_[0]:+.8f} → "
      f"每 100 圈 {abs(one.coef_[0]) * 100 * 100:.3f} 个百分点")

seven = LinearRegression(tol=0).fit(df[FEATS], df["soh"])
print(f"7 特征一起    :coef = {seven.coef_[0]:+.8f} → "
      f"每 100 圈 {abs(seven.coef_[0]) * 100 * 100:.3f} 个百分点")
print(f"倍数差 {abs(one.coef_[0] / seven.coef_[0]):.2f}   "
f"r(cycle, soh) = {df['cycle'].corr(df['soh']):+.4f}")期望输出:
只用 cycle    :coef = -0.00014620 → 每 100 圈 1.462 个百分点
7 特征一起    :coef = -0.00003823 → 每 100 圈 0.382 个百分点
倍数差 3.82   r(cycle, soh) = -0.9137
③ 两个数字都是对的,它们回答两个不同的问题
只用 cycle | 7 个特征一起 | |
|---|---|---|
| 问题 | "循环次数多的设备,健康度低多少?" | "其它条件相同时,多循环几圈差多少?" |
| 统计名字 | 边际效应(marginal effect) | 条件效应(conditional effect) |
| 数字 | 1.462 个百分点 / 100 圈 | 0.382 个百分点 / 100 圈 |
| 什么时候用 | 只有一个特征、或做粗略估算 | 多特征模型里解释"这个特征的独立贡献" |
★ 为什么差 3.82 倍
只用 cycle 时,cycle 一个人扛下了全部老化信息
    ↓
加入 coulombic_eff 之后,"老化程度"这件事被它说掉了大部分
(r(cycle, coulombic_eff) = -0.9264)
    ↓
cycle 的系数只剩下"效率相同的前提下,循环次数还多解释了什么"
★ 报告里怎么写
❌ "每多循环 100 圈,健康度下降 1.462 个百分点。"
   → 没说这个数字是在哪个模型里得到的

✅ "在只用 cycle 的单特征模型里,每多循环 100 圈健康度平均低 1.462 个百分点;
    在 7 特征模型里(即控制库仑效率、内阻等之后),这个效应降到 0.382 个百分点。
    两者的差别来自特征之间的高度相关。"
★ 顺带回答"系数能不能当相关性":
r(cycle, soh) = -0.9137     ← 无单位,∈[-1,1]
coef(cycle)  = -0.00014620   ← 有单位(soh/次)

方向一致(都是负的),但数字完全不可比:
一个是"相关强度",一个是"变化速率"。
练习 3:找一个会"符号反转"的系数
只考虑 resistance_mohm:
- 单独用它拟合,报系数与符号;
- 放进 7 个特征里(用
tol=0)再报一次; - 分别计算
r(resistance_mohm, soh)和r(resistance_mohm, coulombic_eff); - 解释符号为什么会反。
参考答案
import numpy as np
import pandas as pd
from sklearn.linear_model import LinearRegression

FEATS = ["cycle", "mean_charge_voltage_v", "mean_temp_rise_c", "resistance_mohm",
         "coulombic_eff", "cap_fade_rate_ah_per_100", "temp_std_c"]

df = pd.read_csv("data/battery/soh_features.csv")

one = LinearRegression().fit(df[["resistance_mohm"]], df["soh"])
print(f"resistance_mohm 单特征        :{one.coef_[0]:+.8f}")

full = LinearRegression(tol=0).fit(df[FEATS], df["soh"])
print(f"resistance_mohm 7 特征(整表)  :{full.coef_[3]:+.8f}")

print(f"r(resistance_mohm, soh)          = {df['resistance_mohm'].corr(df['soh']):+.4f}")
print(f"r(resistance_mohm, coulombic_eff)= {df['resistance_mohm'].corr(df['coulombic_eff']):+.4f}")
print(f"符号是否反转:{np.sign(one.coef_[0]) != np.sign(full.coef_[3])}")期望输出:
resistance_mohm 单特征        :-0.00442195
resistance_mohm 7 特征(整表)  :+0.00000191
r(resistance_mohm, soh)          = -0.8784
r(resistance_mohm, coulombic_eff)= -0.8987
符号是否反转:True
④ 符号为什么反
三步推理:
第一步:单看 resistance_mohm,它和 soh 是强负相关(-0.8784)
        → 内阻大的设备,健康度低。所以单特征系数是负的。

第二步:但 resistance_mohm 和 coulombic_eff 相关 -0.8987
        → "内阻大"和"效率低"在数据里几乎是一回事。
          模型只需要其中一个就能解释 soh 的下降。

第三步:coulombic_eff 与 soh 的相关(+0.9683)比 resistance_mohm(-0.8784)更强,
        所以模型把"老化"这份功劳给了 coulombic_eff,
        留给 resistance_mohm 的系数只回答:
        "在库仑效率相同的前提下,内阻还多解释了什么?"
        → 答案接近 0,而且因为噪声,符号变成了正的一点点。
★ 一个可迁移的判断:
"某个特征的系数符号和常识相反"
    ├─ 先查它和别的特征的相关性(|r| > 0.8 就要警惕)
    ├─ 再查 VIF(> 10 基本可以确定是共线性)
    └─ 如果确实是共线性:别解释这个系数,改用一个"代表性特征"或做降维
★ 千万不要做的事
# ❌ 看到符号反了,就把 resistance_mohm 删掉再拟合
#    这会让 coulombic_eff 的系数也变化(它接过了更多的功劳)
#    而"内阻"这份信息其实还在模型里,只是从另一个名字进去的

# ✅ 正确的做法是:报告里只解释"有代表性的那一个",
# 或者用第 22 章的正则化让系数稳定下来,再或者用第 20 章的特征重要性注意:7 个特征一起时,这里用的是整表(21,239 行)而不是训练集(17,244 行), 所以数字和 14.5 节的 +0.00011642 略有不同(+0.00000191)。 两个都是正的 —— 符号反转这件事在两种划分下都成立。
面向工程实践:一份"系数报告"该长什么样
① 只给一张系数表,等于没给结论
❌ 交付物:coef_ 的七个数
   → 没人能读懂,而且其中至少两个数字本身是错的(14.6)

✅ 交付物:一张带"符号/单位/尺子/前提"的表 + 三条限制
② 一份可用的系数报告模板
| 特征 | 符号(方向) | 原始系数 | 单位 | 标准化系数 | VIF | 能不能解释 |
|---|---|---|---|---|---|---|
coulombic_eff | + | 27.005 | soh/效率 | 0.0289 | 16.71 | ⚠️ 共线性高,只看方向 |
cycle | − | -0.0000382 | soh/次 | -0.0133 | 11.21 | ⚠️ 共线性高,只看方向 |
mean_temp_rise_c | − | -0.00174 | soh/℃ | -0.0067 | 2.04 | ✅ 可解释 |
mean_charge_voltage_v | − | -0.0584 | soh/V | -0.0050 | 2.51 | ✅ 可解释 |
temp_std_c | − | -0.0300 | soh/℃ | -0.0042 | 3.10 | ✅ 可解释 |
cap_fade_rate_ah_per_100 | − | -0.2619 | soh/(Ah/100次) | -0.0034 | 1.78 | ✅ 可解释 |
resistance_mohm | + | +0.000116 | soh/mΩ | +0.0013 | 5.05 | ❌ 符号反转,不要单独引用 |
③ 三条必须写进报告的限制
① 这些系数来自【按设备划分】的训练集(17,244 行 / 48 支),
   不是全表,也不是随机划分。
② 原始系数不可比大小;比较请用标准化系数这一列。
③ 共线性高的特征(VIF > 10)的系数不能单独解释。
   本表里 coulombic_eff / cycle / resistance_mohm 都属于这一类。
★ 这三条限制就是"限定词",它们让上面的数字从"看起来专业"变成"可以被复核"。
④ 一个反例:什么时候系数特别值得看
| 场景 | 系数能用吗 |
|---|---|
| 特征之间几乎不相关(VIF < 3) | ✅ 能,直接读标准化系数 |
| 有明确实验设计(正交、随机化) | ✅ 能,甚至能谈因果 |
| 观测数据 + 高共线性(本书场景) | ⚠️ 只能读符号和粗排名 |
| 有正则化的模型 | ❌ 系数被压缩过,不是"效应大小"(第 22 章) |
★ 最后一句纪律:
系数是"模型内部的记账",不是"世界的真相"。 换一组特征、换一个划分、换一个数值设置,它们都会变。 能用它下判断的前提是:你能说清它是在什么条件下算出来的。