第 17 章 · 随机森林:种 200 棵树治"抖动"
这一章要解决什么:上一章那棵"训练满分、测试掉下来"的深树,问题出在哪? 随机森林做的两件事(有放回抽样 + 平均)为什么能治它,以及它治不了什么。
最容易踩的坑:
- 把树数(
n_estimators)当成"越大越好"的旋钮 —— 它很快就饱和,多出来的树只烧 CPU;- 相信"森林每次分裂只看随机一小撮特征" —— 在 sklearn 的回归森林里这不是默认行为(17.3);
- 相信
oob_score_可以替代留出测试集 —— 同一份数据上它比真话高 0.02304(17.3)。
本章你需要完成的代码:demos/ch17-random-forest.py
17.1 先看病的症状:一棵树为什么会抖
先复习上一章的结论(同一份数据、按设备划分、random_state=42):
真实输出:
  单棵无限深树:训练 R² = 1.00000   测试 R² = 0.93347   差距 = 0.06653
  叶子数 = 16,774(训练集 17,244 行 → 几乎一行一个叶子)
对照 · 线性回归:训练 R² = 0.94296 测试 R² = 0.94253 差距 = 0.00043三个数字要一起读:
| 模型 | 训练 R² | 测试 R² | 差距 |
|---|---|---|---|
| 单棵无限深树 | 1.00000 | 0.93347 | 0.06653 |
| 线性回归 | 0.94296 | 0.94253 | 0.00043 |
① 训练 R² = 1.00000 不是优点。 16,774 个叶子对应 17,244 行训练数据 —— 它几乎给每一行都安排了一个专属叶子。 这不是"学得好",是把训练集背下来了。
② 它的分数还会抖。
真实输出(同一份数据、同一套特征,只换一个随机种子):
    seed=0  测试 R² = 0.93388
    seed=1  测试 R² = 0.93465
    seed=2  测试 R² = 0.93335
    seed=3  测试 R² = 0.93183
    seed=4  测试 R² = 0.93420
  → 测试 R² 在 0.93183 ~ 0.93465 之间抖,极差 0.00282
★ 这就是本章标题里的"抖动":
同一份数据 → 同一个模型类 → 只换随机种子
   ↓
测试 R² 在 0.9318 ~ 0.9346 之间跳
   ↓
你报告 0.9346 还是 0.9318,取决于一个你没写进报告的参数这件事为什么严重:如果你用单棵树去比较两个特征方案, 方案 A 抽到 seed=1(0.93465)、方案 B 抽到 seed=3(0.93183), 你会得出"方案 A 更好"的结论 —— 而这个结论只反映了种子。
点开:树为什么会"抖"?(不需要公式,看它在干什么就行)
一棵树训练时在做的事:
在每一列上找一个"切一刀最有效"的位置
   ↓
但"最有效"是在【当前这批训练行】上算出来的
   ↓
换掉几行 → 最好的切点可能换一个 → 后面的子树整片重排用一句话说:
树是一个"贪心 + 依赖具体样本"的结构,没有平滑机制。 数据里一点点变化,会在深层的分裂点上被放大。
对比线性回归:它的解是"让所有点的平方误差最小", 换掉一行,系数只动一点点。 所以它的训练-测试差距只有 0.00043,几乎不抖。
★ 但稳定不等于好:
线性回归:稳定,但测试 R² 0.94253
单棵树  :抖动,测试 R² 0.93183 ~ 0.93465
            ↑
   一个"稳而不准"的模型,和一个"又抖又不准"的模型
两者都不够好。 这一章要做的是既稳又准, 而它用的办法不是"改造一棵树",是"种很多棵,然后取平均"。
★ 一个必须先建起来的心智模型:
一棵深树      = 一个偏科的学生,把这批数据背得很熟

200 棵深树    = 200 个学生,每人只看了【随机的一部分】数据
                ↓
              让他们各自答题,然后取平均
                ↓
              有人偏左、有人偏右,误差互相抵消
                ↓
平均下来反而更接近正确答案这不是比喻,是可以量化的(17.4 会亲手验证)。
17.2 Bagging:两味药,缺一不可
"随机森林"这个名字里的"随机",指的就是这两味药:
| 药 | 做法 | 治什么 |
|---|---|---|
| ① 有放回抽样(bootstrap) | 每棵树训练前,从训练集里有放回抽同样多的行 | 让每棵树看到的数据不同 |
| ② 聚合平均(aggregating) | 分类投票 / 回归取平均 | 把个体的抖动抵消掉 |
合起来叫 Bagging:Bootstrap AGGregatING。
真实输出(每棵树有放回抽 17,244 次,其中不重复的样本占多少):
    200 棵树实测:mean 0.6321  min 0.6260  max 0.6370
    理论值 1-(1-1/n)^n = 0.6321
  → 每棵树只见到约 63.21% 的训练行,剩下约 36.79% 是「袋外(OOB)」样本。
"每棵树约 63%"这个数字从哪来(给直觉,不推导):
一次抽样,某一行【没被抽到】的概率 = 1 - 1/n
抽 n 次都没被抽到的概率           = (1 - 1/n)^n
n 很大时,这串数趋近一个常数      ≈ 0.3679

所以:约 36.79% 的行没进这棵树的训练集
      约 63.21% 的行进了(其中有重复的行只算一次)
★ 两味药分别有多重要?亲手做一次对照:
真实输出(手写 30 棵深树,只做有放回抽样 + 平均):
    30 棵树的单棵测试 R²:mean 0.93655  min 0.93057  max 0.94349
    30 棵树【预测取平均】后:训练 R² = 0.99806  测试 R² = 0.96363
→ 单棵的分数没变好,变好的是「平均」这件事。读懂这三行:
单棵:0.93057 ~ 0.94349(抖得厉害,而且方差比 sklearn 的单棵树更大,
      因为这 30 棵树各自只看了 63% 的数据)
平均:0.96363            ← 比【最好的那一棵】还高
★ 关键认知:
平均之后的效果,好于其中任何一棵。 这就是 Bagging 的全部秘密 —— 它不是"选出了最好的树",它是"把树们的误差互相抵消了"。
点开:为什么"取平均"能变准?(一个粗糙但够用的推理)
假设每棵树的预测可以拆成两块:
某棵树的预测 = 真值 + 这棵树的固有偏差 + 这棵树自己的随机误差
                                  ↑                ↑
所有树都差不多(消不掉) 每棵树不一样(能抵消)取平均之后:
200 棵平均 = 真值 + 固有偏差 + (200 个随机误差的平均)
                                  ↑
随机误差的平均 ≈ 0(它们互相抵消)于是剩下两件事:
| 剩下的 | 能不能靠"多棵树"消掉 |
|---|---|
| 固有偏差(树这类模型共同的盲区) | ❌ 不能 |
| 每棵树的随机误差 | ✅ 能(这就是 17.1 的抖动) |
★ 这一条推出本章最重要的结论:
Bagging 只能消掉"树与树之间的差异",消不掉"所有树共有的盲区"。
所以"森林治不了欠拟合" —— 17.6 会亲手验证。
再说一遍这三块的名字(第 18 章会用一整章拆它们): 偏差(bias,所有树共有的盲区)、方差(variance,树与树之间的差异)、噪声(消不掉)。
17.3 ★ 三个"人人都说、但和实现不符"的细节
这一段是本章的"看起来对但其实错"。三个说法都很常见,但你在 sklearn 里照着做会出错。
17.3.1 "随机森林每次分裂只看随机一小撮特征"
这句话在分类里对,在回归里不是默认。
真实输出:
  ★ 顺手验一个传言:'随机森林每次分裂只看随机一小撮特征'
    默认 max_features = 1.0(回归的默认值是全部特征,不是分类里的 sqrt)
    每棵树实际可用的特征数 = 7 / 总特征数 7
对照一下两个 sklearn 类的默认值:
| 类 | max_features 默认值 | 每次分裂看几个特征(本表 7 列) |
|---|---|---|
RandomForestClassifier | "sqrt" | 约 2~3 个 |
RandomForestRegressor | 1.0 | 全部 7 个 |
所以在这张表上,回归森林的"随机"只来自有放回抽样,不来自特征抽样。
那显式抽特征会怎样?
真实输出:
  max_features=1.0    训练 R² 0.99838  测试 R² 0.96503
  max_features=0.5    训练 R² 0.99858  测试 R² 0.96515
  max_features=sqrt   训练 R² 0.99858  测试 R² 0.96533
max_features=2 训练 R² 0.99858 测试 R² 0.96533三个观察:
① 抽特征确实有一点用:0.96503 → 0.96533(+0.00030)
② 但收益小得可怜 —— 因为这张表只有 7 个特征,
   抽 2 个和抽 7 个的差别本来就不大
③ 【特征越多,抽特征越重要】
★ 什么时候该把 max_features 调小:
| 场景 | 建议 |
|---|---|
| 特征少(<10 个) | 默认 1.0 就行,别折腾 |
| 特征几十上百个,且互相相关 | 调成 0.3~0.5,值得一试 |
| 需要极限压榨最后一分 | 把 max_features 放进网格搜索 |
纪律:"随机森林会随机选特征"这句话,在写报告前先跑一行确认:
print(RandomForestRegressor().max_features) # 1.0 ← 回归的默认值17.3.2 更危险的坑:oob_score_
袋外(OOB)分数听起来非常诱人:
每棵树有约 36.79% 的训练行没见过
   ↓
拿这些"没见过"的行给每棵树打分,再汇总
   ↓
不用单独留测试集,就得到一个"泛化分数"真实输出:
=== ③b 再验一个更危险的陷阱:OOB 分数 ===
  袋外(OOB)R² = 0.98806   ← 不用单独留测试集,看起来很省事
  按【行】随机划分的测试 R² = 0.98764
  按【设备】划分的测试 R²   = 0.96503
  → OOB 比按设备划分高了 0.02304,和按行随机划分几乎一样。
★ 看懂这三行:
OOB            0.98806
按行随机划分    0.98764   ← OOB 几乎等于它
按设备划分      0.96503   ← 这才是你要回答的问题
为什么 OOB 更像"按行随机划分":
OOB 的"袋外"是【行】层面的袋外:
   第 100 行没进第 7 棵树的袋
   ↓
   但第 99 行和第 101 行(同一支设备、只差 2~4 圈)大概率在袋里
   ↓
   这棵树照样"见过这支设备长什么样"
   ↓
   OOB 评估的是「对没见过的行准不准」
★ 而你要回答的问题是:
对一支没见过的设备,这个模型准不准?
这两个问题的答案差 0.02304。
结论:
| 做法 | 能不能替代留出测试集 |
|---|---|
oob_score_(数据有分组结构时) | ❌ 不能,它和按行划分同病 |
oob_score_(每行真是独立个体时) | ✅ 可以用,省一次划分 |
回到第 09~10 章的纪律:先问"这一行是什么",再决定怎么评估。
17.3.3 第三个细节:n_jobs=-1 只影响耗时
真实输出:
  n_jobs= 1  训练 R² 0.99834  测试 R² 0.96487  耗时  77.85s
  n_jobs=-1  训练 R² 0.99834  测试 R² 0.96487  耗时   7.82s
分数一模一样,耗时差近 10 倍(77.85s vs 7.82s)。
n_jobs=1   → 单核,一棵一棵种
n_jobs=-1  → 用上所有核,同时种
★ 纪律:
并行只影响"多久跑完",不影响"结果是什么"。 如果你的结果随
n_jobs变了,那是代码里有别的随机性没固定。
顺便说一句:本章所有耗时都是本机 8 核的实测值, 换一台机器数字会变(这也是"耗时不能跨机器比较"的一个例子)。
⚠️ 还有一个更隐蔽的坑:这些数字是在一台同时跑着别的任务的机器上量的。 同一段代码(森林 200 棵)在机器空闲时量到 4.89s,忙的时候量到 27.48s —— 差了 5.6 倍,而代码一个字没改。
这个教训比"绝对值"重要:
   只要报告耗时,就必须写清楚"在哪台机器上、当时忙不忙、量了几次"
   否则那个数字没有意义
17.4 可运行示例
本章你需要完成的代码:demos/ch17-random-forest.py
cd code
python demos/ch17-random-forest.py它按顺序做七件事(每一件都对应上面某一节):
① 先看病的症状:单棵无限深树的训练/测试分 + 换种子的抖动
② 森林干了什么:63% 的抽样实测 + 手写 30 棵树的平均
③ sklearn 的森林 200 棵:和单棵树正面对比
③b OOB 分数的陷阱
④ n_estimators 扫描:从 1 棵到 500 棵
⑤ max_features:真去抽一小撮特征会怎样
⑥ n_jobs:并行只影响耗时
⑦ 森林治不了欠拟合:把每棵树都限成浅树关键代码只有三行(其余都是打印和画图):
from sklearn.ensemble import RandomForestRegressor

rf = RandomForestRegressor(n_estimators=200, random_state=42, n_jobs=-1)
rf.fit(X_tr, y_tr)
★ 和上一章的单棵树比,改动只有两处:
- from sklearn.tree import DecisionTreeRegressor
- model = DecisionTreeRegressor(random_state=42)
+ from sklearn.ensemble import RandomForestRegressor
+ model = RandomForestRegressor(n_estimators=200, random_state=42, n_jobs=-1)真实输出(第 ③ 段):
=== ③ sklearn 的森林:200 棵 ===
  森林 200 棵:训练 R² = 0.99838   测试 R² = 0.96503   差距 = 0.03335
  对比单棵树:差距 0.06653 → 0.03335(缩小到原来的 50.1%)
  测试 R²:0.93347 → 0.96503(+0.03156)
★ 这段输出里最重要的不是 0.96503,是"差距缩小到 50.1%":
单棵深树的病:差距 0.06653(训练记住、测试认不出)
森林的药效  :差距 0.03335(砍掉一半)
   ↓
但注意:0.03335 还是不小 —— 森林不是把病治好了,
        它是把病【减轻了一半】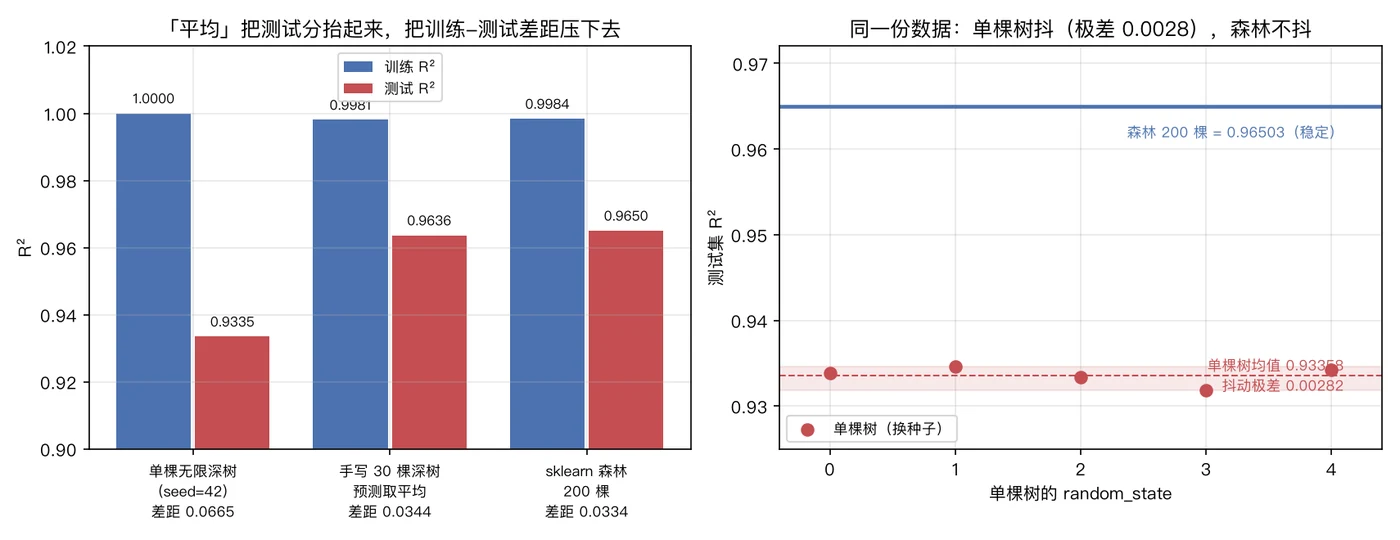
⚠️ 一个必须澄清的说法:
❌ "森林的训练 R² 是 0.99838,说明它比单棵树好"
   ↑ 训练分高只说明模型复杂度够,不说明泛化好

✅ "森林的测试 R² 从 0.93347 涨到 0.96503,差距从 0.06653 降到 0.03335"
   ↑ 这才是它的价值:同样的模型复杂度,更小的泛化差距
17.5 树数扫描:什么时候"加树"就是浪费
真实输出:
  n_estimators=   1  训练 R² 0.98812  测试 R² 0.94096  耗时   0.42s
  n_estimators=   2  训练 R² 0.99330  测试 R² 0.95287  耗时   0.68s
  n_estimators=   5  训练 R² 0.99640  测试 R² 0.96002  耗时   0.66s
  n_estimators=  10  训练 R² 0.99733  测试 R² 0.96324  耗时   1.44s
  n_estimators=  25  训练 R² 0.99798  测试 R² 0.96444  耗时   2.95s
  n_estimators=  50  训练 R² 0.99821  测试 R² 0.96427  耗时   5.33s
  n_estimators= 100  训练 R² 0.99834  测试 R² 0.96487  耗时  11.23s
  n_estimators= 200  训练 R² 0.99838  测试 R² 0.96503  耗时  27.48s
  n_estimators= 500  训练 R² 0.99841  测试 R² 0.96510  耗时  60.35s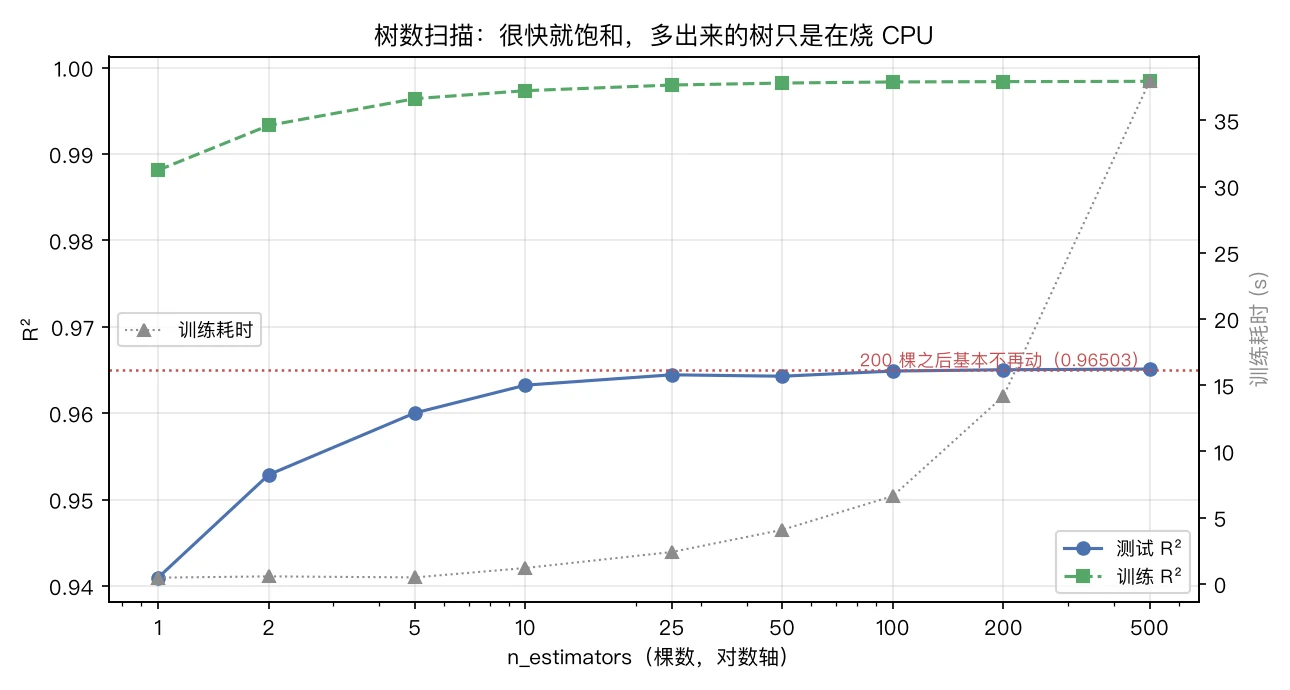
把这张表翻译成"该种几棵":
| 棵数 | 测试 R² | 从上一档涨了多少 | 结论 |
|---|---|---|---|
| 1 | 0.94096 | — | 太抖 |
| 10 | 0.96324 | +0.02228 | 收益最大的区间 |
| 50 | 0.96427 | +0.00103 | 已经很接近上限 |
| 200 | 0.96503 | +0.00016(从 100 起) | 本项目选的档位 |
| 500 | 0.96510 | +0.00007 | 纯烧 CPU:耗时 60.35s 换 0.00007 |
★ 三条纪律:
① 1 → 50 棵是"雪中送炭",50 → 500 棵是"锦上添花",
   后面那段收益几乎为零

② 加树的收益是【递减】的,但耗材是【线性】的:
   500 棵的耗时(60.35s)是 200 棵(20.21s)的 3.0 倍

③ ★ 和后面要讲的提升模型对比:
   森林加树【只会不再变好】,不会变坏 —— 这是它"省心"的原因
★ 为什么是"不会变坏":
森林做的是【平均】:
   多加一棵树 = 在平均里多一项
   ↓
   平均的方差只会越小(不会反过来变大)
这一点在第 19 章会形成鲜明对比 —— 提升模型加树会变差。
点开:那为什么"生产里常见 1000 棵树"?
因为"收益为零"和"收益为负"是两件事:
实测:n_estimators 200 → 500,测试 R² 从 0.96503 涨到 0.96510(+0.00007)
      而训练耗时从 20.21s 涨到 60.35s(约 3 倍)
   ↓
   离线批量跑(一天一次,不急)→ 加就加了,不亏
   线上实时训练(每次请求都要重训)→ 这是灾难
★ 所以"多少棵树合适"取决于三件事:
| 考虑 | 影响 |
|---|---|
| 分数还能不能涨 | 涨不动了就别加(本例 200 棵以后) |
| 训练耗时预算 | 离线 vs 在线,差两个数量级 |
| 预测延迟与模型体积 | 1000 棵树的模型文件是 200 棵的 5 倍 |
一个可操作的做法:
# 画一条"加树曲线",找拐点,而不是拍脑袋定一个数
for k in (10, 25, 50, 100, 200, 400):
    print(k, r2_score(y_te, RandomForestRegressor(n_estimators=k,
                                                  random_state=42,
                                                  n_jobs=-1).fit(X_tr, y_tr)
                      .predict(X_te)))
只要"再加一倍树,测试分涨不到 0.0005",就停手。
17.6 ★ 森林治不了欠拟合
这一节是引出第 18、19 章的关键。
做法:把每一棵树都限制成浅树(max_depth=2/3/4), 然后看"200 棵树平均"这件事能救回多少。
真实输出:
  200 棵 max_depth=2:训练 R² 0.89811  测试 R² 0.89407
  200 棵 max_depth=3:训练 R² 0.93491  测试 R² 0.93085
  200 棵 max_depth=4:训练 R² 0.95114  测试 R² 0.94265
  对照 · 线性回归(1 个模型,不需要种树):测试 R² 0.94253
  → 200 棵 max_depth=2/3 的树都明显不如一条直线;
    max_depth=4 也只是和直线打平(0.94265 vs 0.94253)。
★ 这张表推翻了一个很常见的直觉:
"200 棵树总比 1 棵树强吧?"
   ↓
200 棵 max_depth=2 的树:0.89407
1 条直线             :0.94253
   ↓
200 个笨蛋的平均,不会变成聪明人。
用 17.2 的语言解释:
200 棵浅树有没有"树与树之间的差异"?
   有,但这个差异很小(因为它们都很简单,都很像)

200 棵浅树有没有"共同的盲区"?
   有,而且很大 —— 所有浅树都是同一类"学不到复杂关系"的模型
   ↓
"平均"能消掉第一项,消不掉第二项
   ↓
结果:200 棵浅树 ≈ 1 棵浅树 ≈ 欠拟合
★ 所以有了本章最重要的判断:
| 你在治什么 | 森林有没有用 |
|---|---|
| 单棵树的训练-测试差距大(抖动、方差) | ✅ 有用(0.06653 → 0.03335) |
| 模型根本学不到规律(两条线都低、差距小) | ❌ 没用(0.89407 vs 线性 0.94253) |
这两句话的正式名字是"偏差"与"方差" —— 第 18 章会把它们拆开讲清楚,并给出一条可操作的判据; 第 19 章会给治"偏差"的那条路(提升)。
17.7 常见坑
① 把 n_estimators 拉到 2000 求安心
   → 200 棵之后基本不再涨(0.96503 → 500 棵 0.96510),只烧 CPU

② 以为森林能治欠拟合
   → 200 棵 max_depth=2:测试 R² 0.89407,连线性回归(0.94253)都不如

③ 相信 oob_score_ 可以替代留出测试集
   → 本数据上它 0.98806,比按设备划分(0.96503)高 0.02304

④ 以为"随机森林会随机抽特征"
   → RandomForestRegressor 的 max_features 默认是 1.0(全部特征)

⑤ 用森林就忘了按设备划分
   → 森林自己不会帮你防泄漏,它只会把虚高的分数算得更稳定

⑥ 报告"森林训练 R² = 0.99838"
   → 训练分不是结论;要说的是"测试 0.96503、差距 0.03335"
★ 其中 ③ 和 ⑤ 是同一个病:
同一支设备的相邻行只差 2~4 圈,soh 只差 0.0003 量级
   ↓
按行划分 / OOB / 按行随机 → 都会让"兄弟行"跨进测试侧
   ↓
分数虚高约 0.023
   ↓
森林不会救你,它只会让这个虚高的分数【更稳定、更可信的样子】这才是这本书反复要说的那句:
模型再换,评估不对,一切都是零。
17.8 完整示例与输出
cd code
python demos/ch17-random-forest.py真实输出(节选):
==========================================================================
第 17 章 · 随机森林:种 200 棵树治「抖动」
==========================================================================
数据:data/battery/soh_features.csv   21239 行 / 60 支设备
划分:按设备编号 GroupShuffleSplit(seed=42),训练 17244 行 / 48 支,测试 3995 行 / 12 支
两边设备有交集:False

=== ① 先看病的症状:单棵无限深树 ===
  单棵无限深树:训练 R² = 1.00000   测试 R² = 0.93347   差距 = 0.06653

=== ② 森林干了什么:有放回抽样 + 平均 ===
    200 棵树实测:mean 0.6321  min 0.6260  max 0.6370
   → 每棵树只见到约 63.21% 的训练行,剩下约 36.79% 是「袋外(OOB)」样本。

=== ③ sklearn 的森林:200 棵 ===
  森林 200 棵:训练 R² = 0.99838   测试 R² = 0.96503   差距 = 0.03335

=== ③b 再验一个更危险的陷阱:OOB 分数 ===
  袋外(OOB)R² = 0.98806
  按【行】随机划分的测试 R² = 0.98764
  按【设备】划分的测试 R²   = 0.96503

=== ⑦ 森林治不了欠拟合:把树都限成浅树 ===
  200 棵 max_depth=2:训练 R² 0.89811  测试 R² 0.89407
  对照 · 线性回归(测试 R² 0.94253)

==========================================================================
一句话总结:森林不是「更强的树」,是「很多棵树的平均」。
  它做的事:测试 R² 0.93347 → 0.96503,差距 0.06653 → 0.03335
  它做不到的事:让一群浅树变聪明(第 18、19 章)。
==========================================================================
本章练习
练习 1:手写最小 bagging,亲眼看到"平均"的作用
自己实现 10 棵树的 bagging(不许调 RandomForestRegressor):
- 用
np.random.default_rng(42),每棵树用rng.integers(0, n, n)做有放回抽样; - 每棵树用
DecisionTreeRegressor(random_state=i)(不限深度)训练; - 打印:10 棵树的单棵测试 R² 的 mean / min / max, 以及 10 棵预测取平均后的测试 R²。
要求:第 3 步之后写一句话,说明"平均后的分数和最好的那棵树比,谁高"。
参考答案
import numpy as np
import pandas as pd
from sklearn.tree import DecisionTreeRegressor
from sklearn.metrics import r2_score
from sklearn.model_selection import GroupShuffleSplit

FEATS = ["cycle", "mean_charge_voltage_v", "mean_temp_rise_c", "resistance_mohm",
         "coulombic_eff", "cap_fade_rate_ah_per_100", "temp_std_c"]

df = pd.read_csv("data/battery/soh_features.csv")
X, y, groups = df[FEATS], df["soh"], df["cell_id"]
tr, te = next(GroupShuffleSplit(n_splits=1, test_size=0.2,
                                random_state=42).split(X, y, groups=groups))
X_tr, X_te, y_tr, y_te = X.iloc[tr], X.iloc[te], y.iloc[tr], y.iloc[te]

rng = np.random.default_rng(42)
n = len(X_tr)
preds = np.zeros((10, len(X_te)))
for i in range(10):
    idx = rng.integers(0, n, n)                     # 有放回抽样
    tree = DecisionTreeRegressor(random_state=i).fit(X_tr.iloc[idx], y_tr.iloc[idx])
    preds[i] = tree.predict(X_te)

singles = np.array([r2_score(y_te, p) for p in preds])
print(f"单棵测试 R²:mean {singles.mean():.5f}  min {singles.min():.5f}  "
      f"max {singles.max():.5f}")
print(f"10 棵平均后:测试 R² = {r2_score(y_te, preds.mean(axis=0)):.5f}")期望输出:
单棵测试 R²:mean 0.93623  min 0.93275  max 0.94475
10 棵平均后:测试 R² = 0.96152
第 3 问的回答:
平均后(0.96152)高于最好的那一棵(0.94475),高了 0.01677。 这说明 Bagging 不是"选出最好的树",而是"让树们的误差互相抵消"。
★ 为什么平均能超过最好的那一棵
任何一棵树都在某个方向上"过头"了:
   树 A 在这批测试点上偏高,树 B 在那批上偏低
   ↓
   取平均 = 让偏差互相抵消
   ↓
   平均后的误差 < 典型单棵的误差
注意别把"10 棵"和"我"的数字对错:
不同的 random_state、不同的抽样实现(rng vs RandomState)
   → 具体数字会变(可能第 3 位小数就不同)
   → 但结论不变:平均后的分数 > 单棵的平均分
★ 自己验一遍的方法:把 default_rng(42) 改成 default_rng(7), 看那三个"单棵"数字会不会变 —— 它们会变,而"平均后更高"这件事不会变。
练习 2:树数扫描 —— 找到你自己的"拐点"
用 RandomForestRegressor(n_jobs=-1) 扫 n_estimators ∈ {1, 3, 10, 30, 100, 300}:
- 打印每一档的训练 R²、测试 R²、训练耗时;
- 打印每一档的测试 R² 比上一档涨了多少;
- 回答:如果你只有 10 秒的训练预算,你会选哪一档?为什么?
参考答案
import time
import pandas as pd
from sklearn.ensemble import RandomForestRegressor
from sklearn.metrics import r2_score
from sklearn.model_selection import GroupShuffleSplit

FEATS = ["cycle", "mean_charge_voltage_v", "mean_temp_rise_c", "resistance_mohm",
         "coulombic_eff", "cap_fade_rate_ah_per_100", "temp_std_c"]

df = pd.read_csv("data/battery/soh_features.csv")
X, y, groups = df[FEATS], df["soh"], df["cell_id"]
tr, te = next(GroupShuffleSplit(n_splits=1, test_size=0.2,
                                random_state=42).split(X, y, groups=groups))
X_tr, X_te, y_tr, y_te = X.iloc[tr], X.iloc[te], y.iloc[tr], y.iloc[te]

prev = None
for k in (1, 3, 10, 30, 100, 300):
    t0 = time.time()
    m = RandomForestRegressor(n_estimators=k, random_state=42,
                              n_jobs=-1).fit(X_tr, y_tr)
    dt = time.time() - t0
    a, b = r2_score(y_tr, m.predict(X_tr)), r2_score(y_te, m.predict(X_te))
    gain = "" if prev is None else f"  比上一档 {b - prev:+.5f}"
    print(f"n_estimators={k:4d}  训练 {a:.5f}  测试 {b:.5f}  耗时 {dt:5.2f}s{gain}")
prev = b期望输出:
n_estimators=   1  训练 0.98812  测试 0.94096  耗时  0.69s
n_estimators=   3  训练 0.99497  测试 0.95694  耗时  0.54s  比上一档 +0.01598
n_estimators=  10  训练 0.99733  测试 0.96324  耗时  1.53s  比上一档 +0.00630
n_estimators=  30  训练 0.99807  测试 0.96422  耗时  3.55s  比上一档 +0.00098
n_estimators= 100  训练 0.99834  测试 0.96487  耗时 14.74s  比上一档 +0.00065
n_estimators= 300  训练 0.99839  测试 0.96514  耗时 39.10s  比上一档 +0.00027
第 3 问的回答:
选 30 棵。
理由:30 棵已经拿到 0.96422(距 300 棵的 0.96514 只差 0.00092), 耗时 3.55s;而 300 棵要 39.10s,买到的 0.00092 分完全不值。
"10 秒预算"这个限制下,选 100 棵(14.74s)已经超预算了, 所以真正的答案是 30 棵(3.55s) —— 剩下的预算留给别的实验。 真正不该做的是"因为不确定,就选 300 棵":那等于用 39 秒换 0.0009 分。
★ 这张表里最值钱的一列是"比上一档"
+0.01598  ← 1 → 3 棵
+0.00630
+0.00098
+0.00065  ← 100 棵时,每加一批树只值万分之六
+0.00027 ← 300 棵时,加树已经和"噪声"同量级了判断标准(可操作):
当"再加一批树"的收益小于 0.0005,就停手。
⚠️ 注意耗时会变:上面的耗时是本机 8 核的实测值,而且当时机器上同时在跑别的任务 (同一段代码在机器空闲时量到的 300 棵是 6.54s,忙的时候是 39.10s,差了 6 倍)。 换一台机器、换 n_jobs 也都会变。 所以要比较的是"分数的增量",不是绝对耗时 —— 这一条在真实项目里同样成立: benchmark 必须在机器空闲时做,否则你量到的是"别人的任务"。
练习 3:亲手验证 OOB 分数的陷阱
用同一份数据做三件事:
- 训练一个
oob_score=True的森林(200 棵),打印oob_score_; - 用
train_test_split(按行随机划分,random_state=42)训练同一个森林,打印测试 R²; - 用按设备划分的测试 R² 作对照,算出 OOB 分别和两者差多少;
- 回答:如果我只报告 OOB 分数,我会高估多少?
参考答案
import pandas as pd
from sklearn.ensemble import RandomForestRegressor
from sklearn.metrics import r2_score
from sklearn.model_selection import GroupShuffleSplit, train_test_split

FEATS = ["cycle", "mean_charge_voltage_v", "mean_temp_rise_c", "resistance_mohm",
         "coulombic_eff", "cap_fade_rate_ah_per_100", "temp_std_c"]

df = pd.read_csv("data/battery/soh_features.csv")
X, y, groups = df[FEATS], df["soh"], df["cell_id"]

# 按设备划分
tr, te = next(GroupShuffleSplit(n_splits=1, test_size=0.2,
                                random_state=42).split(X, y, groups=groups))
rf = RandomForestRegressor(n_estimators=200, oob_score=True, bootstrap=True,
                           random_state=42, n_jobs=-1)
rf.fit(X.iloc[tr], y.iloc[tr])
group_te = r2_score(y.iloc[te], rf.predict(X.iloc[te]))

# 按行随机划分
Xr_tr, Xr_te, yr_tr, yr_te = train_test_split(X, y, test_size=0.2, random_state=42)
rf_row = RandomForestRegressor(n_estimators=200, random_state=42,
                               n_jobs=-1).fit(Xr_tr, yr_tr)
row_te = r2_score(yr_te, rf_row.predict(Xr_te))

print(f"OOB(袋外)R²          = {rf.oob_score_:.5f}")
print(f"按【设备】划分测试 R²  = {group_te:.5f}")
print(f"按【行】随机划分测试 R² = {row_te:.5f}")
print(f"OOB 与按行划分差 {abs(rf.oob_score_ - row_te):.5f},"
f"与按设备划分差 {abs(rf.oob_score_ - group_te):.5f}")期望输出:
OOB(袋外)R²          = 0.98806
按【设备】划分测试 R²  = 0.96503
按【行】随机划分测试 R² = 0.98764
OOB 与按行划分差 0.00043,与按设备划分差 0.02304
第 4 问的回答:
我会高估 0.02304。
OOB 报出 0.98806,而"对没见过的设备"的真实水平是 0.96503。 它和按行随机划分(0.98764)只差 0.00043 —— 也就是说,OOB 本质上就是一次"按行"的袋外评估。
★ 为什么 OOB 和"按行"是同一个病
OOB 的袋外判断发生在【行】这个层面:
   第 100 行没进第 7 棵树
   ↓
   但它同一支设备的邻居(99、101 行)多半在袋里
   ↓
   这棵树见过"这支设备的脾气"
   ↓
   OOB 于是测的是"对没见过的行准不准"
★ 一个可迁移的判据
| 你的数据 | oob_score_ 能用吗 |
|---|---|
| 每行是独立个体(一张订单、一个用户) | ✅ 可以,省一次划分 |
| 一行属于某个实体(设备/用户/门店),实体出现多次 | ❌ 不行,它和按行划分同病 |
★ 报告纪律
❌ "我们的模型 R² = 0.988"(其实是 OOB)
✅ "OOB R² = 0.98806;按设备留出的测试集 R² = 0.96503。
    两者差 0.02304,因为 OOB 是在行层面做的袋外评估。"
第二行写法看起来啰嗦,但它才是诚实的说法 —— 在评审会上,这两种写法决定了别人信不信你的结论。
面向工程实践:森林在真实项目里的位置
① 它是"最省心的基线",但不是"最强的模型"
优点:
   · 几乎不用调参(n_estimators 到 200~500 就够,别的用默认)
   · 不用标准化(树按大小切分,与量纲无关)
   · 对缺失值、异常值相对不敏感
   · 能给出特征重要性(第 20 章)
   · 加树不会变坏(只会不再变好)

代价:
   · 模型体积大(200 棵树 ≈ 十几 MB 量级)
   · 单行预测比线性模型慢一个量级
   · 外推能力为零(树只会在训练范围内取值)
   · 给不出不确定性
② 什么时候选它、什么时候不选
| 场景 | 选什么 | 理由 |
|---|---|---|
| 表格数据、要一个稳的起点 | 森林 | 默认参数就不容易翻车 |
| 需要"这个预测有多不可靠" | 高斯过程 / 分位数回归 | 森林给不出 ±σ |
| 需要外推到训练范围之外 | 线性/物理模型 | 森林只会"取边界值" |
| 边缘设备、延迟预算 100ms | 线性模型 | 森林单行预测更慢 |
| 特征几百个且相关 | 森林(max_features 调小) | 它的随机性在这里开始起作用 |
★ 一个可以直接抄进方案的判断顺序:
① 先算一个线性回归 —— 它是"地板"
② 再算一个森林 200 棵 —— 它是"性价比最高的天花板"
③ 如果森林比线性高不到 0.01 → 卡点不在模型,去改特征(第 27 章)
④ 如果森林比线性高很多 → 关系确实是非线性的,再考虑提升(第 19 章)在本项目的数据上,这个顺序的结果是:
线性回归  0.95053
随机森林  0.96503   ← 高出 0.0145,值得用
提升      0.96429   ← 和森林打平(第 19 章实测:差 0.00074)
③ 一个容易忽略的成本:模型体积与推理延迟
森林 200 棵 × 每棵 16,774 个叶子
   ↓
   序列化后模型文件很大,加载慢
   ↓
如果这个模型要下发到 1000 台边缘设备上,这就是硬约束验收时该问的问题:
① 模型文件多大?
② 单行预测多少毫秒?(第 26 章的横评里会量)
③ 重训一次要多久?(决定"数据多久更新一次")
④ 最后一条:森林不改变"评估纪律"
这一章讲的都是"怎么把分数做稳", 但**"分数该在哪个数据上算"这件事,森林帮不了你**:
按行划分 → 0.98764
按设备划分 → 0.96503
OOB      → 0.98806(≈按行)

三个数字都是同一个森林算出来的。
换模型不会改变这个 0.023 的虚高 ——
只有换划分方式才会。
★ 这也是这本书每一章都在重复的一件事:
模型是容易换的,评估纪律是必须建的。 前者花十分钟,后者决定这个项目有没有意义。