第 09 章 · 训练 / 测试划分:按「设备」切,不是按「行」切
这一章要解决什么:把 21,239 行的表切成"训练用"和"考试用"两份, 并且让这次切割回答一个真实的问题 —— 对一支从没见过的设备,模型准不准?
最容易踩的坑: ① 以为
test_size=0.2切的是"20% 的行" —— 按设备切时,它切的是设备数; ② 只验证"两边行号没有重叠",就以为划分干净了 —— 真正要查的是设备有没有重叠; ③ 按设备切完就以为万事大吉 —— 真实投产时,你还得问"换一批设备还行吗"。
本章你需要完成的代码:demos/ch09-train-test-split.py
9.1 为什么要"留一手"
先看一个思想实验。
你想知道自己有多会做某类题。
方案 A:把所有题都做完,然后看着答案说"这些题我都会"。
方案 B:先做 80 道,对照答案总结规律;再把最后 20 道当考试,做完才看答案。
方案 A 的问题不是"你撒谎了",而是它根本没有测量任何东西 —— 你看着答案说会,这句话没有信息量。
机器学习里完全一样:
| 名字 | 别名 | 用途 | 你允许看它几次 |
|---|---|---|---|
| 训练集(train) | 学习集 | 让模型学参数 | 无数次 |
| 测试集(test) | 留出集、hold-out | 估计"对没见过的样本有多准" | 只看一次 |
关键不是"分成两份",而是"分完之后不许偷看"。
点开:为什么"在训练集上的分数"几乎没有意义
这要用第 08 章的 R² 来说。
R² = 1 - 模型的平方误差 / 用均值预测的平方误差训练集上的 R² 衡量的是"模型记住训练数据的程度",不是"预测能力"。
极端例子(第 18 章会正式量化):
# 一棵不限深度的决策树
tree = DecisionTreeRegressor(random_state=42).fit(X_tr, y_tr)

print(tree.score(X_tr, y_tr))    # 1.00000   ← 完美
print(tree.score(X_te, y_te)) # 0.93347 ← 真实水平原因:不限深的树可以把每个训练样本单独放进一个叶子, 预测时直接输出那个样本的标签 —— 它在背诵,不是在学规律。
★ 一条纪律:
任何"在训练数据上算出来的分数",都不能作为能力证据。 它只能用来判断"模型有没有学会(欠拟合了没有)"。
这条纪律的推论:
训练分数低  →  模型太弱 / 训练不充分        → 有用信息
训练分数高  →  什么都说明不了               → 无用信息
训练 ≫ 测试 →  过拟合                       → 有用信息
测试分数高  →  这才是你要的证据             → 前提是测试集是干净的
最后一行里"干净"这两个字,就是本章的全部内容。
9.2 两种切法,只差一个参数
先看最眼熟的那种写法:
from sklearn.model_selection import train_test_split

train_idx, test_idx = train_test_split(df.index, test_size=0.2, random_state=42)它做的事:把行号洗牌,前 80% 给训练,后 20% 给测试。
再看这一章真正要用的写法:
from sklearn.model_selection import GroupShuffleSplit

gss = GroupShuffleSplit(n_splits=1, test_size=0.2, random_state=42)
train_idx, test_idx = next(gss.split(X, y, groups=groups))     # groups = df["cell_id"]
区别只有 groups= 这一个参数。
train_test_split | GroupShuffleSplit | |
|---|---|---|
| 洗牌的对象 | 行 | 设备(groups 里的每个不同值) |
| 同一设备的行会去哪 | 可能两边都有 | 保证只在一侧 |
test_size=0.2 切掉的是 | 20% 的行 | 20% 的设备 |
| 结果可复现吗 | 是(random_state) | 是(random_state) |
真实输出(本章 demo 的第 ② 节):
  划分方式           训练行数     测试行数     训练设备     测试设备     设备交集     行交集
  按行随机         16,991    4,248       60       60       60       0
  按设备划分        17,244    3,995       48       12        0       0

  test_size=0.2 在【按行】划分里切掉的是 : 4,248 行(= 20% 的行)
  test_size=0.2 在【按设备】划分里留出的是 : 12 支设备(3,995 行,占 18.8% 的行)
  → test_size 切的是【设备数】,不是行数。行数比例只是顺带的结果。
  → 按行随机时,60 支设备【全部】同时出现在两边:设备交集 = 60,不是 0。
★ 这张表要横着读、再竖着读一遍。
横着读:两种切法的行数几乎一样(4,248 vs 3,995,差 6%)。
从"行数"这个角度看,两种切法没有任何区别。竖着读:设备交集 那一列 —— 60 vs 0。
按行随机:60 支设备,每一支都同时在训练集和测试集里。
按设备划分:测试集那 12 支,训练时一支都没见过。
★ 这一列(设备交集)就是"干净"的定义:它必须是 0。
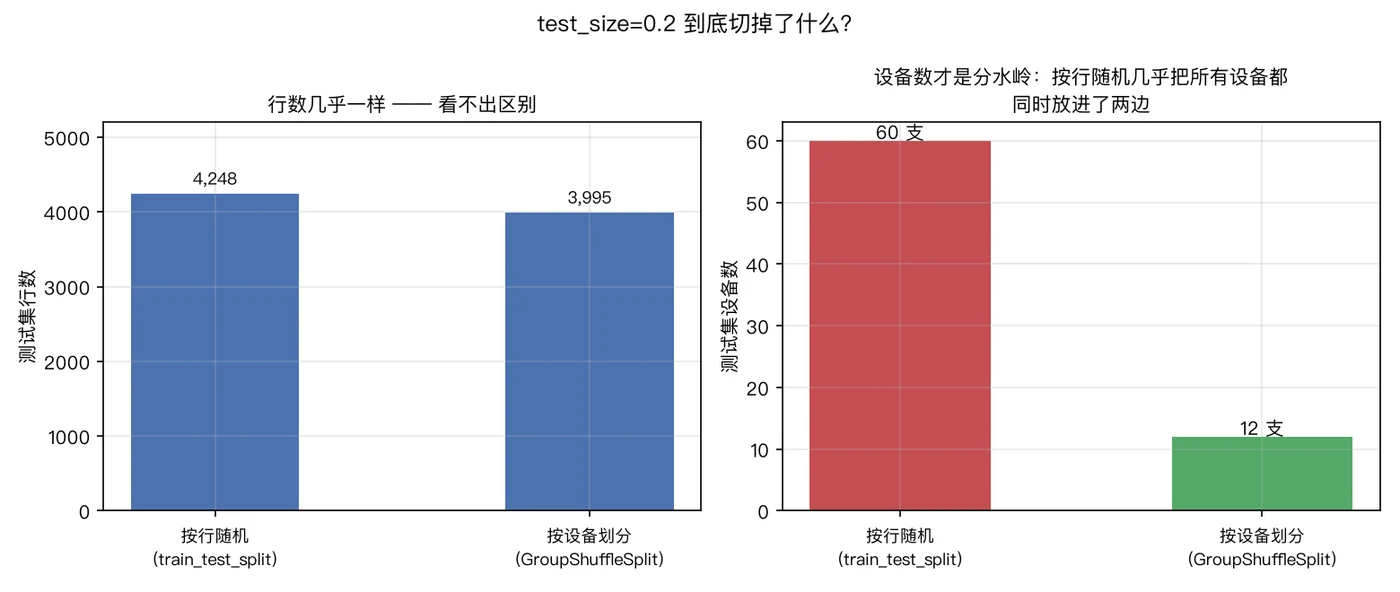
左边这张图说明为什么这个错误很难自己发现: 两条柱子的高度几乎一样(4,248 与 3,995)。 右边这张图才是分水岭:60 支 vs 12 支。
点开:为什么"行交集 = 0"骗过了大多数人
绝大多数人的自检长这样:
assert not (set(train_idx) & set(test_idx)), "训练测试有重叠!"这行断言永远会通过 —— 因为 train_test_split 本来就不会把同一行放进两边。
所以它检查的是"有没有重复行",而不是"有没有泄漏"。
两者的区别:
行交集 = 0
   → 没有一行被同时用了两次
   → 这是【划分的基本要求】,任何 splitter 都满足

设备交集 = 0
   → 没有一支设备的任何信息同时出现在两边
   → 这是【无泄漏的要求】,只有分组 splitter 才满足
★ 一个可以直接抄走的检查函数:
def check_split(df, train_idx, test_idx, group_col):
    tr, te = df.loc[train_idx], df.loc[test_idx]
    rows_overlap = set(train_idx) & set(test_idx)
    groups_overlap = set(tr[group_col]) & set(te[group_col])
    print(f"行交集   : {len(rows_overlap)}   (必须是 0,但通常是 0,没有信息量)")
    print(f"设备交集 : {len(groups_overlap)}   (必须是 0,这才是真检查)")
    assert not groups_overlap, f"泄漏:{len(groups_overlap)} 支设备跨了两边"
★ 顺带说一个反直觉的结论:
"行交集 = 0"是一个几乎不会失败、因此也几乎没有价值的检查。 真正值钱的检查是"分组列交集 = 0"。
这一条在真实项目里能省掉的返工,比本章其他所有内容加起来都多。
9.3 为什么必须按设备切:相邻行几乎一样
现在讲"为什么",而不是"怎么做"。
真实输出(本章 demo 的第 ① 节):
  整表 shape            : (21239, 9)   ← 9 列(7 特征 + 设备编号 + 标签)
  行数                  : 21,239
  设备数                : 60
  每支设备的行数        : min 235 / 中位 356 / max 464
  平均每支设备          : 353.98 行
  → 平均每支设备 354 行 > 1 行 ⇒ 有分组结构,必须按设备切

  同一支设备相邻两行的 cycle 差 : {4.0: 10607, 2.0: 10572}
  同一支设备相邻两行的 |soh| 差 : 中位 0.0016(0.0016 量级)
  而不同设备之间的 soh 差       : 中位 0.0073
  → 相邻行之间的差异,只有跨设备差异的 1/4.5 —— 它们几乎是一个点。
三行数字,一个结论:
21,239 行  ÷  60 支设备  =  354 行/支
                              ↑
                    同一支设备的 354 行,是一条连续曲线上的 354 个点
相邻两行的 cycle 只差 2~4 圈,soh 只差 0.0016(跨设备差异的 1/4.5)。 把这样的两行拆到训练集和测试集两边,等于:
考试的时候,你把标准答案的邻居抄给了考生。真实输出(本章 demo 的第 ③ 节):
  相邻两行被拆到【不同集合】的次数 : 6,757
  (表里一共有 21,179 对相邻行)
  → 占全部相邻对的 31.9%

  随机抽一个实例:设备 C001
    cycle = 56    soh = 0.9898  → 训练集
    cycle = 60    soh = 0.9871  → 测试集   ← 几乎同一个点
将近 1/3 的相邻行对被拆开了。 这不是"偶发几个样本",这是系统性泄漏。
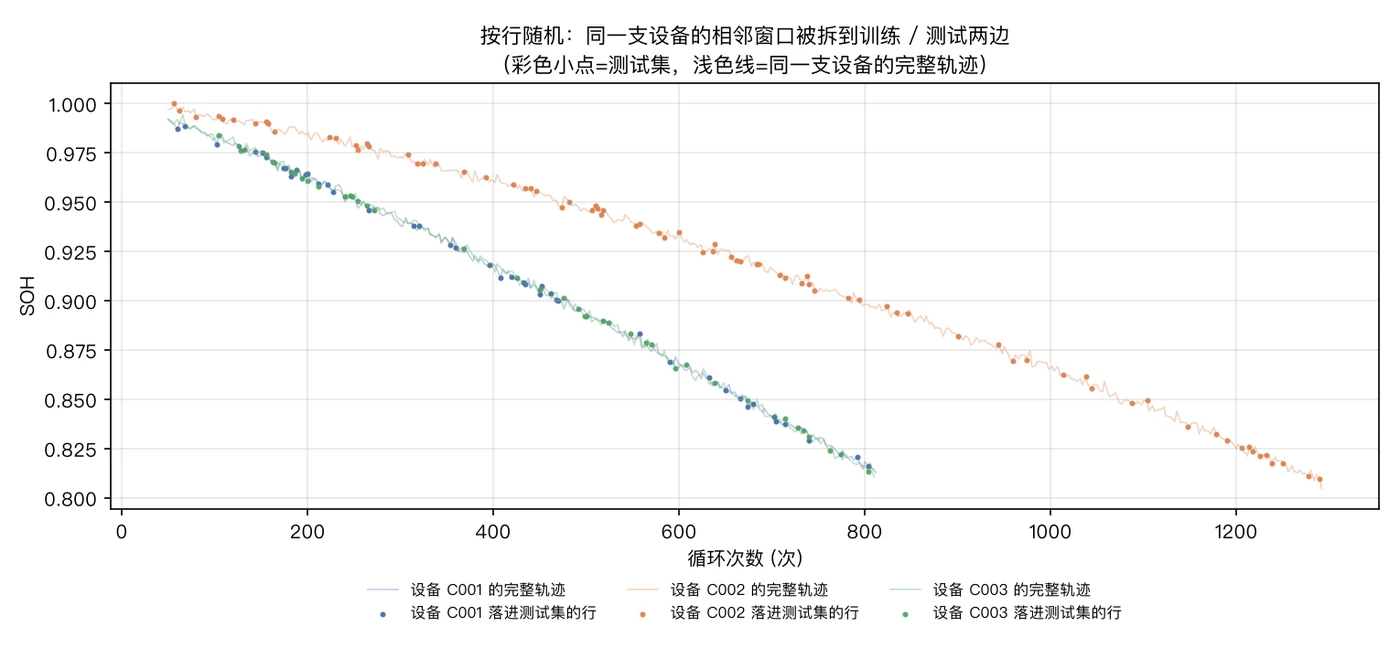
看图的方法:这图里有三支设备(C001/C002/C003)的完整轨迹(浅色线), 彩色小点是其中落进测试集的那些行。
浅色线  →  这支设备的全部 300 多行
彩色点  →  随机抽样后分到测试集的行
注意彩色点不是连续的一段 —— 它们散布在整条曲线上。 也就是说:每一段曲线的邻居都留在了训练集里。
★ 这就是按行随机的真实后果:
你以为在评估:对【没见过的设备】准不准
实际上在评估:对【这支设备的其他行】准不准
两个问题的难度差了一个量级 —— 而这个差距就是第 10 章要量化的"虚高"。
点开:为什么"相邻行相似"这件事是数据本身决定的,不是模型的锅
这不是这份数据碰巧如此。 只要你的数据是"从连续过程里按固定间隔采样出来的",就一定会这样:
| 场景 | "一行"是什么 | 相邻行的间隔 | 相邻行有多像 |
|---|---|---|---|
| 本数据 | 设备 × 100 圈窗口 | 2~4 圈 | soh 差 0.0016 |
| 门店销量 | 门店 × 周 | 1 周 | 高度季节相关 |
| 用户行为 | 用户 × 天 | 1 天 | 兴趣连续 |
| 患者指标 | 患者 × 次就诊 | 几周 | 生理状态连续 |
| 传感器 | 设备 × 分钟 | 1 分钟 | 温度压力几乎不变 |
判据不是"是不是时间序列",而是:
相邻两行的特征与标签,是不是比随机两行更接近?
    是  →  就有"分组 + 相邻"的双重结构 → 必须按实体切
    否  →  按行切也可以
★ 一个 5 行代码的判据:
gap = df.groupby("cell_id")["soh"].diff().abs().dropna()          # 同设备相邻行
far = df.groupby("cell_id")["soh"].mean().diff().abs().dropna()   # 不同设备之间
print(f"相邻行差异中位 : {gap.median():.4f}")
print(f"跨设备差异中位 : {far.median():.4f}")
print(f"比值 : {far.median() / gap.median():.1f} 倍")相邻行差异中位 : 0.0016
跨设备差异中位 : 0.0073
比值 : 4.5 倍比值明显大于 1(这里 4.5 倍) → 分组结构的信号很强 → 必须按分组切。
★ 反过来也要知道:如果这个比值接近 1,说明"同一实体"和"不同实体"的行 长得一样近,那按行切也没关系(比如"每套房一行"的房价数据)。
这就是第 03 章那句"先问这一行是什么"的量化版本。
9.4 验证两边交集为空:三道检查
划分写完不算完,必须验证。 本章 demo 用三道检查:
第一道:分组列交集(最重要)
inter = set(df.loc[train_idx, "cell_id"]) & set(df.loc[test_idx, "cell_id"])
assert len(inter) == 0, f"泄漏:{len(inter)} 支设备跨了两边"第二道:行交集(基本要求,几乎不会失败)
assert not (set(train_idx) & set(test_idx)), "同一行出现在两边"第三道:跨集相邻对数量(把"泄漏的机制"直接数出来)
te_index = set(test_idx)
cross = 0
for _, sub in df.groupby("cell_id"):
    flags = sub.index.isin(te_index)
    cross += int(np.sum(flags[1:] != flags[:-1]))
print(f"相邻两行被拆到不同集合的次数:{cross}")真实输出:
  按设备划分 → 断言通过:{'设备交集': 0, '行交集': 0, '跨集相邻对': 0, '跨集相邻对占比': 0.0}
    → 「跨集相邻对 = 0」这一条,是按设备划分的【数学必然】,也是它可信的原因。
★ 注意 跨集相邻对 = 0 是"数学必然",不是"运气好"。
按设备切 → 一支设备的全部行都在同一侧
         → 同一支设备内部当然不可能有"跨集的相邻对"
         → 这个数字【必然】是 0
所以它比"设备交集 = 0"更彻底:后者只保证"整支设备不跨集", 前者还顺带保证"没有任何跨设备的近邻关系被拉进来"。
★ 三道检查组成一个可以复用的验收函数:
def audit_split(df, train_idx, test_idx, group_col, expect_clean=True):
    tr, te = df.loc[train_idx], df.loc[test_idx]
    groups_overlap = set(tr[group_col]) & set(te[group_col])
    rows_overlap = set(train_idx) & set(test_idx)
    te_index = set(test_idx)
    cross = 0
    for _, sub in df.groupby(group_col):
        flags = sub.index.isin(te_index)
        cross += int(np.sum(flags[1:] != flags[:-1]))
    report = {"设备交集": len(groups_overlap), "行交集": len(rows_overlap),
              "跨集相邻对": cross}
    if expect_clean:
        assert report["设备交集"] == 0, f"泄漏:{sorted(groups_overlap)[:3]}…"
    return report
把它放在你项目的 src/data.py 里,每次划分后调用一次。这一行断言比模型调参值钱得多。
点开:如果分组列交集不为 0,有哪几种补救
发现泄漏之后的四条路,按推荐顺序:
① 换 splitter(最直接)
# ❌ 按行
train_test_split(df.index, test_size=0.2, random_state=42)
# ✅ 按设备
GroupShuffleSplit(n_splits=1, test_size=0.2, random_state=42).split(X, y, groups=df["cell_id"])
② 如果分组列混进了特征,把它拿出来
FEATS = ["cell_id", "cycle", ...]      # ❌
FEATS = ["cycle", ...] # ✅注意:第 04 章说过 —— 如果 cell_id 是数字(1、2、…、60), 它不报错,模型会照常训练,而且分数会偏高。 所以"特征里有没有标识列"这件事,一定要靠代码检查,不要靠肉眼。
③ 如果标不出来"同一实体",就要自己造一个
真实项目里常见的麻烦:数据表里【没有】用户 ID 这一列。
   ↓
但你还有:手机号后四位、设备指纹、订单地址的哈希……
   ↓
用它们凑一个稳定的"实体键"
   ↓
凑不出来怎么办?见 ④
④ 实在标不出来:把结论的范围缩小
# 诚实的写法
print("本评估假设行之间独立;若同一实体出现多行,实际线上表现会低于此值。")
★ 这一条不是"逃避",而是"把限制写进结论"。
第 02 章说过"给数字加限定词" —— 这里就是它的第二次实战。
★ 一张决策表
| 你能不能标出"同一实体"? | 该怎么做 |
|---|---|
| 能,而且实体数 ≥ 20 | GroupShuffleSplit / GroupKFold |
| 能,但实体数只有 3~5 | 按实体交叉验证 + 明确写出"只有 3 个实体,结论不稳" |
| 不能,但能构造代理键 | 先构造,再当实体用 |
| 不能 | 缩小结论范围,并把它写进报告 |
9.5 真投产要按批次再切一层
按设备切完,你已经能回答:
"给我一支全新的设备,我能预测它吗?" → 能,误差水平 ≈ 测试集 R²但真实投产的场景往往不是这句,而是:
"我在 A 产线攒的数据上训练的模型,直接搬到 B 产线,还行吗?"这两句话的差别,就是"设备"和"批次"的差别。
设备  →  个体差异(传感器标定、个体老化快慢)
批次 → 群体差异(同一年、同一供应商、同一工艺版本)真实输出(本章 demo 的第 ④ 节):
  设备批次分布:{'A': 15, 'B': 15, 'C': 15, 'D': 15}(共 4 批)
  场景:用批次 A 的设备建模,上到批次 B 的产线
    批次内设备交集 : 0
    批次 B 的测试 R² : 0.94377
    同一批内按设备 20% 留出的 R² : 0.94253
  → 两个数字回答的是两个不同的问题:'换个批次还行吗' vs '换几支设备还行吗'。
两个数字很接近(0.94377 vs 0.94253)—— 这是一条好消息,不是一条废话。
好消息:换批次没有带来额外的性能崩塌 → 模型学到的是【跨批次通用】的规律但如果反过来(批次外 R² 明显更低),你就要警觉了:
批次内 R² = 0.94,批次间 R² = 0.71
   ↓
说明模型学到的东西里,有相当一部分是"批次专属的"
   ↓
这个模型只能用在同批次的设备上,跨批次要重新训练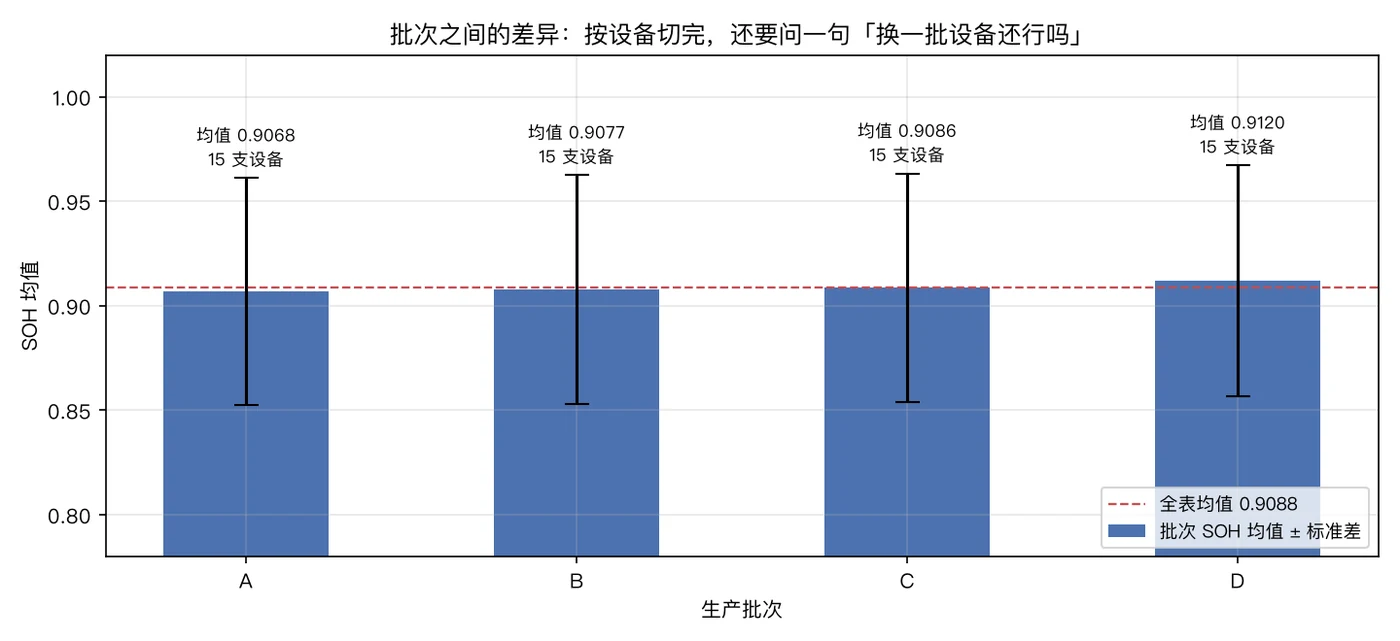
这张图说明怎么提前发现批次问题:
四个批次的 SOH 均值分别是 0.9068 / 0.9077 / 0.9086 / 0.9120,极差 0.0052
而每一批内部的标准差约 0.055
★ 读法:
批次之间的差异(0.005)远小于批次内部的差异(0.055)
     ↓
说明"批次"这个维度带来的偏移不算大
     ↓
但它不是 0 —— 如果你做的是"预测均值"这种精细任务,0.005 就够影响结论了
★ 一个通用做法:把"评估"拆成两个问题
| 你要回答的问题 | 划分方式 | 得到什么 |
|---|---|---|
| 对新设备准不准 | 按设备切 | 个体泛化能力 |
| 对新批次准不准 | 按批次切(留出整批) | 群体泛化能力 |
| 上线后会怎样 | 按时间切(过去→未来) | 时间泛化能力 |
三个都做,你才有资格说"这个模型能上线"。
点开:划分方式决定了"你在评估什么能力"(这是本章最重要的一张表)
同一个模型、同一份数据,换一种切法,你评估的是完全不同的能力:
| 划分方式 | 评估的能力 | 适合回答的问题 | 什么时候会高估 |
|---|---|---|---|
| 按行随机 | (几乎没有真实场景) | 永远高估 | |
| 按设备切 | 对新个体的泛化 | 给一支新设备做预测 | 新批次差异大时 |
| 按批次切 | 对新群体的泛化 | 模型搬去新产线 | 时间漂移大时 |
| 按时间切 | 对未来的泛化 | 明天/下周会怎样 | 实体重复跨越时间点时 |
★ 注意第三列和第四列的关系:
任何一种划分方式,都在【忽略】它没有切掉的那个维度。
     ↓
所以没有一个划分是"万能正确"的。
     ↓
你只能问:我要上线到哪个场景?那个场景里"没见过的东西"是什么?
★ 这个思路在真实项目里的样子
场景:给一个电商平台做"用户会不会复购"的模型

按行随机   → 0.91   ← 同一用户的其他订单泄进来了
按用户切   → 0.83   ← "对新用户准不准"
按时间切   → 0.79   ← "对下个月准不准"
按地区切   → 0.76   ← "开新城市能不能用"

四个数字都不是"错的",它们回答四个不同的问题。
你要报哪一个,取决于【模型要上到哪】。
★ 一句可以直接用在评审会上的话
"这个分数是在『按 X 切』的口径下得到的,它回答的是『对没见过的 X 准不准』。 上线场景里没见过的如果不止 X,那真实表现会更低。"
这句话能把 90% 的"离线很好、上线就崩"的争论提前结束。
9.6 常见坑
① 用 train_test_split 按行切          → 同一设备跨集,分数虚高(第 10 章量化)
② 只检查"行交集 = 0" 就以为干净了      → 行交集从来不会是 0,这个检查没有信息量
③ 以为 test_size 切的是行数            → 按设备切时它切的是设备数
④ 把 cell_id 放进特征                  → 字符串会报错;数字不报错但结果错(第 04 章)
⑤ 分组切完就以为完事                   → 还要问"换一批设备/换一段时间还行吗"
⑥ 只切一次就下结论                     → 单次划分有运气成分(第 11 章量化)
★ 这六个坑排个序
| 坑 | 危险度 | 为什么 |
|---|---|---|
| ① 按行切 | ★★★★★ | 不报错、分数漂亮、上线崩 |
| ④ 标识列进特征 | ★★★★ | 同上,且更难发现 |
| ③ 误解 test_size | ★★★ | 会让你以为"训练数据变少了" |
| ② 检查做错了 | ★★★ | 会让你以为"我检查过了" |
| ⑥ 只切一次 | ★★★ | 误判模型优劣(第 11 章) |
| ⑤ 只切一层 | ★★ | 上线后才知道批次问题 |
★ 三个坑的共同点:它们都不会报错。
报错是好事。
不报错但结果错的,才是真正危险的。
这一章的所有内容,本质都是"把不报错的错误,变成会报错的断言"。
9.7 完整示例与输出
cd code
MPLCONFIGDIR=/tmp/ex03-work/.mplconfig python demos/ch09-train-test-split.py
真实输出(节选):
==============================================================================
① 体检:这张表里「一行」到底是什么
==============================================================================
  整表 shape            : (21239, 9)   ← 9 列(7 特征 + 设备编号 + 标签)
  行数                  : 21,239
  设备数                : 60
  每支设备的行数        : min 235 / 中位 356 / max 464
  平均每支设备          : 353.98 行

==============================================================================
② 两种划分方式并排跑:谁和谁有交集
==============================================================================
  划分方式           训练行数     测试行数     训练设备     测试设备     设备交集     行交集
  按行随机         16,991    4,248       60       60       60       0
  按设备划分        17,244    3,995       48       12        0       0

==============================================================================
③ 为什么按行随机是泄漏:看同一支设备的相邻行去了哪边
==============================================================================
  相邻两行被拆到【不同集合】的次数 : 6,757
  → 占全部相邻对的 31.9%

==============================================================================
④ 真投产还要再切一层:按批次
==============================================================================
  批次 B 的测试 R² : 0.94377
  同一批内按设备 20% 留出的 R² : 0.94253
本章练习
练习 1:亲手比较两种切法的"设备交集"
用 soh_features.csv 做两件事:
- 用
train_test_split(df.index, test_size=0.2, random_state=42)切一次, 打印训练/测试的行数、设备数、设备交集; - 用
GroupShuffleSplit(n_splits=1, test_size=0.2, random_state=42)再切一次, 打印同样四个数字。
要求:用同一张表打印出来,并解释哪一列是"真正的分水岭"。
参考答案
import pandas as pd
from sklearn.model_selection import GroupShuffleSplit, train_test_split

df = pd.read_csv("data/battery/soh_features.csv")
X, y, groups = df.drop(columns=["soh"]), df["soh"], df["cell_id"]

# ① 按行随机
tr_r, te_r = train_test_split(df.index, test_size=0.2, random_state=42)

# ② 按设备划分
tr_g, te_g = next(GroupShuffleSplit(n_splits=1, test_size=0.2, random_state=42)
                  .split(X, y, groups=groups))

print(f"{'划分方式':<10s} {'训练行数':>8s} {'测试行数':>8s} "
      f"{'训练设备':>8s} {'测试设备':>8s} {'设备交集':>8s}")
for name, tr, te in (("按行随机", tr_r, te_r), ("按设备划分", tr_g, te_g)):
    d_tr, d_te = df.loc[tr], df.loc[te]
    print(f"{name:<10s} {len(tr):>8,d} {len(te):>8,d} "
          f"{d_tr['cell_id'].nunique():>8d} {d_te['cell_id'].nunique():>8d} "
f"{len(set(d_tr['cell_id']) & set(d_te['cell_id'])):>8d}")期望输出:
划分方式         训练行数     测试行数     训练设备     测试设备     设备交集
按行随机         16,991    4,248       60       60       60
按设备划分        17,244    3,995       48       12        0
★ 分水岭是最后一列 设备交集。
"训练行数/测试行数" 这两列:两种切法几乎一样(4,248 vs 3,995)
"训练设备/测试设备" 这两列:看起来都"很多"(按行随机是 60/60)
"设备交集"         这一列:60 vs 0
前两列是"看起来"的区别,最后一列是"本质"的区别。
★ 顺带解释第 3、4 列为什么有迷惑性:
按行随机:训练 60 支、测试 60 支 → 每支设备都同时在两边
按设备划分:训练 48 支、测试 12 支 → 12 支完全没进过训练
"训练设备数 = 60" 看起来比 48 更多、更全面 —— 但它恰恰是泄漏的证据**:模型见过每一支设备。**
★ 一个反直觉的推论
在"有没有泄漏"这件事上,"训练集覆盖了 60/60 支设备"是坏消息, "只覆盖了 48/60 支"才是好消息。
★ 自检问题:如果我把 random_state 改成 0,设备交集 会变吗?
不会。按行随机时,设备交集永远是 60(= 全部设备)。
因为 20% 的随机行几乎必然覆盖全部 60 支设备中的每一支。这是一个可以写进断言的"结构性事实":
assert len(set(df.loc[tr_r, "cell_id"]) & set(df.loc[te_r, "cell_id"])) == df["cell_id"].nunique()练习 2:数出"跨集相邻对",并解释它为什么必然为 0
写一个函数 count_cross_pairs(df, test_idx, group_col), 数出"同一支设备的相邻两行被分到不同集合"的次数,然后:
- 对"按行随机"的划分调用它;
- 对"按设备划分"的划分调用它;
- 解释为什么第 2 个结果必然是 0。
参考答案
import numpy as np
import pandas as pd
from sklearn.model_selection import GroupShuffleSplit, train_test_split

df = pd.read_csv("data/battery/soh_features.csv")
X, y, groups = df.drop(columns=["soh"]), df["soh"], df["cell_id"]


def count_cross_pairs(df, test_idx, group_col="cell_id"):
    """数出同一支设备的相邻两行被拆到不同集合的次数。"""
    te_index = set(test_idx)
    cross = 0
    for _, sub in df.groupby(group_col):
        flags = sub.index.isin(te_index)
        cross += int(np.sum(flags[1:] != flags[:-1]))
    return cross


tr_r, te_r = train_test_split(df.index, test_size=0.2, random_state=42)
tr_g, te_g = next(GroupShuffleSplit(n_splits=1, test_size=0.2, random_state=42)
                  .split(X, y, groups=groups))

pairs = len(df) - df["cell_id"].nunique()
for name, te in (("按行随机", te_r), ("按设备划分", te_g)):
    c = count_cross_pairs(df, te)
    print(f"{name:<10s} 跨集相邻对 = {c:>6,d} / {pairs:,d} 对 "
f"({100 * c / pairs:5.1f}%)")期望输出:
按行随机     跨集相邻对 =  6,757 / 21,179 对 ( 31.9%)
按设备划分    跨集相邻对 =      0 / 21,179 对 (  0.0%)
★ ③ 为什么第 2 个结果必然是 0
按设备划分的定义:
    某一支设备的【全部行】要么全在训练集,要么全在测试集
        ↓
在这支设备内部,"相邻两行"必然【同侧】
        ↓
flags = [True, True, True, ...]  或  [False, False, False, ...]
        ↓
flags[1:] != flags[:-1] 永远不成立
        ↓
cross = 0   ←  数学必然,不是运气
★ 这个 0 为什么重要
它保证了:模型在测试时的每一条记录,其"最近的邻居"
         都不在训练集里。
     ↓
所以测试分数衡量的是【真正的泛化】,不是【对邻居的记忆】。
★ 反过来看 31.9% 这个数字
表里每 3 对相邻行,就有 1 对被拆到了两边。
     ↓
也就是说:测试集里每 3 行,就有约 1 行在训练集里有一个"几乎一样"的邻居。
     ↓
第 10 章会量出这 31.9% 到底值多少个 R² 点。
★ 一个可以加进验收函数的口径
def assert_no_leak(df, test_idx, group_col="cell_id"):
    assert count_cross_pairs(df, test_idx, group_col) == 0, \
        "存在跨集相邻对 —— 划分方式没有按分组切"
    return True
这一条比"设备交集 = 0"更严格: 即使设备交集为 0(比如按批次切),只要批次内部有跨集相邻对,它也能抓到。
练习 3:给你的数据选一种划分方式
给定下面四张表,为每张表选出最合适的一种划分方式,并写一句"它回答什么问题":
| 表 | 样子 | 上线场景 |
|---|---|---|
| A | 100 家门店 × 每家 104 周销量 | 明年要在新开的 20 家门店上用 |
| B | 2 万用户 × 每人若干次登录 | 明天要给现有用户打分 |
| C | 200 台设备 × 每台每天 1 条传感器记录 | 模型搬到新采购的一批设备上 |
| D | 5000 条历史订单,每条独立 | 给下一批订单预测金额 |
参考答案
| 表 | 划分方式 | 它回答什么问题 |
|---|---|---|
| A | 按门店切(留出整店) | "对新门店能不能预测" |
| B | 按用户切 | "对新用户能不能预测" |
| C | 按设备切(设备足够多时再按批次切一层) | "对新设备能不能预测" |
| D | 按行随机即可 | "对下一个独立订单能不能预测" |
★ 逐步推理
表 A:100 家门店 × 104 周
同一家门店的 104 周高度相关(同店、同季节性、同店长)
     ↓
如果按行随机切:同一家门店的第 30 周进训练、第 31 周进测试
     ↓
模型见过这家门店的"水平"(门店固定效应)
     ↓
分数虚高
     ↓
按门店切
但要注意 A 里的一个细节:
"明年要在新开的 20 家门店上用"
     ↓
不仅要按门店切,还要能回答"对新门店"这个问题
     ↓
所以:留出【整家门店】当测试集(GroupShuffleSplit)
     而不是"每家店留最后 20 周"(那样测试的是'对未来的周')
★ 表 B:2 万用户 × 若干次登录
上线场景是"明天给现有用户打分"
     ↓
现有用户在训练集里【已经见过】—— 这是正常的!
     ↓
所以这里按用户切【不是必须的】,取决于你要评估什么:| 你真正想知道 | 划分 |
|---|---|
| 对已有用户的下一周打分准不准 | 按时间切(前 80% 天训练、后 20% 天测试) |
| 对新用户准不准 | 按用户切 |
| 两个都想报 | 做两套评估,并注明口径 |
★ 这一题的关键认知:
「必须按用户切」不是一条铁律。 铁律是「划分方式必须匹配上线场景」。
表 B 的上线场景是"现有用户",所以按时间切可能比按用户切更贴近现实。
★ 表 C:200 台设备 × 每天 1 条
按设备切(先)
     ↓
设备数只有 200,还想知道"换一批(批次)还行吗"
     ↓
按批次再切一层(后)
     ↓
两套数字都报:0.94(新设备) / 0.91(新批次)
★ 表 D:5000 条独立订单
每一条是一个独立事件,没有"同一个实体出现多次"
     ↓
按行随机切就够了
     ↓
但要小心另外两种泄漏(第 04 章讲过):
    · 特征里含"这笔订单最终是否退款" → 标签泄漏
    · 特征里含"该用户历史总消费"(含这一单) → 时间穿越
★ 一句话总结(可以贴在显示器上)
先看"一行是什么",再看"上线时没见过什么",两句话一起决定了划分方式。
★ 一个可以复用的决策脚本
def suggest_split(df, entity_col, time_col=None):
    n_entity = df[entity_col].nunique()
    per = len(df) / n_entity
    print(f"实体数 {n_entity},平均每实体 {per:.1f} 行")
    if per <= 1.05:
        print("→ 每实体一行:按行随机即可(但别忘了查标签泄漏/时间穿越)")
    elif n_entity >= 20:
        print(f"→ 有分组结构:用 GroupShuffleSplit / GroupKFold(groups={entity_col})")
    else:
        print(f"→ 只有 {n_entity} 个实体:分组切 + 明确写出『实体数太少,结论不稳』")
    if time_col:
        print(f"→ 如果上线场景涉及『未来』,再加一套按 {time_col} 切的评估")
★ 这个函数在真实项目里的价值:它把"划分方式"从一个习惯, 变成一个根据数据形状推导出来的决定。
面向工程实践:划分是评估的第一道闸门
这一章看起来只讲了一个参数(groups=),但它是整本书从"能跑"到"可信"的转折点。
① 划分方式决定了"你评估的是什么能力",它是方法层面的问题
模型选错了  →  分数低一点,但结论方向是对的
划分错了    →  分数漂亮,但结论方向是错的
后者才是真正会造成损失的错误 —— 因为你会基于它做决定。
② 把划分写成一个"合约"
# src/split.py
GROUP_COL = "cell_id"
TEST_SIZE = 0.2
SEED = 42

def make_split(df, group_col=GROUP_COL, test_size=TEST_SIZE, seed=SEED):
    """全项目唯一的划分入口:保证所有实验用同一套切法。"""
    from sklearn.model_selection import GroupShuffleSplit
    gss = GroupShuffleSplit(n_splits=1, test_size=test_size, random_state=seed)
    train_idx, test_idx = next(gss.split(df, groups=df[group_col]))
    audit = audit_split(df, train_idx, test_idx, group_col)     # 见 9.4
return train_idx, test_idx, audit为什么值得这么做:
❌ 每个脚本自己切一次
   notebook1: train_test_split(..., random_state=42)      ← 按行
   notebook2: GroupShuffleSplit(..., random_state=42)     ← 按设备
   ↓
   两份报告的数字【不可比】,但没人看得出来
✅ 一个函数,一处定义
所有脚本都调 make_split()
↓
数字可比;改切法只改一处;审计结果会一起打印出来★ 这是第 04 章"数据契约"思路的延续: 上一章把"特征/标签"变成契约,这一章把"划分"变成契约。
③ 三个可以立刻加进 CI 的断言
# tests/test_split.py
def test_no_group_leak(df):
    tr, te, _ = make_split(df)
    assert not (set(df.loc[tr, "cell_id"]) & set(df.loc[te, "cell_id"]))

def test_both_sides_not_empty(df):
    tr, te, _ = make_split(df)
    assert len(tr) > 0 and len(te) > 0

def test_test_side_has_enough_groups(df):
    tr, te, _ = make_split(df)
    assert df.loc[te, "cell_id"].nunique() >= 5, "测试集设备数太少,结论不稳"
★ 第三条断言最容易被忽略,但很重要:
测试集只有 1 支设备  →  这个 R² 是"这一支设备的成绩",不是"模型的能力"
测试集有 12 支设备    →  这个 R² 有了"设备间平均"的含义
④ 上一章埋的伏笔在这里收
第 04 章末尾我让你在 make_xy 里把 groups 一起返回:
X, y, groups = make_xy(df, FEATS, TARGET)现在你知道为什么了:
做分组划分必须有 groups
     ↓
如果 make_xy 只返回 X 和 y,你就得回去重新对齐索引 —— 而且很容易对齐错
     ↓
对齐错了 = 悄悄泄漏
⑤ 下一章要量化的事情
你现在已经知道"按行随机会泄漏",但你还不知道"泄漏有多大"。
下一章会给你两个数字:
    按行随机  →  R² = 0.98764
    按设备划分 →  R² = 0.96503
    虚高       →  0.02261

并且会解释:为什么这 0.02261 是从"每支设备固定的个体偏置"里来的。
★ 那是全书最重要的一章 —— 因为它演示了"怎样亲手推翻自己的好成绩"。