第 05 章 · 滑动窗口:把一段曲线压成几个数
这一章要解决什么:上一章说清了模型只看到"一行"。 这一章给每一行补上它之前发生了什么 —— 办法只有一句话: 把一段曲线压成几个数。
最容易踩的坑: ① 以为
rolling(W)是"过去 W 行" —— 它默认含当前行; ② 看到开头一堆 NaN 就以为代码写错了 —— 那是冷启动,不是 bug; ③ 把"窗口"和"循环数"混为一谈 —— 窗口表的 1 行 = 100 圈, 所以"回看 20 个窗口"约等于 60 圈,不是 20 圈。
本章你需要完成的代码:demos/ch05-sliding-window.py
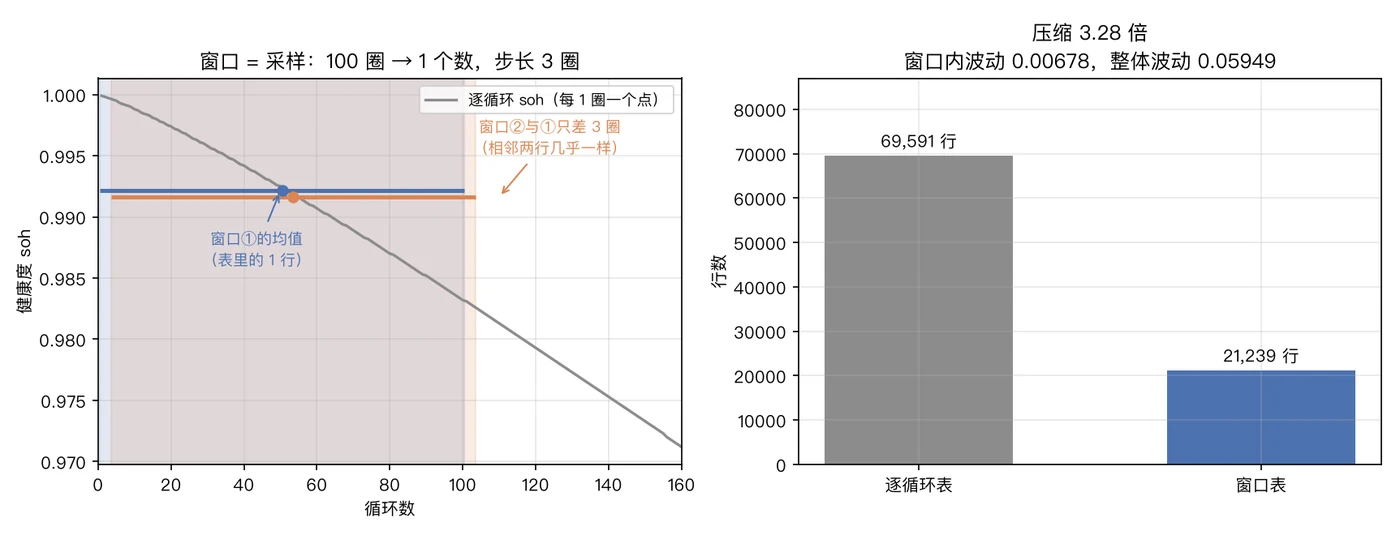
5.1 一句话:窗口 = 采样
先看清楚两张表在描述同一件事:
逐循环表:一行 = 一刻
   C001  cycle=1   soh=0.9999
   C001  cycle=2   soh=0.9998
   C001  cycle=3   soh=0.9997
        ↑ 相邻行只差 0.0001 —— 模型看不出"它们在讲同一个故事"

窗口表:一行 = 一段
   C001  cycle=50  soh=0.9921   ← 这一行代表第 1~100 圈
   C001  cycle=54  soh=0.9901   ← 这一行代表第 4~103 圈
"把一段压成几个数"这个动作,名字叫滑动窗口(sliding window)。
| 逐循环表 | 窗口表 | |
|---|---|---|
| 一行是什么 | 一个时刻 | 一段时间 |
| 行数 | 69,591 | 21,239 |
| 一行看得到什么 | 这一刻的读数 | 这一段的均值 / 标准差 |
| 相邻行像不像 | 几乎一样 | 几乎一样 |
★ 关键认知:
窗口不是"减少数据",而是"换一种采样密度"。
69,591 行 → 21,239 行,压缩了 3.28 倍; 但相邻两行之间的差只有 2~4 圈,信息几乎没有损失 —— 因为退化是慢变量。
这句话值得再展开一次:
如果 SOH 一圈掉 0.01(剧烈的快变量):
   把 100 圈压成 1 个数 → 你会把一轮完整的跳水抹成一条平线  → 损失巨大

实际上 SOH 一圈掉 0.00014(慢变量):
   把 100 圈压成 1 个数 → 这 100 圈内部的波动只有整体的 11%  → 损失很小
数字证明在第 5.2 节。
5.2 两张表在描述同一批设备
真实输出:
=== ① 一行 vs 一段:两张表在描述同一批设备 ===
  逐循环表 : 69,591 行 × 9 列   (一行 = 一圈)
  窗口表   : 21,239 行 × 27 列   (一行 = 100 圈)
  压缩比   : 3.2766 倍
  每支设备的窗口数:min 235 / 中位 356 / max 464
  窗口表口径:窗长 100 圈、步长 3 圈;所以 1 行 ≈ 100 圈,回看 20 个窗口 ≈ 60 圈。
  窗口内 soh 的标准差(C001):均值 0.00678
  全表 soh 的标准差          :0.05949
→ 窗口内的波动只有整体的 11% —— 一段曲线压成一个数,丢掉的信息很少。把这几行读成三句话:
| 观察 | 数字 | 说明 |
|---|---|---|
| 行数塌了 | 69,591 → 21,239 | 压缩 3.28 倍 |
| 设备数没变 | 60 支,每支 235~464 个窗口 | 每个窗口都是同一支设备的一段 |
| 信息几乎没丢 | 窗口内波动 0.00678,整体 0.05949 | 只占 11% |
为什么"窗口内波动只有 11%"就说明信息损失很小
因为模型要预测的那个东西,在窗口内部本来就没怎么变。
一个 100 圈的窗口里,soh 从 0.9921 走到 0.9831(掉了 0.009)
   ↓
窗口内标准差 0.00678
   ↓
而整张表里,soh 从 0.80 走到 1.00(跨度 0.20,标准差 0.0595)换句话说:
窗口内部的"变化"只占全部变化的 11%。 把一段压成一个数,你丢掉的正是这 11% —— 换来的是 3.28 倍的行数削减。
★ 一个必须同时记住的反面:
如果这条曲线一周内从 0.90 掉到 0.80(跳水),
窗口均值会告诉你"这周是 0.85,还行"
    ↓
你会把一次事故抹平
所以"能不能压"取决于"退化有多慢" —— 这是本章示例数据成立的前提,也是你要在你自己的数据上先验证的事(怎么验证:看窗口内的标准差占整体的比例)。
窗口表的两个口径数字
窗长 100 圈   :窗口覆盖多少圈
步长 3 圈     :相邻两个窗口错开多少圈
★ 这两个数字决定了"一个窗口类特征回看多久":
| 说法 | 换算 |
|---|---|
| "回看 20 个窗口" | 20 × 3 = 60 圈 |
| "回看 20 圈" | 20 圈 = 约 7 个窗口 |
这两句在代码里长得几乎一样,含义差 3 倍:
s.shift(1).rolling(20)     # ← 20 是【窗口数】:回看约 60 圈
cyc.rolling(20)            # ← 20 是【循环数】:回看 20 圈
⚠️ 这是本章第一个"看起来对但其实错":把窗口数当循环数, 写出来的特征会"回看太短",分数看不出问题,但语义已经偏了。
5.3 rolling 的三个默认语义
这一节的三个数字,是本章真正要背下来的东西。
语义一:默认含当前行
真实输出:
=== ② rolling 的语义:C001 的前 22 圈 ===
cell_id  cycle    soh  soh_win_mean  soh_win_std
   C001      1 0.9999           NaN          NaN
   C001      2 0.9998           NaN          NaN
   C001      3 0.9997           NaN          NaN
   ...
   C001     19 0.9975           NaN          NaN
   C001     20 0.9974        0.9987       0.0008
   C001     21 0.9972        0.9986       0.0008
   C001     22 0.9971        0.9984       0.0008
  ⚠️ 前 19 行的 soh_win_mean 是 NaN —— 窗口还没攒够 20 圈。
  手算验证第 20 行(cycle=20):
    最近 20 圈的均值   = 0.998715(表里 = 0.998715)
    最近 20 圈的标准差 = 0.000796(表里 = 0.000796)
  → rolling 默认【含当前行】:它是「含今天在内的最近 W 圈」。
★ 手算验证是这一节的证据:第 20 行的窗口 = 第 1~20 圈, 不是第 0~19 圈。"含今天"这几个字,就是靠这个手算确认的。
为什么这件事重要:在第 10 章你会看到,如果统计的是标签自身的历史, "含不含当前行"就从"多算一圈"变成"把答案抄进特征"。
语义二:默认 min_periods=W,攒不够就给 NaN
真实输出:
=== ③ min_periods:攒不够的时候给不给数 ===
 cycle    soh  默认 min_periods=W  min_periods=1
     1 0.9999               NaN         0.9999
     2 0.9998               NaN         0.9998
     3 0.9997               NaN         0.9998
     4 0.9996               NaN         0.9998
     5 0.9995               NaN         0.9997
     6 0.9993               NaN         0.9996
  默认写法给 NaN 的行数:19;min_periods=1 给 NaN 的行数:0
  min_periods=1 时,第 1 行的「窗口均值」= 0.9999 —— 那不是均值,是它自己。
  → 宁可用 NaN(第 07 章讲怎么处理),也不要用一个假装是均值的数。
min_periods=1 的问题看第 5 行就懂了:
第 1 行:「前 1 圈均值」     = 它自己
第 5 行:「前 5 圈均值」     = 5 个数的均值
第 6 行:「前 6 圈均值」     = 6 个数的均值
                 ↑
        每一行的分母都不一样,但列名都叫「窗口均值」
★ 一个列,两种东西:
前 19 行是"到目前为止的均值",第 20 行之后才是"最近 20 圈的均值"。 模型会把它当成同一个特征来用。
所以正确做法是让它 NaN,然后在建模阶段显式决定怎么处理 (第 07 章会量化 dropna 与 fillna(0) 的差别)。
点开:什么时候 `min_periods` 可以小于 W?
只有一种情况:你明确想让这个特征变成"到目前为止"。
# 例:把"上线至今的累计均值"当特征 —— 这时分母本来就该变
s.expanding().mean()                     # 显式写法,语义清楚
s.rolling(W, min_periods=1).mean() # 副作用写法,语义含糊区别在于:
| 列名该叫什么 | 前几行的含义 | |
|---|---|---|
rolling(W) + 默认 | xxx_win_mean20 | 无(NaN) |
expanding() | xxx_cum_mean | 上线至今的均值 |
rolling(W, min_periods=1) | ? | 既不是窗口,也不是累计 |
★ 纪律:
如果一个特征的语义在表里会随行号变化,那它就不是一个特征,是两个。
要么拆成两列(
has_history+win_mean),要么让它 NaN。
这一条会在第 07 章变成"要不要加一列 has_history"的具体选择。
语义三:rolling 只认行顺序
它不看 cycle 列、不看时间戳、不看任何东西 —— 它只看行的先后。
真实输出:
=== ④ 含当前 vs 不含当前:同一个位置,两个数 ===
 cycle    soh  soh_win_mean_incl  soh_win_mean_excl
    19 0.9975                NaN                NaN
    20 0.9974           0.998715                NaN
    21 0.9972           0.998580           0.998715
    22 0.9971           0.998445           0.998580
    23 0.9969           0.998305           0.998445
    24 0.9968           0.998165           0.998305
  cycle=20:含当前 = 第 1~20 圈(20 个值);不含当前 = 第 1~19 圈(只有 19 个值)→ NaN
  cycle=21:不含当前 = 第 1~20 圈 = 0.998715
  同一个数,含当前在 cycle=20 就给了,不含当前要等到 cycle=21 —— 晚了一行。
  → 建模要的是「不含当前」:预测这一刻时,这一刻的标签还没发生(第 10 章细讲)。
★ 看清楚这两列的关系:
含当前(incl):   cycle 20 → 0.998715
不含当前(excl): cycle 21 → 0.998715
                         ↑
同一个数,晚了一行这不是巧合:shift(1).rolling(W) 就是把 rolling(W) 整体下移一格。
代码上只差一个 shift(1):
# 含当前行("含今天在内的最近 W 圈")
x.rolling(W).mean()

# 不含当前行("今天之前的最近 W 圈")
x.shift(1).rolling(W).mean()"只认行顺序"这件事,在正确排序时是优点,在忘记排序时是灾难。第 06 章整章都在讲那个灾难。
5.4 窗口表里到底有哪些窗口类列
真实输出:
=== ⑤ 窗口表里到底有哪些窗口类列 ===
  volt_win_mean      非空 20,039 / 21,239   范围 3.6078 ~ 4.0339
  volt_win_std       非空 20,039 / 21,239   范围 0.0039 ~ 0.0154
  res_win_mean       非空 20,039 / 21,239   范围 35.6348 ~ 85.3552
  res_win_std        非空 20,039 / 21,239   范围 0.5102 ~ 2.1273
  temp_win_mean      非空 20,039 / 21,239   范围 0.8500 ~ 22.7217
  temp_win_range20   非空 20,039 / 21,239   范围 0.7322 ~ 3.4476
  soh_win_mean5      非空 20,939 / 21,239   范围 0.8068 ~ 0.9994
  soh_win_std5       非空 20,939 / 21,239   范围 0.0001 ~ 0.0049
  共 8 列 —— 前 5 列的口径是 `s.shift(1).rolling(20)`(过去 20 个窗口,不含当前);
  后 2 列的回看长度是 5 个窗口(soh_win_mean5 / soh_win_std5)。
★ 这 8 列可以分成三组来读:
| 组 | 列 | 回看 | 单位 |
|---|---|---|---|
| 通道均值 | volt_win_mean、res_win_mean、temp_win_mean | 20 窗口 | V / mΩ / ℃ |
| 通道波动 | volt_win_std、res_win_std | 20 窗口 | 同上 |
| 极差 / 短轨迹 | temp_win_range20、soh_win_mean5、soh_win_std5 | 20 / 5 窗口 | ℃ / — / — |
注意两件事:
① 非空行数分两档(20,039 与 20,939),因为回看长度不同:
回看 20 个窗口 → 每支设备最早 20 行没有历史 → 60 × 20  = 1,200 行缺
回看  5 个窗口 → 每支设备最早  5 行没有历史 → 60 ×  5  =   300 行缺
第 07 章会把"缺"这件事算总账。
② 单位必须跟着列名走:
volt_win_mean  = 3.8161   → 3.8 V    (有物理含义,可以读)
res_win_std    = 1.1474   → 1.15 mΩ  (有物理含义,可以读)
soh_win_std5   = 0.0001~0.0049       (无量纲,只能比大小)
★ 纪律:一个特征如果没有"说成人话"的方式,它的价值就要打折 —— 因为现场没有人能判断 0.0031 是好还是坏。
5.5 σ 是"稳不稳":均值看水平,标准差看波动
真实输出:
=== ⑥ σ 是「稳不稳」:均值看水平,标准差看波动 ===
  volt_win_mean      mean   3.8161   std  0.0820   min   3.6078   max   4.0339
  volt_win_std       mean   0.0087   std  0.0014   min   0.0039   max   0.0154
  res_win_mean       mean  53.4893   std 10.3299   min  35.6348   max  85.3552
  res_win_std        mean   1.1474   std  0.2092   min   0.5102   max   2.1273
  temp_win_mean      mean  10.1026   std  3.6195   min   0.8500   max  22.7217
  平均波动最小的设备:C060(0.00804)
  平均波动最大的设备:C031(0.01017)  ← 相差 1.27 倍
  → 两个通道均值相同的设备,「稳不稳」要由 σ 区分;
     σ 的用途不是提高分数,是给现场一个可读的判据。
★ 均值与 σ 回答两个不同的问题:
均值:「这台设备最近偏热还是偏冷?」
σ   :「这台设备最近稳不稳?」
为什么 σ 有价值 —— 一个思想实验:
两支设备,volt_win_mean 都是 3.816 V
   A 设备:volt_win_std = 0.0039   ← 每一次都一样,很稳
   B 设备:volt_win_std = 0.0154   ← 时高时低,平台在抖

只看均值,你分不出它们;看 σ,差 4 倍。
⚠️ 但请注意下面这句话的分量:
σ"有用"≠ σ"提升分数"。
在这份数据上(第 15 章的消融会量化):加上窗口统计这 5 列, 测试 R² 几乎不动(+0.00000)。
那为什么还要造它们?
| 目的 | 该看的列 | 收益 |
|---|---|---|
| 提高预测精度 | 轨迹列(历史实测 SOH) | 大(第 15 章:删掉它 −0.046) |
| 给出可读的现场判据 | σ / 极差 | 分数上 ≈ 0,决策上很大 |
★ 这是本章最容易被跳过的一句话:
不是所有特征都是为了涨分。 有些特征的作用是让"模型为什么这么判"这句话说得出口。
第 09 章会把这个话题讲完(极差、以及"现场判读 vs 数据事实")。
5.6 常见坑
① 以为 rolling(W) 是「过去 W 行」      → 默认含当前行,是「最近 W 行」
② 看到开头 NaN 就以为代码错             → 那是冷启动;每支设备都要重新攒 W 行
③ 把「20 个窗口」当「20 圈」            → 步长 3 圈,20 个窗口 ≈ 60 圈
④ 用 min_periods=1 消灭 NaN            → 每行的分母都不一样,一个列变两个语义
⑤ 忘了 shift(1) 就统计标签自己          → 第 10 章的探针会抓它(分数却几乎不动)
⑥ 造完 σ 就以为分数该涨                 → 窗口统计在这份数据上 Δ R² ≈ 0.00000
第 ⑤ 条要多说一句:这一章为了讲清 rolling 的语义,故意用了"含当前行"。 第 10 章会把它拨回正轨,并量化"含"与"不含"差多少分。
5.7 完整示例与输出
cd code
python demos/ch05-sliding-window.py
真实输出(节选):
=== ① 一行 vs 一段:两张表在描述同一批设备 ===
  逐循环表 : 69,591 行 × 9 列   (一行 = 一圈)
  窗口表   : 21,239 行 × 27 列   (一行 = 100 圈)
  压缩比   : 3.2766 倍
  每支设备的窗口数:min 235 / 中位 356 / max 464

=== ② rolling 的语义:C001 的前 22 圈 ===
  手算验证第 20 行(cycle=20):
    最近 20 圈的均值   = 0.998715(表里 = 0.998715)
    最近 20 圈的标准差 = 0.000796(表里 = 0.000796)

=== ③ min_periods:攒不够的时候给不给数 ===
  默认写法给 NaN 的行数:19;min_periods=1 给 NaN 的行数:0
  min_periods=1 时,第 1 行的「窗口均值」= 0.9999 —— 那不是均值,是它自己。

=== ④ 含当前 vs 不含当前:同一个位置,两个数 ===
    20 0.9974           0.998715                NaN
    21 0.9972           0.998580           0.998715

=== ⑤ 窗口表里到底有哪些窗口类列 ===
  volt_win_mean      非空 20,039 / 21,239   范围 3.6078 ~ 4.0339
  soh_win_mean5      非空 20,939 / 21,239   范围 0.8068 ~ 0.9994

=== ⑥ σ 是「稳不稳」:均值看水平,标准差看波动 ===
  平均波动最小的设备:C060(0.00804)
  平均波动最大的设备:C031(0.01017)  ← 相差 1.27 倍

结论:窗口 = 采样。69,591 行压成 21,239 行(3.28 倍),
      窗口内的波动只有整体的 11% —— 因为退化是慢变量,信息只损失一点点。
      代价是每支设备开头 20 行没有历史(第 07 章),
      以及一旦忘了分组排序,窗口会跨设备串线(第 06 章)。
本章练习
练习 1:手算核对一个窗口(C003,W=30)
用逐循环表,对 C003 算一个 30 圈的窗口均值:
- 先
sort_values(["cell_id", "cycle"]),再用groupby("cell_id")["soh"].transform(...)造一列w30; - 打印 C003 前 3 行的
w30、前 29 行里 NaN 的个数; - 手算 C003 第 1~30 圈的 soh 均值,和表里第 30 行对比,打印差值。
要求:差值为 0(或 1e-16 量级)才算通过。
参考答案
import os

import pandas as pd

HERE = os.path.dirname(os.path.abspath(__file__))
CODE = os.path.abspath(os.path.join(HERE, "..", ".."))
RAW_CSV = os.path.join(CODE, "data", "battery", "cycle_raw.csv")

raw = pd.read_csv(RAW_CSV).sort_values(["cell_id", "cycle"]).reset_index(drop=True)
W = 30
raw["w30"] = raw.groupby("cell_id")["soh"].transform(lambda s: s.rolling(W).mean())
one = raw[raw["cell_id"] == "C003"].reset_index(drop=True)

print(f"  C003 前 3 行的 w30:{one['w30'].head(3).round(4).tolist()}")
print(f"  前 {W - 1} 行里 NaN 的行数:{int(one['w30'].head(W - 1).isna().sum())}")
win = one["soh"].iloc[:W]
print(f"  第 {W} 行(cycle={int(one['cycle'].iloc[W - 1])}):")
print(f"    手算最近 {W} 圈均值   = {win.mean():.6f}")
print(f"    表里的 w30            = {one['w30'].iloc[W - 1]:.6f}")
print(f" 两者之差 = {abs(win.mean() - one['w30'].iloc[W - 1]):.2e}")期望输出:
=== 练习 1:手算核对一个窗口(C003,W=30)===
  C003 前 3 行的 w30:[nan, nan, nan]
  前 29 行里 NaN 的行数:29
  第 30 行(cycle=30):
    手算最近 30 圈均值   = 0.998057
    表里的 w30            = 0.998057
    两者之差              = 0.00e+00
★ 差值为 0.00e+00 这件事本身就是一个结论:
它不是「误差够小」,而是【同一个算式】——
rolling 做的就是这件事:取当前行往前 W 个位置求均值。
所以当你怀疑"这个窗口特征是不是用到了未来的数据"时, 最直接的办法就是:手算第 W 行,然后对答案。
点开:为什么选第 30 行对答案,而不是第 1 行?
第 1 行:窗口只有 1 个值  → 均值 = 它自己 → 对不出「窗口」的语义
第 30 行:窗口正好装满 30 个值 → 这是最小的、语义完整的验证点
第 100 行:也对,但样本量大的时候容易掩盖"顺序错了"的问题
★ 规则:验证一个窗口特征,永远从"窗口刚装满的那一行"开始对。
练习 2:min_periods 让「窗口」变成「到目前为止」
对 C003 的 soh 分别算:
s.rolling(30).mean()(默认min_periods=30);s.rolling(30, min_periods=1).mean()。
打印两者的 NaN 行数、第 1 行的值,以及第 1 行的真实 soh,然后用一句话说明 为什么 min_periods=1 会毁掉「窗口」这个语义。
参考答案
import os

import pandas as pd

HERE = os.path.dirname(os.path.abspath(__file__))
CODE = os.path.abspath(os.path.join(HERE, "..", ".."))
RAW_CSV = os.path.join(CODE, "data", "battery", "cycle_raw.csv")

raw = pd.read_csv(RAW_CSV).sort_values(["cell_id", "cycle"]).reset_index(drop=True)
s = raw[raw["cell_id"] == "C003"]["soh"].reset_index(drop=True)
W = 30

default = s.rolling(W).mean()
loose = s.rolling(W, min_periods=1).mean()
print(f"  默认 min_periods=W  :NaN {int(default.isna().sum())} 行,"
      f"第 1 行 = {default.iloc[0]}")
print(f"  min_periods=1      :NaN {int(loose.isna().sum())} 行,"
      f"第 1 行 = {loose.iloc[0]:.4f}")
print(f" 第 1 行的真实 soh = {s.iloc[0]:.4f}")期望输出:
=== 练习 2:min_periods 让「窗口」变成「到目前为止」 ===
  默认 min_periods=W  :NaN 29 行,第 1 行 = nan
  min_periods=1      :NaN 0 行,第 1 行 = 0.9999
  第 1 行的真实 soh   = 0.9999
  → min_periods=1 时第 1 行的「30 圈均值」就是它自己;
     第 5 行是「前 5 圈均值」,第 6 行是「前 6 圈均值」—— 每一行的分母都不一样。
③ 一句话答案:
min_periods=1让"分母"从固定的 30 变成"当前行号", 于是同一列在前 29 行是"累计均值"、第 30 行之后是"滑动均值" —— 一个列名,两种特征。
★ 一个判断技巧:
你可以问自己:这一列在第 1 行和第 1000 行,是【同一件事】吗?
   rolling(30)  → 是(都是最近 30 行)
   min_periods=1 → 不是(一个是前 1 行,一个是前 30 行)
这个问法在第 10 章的"审计表"里会变成一条固定条目。
练习 3:把窗口步长从 3 圈改成 10 圈
窗口表的口径是"窗长 100 圈、步长 3 圈"。把步长改成 10 圈重算一遍:
- 对每支设备,窗口起点是
range(0, max(n - 100 + 1, 1), stride); - 分别算
stride=3与stride=10的总行数、相对逐循环表(69,591 行)的压缩比; - 用一句话说明步长变大换来了什么、又丢了什么。
参考答案
import os

import pandas as pd

HERE = os.path.dirname(os.path.abspath(__file__))
CODE = os.path.abspath(os.path.join(HERE, "..", ".."))
RAW_CSV = os.path.join(CODE, "data", "battery", "cycle_raw.csv")

raw = pd.read_csv(RAW_CSV)
WIN_LEN = 100
for stride in (3, 10):
    n_rows = sum(len(range(0, max(len(g) - WIN_LEN + 1, 1), stride))
                 for _, g in raw.groupby("cell_id"))
    print(f"  步长 {stride:>2d} 圈 → 窗口表 {n_rows:>6,d} 行,"
f"压缩比 {len(raw) / n_rows:.2f} 倍")期望输出:
=== 练习 3:把步长从 3 圈改成 10 圈 ===
  步长  3 圈 → 窗口表 21,239 行,压缩比 3.28 倍
  步长 10 圈 → 窗口表  6,396 行,压缩比 10.88 倍
  逐循环表 69,591 行
  步长 3 圈时每支设备 354 行,步长 10 圈时 107 行。
③ 一句话答案:
步长从 3 圈放大到 10 圈,行数从 21,239 掉到 6,396(压缩比 3.28 → 10.88), 换来的是训练快 3 倍多、相邻行更"不重复"; 丢掉的是时间分辨率 —— 相邻两行从差 3 圈变成差 10 圈, 一个"突发的抖动"更容易被跨过去。
★ 这个取舍在工程上怎么定:
| 你的问题的时间尺度 | 步长该选 |
|---|---|
| 想知道"这一周有没有异常" | 步长 ≤ 一周 |
| 只知道"这个季度趋势" | 步长可以更大 |
第 28 章(多窗口平均)会从另一头回到这个话题: 与其纠结选哪个步长,不如把几个回看长度各造一列,让模型自己挑。
面向工程实践:什么时候该"把曲线压成数"
① 先判断"能不能压"
算一个比例:窗口内标准差 / 整体标准差
    < 20%  → 可以放心压(本章数据是 11%)
    20%~50% → 压了要交代损失
    > 50%  → 别压,你压掉的可能正是信号
② 压完必须写下来的三件事
| 项 | 本章的值 | 不写会怎样 |
|---|---|---|
| 窗长 | 100 圈 | 别人以为"一行 = 一圈" |
| 步长 | 3 圈 | 别人以为"20 个窗口 = 20 圈" |
| 是否含当前行 | v2 表不含(shift(1)) | 争议"这个特征算不算偷看" |
③ 一个可复制的窗口构造骨架
def add_window_features(df, cols, w, group="cell_id", order="cycle", shift=1):
    """给 df 加窗口特征。shift=1 表示只用历史(推荐)。"""
    df = df.sort_values([group, order]).reset_index(drop=True)
    g = df.groupby(group)
    for c in cols:
        base = g[c].transform(lambda s: s.shift(shift)) if shift else df[c]
        df[f"{c}_win_mean{w}"] = base.rolling(w).mean()
        df[f"{c}_win_std{w}"] = base.rolling(w).std()
    return df
★ 这个骨架的三个细节,正好对应本章的三个坑:
sort_values([group, order])  → 排序(第 06 章的反面教材)
groupby(group)               → 分组(同上)
shift(shift)                 → 含/不含当前行(本章 5.3)
④ 一个真实的项目事故长什么样
现象:模型在训练集上很好,上线后第一个月表现正常,第二个月开始变差
排查:窗口特征没写 shift(1),线上"当前这一刻的数据"要延迟 5 分钟才到
     → 训练时用得到,线上第一版为了"跑通"直接填了 0,第二版才接上真实数据
     → 两版的输入分布不一样,模型看到的和学到的不是一回事
★ 一句话:
窗口把"一行"变成了"一段", 但"这一段到底截止到哪一刻"必须在代码里写死、在文档里写明。