第 19 章 · 泄漏②:预处理泄漏
这一章要解决什么:把"先在全量上
fit再划分"这种最常见的泄漏讲清楚 —— 并且诚实地承认本数据上量不出差距(0.92962 对 0.92962), 然后亲手设计一个对照实验,把差距放大到 +0.06525。最容易踩的坑: ① 看到"两种做法结果一样"就下结论"预处理泄漏不重要" —— 这是本章要纠正的头号误解; ② 以为
StandardScaler无害 —— 对线性模型无害,对 kNN / Ridge / SVR 有害; ③ 只在"划分"这一步守纪律,忘了交叉验证内部还有一次fit。
本章你需要完成的代码:demos/ch19-leak-preprocess.py
19.1 先说结论:本数据上,两种写法的结果完全相同
违规写法(❌ 在划分之前就对全量数据 fit):
sc = StandardScaler().fit(X)                     # 用了全量(含测试集)的均值/标准差
bad = LinearRegression().fit(sc.transform(X.iloc[tr]), y.iloc[tr])
r2_bad = r2_score(y.iloc[te], bad.predict(sc.transform(X.iloc[te])))
正确写法(✅ 把缩放器放进 Pipeline,让它只吃训练集):
good = Pipeline([("s", StandardScaler()), ("m", LinearRegression())])
good.fit(X.iloc[tr], y.iloc[tr])
r2_ok = r2_score(y.iloc[te], good.predict(X.iloc[te]))真实输出:
① 诚实结论:本数据上『全量 fit』与『Pipeline 内 fit』结果完全相同
  ①-1 缩放器(17 列安全特征,线性回归,按设备划分)
       先全量 fit R² = 0.94382   Pipeline 内 fit R² = 0.94382   差 +0.00000
       两种口径的预测最大差 = 2.22e-16(浮点零)

  ①-2 特征选择(SelectKBest 按 F 值取 5 列,随机森林)
       全量挑 R² = 0.92962   训练集内挑 R² = 0.92962   差 +0.00000
       全量挑出的 5 列    :['cycle', 'resistance_mohm', 'coulombic_eff', 'temp_std_c', 'res_win_mean']
       训练集内挑出的 5 列:['cycle', 'resistance_mohm', 'coulombic_eff', 'temp_std_c', 'res_win_mean']
       两次是否完全相同   :True
★ 这是全书唯一一处"看不见差距"的泄漏,所以它值得被认真对待。
一个诚实的作者必须在这里停下来问:
    "既然结果一模一样,我凭什么说它是错的?"
     ↓
本章剩下的部分全部在回答这个问题:
    ① 为什么本数据上看不见(两个可验证的原因)
    ② 什么条件下它会显形(三个旋钮,逐个拧给你看)
    ③ 为什么即使看不见也必须修(零成本 + 上线一致性)
★ 先看那个最容易被误读的数字:预测最大差 = 2.22e-16。
0.00000 不是"差一点点",而是【浮点意义上的完全同一】
     ↓
这意味着:不是"差距小到看不见",而是"这个模型根本感知不到差别"
     ↓
一个模型感知不到的东西,不等于它不存在 ——
换个模型就知道了(19.3 节)
19.2 为什么看不见:一条数学原因 + 一条样本原因
19.2.1 数学原因:线性模型对缩放是"等变"的
"等变"(equivariance)这个词听起来吓人,实际上一句话就能说清:
线性回归学的是     ŷ = w·x + b

如果把某一列 x 换成 (x − μ) / σ:
    · 学到的系数会自动变成 w·σ
    · 学到的截距会自动吸收 μ 带来的平移
     ↓
把系数还原回原始量纲之后,两条曲线是【同一个函数】
     ↓
所以"用全量的 μ、σ"还是"用训练集的 μ、σ",
最后乘出来的预测完全一样真实输出:
  ②-1 数学原因:线性模型对特征的仿射变换【等变】
       两种口径学到的系数(还原到原始量纲)最大差 = 3.91e-14
       两种口径学到的截距(还原到原始量纲)差   = 4.97e-14
       —— 用谁的均值/标准差,最后乘出来的预测是同一个函数。
          所以『分数没变』并不说明『流程没问题』,只说明这个模型看不见它。
★ 3.91e-14 就是"零"。 这不是"接近",这是浮点精度极限。
★ 这条性质有一个非常重要的推论:
凡是"对特征的仿射变换等变"的模型(线性回归、普通最小二乘), 都不可能用分数差来发现预处理泄漏。
拿它当探针,等于用一把没有刻度的尺子去量长度。
19.2.2 样本原因:统计量只被测试集挪动了一点点
真实输出:
  ②-2 样本原因:统计量污染度 = 测试行占全量的比例
       训练 16,236 行 / 测试 3,743 行 → 污染度 = 18.73%
       17 列里,|Δ均值|/标准差 最大 = 0.0445(cap_fade_rate_ah_per_100)
       17 列里,|Δ标准差|/标准差 最大 = 0.0266(temp_win_mean)
★ 三个数字要分开读:
① 污染度 18.73% —— 全量统计量里有 18.73% 的行来自测试集
     (这是泄漏的"剂量")

② |Δ均值|/标准差 最大 4.45% —— 全量的均值与训练集均值只差 0.0445 个标准差
     (这是剂量造成的"位移")

③ |Δ标准差|/标准差 最大 2.66% —— 尺度只被挪动了 2.66%
     (这是"缩放"层面的位移)
     ↓
位移很小(几个百分点)+ 线性模型等变(感知不到)
     = 分数差落在小数点后第 5 位以外
★ 污染度的公式值得记住,因为它决定了一切:
污染度 = n_test / (n_train + n_test)

本数据(全量)    :3,995 / 21,239 = 18.8%
小样本(2 支训练):1,109 / (535 + 1,109) = 67.5%   ← 19.3 节要把剂量加到这么大
★ 所以"看不见"是有前提的,而且前提很脆弱:
| 前提 | 一旦被破坏 |
|---|---|
| 模型对尺度不敏感 | 换 Ridge / kNN / SVR → 立刻显形 |
| 样本足够多 | 样本变少 → 污染度上升 → 立刻显形 |
| 被 fit 的东西只影响尺度 | 换成 SelectKBest → 选出的列可能变 |
★ 三个前提,三个旋钮。19.3 节逐个拧给你看。
19.3 亲手把差距放大出来
19.3.1 拧第一个旋钮:缩小训练集
实验设计(要控制变量,所以只动一个东西):
① 固定测试集:先 np.random.RandomState(42) 打乱 60 支设备,取前 4 支作为测试集
② 训练集从 2 支设备逐步加到 56 支(同一批测试设备不变)
③ 每个尺寸下,分别用「全量 fit 缩放器」和「Pipeline 内 fit」各跑一次
④ 报告虚高 = 全量口径 R² − Pipeline 口径 R²真实输出:
③ 自己设计对照实验:缩小训练集 + 换尺度敏感的模型
  固定测试集(4 支设备):['C001', 'C006', 'C037', 'C046']
  训练集从 2 支设备逐步加到 56 支(每次用同一批测试设备)

      训练设备     训练行     污染度              线性回归  Ridge(alpha=100)          kNN(k=5)
         2     535  67.5%          +0.00000          +0.06525          +0.05041
         4   1,285  46.3%          -0.00000          +0.00415          +0.02301
         8   2,634  29.6%          -0.00000          +0.00208          +0.00956
        16   5,466  16.9%          +0.00000          +0.00008          +0.00346
        32  11,389   8.9%          +0.00000          +0.00004          +0.00102
        56  18,870   5.6%          -0.00000          +0.00001          +0.00025
★ 这张表把两件事同时说清了:
① 线性回归那一列永远是 0.00000
     → 它的等变性让它【看不见】泄漏(不是一个可信的探针)

② Ridge / kNN 那一列随污染度单调放大:
     污染度 67.5% → 虚高 +0.06525(Ridge) / +0.05041(kNN)
     污染度  5.6% → 虚高 +0.00001(Ridge) / +0.00025(kNN)
     ↓
"样本越多,影响越小" —— 这是对的
但"影响小"和"不该做"是两件事
★ 用一句话概括本数据为什么看不见:
污染度 18.7%(不大)+ 线性回归(等变)+ 只影响尺度(不改结构) = 0.00000。 这三个条件里任意一个变了,结论就变了。
19.3.2 拧第二个旋钮:换对尺度敏感的模型
真实输出:
  ③-1b 换模型种类(固定在最小的训练集:2 支设备 / 535 行)
  模型                    先全量 fit R²  Pipeline R²         虚高   为什么
  线性回归                     0.79800      0.79800   +0.00000   对缩放等变 → 看不见
  Ridge(alpha=1)           0.74466      0.73844   +0.00622   正则项弱 → 几乎看不见
  Ridge(alpha=100)         0.79328      0.72804   +0.06525   正则项强 → 看得见
  kNN(k=5)                 0.81130      0.76088   +0.05041   距离定义依赖尺度
  SVR(C=10, RBF)           0.79010      0.73276   +0.05734   gamma 直接吃 X.var()
★ 三类模型"对尺度敏感"的原因各不相同,但结果一样:
| 模型 | 敏感的原因 | 一句话 |
|---|---|---|
Ridge | 正则项 alpha·‖w‖² 的量纲随特征尺度变,标准化换了尺度 = 换了 alpha | 惩罚项被尺度污染 |
kNN | "谁是邻居"由距离定义,距离由尺度定义 | 邻居集合被尺度污染 |
SVR(RBF 核) | gamma="scale" 默认吃 X.var() | 核宽度被尺度污染 |
★ 所以"预处理泄漏重要不重要"这个问题,问法本身就是错的:
正确的问法是:
    "在【这个模型 + 这个样本量 + 这些被 fit 的步骤】下,它有多大?"
     ↓
本数据 + 线性回归        → 0.00000
本数据 + 小样本 + Ridge  → 0.06525
     ↓
同一个数据集、同一个泄漏,量级差了 6 万倍
19.3.3 只拧一个旋钮:Ridge 的 alpha
真实输出:
  ③-2 只拧一个旋钮:Ridge 的 alpha(训练 2 支设备 / 测试 4 支设备)
     alpha      先全量 fit R²   Pipeline R²          虚高         预测最大差
         1         0.74466       0.73844    +0.00622       0.00226
        10         0.74285       0.69186    +0.05099       0.00536
       100         0.79328       0.72804    +0.06525       0.00861
      1000         0.83049       0.81087    +0.01962       0.01277
     10000         0.37460       0.47301    -0.09841       0.00891
★ 注意最后一行:虚高的符号反了。
alpha = 100   → 虚高 +0.06525(违规写法让分数变高)
alpha = 10000 → 虚高 −0.09841(违规写法让分数变低)
     ↓
这推翻了"泄漏 = 分数虚高"这个直觉
     ↓
更准确的说法是:
    泄漏 = 分数【不再只由训练集决定】
     ↓
它往哪边偏,取决于数据与模型的细节 —— 你根本无法预料
★ 为什么"无法预料"比"虚高"更可怕?
虚高:你至少知道方向,可以在报告里写"这个分数偏高,打个折"
随机偏:你连"打折"都不知道往哪边打
     ↓
一旦按泄漏口径上线,成绩会随机往两边偏,
而你在离线阶段【连解释都解释不了】
★ 这条要在团队里反复讲:
"泄漏让分数变高"是一个方便记忆的说法, 但它的本质是"评估与上线不一致"。 不一致的方向是不确定的 —— 这才是必须守规矩的原因。
19.3.4 拧第三个旋钮:特征选择(连"选哪几列"都会被改)
前面三小节的都是"缩放器",但预处理泄漏还包括更狠的一类:特征选择。
StandardScaler:改的是【尺度】 → 线性模型等变,看不见
SelectKBest :改的是【选哪几列】 → 模型的"长相"都不一样了真实输出:
  ③-3 特征选择也一样:小样本时『全量挑』与『训练集内挑』选出的列不同
  全量挑(违规口径,恒定):['cycle', 'resistance_mohm', 'coulombic_eff', 'temp_std_c', 'res_win_mean']

      训练设备     训练行             与全量口径是否相同   训练集内挑出的 5 列
         2     535                 False   ['cycle', 'mean_charge_voltage_v', 'coulombic_eff', 'volt_win_mean', 'temp_win_mean']
         4   1,285                 False   ['cycle', 'mean_temp_rise_c', 'coulombic_eff', 'temp_std_c', 'temp_win_mean']
         8   2,634                 False   ['cycle', 'mean_temp_rise_c', 'coulombic_eff', 'temp_std_c', 'temp_win_mean']
        16   5,466                 False   ['cycle', 'mean_charge_voltage_v', 'coulombic_eff', 'temp_std_c', 'volt_win_mean']
        32  11,389                  True   ['cycle', 'resistance_mohm', 'coulombic_eff', 'temp_std_c', 'res_win_mean']
        56  18,870                  True   ['cycle', 'resistance_mohm', 'coulombic_eff', 'temp_std_c', 'res_win_mean']

  ★ 6 个尺寸里有 4 个『两套列不同』。
★ 这一节比前面几节更严重,因为它的后果不只是分数:
缩放器被泄露     → 同一个模型,参数不同,分数差一点
特征选择被泄露   → 【模型不一样】:进了两个不同的列集
     ↓
上线时你用的是【训练集内挑出来的那 5 列】,
但验收报告上的分数是用【全量挑出来的那 5 列】跑出来的
     ↓
这不叫"分数虚高",这叫【验收的模型和上线的模型不是同一个】
★ 顺带记住那个分界线:
训练 32 支设备(11,389 行)以上 → 两套列一致
训练 16 支设备(5,466 行)以下  → 两套列不同
     ↓
本仓库的主口径是 21,239 行 / 60 支设备,
所以 19.1 节的"5 列完全相同"是【样本足够多】的产物,
不是"特征选择泄漏不存在"的证据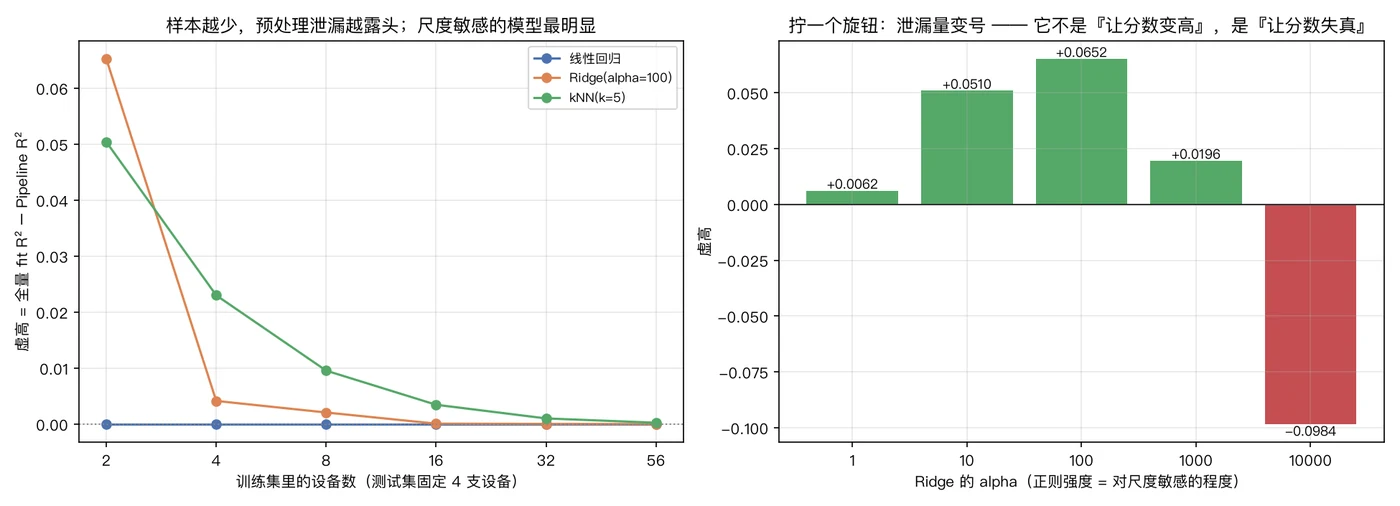
图的读法:
- 左图:横轴是训练集设备数(2 → 56),纵轴是虚高。 蓝线(线性回归)贴着 0;橙线(Ridge)与绿线(kNN)在样本少时冲到 +0.05 以上, 样本变多后一起收敛到 0。
- 右图:只拧 Ridge 的 alpha。虚高从 +0.00622 升到 +0.06525,最后翻成 −0.09841 —— 这就是"泄漏不一定让分数变高"的实证。
19.4 一个小节把这个认知钉死
把本章的发现收成三句话:
① "分数没变"≠"流程没问题"
     线性模型的等变性让它天生看不见缩放泄漏(预测最大差 2.22e-16)

② "泄漏让分数变高"≠"泄漏的定义"
     它只是让分数不再由训练集单独决定;方向可以反(alpha=10000 时 −0.09841)

③ "本数据上差别不大"≠"这一类不重要"
     它的量级由三个旋钮决定:污染度、模型敏感度、被 fit 的东西改不改结构
     三个旋钮里有两个不在你的数据里,而在你的【选择】里
★ 那么"必须修"的理由是什么?
| 理由 | 说明 |
|---|---|
| 成本为零 | 放进 Pipeline 不需要多写逻辑,也不改精度 |
| 不可预测 | 你无法预知它往哪边偏、偏多少 |
| 上线一致性 | 训练时 fit 的缩放参数必须原样带到推理端;Pipeline 就是"一套参数"的载体 |
| 审计要求 | "训练集有没有被污染"是可以被问的;答不上来就是流程缺陷 |
19.5 唯一正确的写法
把"所有需要 fit 的东西"全部放进 Pipeline。
from sklearn.compose import ColumnTransformer
from sklearn.impute import SimpleImputer
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import OneHotEncoder, StandardScaler
from sklearn.feature_selection import SelectKBest, f_regression
from sklearn.linear_model import Ridge
from sklearn.model_selection import GroupKFold, cross_val_score

num_pipe = Pipeline([
    ("imp", SimpleImputer(strategy="median")),     # 缺失值:中位数只在训练集里算
    ("sc", StandardScaler()),                       # 缩放:均值和标准差只在训练集里算
])
cat_pipe = Pipeline([
    ("enc", OneHotEncoder(handle_unknown="ignore")),  # 类别表只在训练集里建
])
pre = ColumnTransformer([("num", num_pipe, NUM_COLS), ("cat", cat_pipe, CAT_COLS)])

pipe = Pipeline([
    ("pre", pre),
    ("sel", SelectKBest(f_regression, k=5)),        # F 值只在训练集上算
    ("m", Ridge(alpha=100)),
])

scores = cross_val_score(pipe, X, y, cv=GroupKFold(n_splits=5), groups=cell_id)
print(f"CV R² = {scores.mean():.5f} ± {scores.std():.5f}")
★ 三条纪律,逐条对应本章的三种失败:
| 纪律 | 防的是什么 |
|---|---|
① 凡是需要 fit 的东西一律进 Pipeline(scaler / imputer / encoder / selector / PCA) | 本节开头那个 StandardScaler().fit(X) |
② 交叉验证也要传 pipe(cross_val_score(pipe, ...)) | 每折内部重新漏一次 |
③ 训练完把 pipe 整体序列化上线,别手写"先减均值再除标准差" | 训练/推理不一致 |
★ 第 ③ 条值得展开,因为它是"预处理泄漏"最贵的变体:
离线:用全量中位数填缺失 → 分数 0.93
上线:线上数据的中位数与训练集不同,但代码里写死了那个中位数
     ↓
预处理参数与线上分布不匹配
     ↓
离线 0.93,线上掉到 0.7 —— 而且你怎么查都查不出原因
     ↓
`Pipeline` 的价值不只是"防泄漏",它是【训练与推理使用同一套参数的唯一保证】
点开:那"先划分再对所有列做标准化"算不算泄漏?
不算。这正是正确做法。
✅ 正确:train_test_split → 在训练集上 fit scaler → transform 两边
❌ 违规:在全量上 fit scaler → train_test_split

区别只在【fit 在哪一步发生】,与"有没有缩放"无关。
★ 那"先对全量做缺失值填充"呢?
同样要看 fit 发生在哪里:
    · 用【常数】填(比如填 0、填"未知")→ 没有 fit,不算泄漏
    · 用【统计量】填(中位数、众数、均值)→ 有 fit,必须只在训练集上算
★ 判断口诀(可以贴在工位上):
问:"这一行代码,在只有训练集的情况下跑得出来吗?"
    跑得出来 → 安全
    跑不出来(因为它需要测试集的行或标签)→ 泄漏
     ↓
standardize(X_all)          → 需要测试集 → ❌
fillna(0)                   → 不需要    → ✅
fillna(X_train.median())    → 不需要    → ✅
SelectKBest().fit(X_all,y)  → 需要测试集 → ❌
PCA().fit(X_all)            → 需要测试集 → ❌
★ 一个容易忽略的边界情况:
用测试集的【特征】算统计量 → 泄漏(本章这一种)
用测试集的【标签】算统计量 → 更严重的泄漏(比如用全量 y 挑目标编码的均值)
     ↓
后者在真实项目里非常常见,而且它连"无监督"这个借口都没有
19.6 常见坑
① 先在整表 fit_transform,再 train_test_split        → 本章的 ① 号坑
② 用全量的中位数/众数填缺失值                        → 同一个坑的无监督版本
③ 用测试集的标签做目标编码(target encoding)         → 更严重,直接影响分数
④ 只在"划分"处守纪律,忘了 CV 内部还有一次 fit        → cross_val_score(pipe, ...)
⑤ 看到差 ≈ 0 就下结论"没有泄漏"                      → 换模型、换样本量结论就变
⑥ 用线性回归当"泄漏探针"                             → 它对缩放等变,天生看不见
⑦ 把 scaler 训练好单独存下来,上线时手写变换           → 训练/推理不一致
★ 第 ⑥ 条是本章最实用的一条经验:
想测"预处理有没有泄漏",探针要选【对尺度敏感】的模型:
    Ridge(alpha 调大)/ kNN / SVR
     ↓
并且要挑【小样本】配置(污染度 > 30% 才明显)
     ↓
两条都不满足时,你测的不是"泄漏存不存在",而是"我这个配置敏不敏感"
★ 第 ①②③ 条的共同点:
它们的错误都发生在"划分之前"这个时间窗口里
     ↓
所以最省事的自查方式是:把数据流画出来,标出每个 fit 的位置
     ↓
只要有一个 fit 画在"划分"这条竖线的左边,就是泄漏
19.7 完整示例与输出
cd tools/feature-engineering-pipeline/code
MPLCONFIGDIR=/tmp/fe-mpl /Users/jini/Projects/MyBooks/Basic-Tutorials/.pytmp/venv/bin/python \
demos/ch19-leak-preprocess.py真实输出(节选):
① 诚实结论:本数据上『全量 fit』与『Pipeline 内 fit』结果完全相同
  ①-1 先全量 fit R² = 0.94382   Pipeline 内 fit R² = 0.94382   差 +0.00000
       两种口径的预测最大差 = 2.22e-16(浮点零)
  ①-2 全量挑 R² = 0.92962   训练集内挑 R² = 0.92962   差 +0.00000
       两次挑出的 5 列完全相同:['cycle', 'resistance_mohm', 'coulombic_eff', 'temp_std_c', 'res_win_mean']

② 为什么看不见
  ②-1 系数(还原到原始量纲)最大差 = 3.91e-14   截距差 = 4.97e-14
  ②-2 污染度 = 18.73%   |Δ均值|/标准差 最大 = 0.0445

③ 把差距放大出来
      训练设备     训练行     污染度              线性回归  Ridge(alpha=100)          kNN(k=5)
         2     535  67.5%          +0.00000          +0.06525          +0.05041
        56  18,870   5.6%          -0.00000          +0.00001          +0.00025
  Ridge alpha 扫描:+0.00622 → +0.05099 → +0.06525 → +0.01962 → -0.09841
  特征选择:6 个尺寸里有 4 个『两套 5 列不同』
本章练习
练习 1:复现那个"完全相同"的 0.92962
用 17 列安全特征(基础 7 + 窗口 5 + 差分 4 + 极差 1)与随机森林 200 棵:
- 在全量上
SelectKBest(f_regression, k=5).fit(X, y),打印挑出的 5 列与测试 R²; - 把
SelectKBest放进Pipeline,只在训练集上 fit,打印挑出的 5 列与测试 R²; - 打印两者的差,并确认两套列是否相同;
- 用一句话说明:为什么这个 0.00000 不能作为"预处理泄漏不重要"的证据?
参考答案
import pandas as pd
from sklearn.ensemble import RandomForestRegressor
from sklearn.feature_selection import SelectKBest, f_regression
from sklearn.metrics import r2_score
from sklearn.model_selection import GroupShuffleSplit
from sklearn.pipeline import Pipeline

BASE = ["cycle", "mean_charge_voltage_v", "mean_temp_rise_c", "resistance_mohm",
        "coulombic_eff", "cap_fade_rate_ah_per_100", "temp_std_c"]
WIN = ["volt_win_mean", "volt_win_std", "res_win_mean", "res_win_std", "temp_win_mean"]
DIFF = ["volt_slope20", "res_slope20", "temp_slope20", "res_diff1"]
SAFE17 = BASE + WIN + DIFF + ["temp_win_range20"]

df = pd.read_csv("data/battery/soh_features_v2.csv").dropna(subset=SAFE17)
X, y, g = df[SAFE17], df["soh"], df["cell_id"]
tr, te = next(GroupShuffleSplit(n_splits=1, test_size=0.2,
                                random_state=42).split(X, y, groups=g))

def rf():
    return RandomForestRegressor(n_estimators=200, random_state=42, n_jobs=-1)

sel = SelectKBest(f_regression, k=5).fit(X, y)                 # ❌ 全量挑
cols_all = list(X.columns[sel.get_support()])
r2_all = r2_score(y.iloc[te], rf().fit(X.iloc[tr][cols_all], y.iloc[tr])
                  .predict(X.iloc[te][cols_all]))

pipe = Pipeline([("sel", SelectKBest(f_regression, k=5)), ("m", rf())])
pipe.fit(X.iloc[tr], y.iloc[tr])                               # ✅ 训练集内挑
cols_tr = list(X.columns[pipe.named_steps["sel"].get_support()])
r2_tr = r2_score(y.iloc[te], pipe.predict(X.iloc[te]))

print(f"全量挑       测试 R² = {r2_all:.5f}   5 列:{cols_all}")
print(f"训练集内挑   测试 R² = {r2_tr:.5f}   5 列:{cols_tr}")
print(f"差 {r2_all - r2_tr:+.5f} 两套列是否相同:{cols_all == cols_tr}")期望输出:
全量挑       测试 R² = 0.92962   5 列:['cycle', 'resistance_mohm', 'coulombic_eff', 'temp_std_c', 'res_win_mean']
训练集内挑   测试 R² = 0.92962   5 列:['cycle', 'resistance_mohm', 'coulombic_eff', 'temp_std_c', 'res_win_mean']
差 +0.00000   两套列是否相同:True
★ 第 4 问的答案
因为这里的 0.00000 是【结果】,而它的三个前提是:
    样本足够多(污染度只有 18.7%)
    模型对尺度不敏感(这里用的是随机森林,压根不缩放)
    被 fit 的步骤(SelectKBest)恰好选出了一样的列
     ↓
三个前提都变了结论就会变 —— 19.3 节的实验已经验证:
训练 16 支设备以下,两套 5 列就完全不同了。
     ↓
"本数据上看不见"只能写成"本数据上看不见",
不能写成"这一类泄漏不重要"
练习 2:用 kNN 把差距放大到 0.05 量级
固定测试集 4 支设备、训练集 2 支设备(RandomState(42) 打乱后取前 4 支做测试、第 5~6 支做训练):
- 打印训练/测试行数与统计量污染度;
- 对线性回归、
Ridge(alpha=100)、kNN(k=5)三个模型,分别跑"全量 fit 缩放器"与"Pipeline 内 fit"; - 打印每个模型的两种 R² 与虚高;
- 解释为什么线性回归那一行永远是 0.00000。
参考答案
import numpy as np, pandas as pd
from sklearn.linear_model import LinearRegression, Ridge
from sklearn.metrics import r2_score
from sklearn.model_selection import GroupShuffleSplit
from sklearn.neighbors import KNeighborsRegressor
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler

BASE = ["cycle", "mean_charge_voltage_v", "mean_temp_rise_c", "resistance_mohm",
        "coulombic_eff", "cap_fade_rate_ah_per_100", "temp_std_c"]
WIN = ["volt_win_mean", "volt_win_std", "res_win_mean", "res_win_std", "temp_win_mean"]
DIFF = ["volt_slope20", "res_slope20", "temp_slope20", "res_diff1"]
SAFE17 = BASE + WIN + DIFF + ["temp_win_range20"]

df = pd.read_csv("data/battery/soh_features_v2.csv").dropna(subset=SAFE17)
rng = np.random.RandomState(42)
cells = np.array(sorted(df["cell_id"].unique()))
rng.shuffle(cells)
test_cells, pool = list(cells[:4]), list(cells[4:])

sub_tr = df[df["cell_id"].isin(pool[:2])]
sub_te = df[df["cell_id"].isin(test_cells)]
Xtr, ytr = sub_tr[SAFE17], sub_tr["soh"]
Xte, yte = sub_te[SAFE17], sub_te["soh"]
full = pd.concat([Xtr, Xte])
print(f"训练 {len(Xtr)} 行 / 测试 {len(Xte)} 行   污染度 = {len(Xte) / len(full):.1%}")

print(f"\n{'模型':<20}{'全量 fit R²':>13}{'Pipeline R²':>13}{'虚高':>11}")
for name, mdl in [("线性回归", LinearRegression()),
                  ("Ridge(alpha=100)", Ridge(alpha=100.0)),
                  ("kNN(k=5)", KNeighborsRegressor(n_neighbors=5))]:
    sc = StandardScaler().fit(full)                       # ❌ 吃了测试集
    bad = mdl.__class__(**mdl.get_params()).fit(sc.transform(Xtr), ytr)
    r_bad = r2_score(yte, bad.predict(sc.transform(Xte)))
    pipe = Pipeline([("sc", StandardScaler()), ("m", mdl)]).fit(Xtr, ytr)   # ✅
    r_ok = r2_score(yte, pipe.predict(Xte))
print(f"{name:<20}{r_bad:>13.5f}{r_ok:>13.5f}{r_bad - r_ok:>+11.5f}")期望输出:
训练 535 行 / 测试 1109 行   污染度 = 67.5%

模型                     全量 fit R²  Pipeline R²         虚高
线性回归                      0.79800      0.79800   +0.00000
Ridge(alpha=100)          0.79328      0.72804   +0.06525
kNN(k=5)                  0.81130      0.76088   +0.05041
★ 第 4 问的答案
线性回归对特征的仿射变换等变:
用全量的 μ、σ 还是训练集的 μ、σ,
学出来的系数会跟着缩放一起变,还原到原始量纲后是同一个函数
     ↓
所以它的预测值在两种口径下逐点相同(最大差 ~1e-16,浮点零)
     ↓
结论:线性回归不能用来探测预处理泄漏;
      要探测它,必须换对尺度敏感的模型(Ridge / kNN / SVR)
练习 3:写一个"fit 位置"静态检查,并验证等变性
- 写
check_fit_scope(model):不是Pipeline就返回(False, 原因),是Pipeline就检查前 n−1 步有没有transform;对裸 scaler、裸 kNN、Pipeline([scaler, model])各跑一次; - 验证等变性:同一份数据,用全量/训练集两种
StandardScaler各 fit 一个线性回归,打印两者预测的最大绝对差; - 打印一句话结论:为什么"预测差 ≈ 1e-16"不能当作"流程没问题"的证据。
参考答案
import numpy as np, pandas as pd
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import GroupShuffleSplit
from sklearn.neighbors import KNeighborsRegressor
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler

BASE = ["cycle", "mean_charge_voltage_v", "mean_temp_rise_c", "resistance_mohm",
        "coulombic_eff", "cap_fade_rate_ah_per_100", "temp_std_c"]
WIN = ["volt_win_mean", "volt_win_std", "res_win_mean", "res_win_std", "temp_win_mean"]
DIFF = ["volt_slope20", "res_slope20", "temp_slope20", "res_diff1"]
SAFE17 = BASE + WIN + DIFF + ["temp_win_range20"]


def check_fit_scope(model):
    if not isinstance(model, Pipeline):
        return False, f"{type(model).__name__} 不是 Pipeline:fit 可能发生在划分之前"
    bad = [n for n, s in list(model.steps)[:-1] if not hasattr(s, "transform")]
    return (not bad), f"预处理步骤 {list(model.named_steps)[:-1]} 都在 Pipeline 内"


df = pd.read_csv("data/battery/soh_features_v2.csv").dropna(subset=SAFE17)
X, y, g = df[SAFE17], df["soh"], df["cell_id"]
tr, te = next(GroupShuffleSplit(n_splits=1, test_size=0.2,
                                random_state=42).split(X, y, groups=g))
Xtr, ytr, Xte = X.iloc[tr], y.iloc[tr], X.iloc[te]

sc_full = StandardScaler().fit(pd.concat([Xtr, Xte]))
sc_tr = StandardScaler().fit(Xtr)
p_full = LinearRegression().fit(sc_full.transform(Xtr), ytr).predict(sc_full.transform(Xte))
p_tr = LinearRegression().fit(sc_tr.transform(Xtr), ytr).predict(sc_tr.transform(Xte))
print(f"两种口径的预测最大差 = {np.abs(p_full - p_tr).max():.2e}")

pipe = Pipeline([("sc", StandardScaler()), ("m", LinearRegression())])
print("裸 scaler          →", check_fit_scope(StandardScaler()))
print("裸 kNN             →", check_fit_scope(KNeighborsRegressor()))
print("Pipeline(scaler,m) →", check_fit_scope(pipe))期望输出:
两种口径的预测最大差 = 2.22e-16
裸 scaler          → (False, 'StandardScaler 不是 Pipeline:fit 可能发生在划分之前')
裸 kNN             → (False, 'KNeighborsRegressor 不是 Pipeline:fit 可能发生在划分之前')
Pipeline(scaler,m) → (True, "预处理步骤 ['sc'] 都在 Pipeline 内")
★ 第 3 问的答案
因为 1e-16 是【线性回归看不见】,不是【泄漏不存在】:
线性模型把缩放的影响吸收进系数里,还原后是同一个函数。
     ↓
换句话说:这个数字衡量的是"模型对尺度敏不敏感",
而不是"流程干不干净"。
     ↓
想用它做证据,必须换成对尺度敏感的模型;
但更省事的做法是【直接检查结构】:assert isinstance(model, Pipeline)
面向工程实践
| 场景 | 怎么用 |
|---|---|
| 代码评审 | 搜索 fit_transform( 在划分之前的调用 —— 一行就能定位这类泄漏 |
| Pipeline 模板 | 把 imputer / scaler / encoder / selector 全部包进去,团队共享同一个模板 |
| 上线打包 | 序列化整个 Pipeline(joblib.dump(pipe, ...)),不手写变换逻辑 |
| 小样本项目 | 数据越少越要小心:污染度 = n_test/(n_train+n_test),样本少时轻松超过 30% |
| 目标编码(target encoding) | 必须用折内均值(out-of-fold),否则是最严重的一类预处理泄漏 |
| 监控离线/线上差异 | 定期比对线上数据的列分布与训练时的 scaler.mean_,偏差大就重训 |
★ 一句话总结本章:
预处理泄漏的量级不由"泄漏"决定,而由"你的配置有多敏感"决定。 它的修复成本是零 —— 所以在任何配置下都没有理由不做。