第 22 章 · 防泄漏检查清单(交付物)
这一章要解决什么:把前面五章的教训收成一张可以带走的清单, 并且让它的每一条都可以被机器执行 —— 因为泄漏恰恰是那种"所有人都会想不起来"的错误。
最容易踩的坑: ① 清单只写"不要泄漏",不写"怎么检查" —— 那种清单没人会用; ② 清单停留在 PPT / 文档里,没有挂到任何流程节点上; ③ 只做静态检查(查代码结构),不做动态对照(两种口径各跑一次)—— 前者只能挡住已知的坑。
本章你需要完成的代码:demos/ch22-leak-checklist.py
本章的交付物:outputs/feature-leak-checklist.md(由 demo 自动生成,可以带走)
22.1 为什么"清单"不够
先看一个真实场景:
周一:评审会通过了一份《防泄漏检查清单》,五条,写得很漂亮
周二:新人加了一列 cycle_frac(因为"老化进度"听起来很合理)
周三:分数从 0.96503 涨到 0.97058,大家都挺高兴
周四:上线,效果不如预期
周五:复盘会上有人翻出周一那份清单 —— 第一条就写着"检查特征可得性"

问题不在清单,在于:清单需要【有人想起来去执行】
★ 三种失败模式,都必须用"卡点"解决:
| 失败模式 | 表现 | 卡点怎么解 |
|---|---|---|
| 想不起来 | 清单在文档里,没人主动跑 | 挂到 CI:PR 自动跑,不通过不能合 |
| 跑得太晚 | 出报告时才发现,返工成本高 | 挂到训练开始:断言失败直接不训练 |
| 只查已知的 | 静态检查只能匹配已知钩子 | 加动态对照:两种口径各跑一次,抓未知 |
★ 一句话区分"清单"和"卡点":
清单:靠人想起来   → 适合当【学习材料】和【评审提纲】
卡点:靠机器执行   → 适合当【流程闸门】

两者都要,但不能用前者代替后者
★ 本章的结构就是这两层:
22.2 五道卡点(每条都可执行)      ← 清单的内容
22.3 交付物(一份可以带走的文档)   ← 清单的形态
22.4 从清单到流程卡点(四个挂载点) ← 卡点的实现
22.5 红线阈值(越线必须举证)       ← 卡点的判据
22.2 五道卡点:每一条都真的跑一遍
本章 demo 的写法有一个硬性要求:每一条检查都必须是可执行的代码, 不允许出现"建议检查一下……"这种句子。
判断一份清单好不好,有一个简单的标准:
    把每一条的"怎么查"复制出来,能不能直接跑?
    跑不出来 → 这一条是口号,不是检查
22.2.1 C1 划分卡点
真实输出:
C1 划分卡点:训练集与测试集不能有同一个『独立单元』
  ✅ 按设备划分        共有独立单元 0 个 / 共有行 0 行 / 跨集相邻对 0 对
  ❌ 按行随机(对照组) 共有独立单元 60 个 / 共有行 0 行 / 跨集相邻对 6757 对
     → 卡点判据:共有设备 == 0 且 跨集相邻对 == 0;否则直接 raise
★ 怎么查(完整函数):
def check_split(df, tr, te, group_col="cell_id"):
    """C1 划分:实体不跨集 + 行不重复 + 没有跨集相邻对。返回 (ok, 说明)。"""
    overlap = set(df.loc[tr, group_col]) & set(df.loc[te, group_col])
    rows_overlap = set(tr) & set(te)
    te_set = set(te)
    cross = 0
    for _, sub in df.groupby(group_col):
        flags = sub.index.isin(te_set)
        cross += int(np.sum(flags[1:] != flags[:-1]))
    ok = (len(overlap) == 0) and (not rows_overlap) and (cross == 0)
    detail = (f"共有独立单元 {len(overlap)} 个 / 共有行 {len(rows_overlap)} 行 / "
              f"跨集相邻对 {cross} 对")
    return ok, detail
★ 三个数字分别抓三类错误:
共有独立单元 > 0  → 实体跨集(第 18 章,本数据 +0.02261)
共有行 > 0        → 索引对齐错误(同一行被切到两边)
跨集相邻对 > 0    → 实体内部的近邻泄漏(本数据按行随机时 6,757 对)
★ 6,757 对是什么概念?
21,179 对相邻行里有 6,757 对被拆到了两边 = 31.9%
     ↓
也就是说:测试集里每 3 行,就有 1 行的"上一行"在训练集里
     ↓
这才是按行随机虚高 +0.02261 的直接来源
22.2.2 C2 预处理卡点
真实输出:
C2 预处理卡点:所有 fit 必须只看到训练集
  ✅ Pipeline([scaler, model])       1 个预处理步骤全部在 Pipeline 内:['sc', 'm']
  ❌ 传进来一个裸 scaler             StandardScaler 不是 Pipeline:无法保证 fit 只发生在训练集
     → 静态检查只能管结构,数值上用『两种口径比一次』兜底:
        线性回归:全量 fit 0.99887 / Pipeline 0.99887  差 -0.00000
        kNN(k=5) :全量 fit 0.89381 / Pipeline 0.87912  差 +0.01469
     → 线性模型看不见它,kNN 看得见 —— 所以卡点必须写成代码,不能靠眼看
★ 两道检查,一道静态、一道动态:
def check_fit_inside_pipeline(model):
    """C2 静态:所有需要 fit 的步骤必须包在 Pipeline 里。"""
    if not isinstance(model, Pipeline):
        return False, f"{type(model).__name__} 不是 Pipeline:无法保证 fit 只发生在训练集"
    bad = [name for name, step in list(model.steps)[:-1] if not hasattr(step, "transform")]
    if bad:
        return False, f"这些步骤没有 transform,可能不是预处理步骤:{bad}"
return True, f"{len(model.steps) - 1} 个预处理步骤全部在 Pipeline 内"# C2 动态:两种口径各跑一次,看预测差(第 19 章的方法)
sc = StandardScaler().fit(pd.concat([Xtr, Xte])) # ❌ 全量
bad = LinearRegression().fit(sc.transform(Xtr), ytr)
good = Pipeline([("sc", StandardScaler()), ("m", LinearRegression())]).fit(Xtr, ytr)
print(np.abs(bad.predict(sc.transform(Xte)) - good.predict(Xte)).max())★ 为什么必须两道都要?
| 检查 | 能抓什么 | 抓不到什么 |
|---|---|---|
静态(isinstance(model, Pipeline)) | 结构错误:裸 scaler、裸 selector、裸 imputer | 藏在自己写的函数里的 fit_transform |
| 动态(两种口径比分) | 数值差异:任何"fit 看到了测试集"的实现 | 差异恰好为 0 的情况(线性模型见第 19 章) |
★ 本数据上这道卡点的一个真实教训(第 19 章):
线性回归:差 −0.00000(等变,看不见)
kNN     :差 +0.01469(看得见)
     ↓
如果我们的卡点只用"线性模型 + 大样本"来验证,
会得出"预处理没问题"的错误结论
     ↓
所以动态检查必须挑【对尺度敏感】的模型(Ridge / kNN / SVR)+
【小样本】配置,才具备检出能力
22.2.3 C3 特征卡点
真实输出:
C3 特征卡点:已知钩子 + 超高相关列 + 系数体检
  ✅ 安全特征 21 列       已知钩子 无;|r| > 0.999 的列 ['soh_lag1', 'soh_lag5', 'soh_win_mean5']
  ❌ 21 列 + 两个钩子     已知钩子 ['cycle_frac', 'soh_margin'];|r| > 0.999 的列 ['soh_lag1', 'soh_lag5', 'soh_win_mean5', 'soh_margin']
     系数体检(这才是能抓住【未知】钩子的那条):
        带钩子的 8 列:max|coef| = 0.9999,它占全部 |coef| 的 98.9%   ← 单列吃掉一切
        干净的 7 列  :max|coef| = 0.5556,它占全部 |coef| 的 79.9%
        MAE 对照:干净 0.010820  /  带钩子 2.10e-06
     → 判据:max|coef| ≈ 1 且单列占比 > 80% → 立刻回看那一列是怎么算的
★ 三道子检查,强度依次递增:
# C3-a 黑名单:已知钩子不许出现在特征里(抓已知)
leaked = sorted(set(LEAKY_COLS) & set(feats))
assert not leaked, f"危险列进入了特征:{leaked}"

# C3-b 相关性:|r| > 0.999 报警(抓可疑,但会误报,见第 20 章)
hi = [c for c in feats if abs(np.corrcoef(df[c], df["soh"])[0, 1]) > 0.999]

# C3-c 系数体检:一列独大(抓未知,最有用)
c = np.abs(model.coef_)
print(f"max|coef| = {c.max():.4f}   单列占比 = {c.max() / c.sum():.1%}")
★ 为什么 C3-c(系数体检)最重要?
C3-a 只能抓"我们已经知道的"钩子(cycle_frac / soh_margin)
C3-b 会误报(soh_lag1 = 0.9991 是合法的)、会漏报(cycle_frac = 0.9757)
C3-c 不需要知道钩子长什么样:
     只要"某一列的系数 ≈ 1、其余列 ≈ 0",就一定是这一列在替模型抄答案
     ↓
它对【未知的】泄漏有效 —— 这是它比前两条更值钱的原因
★ 而"单列占比"这个指标还有一个更通用的版本(不限于线性模型):
imp = model.feature_importances_          # 树模型
print(f"最重要的一列:{feats[int(imp.argmax())]} 占比 {imp.max():.1%}")本数据(第 20 章实测):带 cycle_frac 时它吃掉 95.81% 的重要性
↓
"某列重要性 > 90%" 在任何模型上都值得停下来问一句22.2.4 C4 时序卡点
真实输出:
C4 时序卡点:shift(1) 有没有漏写(用 NaN 的位置抓它,而不是用分数)
  ✅ 结构检查:每支设备最早 5 行的 NaN 比例:shift(1) 后 100.0%(应为 100%)/漏写 shift 时 80.0%(应为 0%)
     漏写 shift 后,每支设备最早 5 行里有 4 行有值,总共少 60 个 NaN —— 一眼可辨
     但【分数】几乎看不出来(本书实测,把窗口均值当唯一特征):
        shift(1).rolling(5)(✅ 只用过去)        测试 R² = 0.99849
        rolling(5)(❌ 含当前行)                 测试 R² = 0.99900
     → 0.99849 与 0.99900 的差别,你在周报里根本不会注意到;
       NaN 位置是【结构性事实】,一秒钟就能判定。
  ⚠️ 本项目未做:按【时间】再切一次(早期数据训练、后期数据验证)
★ 怎么查(完整函数):
def check_shift_structure(df, group_col="cell_id", w=5, col="soh"):
    """C4 时序:`shift(1)` 有没有漏写 —— 用『最早 w 行必须全是 NaN』来抓。"""
    d = df.sort_values([group_col, "cycle"])
    grp = d.groupby(group_col)[col]
    ok_series = grp.transform(lambda s: s.shift(1).rolling(w).mean())   # ✅ 先 shift
    bad_series = grp.transform(lambda s: s.rolling(w).mean())           # ❌ 含当前行
    head = d.groupby(group_col).cumcount() < w
    ok_head = ok_series[head].isna().mean()          # 应为 1.0
    bad_head = bad_series[head].isna().mean()        # 应为 0.8(= 4/5)
    ok = bool(np.isclose(ok_head, 1.0)) and not bool(np.isclose(bad_head, 1.0))
    return ok, (f"最早 {w} 行 NaN 比例:shift(1) 后 {ok_head:.1%}/"
                f"漏写 shift 时 {bad_head:.1%}")
★ 这一条卡点的设计思想值得单独讲:用【结构】而不是【分数】做判据。
靠分数发现漏写 shift 1 位:0.99849 → 0.99900(差 0.00051,你根本不会注意)
靠 NaN 位置发现:最早 5 行里应该有 5 个 NaN,实际只有 4 个 → 立刻报错
     ↓
"结构性事实"(某个位置该不该是 NaN)比"数值差异"(分数高低)灵敏得多
     ↓
通用经验:能用结构判定的,就不要用分数判定
★ 这一条还留了一个 ⚠️ 项,必须诚实写上:
本项目:窗口表按【设备】分组切分,但没有再按【时间】切
     ↓
真实项目应该补一条"早期数据训练、后期数据验证"
     ↓
清单里保留 ⚠️ 不是"没写完",而是"明确记录已知缺口"
—— 一张全 ✅ 的清单通常意味着检查得太浅
22.2.5 C5 评估卡点
真实输出:
C5 评估卡点:测试集只准被评估一次
  ✅ 第一次评估 R² = 0.94253
  ❌ 第二次评估 → AssertionError: 测试集被评估了 2 次 —— 它已经参与选择,这个分数不能再用于最终报告
     → 调参、选特征、挑模型一律走交叉验证;测试集只在最后开一次
★ 怎么查(一个 8 行的守卫类):
class TestSetGuard:
    """把测试集包起来:只允许 score 一次,第二次直接抛错。"""

    def __init__(self, name="test"):
        self.name = name
        self.n = 0

    def score(self, model, X, y):
        self.n += 1
        assert self.n == 1, (f"测试集被评估了 {self.n} 次 —— 它已经参与选择,"
                             f"这个分数不能再用于最终报告")
        return r2_score(y, model.predict(X))
★ 为什么"评估"也要算一道泄漏卡点?
第 17 ~ 21 章讲的三类泄漏,都发生在"数据进入模型之前"
这一条不一样:它防的是【人对测试集的反复使用】
     ↓
每用测试集做一次选择(调参 / 选特征 / 挑模型),
测试集的信息就渗进模型一次
     ↓
用 20 次之后,测试集实质上变成了"第二个训练集",
只是你自己不知道
     ↓
这一类泄漏在文献里叫"测试集过拟合"(test set overfitting),
它比划分泄漏更隐蔽:因为每一单次操作看起来都很小
★ 正确姿势只有一句:
调参 / 选特征 / 挑模型 → 一律走交叉验证(本项目用 GroupKFold)
测试集                → 只在最后开一次,用于生成最终报告
     ↓
如果中途改了主意(换了特征、换了模型),
那就把测试集"重新封存",并如实记录"我用了它几次"
22.2.6 五道卡点的实测判定
真实输出:
  五条检查项的实测判定:
  编号   环节     判定    依据
  C1   划分     ✅     共有设备 0 支 / 跨集相邻对 0 对
  C2   预处理    ✅     1 个预处理步骤在 Pipeline 内(对照:裸 scaler 被判 ❌)
  C3   特征     ✅     21 列可登记;混入钩子立刻判 ❌(['cycle_frac', 'soh_margin'])
  C4   时序     ✅     最早 5 行 NaN 比例 100%(漏写 shift 时为 80%);时间切分 ⚠️ 待补
  C5   评估     ✅     TestSetGuard 第二次访问抛错;调参走 GroupKFold
★ 注意这里有一行是 ✅ 但带 ⚠️ 的(C4)。 这是刻意的:
清单的价值不在于"全部打勾",而在于【让缺口可见】
     ↓
一张全 ✅ 的清单有两种可能:
    ① 项目真的很干净
    ② 检查写得太浅(只查了容易查的)
     ↓
所以清单要强制包含"待确认项",并且写明【谁负责确认】
22.3 交付物:清单长什么样
demo 会把清单写成一份 Markdown 文件(outputs/feature-leak-checklist.md), 它的结构如下(真实文件内容):
① 五道卡点表(节选)
| # | 环节 | 要问的问题 | 怎么查(可执行) | 本项目判定 | 触发时机 | 责任人 |
|---|---|---|---|---|---|---|
| C1 | 划分 | 测试单元的"身份"有没有出现在训练集里? | set(df.loc[tr,'cell_id']) & set(df.loc[te,'cell_id']) 必须为空;再数一遍"跨集相邻对" | ✅ 共有设备 0 支 / 跨集相邻对 0 对 | 每次划分后 | 特征+评估负责人 |
| C2 | 预处理 | 缩放 / 编码 / 填充 / 选择,有没有在哪一步看到了测试集? | assert isinstance(model, Pipeline);再跑一次"全量 fit vs Pipeline"比分 | ✅ 1 个预处理步骤全在 Pipeline 内 | 每次改特征变换后 | 建模负责人 |
| C3 | 特征 | 每一列在"预测这一刻"真的拿得到吗? | 按特征账本逐列登记可得性;set(LEAKY_COLS) & set(feats) 必须为空;打印 max|coef| 与单列占比 | ✅ 21 列可登记;❌ 混入 cycle_frac / soh_margin 立刻判错 | 每次新增特征后 | 特征负责人 + 业务方 |
| C4 | 时序 | shift(1) 有没有漏写?要不要再按时间切? | 每支设备最早 w 行必须全是 NaN;cumcount() < w 的比例应为 100% | ✅ 100%(漏写 shift 时为 80%);⚠️ 时间切分待补 | 每次构造时序特征后 | 特征负责人 |
| C5 | 评估 | 测试集有没有参与调参 / 选特征 / 挑模型? | TestSetGuard:第二次 score 直接抛错;调参一律 GroupKFold | ✅ 第二次访问抛错 | 每次出最终报告前 | 评估负责人 |
★ 三个字段是"让清单能被别人执行"的关键:
| 字段 | 为什么必须有 |
|---|---|
| 怎么查(可执行) | 没有它,清单就是口号 |
| 触发时机 | 没有它,清单永远不会被执行("重要性"不能当触发器) |
| 责任人 | 没有它,⚠️ 项永远不会被确认 |
② 一句话判据
在这个评估里,模型能看到哪些信息?上线时,这些信息我一样都拿得到吗?③ 复用第 16 章的特征账本格式(逐列登记可得性)
真实输出:
  列名                        判定    依据
  cycle                     ✅     已知:想预测第几圈就知道
  resistance_mohm           ✅     当圈实测
  temp_win_range20          ✅     过去 20 窗口的极差
  soh_lag1                  ⚠️    需要能拿到历史【实测】SOH
  soh_win_mean5             ⚠️    同上
  cycle_frac                ❌     分母 = 该设备最终总寿命,只有退役才知道(未来聚合)
  soh_margin                ❌     = soh − 0.80,等于把标签当作输入(标签自身)
  soh_future                ❌     = 下一个窗口的 soh(未来时刻的值)
★ 账本里最值钱的一行是 ⚠️:它把一个模糊的担忧变成了一个可追问的问题。
"soh_lag1 能不能用?"                        → 没人能回答
"现场每 20 圈做一次容量标定吗?如果是就能用" → 业务方立刻能回答
     ↓
本章主线配置能到 0.99904,完全取决于这个问题的答案是"是"
     ↓
所以这一行必须写进文档,并注明【谁确认的、什么时候确认的】
22.4 从清单到流程卡点
真实输出:
③ 从清单到流程卡点:让它自动跑,而不是等人想起来
  三个挂载点(顺序就是泄漏发生的时间顺序):
    ① 改代码时(PR):静态检查 + 单元测试 —— C2/C3 能自动化到 100%
    ② 训练开始时:划分断言 + 时序结构检查 —— 失败就直接不训练(C1/C4)
    ③ 出报告前:测试集守卫 + 红线阈值 —— 越线就必须附举证材料(C5)

  ★ 为什么必须是『卡点』而不是『清单』:
     清单靠人想起来,卡点靠机器执行;
     泄漏恰恰是那种『所有人都会想不起来』的东西。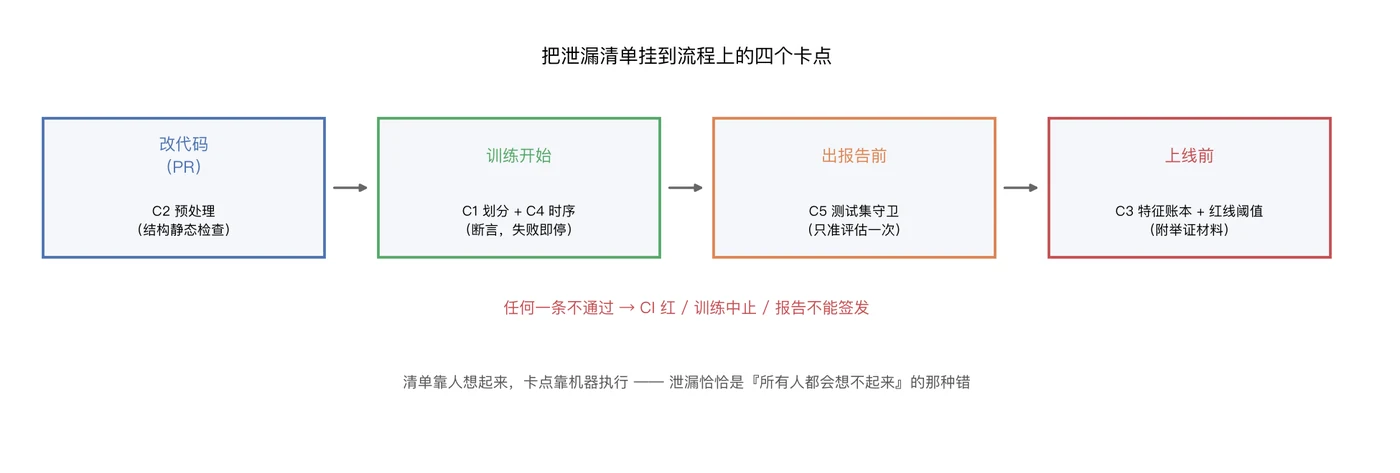
★ 四个挂载点,逐条给出可复制的实现:
挂载点一:PR(改动特征或划分的文件就必须跑)
# .github/workflows/leak-gate.yml
name: leak-gate
on: [pull_request]
jobs:
  leak-audit:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - run: python demos/ch22-leak-checklist.py
      - run: python - <<'PY'
        import json, sys
        r = json.load(open('outputs/leak-audit.json'))
        sys.exit(1 if any(not v['ok'] for v in r.values()) else 0)
PY要点:审计脚本要把结果落成 JSON(便于 CI 判定),而不是只打印到屏幕
↓
"打印出来给人看"是清单,"写成 JSON 让 CI 判断"是卡点挂载点二:训练开始时(断言失败直接不训练)
def train_with_gates(df, feats, model):
    assert_no_leaky(feats)                                   # C3-a 黑名单
    tr, te = split_by_group(df)                              # 按设备划分
    ok, detail = check_split(df, tr, te, "cell_id")
    assert ok, f"划分卡点失败:{detail}"                      # C1
    ok, detail = check_shift_structure(df)                   # C4
    assert ok, f"时序卡点失败:{detail}"
    assert isinstance(model, Pipeline), "模型必须是 Pipeline"  # C2
return model.fit(df.iloc[tr][feats], df.iloc[tr]["soh"])要点:断言放在【训练之前】——
训练一次可能要几分钟到几小时,早失败一分钟都是净收益挂载点三:出报告前(越线必须举证)
def check_red_lines(r2, mae, mae_normal, max_abs_coef, top1_share, gap):
    flags = []
    if r2 > 0.995:
        flags.append("R² > 0.995:必须附三张体检表(划分/预处理/特征)")
    if mae < mae_normal / 1000:
        flags.append("MAE 只有正常水平的 1/1000 以下:查恒等式/重复行")
    if max_abs_coef > 0.99 and top1_share > 0.8:
        flags.append("max|coef| ≈ 1 且单列占比 > 80%:看那一列怎么算的")
    if gap > 0.02:
        flags.append("两种划分差 > 0.02:以分组口径为准并查管道")
    return flags
挂载点四:上线前(模型卡必须附审计输出)
模型卡(model card)里固定附三样东西:
    ① 本次训练的审计输出(五道卡点的判定 + 时间戳 + commit)
    ② 特征账本的可得性表(含所有 ⚠️ 项的确认记录)
    ③ 红线阈值的越线清单(如果有越线,写明举证材料)
     ↓
没有这三样,不允许发版 ——
这一步把"技术检查"变成"发布流程的一部分"
★ 这四个挂载点的顺序,就是泄漏发生的时间顺序:
改代码(PR)→ 训练开始 → 出报告前 → 上线前
     ↑            ↑            ↑          ↑
   结构错误     划分/时序     评估纪律   落地把关
     ↓
每一个挂载点只做"这一步能做的检查",
不去越界(PR 阶段没有数据,就只做静态检查)
22.5 红线阈值:分数高到多少就必须举证
清单解决"有没有做检查",阈值解决"检查到什么程度"。
| 现象 | 阈值 | 必须做的事 |
|---|---|---|
| 测试 R² | > 0.995 | 附"划分 + 预处理 + 特征"三张体检表,并说明天花板在哪 |
| 测试 R² | = 1.000000 | 视为事故:先查标签泄漏,再看 coef_ 与 MAE(第 21 章) |
| MAE | < 正常水平的 1/1000 | 查恒等式、重复行、shift(-k) |
| 某一列 |r| | > 0.999 | 逐列回答"预测时刻可得吗",写进特征账本 |
max|coef| | ≈ 1 且单列占比 > 80% | 直接看那一列的构造代码 |
| 两种划分的分数差 | > 0.02 | 以分组口径为准,回头查数据管道 |
| 某列特征重要性 | > 90% | 问"这一列凭什么这么值钱" |
| 训练/测试差 | > 0.05 | 不是泄漏,是过拟合(第 23 章),但同样要处理 |
★ 阈值的设计原则:宁可多报警,不要漏报。
漏报的代价:一个泄漏的模型进了生产,几个月后才发现
误报的代价:多花 30 分钟附三张体检表
     ↓
所以阈值应该偏保守,并且【报警不等于封杀】——
它触发的是"必须给出解释",而不是"必须回滚"
     ↓
本项目的实践:五道卡点里,C1/C4 是【硬卡点】(抛错),
C3/红线阈值是【软卡点】(要求解释)
★ 一个容易忽略的细节:阈值必须写进代码,而不是写在文档里。
文档里的阈值 → 评审时会被引用一次,然后被遗忘
代码里的阈值 → 每次训练都会被执行
     ↓
本项目的做法:
    RED_LINES = {"r2": 0.995, "mae_ratio": 1 / 1000, "coef": 0.99,
                 "coef_share": 0.8, "split_gap": 0.02}
    把它放在一个模块里,训练脚本 import 它
     ↓
阈值改动需要走代码评审 —— 这本身就防止了"为了让报告通过而调高阈值"
22.6 本章练习
先看一张自检清单(这一章的核心知识都在里面):
已勾选 0 / 0 项
如果打勾超过 80%,你已经能独立做一次"防泄漏审计"了。
练习 1:实现 C1 与 C4 两道卡点
- 实现
check_split(df, tr, te, group_col="cell_id"):返回(ok, 说明),检查共有独立单元、共有行、跨集相邻对; - 实现
check_shift(df, group_col="cell_id", w=5, col="soh"):用"最早 w 行必须全是 NaN"判断shift(1)有没有漏写; - 对按设备划分 / 按行随机两种配置分别跑 C1;
- 对
soh_features.csv跑 C4,打印两种写法的 NaN 比例。
参考答案
import numpy as np, pandas as pd
from sklearn.model_selection import GroupShuffleSplit, train_test_split

BASE = ["cycle", "mean_charge_voltage_v", "mean_temp_rise_c", "resistance_mohm",
        "coulombic_eff", "cap_fade_rate_ah_per_100", "temp_std_c"]


def check_split(df, tr, te, group_col="cell_id"):
    overlap = set(df.loc[tr, group_col]) & set(df.loc[te, group_col])
    te_set = set(te)
    cross = 0
    for _, sub in df.groupby(group_col):
        flags = sub.index.isin(te_set)
        cross += int(np.sum(flags[1:] != flags[:-1]))
    ok = len(overlap) == 0 and cross == 0
    return ok, f"共有独立单元 {len(overlap)} 个 / 跨集相邻对 {cross} 对"


def check_shift(df, group_col="cell_id", w=5, col="soh"):
    d = df.sort_values([group_col, "cycle"])
    grp = d.groupby(group_col)[col]
    ok_s = grp.transform(lambda s: s.shift(1).rolling(w).mean())
    bad_s = grp.transform(lambda s: s.rolling(w).mean())
    head = d.groupby(group_col).cumcount() < w
    ok_head, bad_head = ok_s[head].isna().mean(), bad_s[head].isna().mean()
    ok = bool(np.isclose(ok_head, 1.0)) and not bool(np.isclose(bad_head, 1.0))
    return ok, (f"最早 {w} 行 NaN 比例:shift(1) 后 {ok_head:.1%}/"
                f"漏写 shift 时 {bad_head:.1%}")


df = pd.read_csv("data/battery/soh_features_v2.csv")
X, y, g = df[BASE], df["soh"], df["cell_id"]
tr_g, te_g = next(GroupShuffleSplit(n_splits=1, test_size=0.2,
                                    random_state=42).split(X, y, groups=g))
tr_r, te_r = train_test_split(np.arange(len(X)), test_size=0.2, random_state=42)

for tag, (tr, te) in (("按设备划分", (tr_g, te_g)), ("按行随机", (tr_r, te_r))):
    ok, detail = check_split(df, tr, te)
    print(f"C1 {tag:<10}{'✅' if ok else '❌'}  {detail}")

raw = pd.read_csv("data/battery/soh_features.csv")
ok, detail = check_shift(raw[["cell_id", "cycle", "soh"]])
print(f"C4 shift(1) 结构检查 {'✅' if ok else '❌'} {detail}")期望输出:
C1 按设备划分     ✅  共有独立单元 0 个 / 跨集相邻对 0 对
C1 按行随机      ❌  共有独立单元 60 个 / 跨集相邻对 6757 对
C4 shift(1) 结构检查   ✅  最早 5 行 NaN 比例:shift(1) 后 100.0%/漏写 shift 时 80.0%
★ 三行输出,三道防线:
① 共有独立单元 60 → 实体跨集(划分泄漏,第 18 章)
② 跨集相邻对 6,757 → 近邻泄漏(划分泄漏的"细粒度"版本)
③ NaN 比例 100% vs 80% → shift 方向正确性(第 20 章,用结构判定)
练习 2:实现 TestSetGuard 与红线阈值检查
- 实现
TestSetGuard:第二次score抛AssertionError; - 实现
check_red_lines(r2, mae, mae_normal, max_abs_coef, top1_share, gap),返回需要举证的理由列表; - 对"干净 7 列"与"带钩子 8 列"两个模型各跑一次,打印各自的越线清单。
参考答案
import numpy as np, pandas as pd
from sklearn.linear_model import LinearRegression
from sklearn.metrics import r2_score
from sklearn.model_selection import GroupShuffleSplit

BASE = ["cycle", "mean_charge_voltage_v", "mean_temp_rise_c", "resistance_mohm",
        "coulombic_eff", "cap_fade_rate_ah_per_100", "temp_std_c"]


class TestSetGuard:
    def __init__(self, name="test"):
        self.name = name
        self.n = 0

    def score(self, model, X, y):
        self.n += 1
        assert self.n == 1, f"测试集被评估了 {self.n} 次 —— 它已经参与选择"
        return r2_score(y, model.predict(X))


def check_red_lines(r2, mae, mae_normal, max_abs_coef, top1_share, gap):
    flags = []
    if r2 > 0.995:
        flags.append(f"测试 R² = {r2:.5f} > 0.995:必须附三张体检表")
    if mae < mae_normal / 1000:
        flags.append(f"MAE = {mae:.2e} 只有正常水平的 {mae / mae_normal:.2e}:查恒等式/重复行")
    if max_abs_coef > 0.99 and top1_share > 0.8:
        flags.append(f"max|coef| = {max_abs_coef:.4f} 且单列占比 {top1_share:.1%}")
    if gap > 0.02:
        flags.append(f"两种划分差 {gap:+.5f} > 0.02:以分组口径为准并查管道")
    return flags


df = pd.read_csv("data/battery/soh_features_v2.csv")
y = df["soh"]
tr, te = next(GroupShuffleSplit(n_splits=1, test_size=0.2, random_state=42)
              .split(df[BASE + ["soh_margin"]], y, df["cell_id"]))
clean = LinearRegression().fit(df[BASE].iloc[tr], y.iloc[tr])
leaker = LinearRegression().fit(df[BASE + ["soh_margin"]].iloc[tr], y.iloc[tr])

guard = TestSetGuard()
print(f"✅ 第一次评估 R² = {guard.score(clean, df[BASE].iloc[te], y.iloc[te]):.5f}")
try:
    guard.score(clean, df[BASE].iloc[te], y.iloc[te])
except AssertionError as e:
    print(f"❌ 第二次评估 → AssertionError: {e}")

mae_normal = np.abs(clean.predict(df[BASE].iloc[te]) - y.iloc[te].to_numpy()).mean()
for tag, model, feats in (("干净 7 列", clean, BASE),
                          ("带钩子 8 列", leaker, BASE + ["soh_margin"])):
    c = np.abs(model.coef_)
    r2 = r2_score(y.iloc[te], model.predict(df[feats].iloc[te]))
    mae = np.abs(model.predict(df[feats].iloc[te]) - y.iloc[te].to_numpy()).mean()
    print(f"{tag}:")
    for f in check_red_lines(r2, mae, mae_normal, c.max(), c.max() / c.sum(), 0.02261):
print(f" ⚠️ {f}")期望输出:
✅ 第一次评估 R² = 0.94253
❌ 第二次评估 → AssertionError: 测试集被评估了 2 次 —— 它已经参与选择

干净 7 列:
  ⚠️ 两种划分差 +0.02261 > 0.02:以分组口径为准并查管道
带钩子 8 列:
  ⚠️ 测试 R² = 1.00000 > 0.995:必须附三张体检表
  ⚠️ MAE = 2.10e-06 只有正常水平的 1.94e-04:查恒等式/重复行
  ⚠️ max|coef| = 0.9999 且单列占比 98.9%
  ⚠️ 两种划分差 +0.02261 > 0.02:以分组口径为准并查管道
★ 注意"干净 7 列"也报了一条:
它报的是"两种划分差 +0.02261 > 0.02" ——
这一条与模型无关,是【评估口径】的红线
     ↓
说明红线检查是"分层"的:
    有些红线挂在模型上(系数、MAE)
    有些红线挂在评估口径上(划分差)
    两者都要查,不能只查一个
练习 3:生成一份可以带走的清单
- 写一个函数/脚本,生成 Markdown 文件(写到
outputs/ex22-leak-checklist.md); - 内容至少包含:五道卡点表(含"怎么查"列)、一句话判据、本项目判定、触发时机;
- 运行后打印文件路径,并打印内容预览的前几行;
- 用一句话说明:为什么"怎么查"这一列不能省?
参考答案
import os

OUT = os.path.join("outputs", "ex22-leak-checklist.md")

LINES = [
    "# 数据泄漏检查清单(练习交付物)",
    "",
    "| # | 环节 | 怎么查 | 本项目判定 | 触发时机 |",
    "|---|---|---|---|---|",
    "| C1 | 划分 | `set(df.loc[tr,'cell_id']) & set(df.loc[te,'cell_id'])` 必须为空 | "
    "✅ 0 支 / 跨集相邻对 0 对 | 每次划分后 |",
    "| C2 | 预处理 | `assert isinstance(model, Pipeline)` + 全量对比一次 | "
    "✅ 全部 fit 在 Pipeline 内 | 每次改特征变换后 |",
    "| C3 | 特征 | 逐列登记可得性;`set(LEAKY_COLS) & set(feats)` 为空 | "
    "✅ 21 列可登记 / ❌ 两个钩子已隔离 | 每次新增特征后 |",
    "| C4 | 时序 | 最早 w 行必须全为 NaN(`cumcount() < w`) | ✅ 100% | 每次构造时序特征后 |",
    "| C5 | 评估 | `TestSetGuard`:第二次 score 抛错 | ✅ 第二次抛错 | 每次出报告前 |",
    "",
    "> 一句话判据:**预测这一刻,我手上真的拿得到这个数吗?**",
    "",
]

os.makedirs("outputs", exist_ok=True)
with open(OUT, "w", encoding="utf-8") as f:
    f.write("\n".join(LINES))
print(f"已写入 {OUT}")
print("内容预览:")
for line in LINES[:4]:
print(f" {line}")期望输出(节选):
已写入 outputs/ex22-leak-checklist.md
内容预览:
  # 数据泄漏检查清单(练习交付物)

  | # | 环节 | 怎么查 | 本项目判定 | 触发时机 |
  |---|---|---|---|---|
★ 第 4 问的答案
因为"怎么查"决定了这份清单是【资产】还是【口号】:
    没有它 → 读者知道"要检查划分",但不知道从哪一行代码开始
    有它   → 复制粘贴就能跑,检查成本降到 10 秒
     ↓
一条检查的成本越低,被执行的概率越高 ——
清单的设计目标不是"完整",而是"低摩擦"
22.7 常见坑
① 清单只写"不要泄漏",不写"怎么查"        → 等于没写
② 清单不写责任人 / 触发时机                → 永远不会被执行
③ 停留在 PPT / 文档里,不进 CI              → 一次性的仪式
④ 只有静态检查,没有动态对照                → 只能挡住已知的坑
⑤ 动态对照用"线性模型 + 大样本"来验证       → 检出能力为零(第 19 章)
⑥ 追求"全 ✅"的清单                        → 通常意味着检查太浅
⑦ 阈值写在文档里而不是代码里                → 为了让报告通过而被调高
⑧ 把测试集当成"第二个训练集"反复使用        → 最隐蔽的一类泄漏(C5)
★ 第 ⑦ 条值得单独讲,因为它是"流程卡点"最常见的死法:
文档里的阈值:"R² 高于 0.995 需要额外举证"
     ↓
报告要交了,R² = 0.996,附举证太麻烦
     ↓
有人把文档里的阈值改成 0.999("技术委员会同意")
     ↓
阈值形同虚设
     ↓
正确做法:阈值是代码常量,改动必须走代码评审并留记录
—— 让"调高阈值"的成本 ≥ "附举证"的成本
★ 第 ⑧ 条是最容易被忽略的,因为它的每一次操作都很小:
用测试集挑了 3 次特征、试了 5 组超参、比了 2 个模型
     ↓
每次都可以解释:"我就看一眼"
     ↓
合起来:测试集被看了 10 次,它已经不再"没见过"
     ↓
`TestSetGuard` 的价值就是让"看一眼"这个动作变成"必须承认"
22.8 完整示例与输出
cd tools/feature-engineering-pipeline/code
MPLCONFIGDIR=/tmp/fe-mpl /Users/jini/Projects/MyBooks/Basic-Tutorials/.pytmp/venv/bin/python \
demos/ch22-leak-checklist.py真实输出(节选):
C1 划分卡点
  ✅ 按设备划分        共有独立单元 0 个 / 共有行 0 行 / 跨集相邻对 0 对
  ❌ 按行随机(对照组) 共有独立单元 60 个 / 共有行 0 行 / 跨集相邻对 6757 对

C2 预处理卡点
  ✅ Pipeline([scaler, model])       1 个预处理步骤全部在 Pipeline 内
  ❌ 传进来一个裸 scaler             StandardScaler 不是 Pipeline
        线性回归:全量 fit 0.99887 / Pipeline 0.99887  差 -0.00000
        kNN(k=5) :全量 fit 0.89381 / Pipeline 0.87912  差 +0.01469

C3 特征卡点
  ✅ 安全特征 21 列       已知钩子 无
  ❌ 21 列 + 两个钩子     已知钩子 ['cycle_frac', 'soh_margin']
        带钩子的 8 列:max|coef| = 0.9999,单列占比 98.9%
        干净的 7 列  :max|coef| = 0.5556,单列占比 79.9%

C4 时序卡点
  ✅ 结构检查:最早 5 行 NaN 比例 100.0%(漏写 shift 时 80.0%)
        shift(1).rolling(5)(✅ 只用过去)        测试 R² = 0.99849
        rolling(5)(❌ 含当前行)                 测试 R² = 0.99900
  ⚠️ 本项目未做:按【时间】再切一次

C5 评估卡点
  ✅ 第一次评估 R² = 0.94253
  ❌ 第二次评估 → AssertionError: 测试集被评估了 2 次

② 交付物:outputs/feature-leak-checklist.md(69 行)
③ 从清单到流程卡点:PR / 训练开始 / 出报告前 / 上线前
面向工程实践
| 场景 | 怎么用 |
|---|---|
| 团队规范 | 把五道卡点写进 CONTRIBUTING.md:改特征/改划分必须跑审计 |
| CI 集成 | 审计脚本输出 JSON;any(not ok) 就让 PR 红 |
| 新项目脚手架 | 把 check_split / check_fit_inside_pipeline / check_shift_structure / TestSetGuard 做成模板函数 |
| 模型卡(model card) | 固定附审计输出 + 特征账本可得性表 + 越线清单 |
| 复盘 | 每次线上事故复盘时重跑一遍清单,看哪一道卡点没拦住 |
| 教学 | 本章清单是最好的新人 onboarding 材料:五条覆盖三类泄漏 + 评估纪律 |
★ 本章与后续章节的关系:
第 22 章(本章)→ 交付物:清单 + 卡点
第 23 ~ 27 章  → 从"防泄漏"转向"防过拟合 / 防无效调参"
第 31 章       → 把"清单到卡点"这件事推广到整个团队流程
     ↓
防泄漏是【数据与流程】的问题;
防过拟合是【模型与容量】的问题 ——
先解决前者,因为前者的错误无法通过换模型弥补(第 17 章)
★ 一句话总结本章:
清单靠人想起来,卡点靠机器执行。 防泄漏的最终形态不是一张更长的清单, 而是五个每次都会自动跑起来的检查 —— 以及四个它们挂上去的位置。
下一章:第 23 章 · 过拟合的形状