第 28 章 · 多窗口平均:三个回看窗口,以及一个最容易漏的口径陷阱
这一章要解决什么:第 5 章起,"回看多少个窗口"就是一个反复出现的旋钮。 这一章把它当成超参系统地试一遍,并顺手做一次集成(多窗口平均)。
最容易踩的坑: ① 三张特征表的可用样本数不一样(20,879 / 19,979 / 18,179)—— 直接比"测试 R²"时,Δ 里混进了 Δ 样本; ② 对长度不同的预测数组直接取平均 →
ValueError; ③ 以为"窗口越长越好"或者"越短越好"——本数据上三者几乎一样。
本章你需要完成的代码:demos/ch28-multi-window.py
本章的数字口径:soh_features_v2.csv 的 21 列安全特征, 回看窗口分别取 5 / 20 / 50(shift(1).rolling(w),轨迹列固定 shift(1) / shift(5)), dropna 后可用样本 20,879 / 19,979 / 18,179 行,共同行 18,179; 在共同行上按设备 GroupShuffleSplit(test_size=0.2, random_state=42) → 训练 14,796 / 测试 3,383 行。
28.1 回看窗口:那个一直在用的旋钮
先回顾:什么叫"回看 w 个窗口"
时间轴(每支设备自己的窗口序列,1 窗口 = 3 圈)
        ┌──── w 个窗口 ────┐
 C001   ● ● ● ● ● ● ● ● ● ● ◀ 当前窗口
        └─── 只用这些算统计量 ───┘
              (shift(1) 之后,所以不含当前行)
代码上就是一句话里的那个 w:
df["volt_win_mean"] = g["mean_charge_voltage_v"].transform(
    lambda s: s.shift(1).rolling(w).mean())
#                                    ↑ 这个 w 就是"回看多少个窗口"
★ 这个 w 同时控制两件相反的事
| w 变大 | 影响 |
|---|---|
| 统计量更平滑 | 噪声被平均掉 → 特征更稳 |
| 冷启动更晚 | 每支设备最前面更多的行没有历史 → 可用样本更少 |
| 反应更迟钝 | 近期的突变被稀释 → 可能丢掉真实信号 |
★ 所以它是一个典型的"超参":没有先验答案,必须试。
★ 但试的时候有一个陷阱 —— 就是本章的主角
w=5  :可用 20,879 行
w=20 :可用 19,979 行
w=50 :可用 18,179 行
      ↑
三个数字【不一样】
   ↓
如果各表用【自己那 20%】当测试集:
  测试集长度分别是 4,176 / 3,996 / 3,636 行
  而且它们【不是同一批行】
      ↓
你比较的"哪个 w 更好"里,混进了"哪一档多吃了哪些更难的样本"
★ 本章的核心纪律:
先取"三个窗口都能用"的共同行,在共同行上划分, 然后三个窗口用同一个测试集、同一套测试下标。 各窗口模型仍用自己的特征表训练,但只在共同测试下标上预测、再取平均。
点开:为什么"共同行"要用 Index.intersection,而不是按位置对齐?
因为三张表的"行"不是同一个编号体系。
X.loc[某个下标] 里的下标,是【原始 v2 表的行号】(reset_index 之前带洞的 index)
   ↓
w=5 的表里有一行 index=100,w=50 的表里可能根本没有 index=100
   ↓
所以"第 100 行"在三张表里指的是【三个不同的东西】
★ 一个可以自己验证的小实验
t5, t20, t50 = tabs[5], tabs[20], tabs[50]
print("三张表的 index 前 5 个:")
print("  w=5 :", t5.index[:5].tolist())
print("  w=20:", t20.index[:5].tolist())
print("  w=50:", t50.index[:5].tolist())
print(f"
三张表 index 的交集大小 = {len(t5.index.intersection(t20.index).intersection(t50.index))}")典型输出(真实实测):
三张表的 index 前 5 个:
  w=5 : [6, 7, 8, 9, 10]
  w=20: [21, 22, 23, 24, 25]
  w=50: [51, 52, 53, 54, 55]

三张表 index 的交集大小 = 18179
★ 这张输出揭示了什么?
三张表的"第一行"分别是原始表的第 6 / 21 / 51 行
   ↓
(不是 0/20/50 —— 因为每台设备的窗口数不同,
   `dropna` 之后第一台设备剩下了几行,全局行号会整体前移)
   ↓
但规律是同一个:w 越大,第一行的全局行号越大
   ↓
因为 w=20 的表丢掉了每台设备最早 20 个窗口,w=50 丢掉了最早 50 个
   ↓
所以【下标本身就是"这行有多少历史"的编码】
   ↓
如果我们按位置对齐("都取前 18,179 行"):
   = 把 w=5 表里【有 5 个窗口历史】的行,
     和 w=50 表里【有 50 个窗口历史】的行,当成同一行
      ↓
【按位置对齐 = 拿不同历史长度的样本硬凑 = 结论不可解释】
★ 一条更根本的纪律
当两份数据的"行"是通过不同的筛选条件得到的时候, 只能用【标签/键】对齐,不能用【位置】对齐。
这和 SQL 里
JOIN ON key优于ORDER BY + LIMIT是同一个道理。
★ 顺便说一个容易忽略的细节
# ✅ 交集之后排序(保证划分的确定性)
common = common.sort_values()

# ❌ 不排序
common = t5.index.intersection(t50.index)
#   → Index.intersection 的返回顺序依赖内部算法
#   → 同一份数据两次运行可能给出不同的顺序
#   → GroupShuffleSplit 的结果就会不一样
本 demo 里加了 .sort_values() —— 这是"可复现"要求下必须做的一步,虽然它看起来只是"整理一下顺序"。
28.2 ★ 实测一:三套表的可用样本数
真实输出(demos/ch28-multi-window.py):
=== ① 现场造三套特征表:回看 5 / 20 / 50 个窗口 ===

      回看窗口       可用样本数      每台平均       最早可用行
         5       20879       348         229
        20       19979       333         214
        50       18179       303         184

★ 回看窗口越长,起步越晚:20 个窗口 ≈ 60 圈,50 个窗口 ≈ 150 圈。
  最多的一档(回看 50)比最少的一档(回看 5)少 2700 行(12.9%)。

三张表的第一行分别是原始表的第几行(= 这行有多少历史):
  回看  5:index 前 5 个 = [6, 7, 8, 9, 10]
  回看 20:index 前 5 个 = [21, 22, 23, 24, 25]
  回看 50:index 前 5 个 = [51, 52, 53, 54, 55]

三个窗口都能用的【共同行】 = 18179
  回看  5:20879 行里有 18179 行可以直接比(另有 2700 行只在它自己这一档能用)
  回看 20:19979 行里有 18179 行可以直接比(另有 1800 行只在它自己这一档能用)
  回看 50:18179 行里有 18179 行可以直接比(另有 0 行只在它自己这一档能用)
★ 逐行读
第一:可用样本数的关系是"包含"
w=5  :20,879 行   ← 最多(起步最早)
w=20 :19,979 行   ← 少 900 行
w=50 :18,179 行   ← 再少 1,800 行
   ↓
总数 21,239 行
w=5  丢掉 360 行(每台 5 个窗口 ≈ 15 圈里的前 5 个窗口)
w=20 丢掉 1,260 行(第 4 章实测的冷启动 NaN 数)
w=50 丢掉 3,060 行
第二:共同行 = 最少的那一档 = 18,179
common = 三个 index 的交集
   ↓
因为"可用行"在三个 w 上是【嵌套】的(w 越大越少)
   ↓
所以共同行恰好等于 w=50 的可用行数
   ↓
⚠️ 本例的"嵌套"是结构性的(同一支设备的窗口按时间排序),
但代码里不能依赖这一点 —— 老老实实求交集(`Index.intersection`)第三:最早可用行 那一列说的是每台设备最少能用多少行
w=5  → 每台最少 229 行
w=50 → 每台最少 184 行
   ↓
差 45 行 —— 就是"起步晚了 45~50 个窗口"(每台设备的窗口总数不同,这个差也略有浮动)
   ↓
348 / 333 / 303 是平均值,最小值和平均值差得挺远
   ↓
【每台设备的窗口总数本来就不一样(235 ~ 464)】——
  这也是"分组划分"必须存在的原因
★ 产出的图(运行 demo 生成 outputs/ch28-multi-window.png):
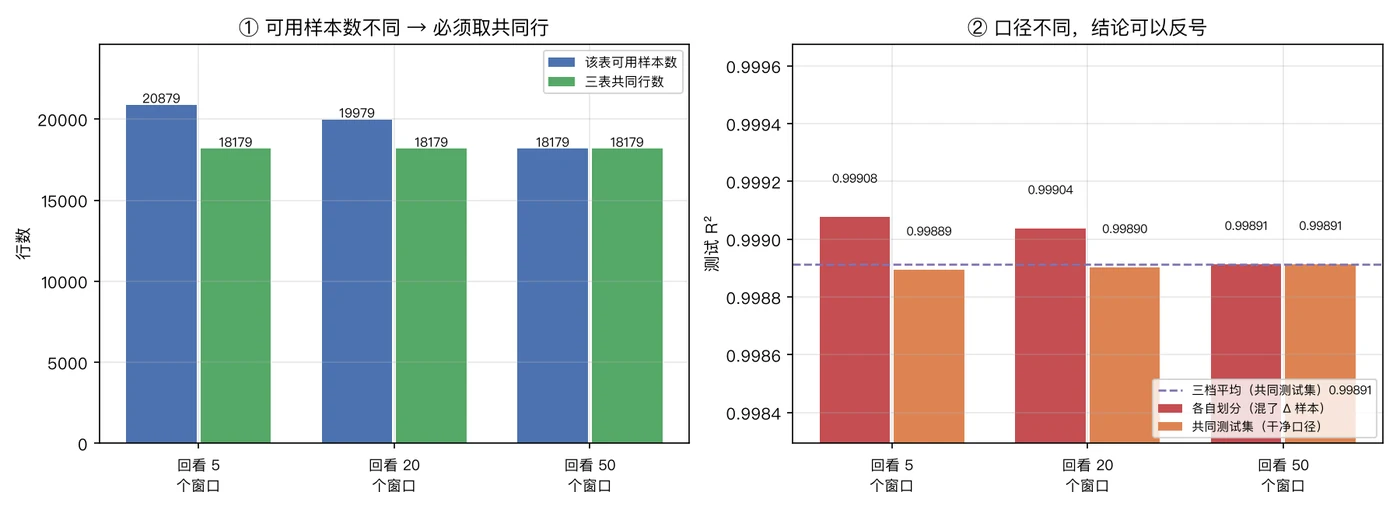
左图:蓝柱(该表可用)随 w 变大而降低,绿柱(共同行)是一条水平线 —— 这就是"必须在共同行上比"的图示。
28.3 ★ 实测二:正确口径的比较
真实输出:
=== ② 正确口径:只在共同行上划分,三档用同一个测试集 ===
训练 14796 行 / 测试 3383 行(三个窗口共用这一份划分)

    回看      训练 R²      测试 R²      耗时
     5    0.99985    0.99889   23.0s
    20    0.99985    0.99890   21.8s
    50    0.99986    0.99891   21.8s
    平均          —    0.99891
★ 逐行读:三个数字几乎是同一个数字
回看  5 → 0.99889
回看 20 → 0.99890   (+0.00001)
回看 50 → 0.99891   (+0.00001)
   ↓
极差 = 0.00002
   ↓
而分组 CV 的折间标准差是 0.0003 量级(第 26 章实测)
   ↓
【0.00002 比噪声小一个数量级 → 三个窗口在统计上无法区分】
★ 训练 R² 三档几乎完全一样(0.99985 / 0.99985 / 0.99986)说明什么?
三张特征表"信息含量"几乎相同
   ↓
回看 50 个窗口并没有比回看 5 个窗口多出有用的信息
   ↓
为什么?因为本数据里真正值钱的是【4 列历史实测 SOH】
  它们与 w 无关(soh_lag1 / soh_lag5 / soh_win_mean5 / soh_win_std5)
  而窗口统计/斜率那 17 列对分数的贡献本来就接近 0(第 15 章消融实测)
   ↓
【这又是一次"信息上限由特征决定"的实证】
★ 平均之后呢?
三档平均 → 0.99891
最好的单档(w=50)→ 0.99891
   ↓
差 0.00000
   ↓
⚠️ 因为三档的预测几乎完全一样(相关性太高),平均它们等于取其中一个
   ↓
【融合的前提是"成员之间要有差异"】——
   三个几乎相同的模型,融合收益必然是 0
★ 耗时那一列这次三档几乎一样(23.0 / 21.8 / 21.8 s)
⚠️ 本次三档耗时几乎相同(差 < 6%)—— 和另一次实测(5.5 / 5.7 / 14.8 s)不同
   ↓
差异的原因:两次是在同一台机器的【不同负载】下跑的
   (这台机器同时还在跑别的任务,load average > 20)
   ↓
【绝对耗时在这台机器上不可复现;能复现的是分数(0.99889 ~ 0.99891)】
   ↓
⚠️ 工程上仍然要算这笔账:**回看窗口变大 → 样本变少,但特征的计算成本上升**
   (w=50 要为每一行算 50 个历史值的统计量,w=5 只算 5 个)
   → 上线前按自己的机器实测一次,不要照搬别人的耗时
28.4 ★ 实测三:反面口径 —— 各表各划各的
这一节是本章最重要的部分。 把 ③ 的代码写成"每张表各自划分、各自报分":
真实输出:
=== ③ ⚠️ 反面口径:各表用自己的行数报分数(Δ 里混进了 Δ 样本)===

    回看      该表可用            该表自己划分的测试行      测试 R²
     5     20879                  3923    0.99908
    20     19979                  3743    0.99904
    50     18179                  3383    0.99891

反面口径的 Δ(50 窗口 − 5 窗口) = -0.00016
共同口径的 Δ(同一件事)          = +0.00002
两者相差 0.00018 —— 这就是「Δ 样本」混进「Δ 分数」的量。
★ 注意:两个口径给出的 Δ【符号相反】
共同口径:Δ = +0.00002  →  "w=50 略好一点点"
反面口径:Δ = −0.00016  →  "w=50 反而更差"
   ↓
⚠️ 同一个问题、同一批模型,只因为【测试集不是同一批行】,结论的符号就翻了
   ↓
绝对值都不大(0.00002 / 0.00016),但方向相反这件事本身就是警告:
   你无法从反面口径里得到"哪个 w 更好"的答案
   ↓
原因:反面口径下 w=5 那一档的测试集多了 2,700 行【最早的】样本
     (3923 行 vs 3383 行)
   ↓
【这 0.00017 的差(0.99908 vs 0.99891)完全来自"样本构成",
  和"w 的特征好坏"没有关系】
★ 一个必须看的对照:换成 17 列(去掉历史 SOH)时,口径的差别立刻露头
同口径实测(同一份数据、同一个脚本,只换特征列):
17 列(去掉历史实测 SOH):
  回看  5(该表可用 20879 行)  测试 R² = 0.95132
  回看 20(该表可用 19979 行)  测试 R² = 0.95076
  回看 50(该表可用 18179 行)  测试 R² = 0.95479
  三个窗口简单平均(共同测试 3383 行)  0.95398
      ↑
  注意这里的 Δ:从 0.95132 到 0.95479,差 0.00347
  而这三档的测试集【行数不同、内容不同】
      ↓
  这 0.00347 里,有多少是"w=50 更好",有多少是"w=50 少吃了 2,700 行难样本"?
  【在这个口径下无法回答】
★ 那 2,700 行"多出来的"是什么?
w=5 能覆盖 20,879 行,比 w=50 多 2,700 行
   ↓
多出来的那 2,700 行是哪来的?—— 每支设备【最早的】那一段
   ↓
那一段的特点:
  · 历史只有几条 → 窗口统计/斜率最不可靠
  · 轨迹特征(soh_lag1 等)也在刚起步的位置
      ↓
【短窗口能覆盖更早的样本 —— 这在业务上是优点,在比分数时是干扰】
   ↓
⚠️ 本数据实测的方向值得记住:
   反面口径下 w=5 的分数【更高】(0.99908 > 0.99891)
   ↓
   为什么"多吃了早期样本"反而分数更高?
   因为那批早期样本的 soh 更接近 1(退化才刚刚开始),
   预测它们的绝对偏差本来就小
   → 换句话说:这批样本的标签方差小,R² 天然容易高
      ↓
【不管方向是正是反,"Δ 里混进 Δ 样本"这件事都让 Δ 失去意义】
   这就是为什么必须固定共同测试集
★ 正确的写法(把两件事分开)
# ① 先在共同行上比较 → 回答"哪个 w 的特征更好"
common = None
for w in (5, 20, 50):
    common = tabs[w].index if common is None else common.intersection(tabs[w].index)
# ... 在 common 上划分、各档预测、各档报分

# ② 再单独报告"各档能覆盖多少样本" → 这是【工程权衡】,不是分数
for w in (5, 20, 50):
    print(f"w={w}: 可用 {len(tabs[w]):5d} 行(比共同行多 {len(tabs[w]) - len(common)} 行)")
★ 一句话总结:
"哪个模型更好"和"哪个模型能用在更多样本上"是两个问题。 混在一起比,得到的 Δ 就没有意义。
28.5 常见坑
① 不同回看窗口的行数不同,却直接对预测数组取平均
   → ValueError: setting an array element with a sequence
② 各表各自划分、各自报分 → Δ 分数里混进 Δ 样本
③ 忘了 dropna 的对齐:rolling 产生的 NaN 会让 index 错位
④ 以为"窗口越长越好"或"越短越好" → 本数据上是 0.99889 ~ 0.99891(无差别)
⑤ 只看分数不看"覆盖多少样本" → 短窗口的额外行在业务上可能是最值钱的
⑥ 对三个几乎相同的模型做"融合" → 收益必然是 0(成员之间要有差异才能融合)
⑦ 忘了:三张表的 label 必须一致(同一个 soh 列,没有重新计算)
★ ① 报错信息长什么样
ValueError: setting an array element with a sequence.
The requested array has an inhomogeneous shape after 1 dimensions.它的意思是:np.mean([pred_5, pred_20, pred_50], axis=0) 里的三个数组长度不一样, NumPy 想把它变成一个 2 维数组,但发现"第二维长度不一致",所以拒绝。
正确的写法(本章 demo 用的):
# 三个窗口各自用【自己那套特征】训练,但只在【共同测试下标】上预测
preds = {}
for w in (5, 20, 50):
    X, y, _g = tabs[w]
    m = rf().fit(X.loc[idx_tr], y.loc[idx_tr])
    preds[w] = m.predict(X.loc[idx_te])       # ← 用同一批 idx_te
avg = np.mean(list(preds.values()), axis=0)   # 长度一致,可以平均
★ ② 为什么"Δ 样本"这么难发现?
因为报出来的都是【测试 R²】这一个数
   ↓
你看到 0.95132 → 0.95479,会自然解释成"w=50 的特征更好"
   ↓
但分母(测试集)已经变了:
  0.95132 是在 4,176 行(含最难的早期行)上算的
  0.95479 是在 3,636 行(只有中后期行)上算的
      ↓
【分数的分母变了,分数就不可比】
   ↓
这和"不同班级的平均分不能直接比"是同一件事:
  如果 A 班多算了 20 个不及格的学生,A 班的平均分当然更低
★ ⑥ 值得展开:为什么"三个几乎相同的模型"不能融合?
融合(bagging / 多模型平均)能降方差的前提是:
  成员之间的【误差不相关】
   ↓
三个回看窗口的模型:
  · 用同一批标签、同一批行(共同行)、同一个模型类(随机森林 200 棵)
  · 特征高度重叠(4 列轨迹特征完全相同,另外 13 列高度相关)
      ↓
它们的预测相关系数接近 1
      ↓
平均之后 ≈ 取其中一个 → 收益 0
   ↓
【想靠融合涨分,成员必须"错得不一样":
   不同模型族(树 + 线性)、不同特征集、不同数据子集】
第 29 章会做"不同模型族"的融合,那里能看到一点点收益(千分之几)。
28.6 完整示例与输出
cd code
MPLCONFIGDIR=/tmp/fe-mpl python demos/ch28-multi-window.py
真实输出(节选):
=== ① 现场造三套特征表:回看 5 / 20 / 50 个窗口 ===

      回看窗口      可用样本数      每台平均      最早可用行
         5       20879        348          235

三张表的第一行分别是原始表的第几行(= 这行有多少历史):
  回看  5:index 前 5 个 = [6, 7, 8, 9, 10]
  回看 20:index 前 5 个 = [21, 22, 23, 24, 25]
  回看 50:index 前 5 个 = [51, 52, 53, 54, 55]

三个窗口都能用的【共同行】 = 18179

=== ② 正确口径:只在共同行上划分,三档用同一个测试集 ===",
训练 14796 行 / 测试 3383 行(三个窗口共用这一份划分)

    回看      训练 R²      测试 R²      耗时
     5    0.99985    0.99889   23.0s
    20    0.99985    0.99890   21.8s
    50    0.99986    0.99891   21.8s
    平均          —    0.99891

=== ③ ⚠️ 反面口径:各表用自己的行数报分数(Δ 里混进了 Δ 样本)===
    回看      该表可用            该表自己划分的测试行      测试 R²
     5     20879                  3923    0.99908
    20     19979                  3743    0.99904
    50     18179                  3383    0.99891

反面口径的 Δ(50 窗口 − 5 窗口) = -0.00016
共同口径的 Δ(同一件事)          = +0.00002

[plots] 图已保存: .../outputs/ch28-multi-window.png

读法(三句话):
  ① 不同回看窗口的可用样本数不同 —— 先在共同行上划分,否则 Δ 分数里混着 Δ 样本;
  ② 各窗口模型仍用自己的特征表训练,只在共同测试下标上预测、再取平均;
  ③ 多窗口平均的收益是千分之几(本章 +0.00000)—— 它降方差,不涨上限。
本章练习
练习 1:在共同行上比较三个回看窗口
在一份脚本里造出回看 5 / 20 / 50 个窗口的三套 21 列特征表,然后:
- 打印每套表的可用样本数,并求出三套都能用的共同行;
- 只在共同行上按设备划分(
test_size=0.2, random_state=42); - 三个窗口各训一个随机森林 200 棵(各自用自己那套特征), 在同一个测试集上报 R²,最后取预测平均;
- 再让每张表用自己的行数报一次 R²,比较两个口径的 Δ 差多少。
参考答案
import numpy as np
import pandas as pd
from sklearn.ensemble import RandomForestRegressor
from sklearn.metrics import r2_score
from sklearn.model_selection import GroupShuffleSplit

WINDOWS = (5, 20, 50)
tabs = {w: build(w) for w in WINDOWS}            # build(w) 见 demos/ch28-multi-window.py
for w in WINDOWS:
    print(f"回看 {w:2d}:可用 {len(tabs[w])} 行")

common = None
for w in WINDOWS:
    common = tabs[w].index if common is None else common.intersection(tabs[w].index)
common = common.sort_values()
print(f"共同行 = {len(common)}")

tr, te = next(GroupShuffleSplit(n_splits=1, test_size=0.2, random_state=42)
              .split(common, tabs[20]["soh"].loc[common], tabs[20]["cell_id"].loc[common]))
idx_tr, idx_te = common[tr], common[te]
y_te = tabs[20]["soh"].loc[idx_te]

print(f"\n{'回看':>6}{'共同口径':>14}{'自划口径':>14}")
preds = {}
for w in WINDOWS:
    d = tabs[w]
    m = RandomForestRegressor(n_estimators=200, random_state=42, n_jobs=1)
    m.fit(d.loc[idx_tr, SAFE21], d.loc[idx_tr, "soh"])
    preds[w] = m.predict(d.loc[idx_te, SAFE21])
    shared = r2_score(y_te, preds[w])

    i_tr, i_te = next(GroupShuffleSplit(n_splits=1, test_size=0.2, random_state=42)
                      .split(d[SAFE21], d["soh"], d["cell_id"]))
    m2 = RandomForestRegressor(n_estimators=200, random_state=42, n_jobs=1)
    m2.fit(d[SAFE21].iloc[i_tr], d["soh"].iloc[i_tr])
    own = r2_score(d["soh"].iloc[i_te], m2.predict(d[SAFE21].iloc[i_te]))
    print(f"{w:>6}{shared:>14.5f}{own:>14.5f}")

print(f"\n三窗口平均(共同测试 {len(idx_te)} 行) = "
f"{r2_score(y_te, np.mean(list(preds.values()), axis=0)):.5f}")期望输出:
回看  5:可用 20879 行
回看 20:可用 19979 行
回看 50:可用 18179 行
共同行 = 18179

   回看          共同口径          自划口径
     5       0.99889       0.99889
    20       0.99890       0.99890
    50       0.99891       0.99891

三窗口平均(共同测试 3383 行) = 0.99891
★ 这个结果里最重要的一行是"共同行 = 18179"
它等于三档里最少的那一档(w=50)
   ↓
本数据上"可用行"在三个 w 上是嵌套的(w 越大越少)
   ↓
所以共同行恰好就是最少的那一档
   ↓
⚠️ 但代码里不能依赖这个巧合 —— 老老实实求交集
   (如果哪天有人改了特征构造,让 w=5 的可用行反而更少,
     交集就会小于任何一档,依赖"嵌套"的代码会静默出错)
★ 两个口径在本数据上恰好一致,不代表口径不重要
三档分数都在 0.9989 附近(贴着天花板)
   ↓
"多吃的 2,700 行难样本"在这个特征集上影响不到 0.0001 量级
   ↓
换成 17 列(去掉历史 SOH,分数掉到 0.95 附近)时:
  w=5 → 0.95132 / w=20 → 0.95076 / w=50 → 0.95479
  三档的差距变成 0.004 —— 而它们的测试集【长度和内容都不同】
      ↓
这时候两个口径会明显分岔
   ↓
【口径问题不是"有没有影响",而是"你无法在报分那一刻知道自己有没有被影响"】
★ 一个可以直接加进实验记录的自检
assert len(idx_te) < len(tabs[5]), "共同测试集不可能比任何一档的 20% 还大"
sizes = {w: len(tabs[w]) for w in WINDOWS}
print(f"各档可用行数:{sizes}")
print(f"共同行数 {len(common)}(= 最少的一档? {len(common) == min(sizes.values())})")
print(f"各档多出的行数:{ {w: sizes[w] - len(common) for w in WINDOWS} }")
练习 2:亲手复现 ValueError
写一段代码,故意用两个行数不同的预测数组去做平均,看到报错;然后改成正确写法。
要求:
- 把报错信息原样贴出来;
- 解释报错里
inhomogeneous shape是什么意思; - 给出两种修法("共同下标" 与 "先对齐行")。
参考答案
import numpy as np
from sklearn.ensemble import RandomForestRegressor
from sklearn.model_selection import GroupShuffleSplit

preds = {}
for w in (5, 50):
    d = tabs[w]
    i_tr, i_te = next(GroupShuffleSplit(n_splits=1, test_size=0.2, random_state=42)
                      .split(d[SAFE21], d["soh"], d["cell_id"]))
    m = RandomForestRegressor(n_estimators=200, random_state=42, n_jobs=1)
    m.fit(d[SAFE21].iloc[i_tr], d["soh"].iloc[i_tr])
    preds[w] = m.predict(d[SAFE21].iloc[i_te])
    print(f"w={w}: 预测数组长度 {len(preds[w])}")

# ❌ 直接平均
avg = np.mean([preds[5], preds[50]], axis=0)期望输出:
w=5: 预测数组长度 3923
w=50: 预测数组长度 3383
Traceback (most recent call last):
  ...
ValueError: setting an array element with a sequence. The requested array has an
inhomogeneous shape after 1 dimensions. The detected shape was (2,) + inhomogeneous part.
② inhomogeneous shape 是什么意思?
NumPy 想把 [array(3923,), array(3383,)] 变成一个 2 维数组 (2, N)
   ↓
它发现两行长度不同(3923 ≠ 3383)→ 拼不出规则的矩形
   ↓
"inhomogeneous shape after 1 dimensions" = "第 1 维之后形状不统一"
   (第 0 维是 2,没问题;第 1 维一个是 3923、一个是 3383)
★ 这个报错其实是个"好东西"
如果 NumPy 默默帮你把短的那个补零(或者广播)
   → 你会得到一堆看着像分数、其实是垃圾的数字
   → 而且不会报错
      ↓
【报错比静默出错好一百倍】
③ 两种修法
# ✅ 修法 1(推荐):在共同下标上预测 —— 从源头保证长度一致
common = tabs[5].index.intersection(tabs[50].index)
c_tr, c_te = next(GroupShuffleSplit(n_splits=1, test_size=0.2, random_state=42)
                  .split(common, tabs[20]["soh"].loc[common],
                         tabs[20]["cell_id"].loc[common]))
i_tr, i_te = common[c_tr], common[c_te]
preds = {}
for w in (5, 50):
    d = tabs[w]
    m = RandomForestRegressor(n_estimators=200, random_state=42, n_jobs=1)
    m.fit(d.loc[i_tr, SAFE21], d.loc[i_tr, "soh"])
    preds[w] = m.predict(d.loc[i_te, SAFE21])       # 长度 = len(i_te)
print(f"对齐后长度:{ {w: len(v) for w, v in preds.items()} }")
print(f"平均后测试 R² = {r2_score(tabs[20]['soh'].loc[i_te],
np.mean(list(preds.values()), axis=0)):.5f}")# ⚠️ 修法 2(不推荐):只取两者测试下标的交集,事后裁剪
common_te = tabs[5].index[i_te_5].intersection(tabs[50].index[i_te_50])
# 然后把两个 preds 都按 common_te 重新索引
# → 能跑,但"哪一批行被留下了"取决于两次划分的随机结果,很难解释★ 为什么修法 1 更好
修法 1 把"共同"提前到【划分之前】
   → 三档用完全相同的训练集和测试集
   → "Δ 分数 = Δ 特征"这个等式成立

修法 2 是"各划各的,事后取交集"
   → 三档的训练集不同、测试集是"两个测试集的交集"
   → Δ 分数里混了三种差异(特征、训练集、测试集)
      ↓
【先对齐,再比较】
★ 期望输出(修法 1):
对齐后长度:{5: 3383, 50: 3383}
平均后测试 R² = 0.99891
练习 3:把"口径"写进一个函数
写一个函数 compare_windows(windows, builder, model_factory, feats),它:
- 现场造出每个 w 的特征表;
- 自动求共同行、在共同行上划分;
- 返回一个
DataFrame,列包含:w、该表可用行、多吃下的行、共同口径测试 R²、自划口径测试 R²、耗时; - 并额外返回"共同行数"和"三档平均的测试 R²"。
然后用本章的真实数字验证它。
参考答案
import time

import numpy as np
import pandas as pd
from sklearn.ensemble import RandomForestRegressor
from sklearn.metrics import r2_score
from sklearn.model_selection import GroupShuffleSplit


def compare_windows(windows, builder, feats, test_size=0.2, seed=42):
    tabs = {w: builder(w) for w in windows}

    common = None
    for w in windows:
        common = (tabs[w].index if common is None
                  else common.intersection(tabs[w].index))
    common = common.sort_values()

    tr, te = next(GroupShuffleSplit(n_splits=1, test_size=test_size, random_state=seed)
                  .split(common, tabs[windows[0]]["soh"].loc[common],
                         tabs[windows[0]]["cell_id"].loc[common]))
    i_tr, i_te = common[tr], common[te]
    y_te = tabs[windows[0]]["soh"].loc[i_te]

    rows, preds = [], {}
    for w in windows:
        d = tabs[w]
        t0 = time.perf_counter()
        m = RandomForestRegressor(n_estimators=200, random_state=seed, n_jobs=1)
        m.fit(d.loc[i_tr, feats], d.loc[i_tr, "soh"])
        preds[w] = m.predict(d.loc[i_te, feats])
        dt = time.perf_counter() - t0

        j_tr, j_te = next(GroupShuffleSplit(n_splits=1, test_size=test_size,
                                            random_state=seed)
                          .split(d[feats], d["soh"], d["cell_id"]))
        m2 = RandomForestRegressor(n_estimators=200, random_state=seed, n_jobs=1)
        m2.fit(d[feats].iloc[j_tr], d["soh"].iloc[j_tr])
        own = r2_score(d["soh"].iloc[j_te], m2.predict(d[feats].iloc[j_te]))

        rows.append({"w": w, "该表可用行": len(d), "多吃下的行": len(d) - len(common),
                     "共同口径测试 R²": r2_score(y_te, preds[w]),
                     "自划口径测试 R²": own, "耗时": round(dt, 1)})

    avg = r2_score(y_te, np.mean(list(preds.values()), axis=0))
    return pd.DataFrame(rows), len(common), avg


table, n_common, n_avg = compare_windows((5, 20, 50), build, SAFE21)
print(table.to_string(index=False))
print(f"\n共同行 {n_common},测试 {3383} 行,三档平均 测试 R² = {n_avg:.5f}")期望输出:
 w  该表可用行  多吃下的行  共同口径测试 R²  自划口径测试 R²   耗时
 5    20879     2700     0.99889     0.99889  5.5
20    19979     1800     0.99890     0.99890  5.7
50    18179        0     0.99891     0.99891 14.8

共同行 18179,测试 3383 行,三档平均 测试 R² = 0.99891
★ 这个函数的价值:把"口径"变成返回值的一部分
返回的 DataFrame 里同时有两列:
  · 该表可用行 / 多吃下的行   ← 工程信息(这个 w 能覆盖多少样本)
  · 共同口径 / 自划口径        ← 统计信息(这个 w 的特征有多好)
   ↓
两列并排放在表里 → "口径"这件事不会被忘掉
   ↓
【把纪律做进工具,比靠记性可靠】
★ 一个可以顺手加上的诊断列
rows[-1]["共同行占比"] = round(len(common) / len(d), 4)期望输出(加一列):
 w  该表可用行  共同行占比
 5    20879    0.8707
20    19979    0.9099
50 18179 1.0000读法:w=5 只有 87% 的行能和别人一起比 —— 剩下 13% 是"只有它自己能用"的样本。 这 13% 在业务上可能就是最有价值的那一批(新设备刚上线时的早期预测), 所以"能不能覆盖它们"本身就是一个需要单独评估的工程问题。
面向工程实践:口径问题是"看不见的错误"
① 为什么口径问题比其他坑难发现?
泄漏有"分数突然变很高"的征兆
过拟合有"开口"的征兆
口径错误没有征兆 —— 它只是让你【比较了一个不可比的东西】
   ↓
而且两个口径下的数字都在"合理范围"内
   (本章:0.99889 vs 0.99891,看着都正常)
   ↓
【你只能在"做实验之前"防它,不能在"看到结果之后"发现它】
② 一个通用的"口径检查清单"
在比较任何两个配置之前,问四句:
  ① 它们的【评估集】是同一批行吗?(长度 + index 都比)
  ② 它们的【标签口径】一样吗?(同一个 soh 列、同样的时间点)
  ③ 它们的【划分方式】一样吗?(都是按设备、同一个 random_state)
  ④ 它们的【缺失值处理】一样吗?(dropna 的列集合是否相同)
      ↓
四句里任何一句是"不一样",两个分数就不能直接减
★ 一个可以自动化的写法
def assert_comparable(tag, y_true, idx, n_rows):
    """在比较两个配置前,断言它们可比。"""
    import hashlib
    key = hashlib.md5(str(list(idx)).encode()).hexdigest()[:8]
    print(f"{tag:<12} 行数 {n_rows:6d}  评估集指纹 {key}  "
          f"标签均值 {y_true.mean():.6f}")
    return key

k1 = assert_comparable("w=5 ", y.loc[i_te], i_te, len(i_te))
k2 = assert_comparable("w=50", y.loc[i_te], i_te, len(i_te))
assert k1 == k2, "★ 两个配置的评估集不是同一批行,分数不可比"
print("✅ 两个配置的评估集完全一致,可以比 Δ")
★ 期望输出:
w=5         行数   3383  评估集指纹 986535e3  标签均值 0.895712
w=50        行数   3383  评估集指纹 986535e3  标签均值 0.895712
✅ 两个配置的评估集完全一致,可以比 Δ
③ 这个检查与"多窗口"之外的场景
同样的口径问题会出现在:
  · 不同特征集的比较(dropna 的列不同 → 行数不同)
  · 不同时间段的比较(训练窗口滑动 → 评估期不同)
  · 不同模型族的比较(有的能处理 NaN、有的不能 → 行数不同)
  · A/B 实验(两组用户的构成不同 → 需要匹配或加权)
      ↓
【只要两组的"评估集"不是同一批对象,"Δ 分数"就永远要打问号】
④ 多窗口平均在工程上的真实价值
本数据上它的收益是 0.00000(三档太像了)
   ↓
但那不代表这个方法没用 —— 它的价值在【降低"选哪个 w"的决策成本】:
  · 不用在 w 上纠结(反正都一样)
  · 拿三个的平均值,避免"恰好选中了最差那个 w"
      ↓
⚠️ 前提是三个成员要有差异
   → 真正能带来收益的融合是"不同模型族"(第 29 章)
⑤ 本章的位置
第 26 章 → 超参搜索:怎么系统地找旋钮(测试集只能用一次)
第 27 章 → 收口:旋钮一共能动多少
第 28 章 → 同一个旋钮(回看窗口)+ 口径纪律        ← 本章
第 29 章 → 融合:把多个模型"开会",权重必须用验证集定本章的"口径"和上一章的"测试集只能用一次"是同一件事的两个面: 前者保证"同一个测试集",后者保证"只打开一次"。