第 09 章 · 滚动统计与极差:从"多高"到"多稳"
这一章要解决什么:第 05 章造了均值,第 08 章造了变化量。 但现场工程师最常问的第三个问题是: "最坏到什么程度?" —— 那就是极差(窗口内最大值 − 最小值)。
最容易踩的坑: ① 把极差和标准差当成同一件事 —— 它们量的时间尺度不同(窗口之间 vs 窗口之内); ② 把"现场判读"当成"数据事实" —— 本章会实测这句话在这份数据上不成立; ③ 看到极差特别大的行就当异常值删掉 —— 它可能正是你要预测的对象。
本章你需要完成的代码:demos/ch09-rolling-summary.py
9.1 一句话:极差 = 最坏情况
先看清三个统计量在回答三个不同的问题:
| 统计量 | 问题 | 现场话术 |
|---|---|---|
mean | 最近平均偏热还是偏冷? | "这批设备最近温度偏高" |
std | 最近平均抖动有多大? | "温度一直在小幅波动" |
range(极差) | 最近最坏到什么程度? | "上周有一天散热明显不对" |
★ 为什么极差不能被标准差替代 —— 一个思想实验:
A 设备:20 个窗口的温升 = [10.0, 10.1, 10.0, 10.1, ...]      极差 0.1
B 设备:20 个窗口的温升 = [10.0, 10.0, ..., 10.0, 13.4]      极差 3.4

A 的 std ≈ 0.05      B 的 std ≈ 0.73
两个标准差都不是"灾难级"的数字,但 B 设备那一天确实出过问题。
★ 极差和标准差的根本区别:
| 标准差 | 极差 | |
|---|---|---|
| 关心 | 全部样本的偏离 | 只有两个样本(最大、最小) |
| 对单个异常 | 被平均稀释 | 直接反映 |
| 稳定性 | 高(不易被一个点影响) | 低(一个点就能拉高) |
| 用途 | "整体稳不稳" | "有没有出过事" |
★ 一句话:
标准差回答"平均而言稳不稳"; 极差回答"最坏的那一次有多坏"。
制造业现场关心后者 —— 因为事故是按"最坏"记的,不是按"平均"记的。
9.2 temp_win_range20 的分布
真实输出:
=== ① temp_win_range20 的分布(过去 20 个窗口内温升的极差)===
count    20039.0000
mean         1.7895
std          0.3560
min          0.7322
25%          1.5399
50%          1.7623
75%          2.0218
max          3.4476
  缺失 1,200 行 —— 每支设备最前面 20 个窗口还没有足够的历史。
  50% 分位:1.7623
  90% 分位:2.2572
  99% 分位:2.6959
  极差 = 窗口内温升的【最大值 − 最小值】,单位 ℃。
  它和均值在看两件不同的事:均值说「最近偏热」,极差说「最近不稳」。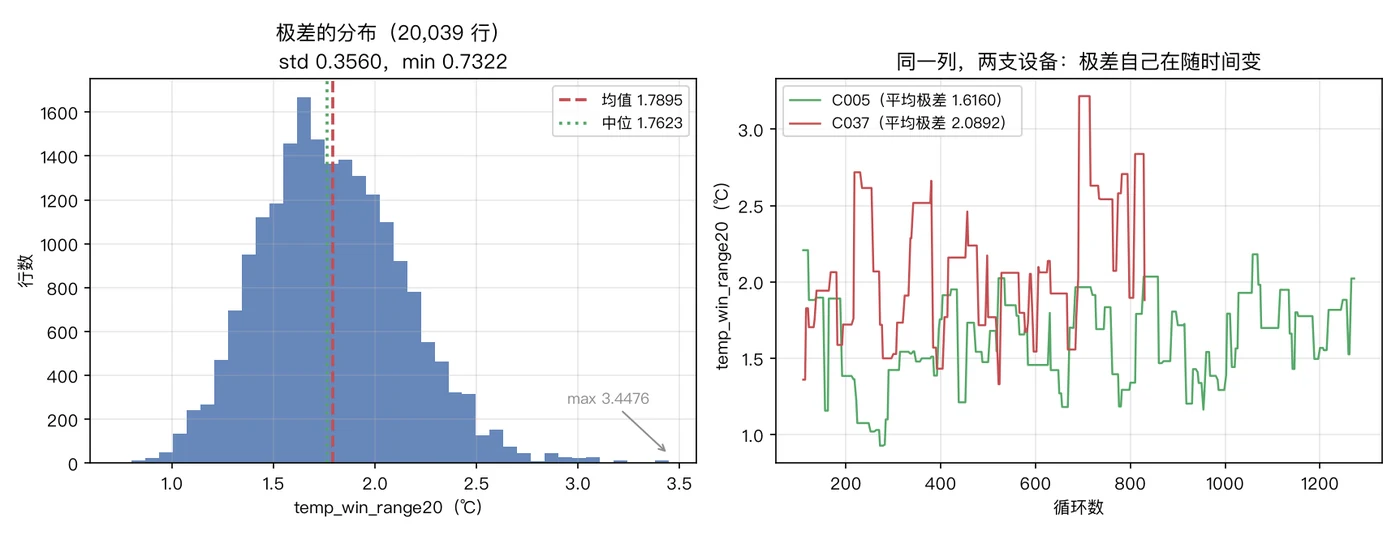
★ 怎么读这组数字:
mean 1.7895  → 平均而言,最近 20 个窗口里温升的落差约 1.79 ℃
std  0.3560  → 设备之间、时间之间差 0.36 ℃(不算大)
min  0.7322  → 最"平"的一台:20 个窗口内只差 0.73 ℃
max 3.4476 → 最"猛"的一次:20 个窗口内差了 3.45 ℃关键看两头:
| 分位 | 值 | 含义 |
|---|---|---|
| 50% | 1.7623 | 一半的行在 1.76 以下 |
| 90% | 2.2572 | 每 10 行里有 1 行超过 2.26 |
| 99% | 2.6959 | 每 100 行里有 1 行超过 2.70 |
★ 这里有一个"现场怎么用"的直接答案:
极差 > 2.70 ℃(99% 分位)→ 值得看一眼
极差 > 3.00 ℃(约 99.9%)→ 现场大概率会打电话
⚠️ 但请注意:这些阈值是这份数据算出来的。 换一份数据、换一个设备型号,阈值完全不同。 所以"阈值"这件事必须写进特征账本(第 16 章),不能在脑子里存着。
9.3 从头复算一遍:shift(1).rolling(20) 的 max − min
这一节的目的是让你相信:表里那一列确实就是"过去 20 个窗口的极差", 而不是别的什么东西。
真实输出:
=== ② 从头复算一遍:`shift(1).rolling(20)` 的 max − min ===
  参与核对的行数:20,039
  与表里那一列的最大绝对差:3.109e-15
  相关系数:1.000000
  → 完全一致。表里那一列就是这么算出来的:先 shift(1) 把当前窗口推出去,
     再取过去 20 个窗口的 max 与 min 相减。
  手算核对最大极差那一行(C050 / cycle=930):
    过去 20 个窗口温升:max 10.9026 − min 7.4550 = 3.4476(表里 3.4476)
★ 三行代码就是这一列的完整定义:
g = base.groupby("cell_id")["mean_temp_rise_c"]
rec = g.transform(lambda s: s.shift(1).rolling(20).max()) \
- g.transform(lambda s: s.shift(1).rolling(20).min())三个细节都不能少:
| 细节 | 少了会怎样 |
|---|---|
groupby("cell_id") | 跨设备串线(第 06 章) |
shift(1) | 极差里混进当前窗口 → 用到当前信息(第 10 章) |
rolling(20) | 变成"全历史极差",越到后期越大(单调上升的假趋势) |
★ 最后一条特别值得说 —— "全历史极差"为什么会骗人:
如果写成 s.expanding().max() - s.expanding().min()
   ↓
这个值只会【单调不减】
   ↓
它和 cycle 的相关性会非常高(因为 cycle 也在增加)
   ↓
模型会以为"极差能预测年龄" —— 其实它只是"活得久"的同义词
⚠️ 这是一个很隐蔽的陷阱:expanding() 的极差看起来很像"设备的某种属性", 实际上是**"这台设备已经运行了多少圈"的单调函数** —— 一个伪装成特征的时间变量。
★ 手算核对最大极差那一行:
C050 / cycle=930 的过去 20 个窗口温升:
   max = 10.9026
   min =  7.4550
   极差 = 3.4476   ← 与表里完全一致
"与表里完全一致"这五个字,是这一节唯一要交付的东西。
9.4 极差 vs 标准差:两个时间尺度
真实输出:
=== ③ 极差 vs 标准差:两种「波动」不是一回事 ===
  corr(temp_win_range20, temp_win_mean)  = +0.0544
  corr(temp_win_range20, temp_std_c)     = +0.1552
  corr(temp_win_range20, res_win_std)    = +0.0735
  corr(temp_win_range20, volt_win_std)   = +0.0446
  → 它们几乎不相关:极差量的是「窗口之间」的漂移(慢),
     temp_std_c 量的是「窗口之内」逐圈的抖动(快)—— 两个时间尺度。
     需要哪一个,取决于你要回答的问题:
       问「这台设备最近一个月稳不稳」→ 极差
       问「这一个循环里温度抖不抖」 → 窗口内标准差
★ 这四个相关系数说明的是一件容易被忽略的事:
极差和"窗口内标准差"的相关系数 = +0.155
                ↓
如果它们量的是同一件事,这个数应该接近 1
                ↓
0.155 说明:它们量的是两件几乎无关的事
★ 为什么"时间尺度"不同:
mean_temp_rise_c(窗口级,每 100 圈一个值)
   ↓ 在这个序列上滚动
temp_win_range20 = 最近 20 个【窗口级值】的极差
   → 覆盖约 60 圈,衡量的是"窗口之间的漂移"

temp_std_c(窗口内,逐圈的温升标准差)
   → 覆盖 100 圈内部的抖动,衡量的是"窗口之内的抖动"
★ 一张图记住区别:
| 覆盖的时间 | 看的东西 | 变化速度 | |
|---|---|---|---|
temp_std_c | 窗口内部(100 圈) | 逐圈抖动 | 快 |
temp_win_range20 | 窗口之间(20 个窗口 ≈ 60 圈) | 窗口水平的漂移 | 慢 |
⚠️ 注意"窗口之间 ≈ 60 圈"和"窗口内部 = 100 圈"这两个数字是交叉的:
temp_win_range20 覆盖 60 圈(但只看到 20 个"平均后的点")
temp_std_c 覆盖 100 圈(看到 100 个"原始点")
             ↓
所以它们不只是尺度不同,【采样密度】也不同
★ 结论:
两个列都留着,不是冗余。 一个抓"慢漂移",一个抓"快抖动"。
这也解释了第 5.5 节那句话:不是所有特征都是为了涨分 —— 有些是为了让"哪里不稳"这句话说得具体。
点开:如果只允许留一个,留哪个?
先看一个判据表:
| 你的问题 | 该留 |
|---|---|
| "这台设备最近是不是散热变差了"(慢,天/周级) | 极差 |
| "这次循环的温度曲线是不是不干净"(快,秒/分级) | 窗口内标准差 |
| "我要预测 SOH" | 两个都不关键(第 15 章:删掉窗口组 Δ R² ≈ 0) |
| "我要给现场一个可解释的告警" | 极差("最坏到多少"比"平均抖多少"好懂) |
★ 一个可操作的判断法:
把这一列的取值画成随时间变化的曲线:
   如果它是"缓慢漂移的" → 它在描述设备状态(有用)
如果它是"随机跳动的" → 它在描述一次采样(多数时候是噪声)在本章数据上:temp_win_range20 是一支设备一个水平、缓慢变化(见 9.6 节的图), 所以它属于第一类 —— 描述状态。
⚠️ 但务必记住:"有用"和"涨分"是两件事。 这一列在本书主线里对 R² 的贡献接近 0, 它的价值在于"能让现场读懂",而不是"能让模型更准"。
9.5 ★ 现场判读 vs 数据事实
这一节是本章最重要的部分。
先看要检验的那句话:
"极差突然变大 = 散热/接触不稳,往往早于 SOH 异常出现。"
这是一句很典型的"现场经验"。它听起来非常合理。 但"听起来合理"不是证据。
真实输出:
=== ④ 检验一句现场判读:极差大,真的更早出问题吗 ===
  corr(temp_win_range20, 当前 soh)                = -0.0599
  corr(temp_win_range20, 未来  5 个窗口的 soh 变化) = -0.0403
  corr(temp_win_range20, 未来 20 个窗口的 soh 变化) = -0.1032
  corr(temp_win_range20, 未来 50 个窗口的 soh 变化) = -0.1038
  → 相关都在 -0.04 ~ -0.11 之间,解释不到 1.5% 的方差。
     说白了:在这份数据上,「极差大 → 即将异常」【没有线性证据】。
     原因是这份数据是理想化的单调退化,没有注入散热异常这类故障。
  ★ 纪律:现场经验是【假设】,不是【事实】。
     别人数据上的结论,必须自己在自己数据上跑一遍才能写进账本。
★ 把这句话拆成可检验的形式:
"极差大 → 即将异常"
   ↓
改写成能算的:
if 极差大(今天):
   then SOH 在接下来 k 个窗口里掉得更多(未来)
        ↓
检验方式:corr(极差_t, soh_{t+k} - soh_t)结果:
| k(未来多少个窗口) | 相关系数 | 能解释的方差 |
|---|---|---|
| 5 | −0.0403 | 0.16% |
| 20 | −0.1032 | 1.07% |
| 50 | −0.1038 | 1.08% |
★ 三个数字一起看:
方向是对的(负号:极差大 → 未来掉得多)
   ↓
但量级极小:最好的一条也只解释了 1% 的方差
   ↓
结论:这句话在这份数据上【不成立】
⚠️ 为什么要把这条写进书里?因为它是一个通用的教训:
"极差大 = 散热不稳"  ← 这句话本身没问题,它是【物理直觉】
"极差大 → 早于 SOH 异常" ← 这句话是【经验断言】,需要证据
                            ↓
            在这份合成数据上,它没有证据(因为数据里没有注入故障)
            在真实数据上,它可能有,也可能没有 —— 但必须【验一遍】
★ 一条可以直接抄走的验证模板:
def check_precursor(df, feat, target="soh", group="cell_id", ks=(5, 20, 50)):
    """检验"这个特征是不是提前报警器"。"""
    d = df.sort_values([group, "cycle"]).reset_index(drop=True)
    print(f"  corr({feat}, 当前 {target}) = {d[feat].corr(d[target]):+.4f}")
    for k in ks:
        fut = d.groupby(group)[target].shift(-k) - d[target]
        print(f"  corr({feat}, 未来 {k:>2d} 个窗口的 {target} 变化) = "
              f"{d[feat].corr(fut):+.4f}")
★ 这个模板解决的是一个非常常见的团队问题:
现场工程师:"这个指标一高就要出事"
数据科学家:"好的,我把它加进特征"          ← ❌ 直接采信
                        ↓
正确做法:先跑 10 行代码验一遍,
         把相关系数写进特征账本(哪怕结果是"没关系")
★ 最后一句,也是本章的立场:
把"现场经验"当成候选假设**,而不是结论。 验证的成本是 10 行代码; 不验证的成本是"模型里多了一列看起来很有道理、实际全是噪声的特征"。**
9.6 用极差给设备排队
真实输出:
=== ⑤ 用极差给设备排队:谁的温升最不稳 ===
  平均极差最小的 3 支:
           mean     std     max
cell_id
C005     1.6160  0.2865  2.2076
C041     1.6769  0.3192  2.4043
C026     1.6914  0.3599  2.8773
  平均极差最大的 3 支:
           mean     std     max
cell_id
C022     1.9659  0.3934  3.3856
C031     2.0353  0.3914  3.3871
C037     2.0892  0.4412  3.2166
  最大 / 最小 = 1.29 倍 —— 设备之间的差异是真实的,不是噪声。
  同一支设备自己的极差也在变:C037 的极差范围 1.3299 ~ 3.2166
★ 这张表有两种读法:
读法一:横向比设备(谁更不稳)
C005:平均极差 1.6160,历史最高 2.2076
C037:平均极差 2.0892,历史最高 3.2166
        ↓
C037 的"典型波动"比 C005 高 29%
读法二:纵向看单支设备(它自己什么时候不稳)
C037 自己的极差范围:1.3299 ~ 3.2166
        ↓
同一支设备,最稳的时候和最不稳的时候差 2.4 倍
        ↓
"设备之间有差异" 和 "同一支设备在不同时间有差异",这两件事同时存在
★ 这解释了为什么"用极差做告警"必须按设备归一化****:
# ❌ 全局阈值:C005 永远不报警,C037 天天报警
alert = df["temp_win_range20"] > 2.7

# ✅ 按设备归一化:问"这台设备相对它自己,是不是异常"
z = (df["temp_win_range20"]
     - df.groupby("cell_id")["temp_win_range20"].transform("mean")) \
    / df.groupby("cell_id")["temp_win_range20"].transform("std")
alert = z > 3
⚠️ 但这里有一个必须小心的点:
按设备归一化用到了"这支设备的均值/标准差"
   ↓
如果这个均值/标准差是在【全生命周期】上算的 → 用到未来数据(第 10 章)
   ↓
正确做法:用"到目前为止"的均值/标准差(expanding),或者写进特征账本说明
★ 这正是"看起来很自然的操作,里面可能藏着泄漏"的又一个例子。
9.7 极差大的行,别急着当异常值删掉
真实输出:
=== ⑥ 极差大的行,别当异常值删掉 ===
  极差最大的 1%(201 行,极差 ≥ 2.6959)的标签:
    soh 均值 0.9000,全表 soh 均值 0.9088  ← 几乎一样
    这些行分布在 24 支设备上,不是某一支的毛病
  → 它们不是「录错了」:如果极差本来就是你要预测的对象(故障前兆),
     删掉它等于把要预测的东西删掉。先问「它为什么大」,再决定怎么处理。
★ 两个数字直接否掉了"删掉"这个动作:
| 观察 | 数字 | 说明 |
|---|---|---|
| 标签均值 | 0.9000 vs 全表 0.9088 | 几乎一样,不是"极端样本" |
| 涉及设备 | 24 支 | 不是某一支的毛病,是普遍现象 |
★ "极差最大的 1%"为什么不是异常值:
异常值的定义是"不属于这个分布"
   ↓
但极差是一个【重尾分布】:尾巴长本来就是它的正常形态
   ↓
99% 分位以上还有 1% 的样本 —— 这不是异常,这是分布的形状
★ 那什么时候该删?
| 情况 | 处理 |
|---|---|
| 值超过物理上限(比如温升极差 = 500 ℃) | 删 / 修,并记录 |
| 单支设备出现,且和其他列同时对不上 | 单独排查这支设备 |
| 分布尾巴长,但物理上可能 | 留着,或者当成"要预测的对象" |
★ 最后一句是本章的立场:
"极端值"和"异常值"是两回事。 极端值是分布的一部分;异常值是分布之外的东西。 把极端值当异常值删掉,是最常见的一种"自欺欺人的数据清洗"。
9.8 常见坑
① 把极差和标准差当同一件事       → 相关系数只有 +0.155,两个时间尺度
② 用 expanding 的极差            → 单调不减,变成"年龄"的伪装
③ 用全局阈值做极差告警           → 设备之间差 1.29 倍,必须按设备归一化
④ 按设备归一化时用了全生命周期的均值 → 用到未来数据(第 10 章)
⑤ 把"现场判读"直接当结论          → 实测相关 −0.04 ~ −0.11,没有线性证据
⑥ 把极差最大的 1% 当异常值删掉    → 标签均值 0.9000 vs 全表 0.9088,它们很正常
9.9 完整示例与输出
cd code
python demos/ch09-rolling-summary.py
真实输出(节选):
=== ① temp_win_range20 的分布(过去 20 个窗口内温升的极差)===
count    20039.0000
mean         1.7895
std          0.3560
min          0.7322
50%          1.7623
max          3.4476

=== ② 从头复算一遍:`shift(1).rolling(20)` 的 max − min ===
  参与核对的行数:20,039
  与表里那一列的最大绝对差:3.109e-15
  手算核对最大极差那一行(C050 / cycle=930):
    过去 20 个窗口温升:max 10.9026 − min 7.4550 = 3.4476(表里 3.4476)

=== ④ 检验一句现场判读:极差大,真的更早出问题吗 ===
  corr(temp_win_range20, 未来 20 个窗口的 soh 变化) = -0.1032

=== ⑤ 用极差给设备排队:谁的温升最不稳 ===
  最大 / 最小 = 1.29 倍 —— 设备之间的差异是真实的,不是噪声。

结论:极差 mean 1.7895 / std 0.3560 / min 0.7322 / 50% 1.7623 / max 3.4476(20,039 行)
      它和窗口内标准差几乎不相关(r = +0.155),量的是另一个时间尺度。
      「极差大 → 即将异常」在这份数据上没有线性证据,
      但这不代表它没用 —— 代表它需要你自己在真实数据上验一遍。
本章练习
练习 1:复算 temp_win_range20 并核对
主表里的 temp_win_range20 是"过去 20 个窗口内温升的极差"。
- 用
soh_features.csv里的mean_temp_rise_c复算:shift(1).rolling(20)的max − min; - 按
(cell_id, cycle)与主表合并,打印核对行数、最大绝对差、相关系数; - 打印主表这一列的
describe()。
要求:最大绝对差要小到 1e-14 量级,才算复算成功。
参考答案
import os

import pandas as pd

HERE = os.path.dirname(os.path.abspath(__file__))
CODE = os.path.abspath(os.path.join(HERE, "..", ".."))
DATA = os.path.join(CODE, "data", "battery")
V1_CSV = os.path.join(DATA, "soh_features.csv")
V2_CSV = os.path.join(DATA, "soh_features_v2.csv")

v2 = pd.read_csv(V2_CSV).sort_values(["cell_id", "cycle"]).reset_index(drop=True)
base = pd.read_csv(V1_CSV).sort_values(["cell_id", "cycle"]).reset_index(drop=True)
W = 20
gb = base.groupby("cell_id")["mean_temp_rise_c"]
rec = (gb.transform(lambda s: s.shift(1).rolling(W).max())
       - gb.transform(lambda s: s.shift(1).rolling(W).min()))
chk = (base.assign(rec=rec).set_index(["cell_id", "cycle"])["rec"].to_frame()
       .join(v2.set_index(["cell_id", "cycle"])[["temp_win_range20"]], how="inner")
       .dropna())
d = (chk["rec"] - chk["temp_win_range20"]).abs()
print(f"  核对行数:{len(chk):,d}")
print(f"  最大绝对差:{d.max():.3e}    相关系数:"
      f"{chk['rec'].corr(chk['temp_win_range20']):.6f}")
print(" " + v2["temp_win_range20"].describe().round(4).to_string())期望输出:
=== 练习 1:复算 temp_win_range20 并核对 ===
  核对行数:20,039
  最大绝对差:3.109e-15    相关系数:1.000000
  count    20039.0000
  mean         1.7895
  std          0.3560
  min          0.7322
  25%          1.5399
  50%          1.7623
  75%          2.0218
  max          3.4476
★ 为什么"最大绝对差 3.109e-15"这个数值得单独说一句:
3e-15 是浮点数的舍入误差量级(双精度约 1e-16 相对误差 × 数量级 10)
   ↓
它不是"差不多一样",而是"同一个算式"
   ↓
把它写进特征账本,下一个人就不需要再猜这一列是怎么算的
★ 复算的价值不在于"这次对不对",而在于:
你能把这一列的定义用 3 行代码写出来。 任何写不出 3 行定义的列,都不该出现在特征表里。
练习 2:极差和谁相关、和谁不相关
打印 temp_win_range20 与下列各列的相关系数:
temp_win_mean、temp_std_c、res_win_std、volt_win_std、soh;- "未来 5 / 20 / 50 个窗口的 soh 变化"(用
groupby(...)["soh"].shift(-k) - soh)。
然后回答:"极差突然变大 = 马上要出问题"这句话,在这份数据上成立吗?
参考答案
import os

import pandas as pd

HERE = os.path.dirname(os.path.abspath(__file__))
CODE = os.path.abspath(os.path.join(HERE, "..", ".."))
V2_CSV = os.path.join(CODE, "data", "battery", "soh_features_v2.csv")

v2 = pd.read_csv(V2_CSV).sort_values(["cell_id", "cycle"]).reset_index(drop=True)
for c in ["temp_win_mean", "temp_std_c", "res_win_std", "volt_win_std", "soh"]:
    print(f"  corr(temp_win_range20, {c:14s}) = "
          f"{v2['temp_win_range20'].corr(v2[c]):+.4f}")
for k in (5, 20, 50):
    fut = v2.groupby("cell_id")["soh"].shift(-k) - v2["soh"]
    print(f"  corr(temp_win_range20, 未来 {k:>2d} 窗口的 soh 变化) = "
f"{v2['temp_win_range20'].corr(fut):+.4f}")期望输出:
=== 练习 2:极差和谁相关、和谁不相关 ===
  corr(temp_win_range20, temp_win_mean ) = +0.0544
  corr(temp_win_range20, temp_std_c    ) = +0.1552
  corr(temp_win_range20, res_win_std   ) = +0.0735
  corr(temp_win_range20, volt_win_std  ) = +0.0446
  corr(temp_win_range20, soh           ) = -0.0599
  corr(temp_win_range20, 未来  5 窗口的 soh 变化) = -0.0403
  corr(temp_win_range20, 未来 20 窗口的 soh 变化) = -0.1032
  corr(temp_win_range20, 未来 50 窗口的 soh 变化) = -0.1038
④ 回答:不成立(在这份数据上)
方向是对的:极差大 → 未来掉得多(负相关)
量级太小:最好的一条解释 1.08% 的方差
                ↓
"极差大 = 马上要出问题" 这句话,
在这份数据上无法作为【预测信号】使用
★ 但请注意这个结论的适用范围****:
❌ "极差这个特征没用"
✅ "在这份【没有注入故障】的合成数据上,极差与未来 SOH 下降没有线性关系"
这正是第 02 章那条纪律在特征工程上的样子:
每个结论都要带限定词:在什么数据上、用什么方法、得到什么。 缺一个,它就会在下一个数据集上变成错误结论。
练习 3:极差最大的那 1% 是什么
- 取 99% 分位作为阈值,统计超过它的行数、涉及多少支设备;
- 对比这些行与全表的标签均值;
- 写一句"该不该当异常值删掉"的结论。
参考答案
import os

import pandas as pd

HERE = os.path.dirname(os.path.abspath(__file__))
CODE = os.path.abspath(os.path.join(HERE, "..", ".."))
V2_CSV = os.path.join(CODE, "data", "battery", "soh_features_v2.csv")

v2 = pd.read_csv(V2_CSV)
q99 = v2["temp_win_range20"].quantile(0.99)
hi = v2[v2["temp_win_range20"] >= q99]
print(f"  阈值(99% 分位):{q99:.4f},共 {len(hi):,d} 行,"
      f"分布在 {hi['cell_id'].nunique()} 支设备上")
print(f"  这些行的 soh 均值 {hi['soh'].mean():.4f},"
      f"全表 soh 均值 {v2['soh'].mean():.4f}")
print(f"  这些行的极差最大值 {hi['temp_win_range20'].max():.4f}"
f"(全表最大 {v2['temp_win_range20'].max():.4f})")期望输出:
=== 练习 3:极差最大的那 1% 是什么 ===
  阈值(99% 分位):2.6959,共 201 行,分布在 24 支设备上
  这些行的 soh 均值 0.9000,全表 soh 均值 0.9088
  这些行的极差最大值 3.4476(全表最大 3.4476)
  → 它们不是错误数据:极差大本身可能就是你要预测的对象,先别删。
③ 结论(一句话):
这 201 行不应该被当异常值删除: 它们的标签均值(0.9000)与全表(0.9088)几乎一样, 分布在 24 支设备上 —— 它们是分布的正常尾巴,不是"错误数据"。
如果极差大本身是你要预测的对象(比如"散热故障前兆"), 删掉它等于把要预测的东西删掉。
★ 一个"该删 vs 不该删"的判断顺序:
先问:这个值物理上可能吗?
   ├─ 不可能(温升 500 ℃)→ 删,并记录原因
   └─ 可能 → 再问:它是"分布的一部分"还是"分布之外"?
            ├─ 分布之内(99% 分位的另一侧还有 1%)→ 留着
            └─ 分布之外(用其他列交叉验证也对不上)→ 单独排查
面向工程实践:把"波动"做成一条能被读懂的曲线
① 极差类特征的三条使用原则
| 原则 | 做法 |
|---|---|
| 按设备归一化 | 用"这台设备自己的历史"当基准,不要用全局阈值 |
| 用 expanding 而不是全体统计 | 避免"用未来算现在"(第 10 章) |
| 阈值写进账本 | 99% 分位是多少、谁定的、什么时候该重算 |
② 一个可复制的"极差异常度"特征
def add_range_anomaly(df, col, group="cell_id", order="cycle", min_periods=20):
    """按设备归一化的极差异常度:只用【到目前为止】的均值/标准差。"""
    df = df.sort_values([group, order]).reset_index(drop=True)
    g = df.groupby(group)[col]
    mu = g.transform(lambda s: s.shift(1).expanding(min_periods=min_periods).mean())
    sd = g.transform(lambda s: s.shift(1).expanding(min_periods=min_periods).std())
    df[f"{col}_z"] = (df[col] - mu) / sd
    return df
★ 注意这里有两个 shift(1):
shift(1).expanding().mean()  → 用"上一行之前"的历史算均值
(如果不 shift,第 1 行就会用自己算自己的均值 → z 值恒为 0)
⚠️ 这个函数的输出也需要 dropna(前 min_periods 行是 NaN), 并且它比原始极差列更"贪心" —— 第 07 章的账要重算一遍。
③ 现场话术 vs 特征名的一一对应
| 现场说法 | 特征列 | 读法 |
|---|---|---|
| "最近散热不太稳" | temp_win_range20 | 数值越大越不稳 |
| "这台设备比那台颠" | temp_win_range20 的设备均值 | 跨设备比较 |
| "它最近比它自己平时颠" | temp_win_range20_z | 按设备归一化 |
| "这次循环内部有抖动" | temp_std_c | 窗口内 |
★ 这张表本身就是"特征账本"的一小块 —— 第 16 章会把它做成正式交付物。
④ 这一部分的收尾
第 05 章:把一段曲线压成几个数(水平)
第 06 章:压之前必须分组排序(前提)
第 07 章:压完产生 NaN(代价)
第 08 章:变化量(方向与速度)
第 09 章:极差与波动(最坏情况)        ← 你在这里
第 10 章:把上面五章的坑收成一张检查表
★ 到这里为止,你已经造出了"四类"时序特征:
| 类 | 回答 | 代表列 |
|---|---|---|
| 水平 | 现在多高 | volt_win_mean |
| 波动 | 平均抖动多大 | volt_win_std、temp_std_c |
| 变化 | 往哪走、多快 | res_slope20 |
| 极值 | 最坏到什么程度 | temp_win_range20 |
下一章不再造新特征,而是回答一个更根本的问题: 这四类特征里,哪些"拿得到",哪些"拿不到"。