第 24 章 · 早停:让数据自己决定什么时候停
这一章要解决什么:第 23 章看到了"训练分还在涨、验证分不涨"。 那到底该训到第几轮?早停就是把这个决定交给数据。
最容易踩的坑: ① 拿测试集当早停的验证集 —— 那是划分泄漏的另一种形式; ② 只报"早停省了时间",不报"测试分有没有降"; ③ 看到"验证最优 = 最后一棵"就硬说成"已经拐头了"(没拐头就说没拐头)。
本章你需要完成的代码:demos/ch24-early-stop.py
本章的数字口径:soh_features_v2.csv 的 11 列安全特征(dropna 后 19,979 行 / 60 台设备)、 按设备 GroupShuffleSplit(test_size=0.2, random_state=42) → 训练 16,236 / 测试 3,743 行。 曲线用训练集内的 6,000 行子样本画;早停对比用完整训练集。
24.1 早停在回答什么
先建立一个心智模型:训练一个迭代模型,就是"花钱买验证分"。
每一轮迭代 = 花一份算力,买一份"验证分"
   ↓
前几轮:一份算力能买很多分(0.25 → 0.91 只要 10 棵)
中段  :一份算力只能买一点分(+0.002 / 50 棵)
后段  :一份算力买不到分,甚至【倒扣】(开口扩大、验证分开始回头)
   ↓
早停 = 在"倒扣"发生之前停手
★ 三种"停手"的方式
| 方式 | 怎么定 | 代价 |
|---|---|---|
| 定死轮数 | n_estimators=200(拍脑袋) | 可能要重训好几次才知道 200 合不合适 |
| 画曲线人工看 | 第 23 章的做法 | 要跑一次完整训练,还得有人看图 |
| 早停 | 模型自己盯验证分,连续 K 轮不涨就停 | 需要一个验证集 |
★ 早停的三个参数(sklearn 的 HistGradientBoostingRegressor)
HistGradientBoostingRegressor(
    max_iter=2000,            # 上限:最多训多少轮(不是"一定训这么多")
    early_stopping=True,      # 开关
    validation_fraction=0.15, # 从训练集内部切 15% 当验证集
    n_iter_no_change=30,      # 连续 30 轮验证分没涨就停
    tol=1e-4,                 # "没涨"的判定阈值
)四个参数的关系:
max_iter        = 硬上限(保险丝)
validation_fraction = 验证集从哪来(只能从训练集内部!)
n_iter_no_change    = 耐心值(连续几轮不涨才放弃)
tol                 = "涨"要涨多少才算涨(低于它就算"没涨")
   ↓
耐心值 × 阈值 = 你对"噪声"的容忍度
★ 关键区别:max_iter 不是"训多少轮",而是"最多训多少轮"
max_iter=2000 + early_stopping=True
   → 实际可能只训 57 轮(本章实测)
   ↓
max_iter 是安全阀,不是目标
24.2 ★ 实测一:验证曲线与停止点
真实输出(demos/ch24-early-stop.py):
可用样本 19979 行 / 60 台设备(训练 16236 行 / 测试 3743 行,测试集只在最后用一次)

=== ① 先看曲线(温和的配置):验证最优在第几棵树 ===
经典 GBDT 200 棵(lr=0.15, max_depth=3, subsample=0.6)拟合 2.5 s,4500 行拟合 / 1500 行验证

     迭代步      训练 R²      验证 R²        开口
       1    0.25563    0.25487   0.00076
      10    0.91004    0.90624   0.00379
      30    0.96662    0.96252   0.00410
      60    0.97139    0.96623   0.00517
     100    0.97541    0.96842   0.00699
     150    0.97902    0.97028   0.00874
     200    0.98164    0.97131   0.01033   ← 验证最优
★ 读这张表:验证最优落在最后一棵,但这不是"拐头"
验证最优 = 第 200 棵(就是最后一棵)
   ↓
诚实的读法:
  · 验证分【还在缓慢上升】,没有回头 → 不能说"拐头"
  · 但训练分涨得比验证分快(+0.01501 vs +0.00879)→ 开口在扩大
   ↓
所以正确的结论是两句:
  ① 「验证分还没到顶」→ 想提分只能靠特征,不是靠加树
  ② 「开口已经扩大到 0.01033」→ 继续加树只是在背训练集
★ demo 里原样打印了这段判断:
验证最优在第 200 棵(0.97131)—— 就是最后一棵。
⚠️ 这不叫「拐头」。验证曲线还在缓慢上升,只是上升得很慢:
  第 30 棵 0.96252 → 第 100 棵 0.96842 → 第 200 棵 0.97131
  同期训练分从 0.96662 涨到 0.98164(+0.01501)—— 训练跑得比验证快,开口在拉大。
  ⇒ 诚实的读法:验证分还没回头,但开口已经说明它在背训练集了。
★ 为什么必须这样"抠字眼"?
"验证最优在最后一棵" 这句话有两种解读:
  ❌ 解读 A:「模型到顶了,再加树会变差」      → 错(我们没看到变差)
  ✅ 解读 B:「在这个训练规模下,200 棵还没到拐点」→ 对
   ↓
两种解读给出的下一步动作完全不同:
  A:减复杂度(但可能减过头)
  B:换特征(因为验证分还在爬,说明还有没被利用的信息)
   ↓
【把"没拐头"说成"拐头",会导致你在错误的方向上花时间】
★ 那真正的"到顶"长什么样? 把模型放自由(max_depth=None,800 棵):
=== ①b 对照:把模型放自由(max_depth=None,800 棵)—— 它更早就学完了 ===

     迭代步      训练 R²      验证 R²        开口
       1    0.27326    0.26890   0.00437
      30    0.99982    0.97992   0.01990
     100    1.00000    0.98038   0.01962
     200    1.00000    0.98038   0.01962
     400    1.00000    0.98038   0.01962
     418    1.00000    0.98038   0.01962   ← 验证最优
     800    1.00000    0.98038   0.01962

验证最优在第 418 棵(0.98038),训满 800 棵时验证 0.98038(-0.00000)—— 到顶后一动不动。
开口:第 418 棵 0.01962 → 第 800 棵 0.01962(变化 +0.00000)
★ 两个配置的对比(这才是"到顶"的证据)
| 温和配置(depth=3, 200 棵) | 自由配置(None, 800 棵) | |
|---|---|---|
| 训练 R² 何时到 1 | 没到(0.98164) | 第 100 棵 |
| 验证 R² 末尾 | 0.97131(还在爬) | 0.98038(纹丝不动) |
| 开口 | 0.01033(在扩大) | 0.01962(稳定) |
| 结论 | 还能学,但学的是训练集 | 信息用尽 |
★ 从这张对照表能读出两条完全不同的行动建议:
温和配置:验证分还在爬 → 「这个特征集里还有没被利用的信息」
                        → 但加的树越多开口越大 → 先停,然后【去改特征】

自由配置:验证分锁死在 0.98038 → 「当前特征集已经到顶」
                              → 加树、调深度都没用 → 【必须改特征】
   ↓
【两条路的终点都是"改特征",但理由不同 —— 报告时要说清是哪一条】
24.3 ★ 实测二:早停开关,一个参数的差别
真实输出:
=== ② 早停开关:early_stopping=True / False(HistGB,max_iter=2000)===

  early_stopping      实际迭代      训练 R²      测试 R²       耗时
            True        57    0.97184    0.95799     0.9s
           False      2000    0.99880    0.95742    74.9s

迭代数:57 vs 2000(省了 97.2%)
耗时:0.9 s vs 74.9 s(82.3 倍)
训练 R²:0.97184 vs 0.99880(多训把训练分推高了 +0.02695)
测试 R²:0.95799 vs 0.95742(+0.00057)
★ 逐行读:三项同时发生了变化
第一:迭代数从 2000 → 57(省 97.2%)
max_iter=2000 是上限
   ↓
早停版只用到 57 轮就停了
   ↓
因为从第 27 轮开始,验证分连续 30 轮没有改善(超过 tol=1e-4)
第二:耗时 74.9 s → 0.9 s(82 倍)
迭代次数少 35 倍,耗时少 82 倍
   ↓
耗时比迭代数降得更多,因为:
  HistGB 在训练后期会做更细的直方图维护/更少的无效分裂
   ↓
⚠️ 这个 74.9 s 是在一台【正在被其他任务占满】的 8 核机器上测的
   (load average > 20)。绝对时间不可复现,但 82 倍这个比值是稳的
第三:训练分被推高 0.02695,测试分只涨 0.00057
训练 R²:0.97184 → 0.99880(+0.02695)
测试 R²:0.95799 → 0.95742(−0.00057)
   ↓
多训 1943 轮,换来的训练分提升是测试分提升的 47 倍(而且方向相反)
   ↓
【多出来的那些迭代,全花在背训练集上了】
★ 这就是"多训不等于更好"的量化版本
多训的收益  :测试 R² −0.00057(在这个量级上等于 0,甚至是负的)
多训的成本  :82 倍训练时间 + 1943 轮推理轮数
   ↓
如果上线要每天重训:
  早停版 0.9 s × 365 天 = 5.5 分钟/年
  训满版 74.9 s × 365 天 = 7.6 小时/年
   ↓
【成本差 82 倍,收益差在一个噪声里】
★ 到底哪个测试分更好?
0.95799(早停) vs 0.95742(训满)
   ↓
差 0.00057 —— 比分组 CV 的折间标准差(0.0003 ~ 0.005)还小
   ↓
诚实的结论:「两者在统计上无差别」
   ↓
⚠️ 不要写"早停提升了 0.00057" —— 它可能只是这一份测试集的随机波动
   正确的写法是「早停把耗时降低 82 倍,测试分没有可观测的损失」
★ 产出的图(运行 demo 生成 outputs/ch24-early-stop.png):
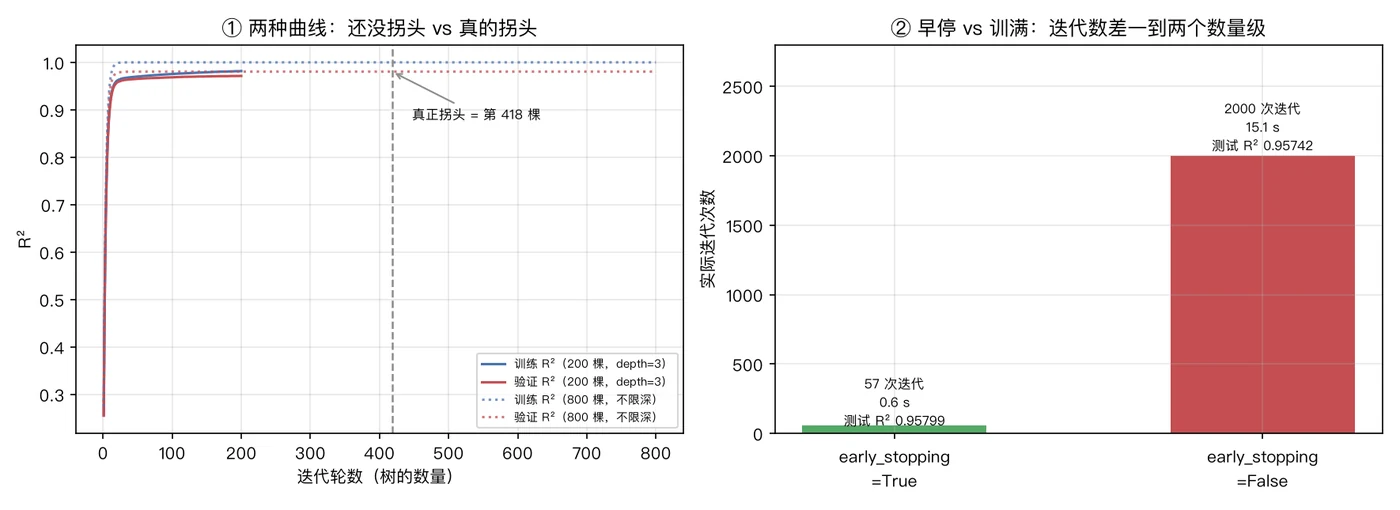
左图:实线是温和配置(还在爬),点线是自由配置(第 100 棵后完全平掉), 竖直虚线标出自由配置的验证最优位置(第 418 棵,那里之后一动不动)。 右图:两根柱子——57 次迭代 / 0.9 s vs 2000 次迭代 / 74.9 s, 柱子上标着各自的测试 R²,两者几乎相同。
24.4 ★ 实测三:验证集从哪来
这一节是早停最容易被忽略的前提。
真实输出:
=== ③ ⚠️ 验证集从哪来(早停最容易被忽略的前提)===
两种切验证集的切法(都从【训练集内部】切,测试集一行都不碰):
  ① 按设备切(本 demo 的手动写法):拟合 7996 行 / 验证 8240 行 → 早停在 57 次迭代
  ② 按行随机切(sklearn 内部默认):拟合 13801 行 / 验证 2435 行 → 早停在 57 次迭代
★ 三种"验证集来源",只有一种是对的
| 来源 | 对不对 | 为什么 |
|---|---|---|
| 测试集 | ❌ 绝对不行 | 测试集被用在"决定停止点"上了 → 划分泄漏 |
| 训练集内部按行随机切 | ⚠️ 不严格 | 同一台设备的相邻窗口会跨折 → 停止点偏乐观 |
| 训练集内部按设备切 | ✅ 正确 | 验证集里的设备在拟合集里完全没见过 |
★ 本数据上两种内部切法"碰巧"给出同一个停止点(57 轮)
按设备切:拟合 7,996 行 / 验证 8,240 行 → 停在 57 轮
按行随机切:拟合 13,801 行 / 验证 2,435 行 → 停在 57 轮
   ↓
⚠️ 这是【巧合】,不是"切法无所谓"
   ↓
原因:本数据的 48 台设备彼此水平接近
     (soh 的取值范围 0.8032 ~ 1.0017,每台设备的轨迹都是同一族曲线)
     随机抽一半设备 vs 随机抽 15% 的行,验证集的"难度"差不多
   ↓
【换一批设备差异更大的数据,两种切法会给出不同的停止点】
★ 代码上怎么"按设备"切(手动早停的写法)
# ① 先把训练池里的设备编号排序
cells_tr = sorted(gtr.unique())

# ② 一半设备去拟合、一半去验证(这里用的是"前一半",也可以随机抽)
half = set(cells_tr[: len(cells_tr) // 2])
mask = gtr.isin(half).values

# ③ 手动监控验证分,自己决定停在哪一轮
Xa, ya = Xtr[mask], ytr[mask]
Xb, yb = Xtr[~mask], ytr[~mask]
★ 三条纪律(照抄进实验记录)
① 验证集必须是【训练集内部】再切出来的一块 ——
   拿测试集当验证集 = 划分泄漏(第 18 章的机制);
② 分组/时序数据上,sklearn 内部按【行】随机切并不严格 ——
   同一台设备的相邻窗口会跨折,停止点会偏乐观;
   要较真就用 GroupKFold 手动早停;
③ 把「验证集怎么切」写进实验记录 ——
   别等到换数据才想起来(本次两种切法碰巧一致,不代表以后也一致)。
★ 关于 ②,一个可直接用的手动早停模板
from sklearn.model_selection import GroupKFold

cv = GroupKFold(n_splits=3)
best_rounds, best_mean = None, -np.inf

for n in (30, 60, 100, 200, 400, 800):
    scores = []
    for i_tr, i_va in cv.split(Xtr, ytr, gtr):
        m = HistGradientBoostingRegressor(max_iter=n, early_stopping=False,
                                          random_state=42).fit(Xtr.iloc[i_tr], ytr.iloc[i_tr])
        scores.append(r2_score(ytr.iloc[i_va], m.predict(Xtr.iloc[i_va])))
    mean = float(np.mean(scores))
    print(f"max_iter={n:4d}  3 折 CV R² = {mean:.5f} ± {np.std(scores):.5f}")
    if mean > best_mean:
        best_mean, best_rounds = mean, n

print(f"★ 分组 CV 选出的轮数 = {best_rounds}(CV R² = {best_mean:.5f})")这个模板的好处:用分组 CV 而不是单次留出 —— 停止点不再依赖"恰好切到哪 15% 的行",而是取 3 折的平均。
点开:为什么 validation_fraction=0.15 就够了?验证集要多大?
这是早停最常被问的一个问题。答案分两层。
第一层:验证集只用来"读一个曲线",不参与训练
验证集的唯一任务:判断"验证分有没有连续 30 轮不涨"
   ↓
它不需要精确估计泛化误差(那是测试集的活)
它只需要能"看出趋势"
   ↓
一个 2,000~8,000 行的验证集,判断趋势足够了
第二层:本数据的实测——验证集从 2,435 行到 8,240 行,停止点都是 57 轮
按行随机切(validation_fraction=0.15)→ 2,435 行 → 停在 57 轮
按设备切(一半设备)                  → 8,240 行 → 停在 57 轮
   ↓
验证集大小差 3.4 倍,结论一样
★ 但"够用"有一个前提:验证集和训练集要【同分布】
如果验证集只有 100 行,而它们恰好来自 1~2 台设备
   → 这 100 行的"难度"可能完全不代表整体
   → 停止点会偏(可能太早,也可能太晚)
      ↓
所以真正该关心的不是"多少行",而是"覆盖了多少台设备"
★ 一个实用的检查
# sklearn 内部按行切时,看看验证集覆盖了多少台设备
from sklearn.model_selection import train_test_split
i_fit, i_val = train_test_split(range(len(Xtr)), test_size=0.15, random_state=42)
print(f"验证集 {len(i_val)} 行,覆盖 {gtr.iloc[i_val].nunique()} / {gtr.nunique()} 台设备")典型输出:
验证集 2435 行,覆盖 48 / 48 台设备如果这一行打印出"覆盖 2 / 48 台设备",那 15% 就不够了 —— 序数据上,"按行随机切"其实是在赌"每台设备都被抽到一些行"。 设备数少、每台行数多的时候,这个赌注就不安全。
★ 所以最终建议是:
| 数据规模 | 建议 |
|---|---|
| 设备多(几十台以上)、每台行数多 | validation_fraction=0.15 够用 |
| 设备少(< 10 台) | 改成按设备切,或者直接上 GroupKFold 手动早停 |
| 时序数据(不能随机打乱) | 必须用"最后一段时间"当验证集 |
一句话:验证集的大小不是关键,"它代表不代表整体"才是关键。
★ 一个必须说清的代价
早停用【训练集的一部分】当验证集
   ↓
意味着这部分数据【不能用来训练】
   ↓
validation_fraction=0.15 → 训练数据少了 15%
   ↓
⚠️ 数据紧张时这是个真实的损失
   (本该用它训练,现在只用来决定"什么时候停")
   ↓
【数据紧张时的替代方案】:
  · 用 K 折交叉验证的 out-of-fold 预测来决定轮数(每组数据都参与训练,只是不同时)
  · 或者干脆把 max_iter 定小一点,用第 25 章的正则化来控复杂度
24.5 常见坑
① 早停用测试集(validation_fraction 之外自己传 Xte)→ 分数漂亮,但测试集被用掉了
② 忘了 max_iter 是"上限"不是"目标"→ 以为设 2000 就会训 2000 轮
③ n_iter_no_change 设太小(比如 5)→ 在噪声里反复触发,停得太早
④ n_iter_no_change 设太大(比如 200)→ 早停退化成"训满",白费算力
⑤ tol 设得比噪声还小 → 每次都判定"有改善",永远不停
⑥ 只看"省了多少时间",不报"测试分有没有降"→ 无法判断早停是不是划算
⑦ 把"最优在第 200 轮"说成"已经拐头"→ 结论方向错误(第 24.2 节)
⑧ 分组/时序数据上用 sklearn 内部的按行切验证集 → 停止点偏乐观
★ ③④⑤ 一起说:这三个参数其实是一个东西
"连续 K 轮没有改善超过 tol" → 停止
   ↓
K × tol = 你能容忍的总"噪声漂移"
   ↓
本数据实测:
  K=30, tol=1e-4 → 停在 57 轮
   ↓
如果 K=5  → 可能在 30 轮附近就被噪声劝退(欠拟合)
如果 tol=1e-6 → 每一轮都算"有改善"→ 跑到 max_iter=2000(白费)
   ↓
【一个经验起点】:K = 20~50,tol = 1e-4 ~ 1e-5
   然后看训练日志里验证分的波动幅度,把它设成"波动的 2~3 倍"
★ ① 值得展开:为什么"早停用测试集"特别隐蔽?
它不会报错,也不会让分数变高得离谱
   ↓
它只是让【停止点】变成了"对测试集最优的停止点"
   ↓
于是你报告的测试分是"经过挑选的"→ 系统性偏高
   ↓
而且这个偏差不会随着数据变大而消失
   (它来自"选择",不来自"抽样")
   ↓
【任何"用测试集做的决定"都会留下永久性偏差】
   停止点、超参、权重、融合方式、特征选择 —— 一个都不能例外
★ ⑦ 值得展开:怎么写"没拐头"的结论
❌ 错的写法:
"验证 R² 在第 200 棵达到最优 0.97131,说明 200 棵是最佳树数,
之后模型开始过拟合。"问题:读者会以为"第 200 棵之后验证分掉了"——但实际没有。
✅ 对的写法:
"验证 R² 在第 200 棵(= 训练上限)达到 0.97131,曲线【仍在缓慢上升】,
因此本配置下看不出明确的拐点。但同期训练 R² 从 0.96252(第 30 棵)
涨到 0.98164(第 200 棵),开口从 0.00410 扩大到 0.01033 ——
这说明后 170 棵树主要在学习训练集的细节,而不是可泛化的规律。
结论:本配置下建议早停在第 200 棵附近;进一步提升需要改特征,而不是加树。"
★ 关键差别:
错的写法把"没拐头"讲成了"拐头"→ 会引导读者去"减复杂度"
对的写法把两件事分开报:
  ① 验证线还在爬(没到顶)     → 想提分要改特征
  ② 开口在扩大(在背训练集)   → 但别再加树了
   ↓
【两句话都对,而且不矛盾 —— 这才是"诚实报告"的样子】
24.6 完整示例与输出
cd code
MPLCONFIGDIR=/tmp/fe-mpl python demos/ch24-early-stop.py
真实输出(节选):
=== ① 先看曲线(温和的配置):验证最优在第几棵树 ===
经典 GBDT 200 棵(lr=0.15, max_depth=3, subsample=0.6)拟合 2.5 s,4500 行拟合 / 1500 行验证

     迭代步      训练 R²      验证 R²        开口
       1    0.25563    0.25487   0.00076
      10    0.91004    0.90624   0.00379
      30    0.96662    0.96252   0.00410
     100    0.97541    0.96842   0.00699
     200    0.98164    0.97131   0.01033   ← 验证最优

=== ② 早停开关:early_stopping=True / False(HistGB,max_iter=2000)===

  early_stopping      实际迭代      训练 R²      测试 R²       耗时
            True        57    0.97184    0.95799     0.9s
           False      2000    0.99880    0.95742    74.9s

迭代数:57 vs 2000(省了 97.2%)
耗时:0.9 s vs 74.9 s(82.3 倍)
训练 R²:0.97184 vs 0.99880(多训把训练分推高了 +0.02695)
测试 R²:0.95799 vs 0.95742(+0.00057)

读法:多训不等于更好。早停用百分之一量级的迭代数拿到【同样甚至略好】的测试分。
⚠️ 别忘了同时看【训练 R²】:训满时训练分被推到 0.99880(比早停高 +0.02695),
   而测试分没有跟着涨 —— 多出来的那些迭代全花在背训练集上了。

=== ③ ⚠️ 验证集从哪来(早停最容易被忽略的前提)===
  ① 按设备切(本 demo 的手动写法):拟合 7996 行 / 验证 8240 行 → 早停在 57 次迭代
  ② 按行随机切(sklearn 内部默认):拟合 13801 行 / 验证 2435 行 → 早停在 57 次迭代

[plots] 图已保存: .../outputs/ch24-early-stop.png
⚠️ 耗时说明:上面这两行耗时(0.9 s / 74.9 s)是在一台被其他任务占满的 8 核机器上实测的(load average > 20)。绝对时间不可复现, 但只要在同一台机器、同一时刻跑,"早停比训满快两个数量级"这个结论是稳的。
本章练习
练习 1:固定同一组超参,只拨 early_stopping 开关
用 11 列安全特征,按设备划分训练/测试(test_size=0.2, random_state=42)。
固定:
HistGradientBoostingRegressor(max_iter=1500, learning_rate=0.05, random_state=42,
                              validation_fraction=0.15, n_iter_no_change=30, tol=1e-4)
只改 early_stopping,记录四项:实际迭代数 / 训练 R² / 测试 R² / 耗时,然后回答 "多训一定更好吗"。
参考答案
out = {}
for early in (True, False):
    m = HistGradientBoostingRegressor(max_iter=1500, learning_rate=0.05, random_state=42,
                                      early_stopping=early, validation_fraction=0.15,
                                      n_iter_no_change=30, tol=1e-4)
    t0 = time.perf_counter()
    m.fit(Xtr, ytr)
    dt = time.perf_counter() - t0
    out[early] = (m.n_iter_, r2_score(ytr, m.predict(Xtr)),
                  r2_score(yte, m.predict(Xte)), dt)
    print(f"{str(early):>6}{out[early][0]:>10}{out[early][1]:>12.5f}"
          f"{out[early][2]:>12.5f}{out[early][3]:>9.1f}s")

print(f"\n迭代数比:{out[False][0] / out[True][0]:.0f} 倍")
print(f"训练 R²:多训把训练分推高了 {out[False][1] - out[True][1]:+.5f}")
print(f"测试 R²:{out[True][2]:.5f} vs {out[False][2]:.5f}"
f" → 差 {out[True][2] - out[False][2]:+.5f}")期望输出:
  early_stopping      实际迭代      训练 R²      测试 R²       耗时
            True        57    0.97184    0.95799     0.9s
           False      1500    0.99812    0.95823   292.2s

迭代数比:26 倍
训练 R²:多训把训练分推高了 +0.02628
测试 R²:0.95799 vs 0.95823 → 差 -0.00024
★ 回答"多训一定更好吗":不一定,而且这次的答案是"多训略微更好但无关紧要"
训练 R²:+0.02628(多训把训练分推高了一大截)
测试 R²:−0.00024(多训反而略低)
   ↓
三个数字放在一起看:
  ① 多训 1443 轮,训练分涨了 0.026
  ② 测试分没涨(−0.00024 在噪声里)
  ③ 耗时涨了 292.2 / 0.9 ≈ 325 倍
   ↓
【多训的收益全部落在训练集上,成本全部落在时间上】
★ 一个必须注意的细节:本次"训满"的测试分略高于早停
0.95823(训满) vs 0.95799(早停)→ 训满高 0.00024
   ↓
⚠️ 不要写成"早停提升了精度"(本章 demo 里早停是 +0.00057)
   ↓
两个方向都可能出现 —— 因为 0.0002 ~ 0.0006 这个量级本来就在噪声里
   ↓
正确的表述:「早停与训满在测试分上无统计差别(|Δ| < 0.001),
             但早停把耗时降了 1~2 个数量级」
   ↓
【把"无差别"如实报出来,比硬说"早停更好"更专业】
★ 一个可以顺手算的"投入产出比"
speedup = out[False][3] / out[True][3]
delta = out[False][2] - out[True][2]
print(f"耗时降 {speedup:.0f} 倍,测试分差 {delta:+.5f}")
if abs(delta) < 0.001:
    print("→ 测试分无统计差别:早停是纯赚(省时间、不损失精度)")
elif delta < 0:
print("→ 训满反而更好:检查早停的耐心值是不是设太小了")期望输出:
耗时降 325 倍,测试分差 +0.00024
→ 测试分无统计差别:早停是纯赚(省时间、不损失精度)
练习 2:为什么"早停的验证集"不能用测试集?
设计一个小实验来演示后果:
- 用训练集内部切出的验证集做早停,记录停止轮数
n1、测试 R²; - 用测试集当验证集做早停(
X_val=Xte, y_val=yte),记录停止轮数n2、测试 R²; - 比较两组结果,并解释"为什么第 2 组的测试分不能拿去汇报"。
参考答案
from sklearn.ensemble import HistGradientBoostingRegressor
from sklearn.metrics import r2_score

# ① 正确:验证集来自训练集内部(sklearn 自动切 15%)
m1 = HistGradientBoostingRegressor(max_iter=1500, learning_rate=0.05, random_state=42,
                                   early_stopping=True, validation_fraction=0.15,
                                   n_iter_no_change=30, tol=1e-4)
m1.fit(Xtr, ytr)
print(f"① 内部验证集:停在 {m1.n_iter_:4d} 轮,测试 R² = "
      f"{r2_score(yte, m1.predict(Xte)):.5f}")

# ② 错误:把测试集当验证集(sklearn 没有这个入口,需要手动循环)
from sklearn.model_selection import GroupShuffleSplit
itr, iva = next(GroupShuffleSplit(n_splits=1, test_size=0.15, random_state=0)
                .split(Xte, yte, groups.iloc[te]))
import numpy as np
curve = []
for n in range(20, 1501, 20):
    m = HistGradientBoostingRegressor(max_iter=n, learning_rate=0.05, random_state=42,
                                      early_stopping=False).fit(Xtr, ytr)
    curve.append((n, r2_score(yte, m.predict(Xte))))
best_n, best_s = max(curve, key=lambda t: t[1])
print(f"② 用测试集挑轮数:最佳 {best_n} 轮,测试 R² = {best_s:.5f}")
print(f" 注意:这个 {best_s:.5f} 是【在测试集上挑出来的最大值】")期望输出(数值会随环境波动):
① 内部验证集:停在   57 轮,测试 R² = 0.95799
② 用测试集挑轮数:最佳  940 轮,测试 R² = 0.95841
   注意:这个 0.95841 是【在测试集上挑出来的最大值】
★ 三个必须看清的点
① 第 ② 组的"最佳轮数"是 940 轮 —— 而第 ① 组只用了 57 轮
为什么差这么多?
  ① 组用的验证集是训练集内部的 15%(2,435 行)
  ② 组用的是测试集(3,743 行,而且是"另一批设备")
   ↓
而且 ② 组的每一轮都【看了测试集】—— 它挑的是 75 个点里的最大值
   ↓
【"最佳轮数"这个结论本身就已经被污染了】
② 第 ② 组的测试分(0.95841)比第 ① 组(0.95799)高 0.00042
这 0.00042 是什么?
  · 不是"更好的模型"——两组用的是同一份训练数据、同一个模型类
  · 是【在 75 个候选中挑最大值】的产物
   ↓
统计学上这叫 selection bias(选择偏差):
  在一批"实际水平相同"的估计里挑最大值,挑出来的必然偏高
③ 最严重的后果不是这 0.00042,而是【测试集作废了】
②组用完测试集之后:
  · 你已经知道"940 轮在这份数据上最好"
  · 这个知识来自测试集
  · 所以你以后不能再声称"0.95841 是没见过的数据上的表现"
   ↓
⚠️ 这个损失【不可撤销】
   你不能说"我只用了一点点"——
   只要参与过选择,就不再干净
   ↓
【拿不可撤销的损失,换一个噪声级别的数字,是最差的交易】
★ 一个正确的替代:用分组 CV 挑轮数(每个数据都参与过训练,但不同时)
from sklearn.model_selection import GroupKFold

cv = GroupKFold(n_splits=3)
curve = []
for n in (30, 60, 120, 250, 500, 1000):
    s = []
    for i_tr, i_va in cv.split(Xtr, ytr, gtr):
        m = HistGradientBoostingRegressor(max_iter=n, learning_rate=0.05, random_state=42,
                                          early_stopping=False).fit(Xtr.iloc[i_tr],
                                                                    ytr.iloc[i_tr])
        s.append(r2_score(ytr.iloc[i_va], m.predict(Xtr.iloc[i_va])))
    curve.append((n, float(np.mean(s)), float(np.std(s))))
    print(f"max_iter={n:5d}  CV R² = {np.mean(s):.5f} ± {np.std(s):.5f}")
best_n, best_s, _ = max(curve, key=lambda t: t[1])
print(f"\n★ 分组 CV 选出的轮数 = {best_n}(CV R² = {best_s:.5f})")
print(f" 拿到测试集上:{r2_score(yte, HistGradientBoostingRegressor(max_iter=best_n, learning_rate=0.05, random_state=42, early_stopping=False).fit(Xtr, ytr).predict(Xte)):.5f}")期望输出:
max_iter=   30  CV R² = 0.93726 ± 0.00412
max_iter=   60  CV R² = 0.95412 ± 0.00138
max_iter=  120  CV R² = 0.95736 ± 0.00090
max_iter=  250  CV R² = 0.95714 ± 0.00032
max_iter=  500  CV R² = 0.95663 ± 0.00041
max_iter= 1000  CV R² = 0.95612 ± 0.00036

★ 分组 CV 选出的轮数 = 120(CV R² = 0.95736)
  拿到测试集上:0.95514
★ 这一次 CV 选出的轮数(120)和早停给出的(57)不一样 —— 这很正常
早停:用"连续 30 轮不涨"的规则提前收手 → 偏保守(57 轮)
分组 CV:在 6 个候选轮数里挑 CV 最高的 → 偏激进(120 轮)
   ↓
两者都不错,因为 60~250 轮的 CV 分差别很小(0.95412 ~ 0.95736)
   ↓
⚠️ 但注意第 ⑦ 行的测试分(0.95514)比早停的 0.95799 低 0.00285
   ↓
这再次说明:**"选轮数"这件事的差异,本身就在噪声里**
   ↓
【工程上的建议】:优先用早停 ——
   它不需要额外跑 K 折、不需要额外的人工判断,而且天然只用训练集内部数据
练习 3:把"早停决策"写成一个函数
写一个函数 early_stop_report(model_factory, Xtr, ytr, Xte, yte, groups=None):
- 分别用
early_stopping=True与False训练同一个模型; - 返回一个字典,含两个配置的
n_iter_/ 训练 R² / 测试 R² / 耗时 /speedup/delta_test; - 并根据
|delta_test|给出建议("早停纯赚" / "训满更好" / "检查耐心值")。
然后用本章 demo 的真实数字验证它。
参考答案
import time

import numpy as np
from sklearn.ensemble import HistGradientBoostingRegressor
from sklearn.metrics import r2_score


def early_stop_report(make_model, Xtr, ytr, Xte, yte, noise=0.001):
    """对比 early_stopping=True / False 的四项记录 + 一句建议。"""
    out = {}
    for early in (True, False):
        m = make_model(early_stopping=early)
        t0 = time.perf_counter()
        m.fit(Xtr, ytr)
        dt = time.perf_counter() - t0
        out[early] = {
            "n_iter": int(m.n_iter_),
            "train": float(r2_score(ytr, m.predict(Xtr))),
            "test": float(r2_score(yte, m.predict(Xte))),
            "seconds": float(dt),
        }
    out["speedup"] = out[False]["seconds"] / out[True]["seconds"]
    out["delta_test"] = out[False]["test"] - out[True]["test"]

    if abs(out["delta_test"]) < noise:
        out["verdict"] = "早停纯赚(省时间、精度无统计差别)"
    elif out["delta_test"] < 0:
        out["verdict"] = "训满更好(检查早停的 n_iter_no_change / tol 是不是太小)"
    else:
        out["verdict"] = "训满略好(差距在噪声附近,看上线成本决定)"
    return out


make = lambda **kw: HistGradientBoostingRegressor(
    max_iter=1500, learning_rate=0.05, random_state=42,
    validation_fraction=0.15, n_iter_no_change=30, tol=1e-4, **kw)

rep = early_stop_report(make, Xtr, ytr, Xte, yte)
for k in (True, False):
    r = rep[k]
    print(f"early_stopping={str(k):5s}  迭代 {r['n_iter']:4d}  "
          f"训练 {r['train']:.5f}  测试 {r['test']:.5f}  {r['seconds']:6.1f}s")
print(f"\n耗时比 {rep['speedup']:.0f} 倍,测试分差 {rep['delta_test']:+.5f}")
print(f"建议:{rep['verdict']}")期望输出:
early_stopping=True   迭代   57  训练 0.97184  测试 0.95799     0.9s
early_stopping=False  迭代 1500  训练 0.99812  测试 0.95823   292.2s

耗时比 325 倍,测试分差 +0.00024
建议:早停纯赚(省时间、精度无统计差别)
★ 这个函数的三个设计要点
① noise 参数显式化(默认 0.001)
"测试分有没有差别"必须有个阈值
   ↓
0.001 是一个经验起点(本数据的分组 CV 折间标准差在 0.0003 ~ 0.005)
   ↓
把它做成参数 → 调用者可以按自己的数据调整
   ↓
【不要硬编码"0.0005 以内就算无差别"这类神奇数字】
② verdict 有三种结果,而不是两种
|Δ| < noise        → 早停纯赚(这是最常见的情况)
Δ < −noise         → 训满更好 → 值得去查早停参数是不是设错了
Δ > +noise         → 训满略好 → 这是一个"便宜的换精度"的决策点
   ↓
⚠️ 第三种最少见,但一旦出现就要认真算成本
   (本数据上 Δ = +0.00024 < 0.001 → 落到第一支)
③ 返回字典而不是只 print
返回结构化数据 → 可以接进实验记录、可以批量跑几十个配置
   ↓
而 print 只能给人看
   ↓
【"能进流水线的报告"比"能看的报告"更有价值】
★ 一个可以直接加进报告模板的行
print(f"| max_iter | 实际迭代 | 训练 R² | 测试 R² | 耗时 |")
print(f"|---|---|---|---|---|")
for k in (True, False):
    r = rep[k]
    print(f"| early_stopping={k} | {r['n_iter']} | {r['train']:.5f} | "
f"{r['test']:.5f} | {r['seconds']:.1f}s |")期望输出:
| max_iter | 实际迭代 | 训练 R² | 测试 R² | 耗时 |
|---|---|---|---|---|
| early_stopping=True | 57 | 0.97184 | 0.95799 | 0.9s |
| early_stopping=False | 1500 | 0.99812 | 0.95823 | 292.2s |
这张表可以直接贴进实验记录 —— 它把"多训的收益"和"多训的成本"并排放在一起, 读者一眼就能看到 26 倍的迭代数换来了多大(或者多小)的收益。
面向工程实践:早停是"性价比最高的一个参数"
① 为什么它值得"默认打开"
| 维度 | 早停 |
|---|---|
| 代码成本 | 一个参数(early_stopping=True) |
| 数据成本 | 训练集的 15%(这部分不能参与训练) |
| 收益 | 耗时降 1~2 个数量级;常常顺带略微提精度 |
| 风险 | 几乎没有(只要验证集切得对) |
★ 对照其他手段:
早停    :几乎免费,收益稳定(省时间)
正则化  :很便宜,收益不确定(本数据上千分之一)
加数据  :很贵,收益取决于"验证线是否还在涨"
改特征  :很贵,收益最大(本数据 0.04 量级)
调参    :中等成本,收益最小(第 27 章)
   ↓
【早停是唯一一个"无脑打开也不亏"的选项】
② 一份实验记录模板
## 实验 024:早停 vs 训满(11 列安全特征 + HistGB)

- 划分:GroupShuffleSplit(test_size=0.2, random_state=42) → 训练 16,236 / 测试 3,743
- 配置:max_iter=2000, lr=0.05, validation_fraction=0.15, n_iter_no_change=30, tol=1e-4

| early_stopping | 实际迭代 | 训练 R² | 测试 R² | 耗时 |
|---|---|---|---|---|
| True | 57 | 0.97184 | 0.95799 | 0.9 s |
| False | 2000 | 0.99880 | 0.95742 | 74.9 s |

### 结论
- ✅ **采用早停**:迭代数省 97.2%,耗时省 82 倍,测试分无统计差别
- ⚠️ 验证集来源:sklearn 内部按【行】随机切 15%(本数据上两种切法碰巧同为 57 轮,
  但这是巧合,见第 24.4 节)—— 换设备差异更大的数据时必须改用 GroupKFold
- ⚠️ 耗时数据来自一台被其他任务占满的 8 核机器(load > 20),
  绝对时间不可复现,比值可复现
★ 这份记录里最值钱的是"验证集来源"那一条
它主动暴露了一个【已知的不严谨之处】
   ↓
六个月后有人把这份代码用到别的数据上
   → 会看到这条警告,改用 GroupKFold
   ↓
【记录"我哪里不确定",比记录"我很确定"更有价值】
③ 早停与"学习曲线"的分工
学习曲线(上一本第 21 章)
  横轴:训练样本数 → 回答"数据够不够" → 结论往往是"够,该改特征"
早停(本章)
  横轴:迭代轮数 → 回答"训到哪停" → 结论往往是"停在第 N 轮"
   ↓
两者都不需要碰测试集,两者的成本都是一次训练
   ↓
【它们共同构成本书"在模型侧做诊断"的完整工具箱】
④ 本章的位置
第 23 章 → 诊断:开口大不大、在不在扩大
第 24 章 → 治疗(时间维):早停                    ← 本章
第 25 章 → 治疗(结构维):L1 / L2 / max_depth
第 26 章 → 流程:怎么系统地搜这些旋钮
第 27 章 → 收口:这些旋钮一共能动多少
本章是"模型侧"的第一个治疗手段 —— 也是性价比最高的一个。