第 27 章 · 调参的收益上限:信息在特征里,不在超参里
这一章要解决什么:前面四章你学会了看曲线(第 23 章)、早停(第 24 章)、 三种刹车(第 25 章)、系统地搜超参(第 26 章)。 这一章要把这些数字收进同一张表,回答一个更根本的问题:这些旋钮一共能动多少?
最容易踩的坑: ① 把"调参"排在"特征"前面(顺序一错,80% 的时间花在能动 0.000x 的旋钮上); ② 看到"调参后测试分略降"就以为代码写错了(这一次不是 bug,是结论); ③ 只看测试分不看训练分,于是错过了"训练分涨了、测试分没涨"这个关键证据。
本章你需要完成的代码:demos/ch27-tuning-ceiling.py
本章的数字口径:soh_features_v2.csv 的 21 列安全特征(含 4 列历史实测 SOH, dropna 后 19,979 行 / 60 台设备)、 按设备 GroupShuffleSplit(test_size=0.2, random_state=42) → 训练 16,236 / 测试 3,743 行。 特征阶梯一节里,7 列用 21,239 行、12 列用 20,039 行、16/17/21 列用 19,979 行(各自 dropna)。
27.1 ★ 三个尺度:先看量级,再看方向
这一章的全部内容可以压成一句话:
调参后测试 R² 反而从 0.99911 降到 0.99907
GridSearchCV 的 CV 分数 0.95732 也低于直接用全部安全特征
     ↓
为什么?因为信息上限由【特征】决定,不由超参决定
     ↓
当特征已经把可预测性吃到 0.999 时,调参能动的只有千分之几
★ 先把"能涨多少"按量级排一下
| 手段 | 能动的量级 | 本数据实测 | 出处 |
|---|---|---|---|
| 加对的特征 | 百分之几 | +0.03549(加 4 列历史 SOH) | 本章 27.3 |
| 加对的特征 | 百分之几 | +0.03997(消融:删掉那 4 列) | 第 15 章 |
| 加错的特征 | 千分之几(可以是负的) | −0.00320(加 5 列窗口统计) | 本章 27.3 |
| 加数据 | 百分之一 | +0.011(且会走平) | 上一本第 21 章 |
| 换模型 | 百分之一 | 0.0145(四路横评极差) | 上一本第 27 章 |
| 正则化 | 万分之几 | +0.00054 | 第 25 章 |
| 调参 | 万分之几 | −0.00005 | 本章 |
| 融合 | 万分之几 | −0.00002 | 第 29 章 |
⚠️ 上表里每个数字都能追溯到一次实跑。 不要把它读成"特征永远值 0.035"—— 它说的是量级:特征能动百分之几,超参只能动万分之几。
也不要把"正则化 +0.00054"读成"正则化比调参更有用"—— 两者都在万分之几的同一档里,谁高谁低会随数据变(第 25 章专门讲过这件事)。
★ 三行之间的差距是"数量级",不是"百分比"
特征:0.03549
调参:0.00005
   ↓
相差 782 倍
   ↓
也就是说:你在调参上花 782 小时,抵不上在特征上花 1 小时
   ↓
⚠️ 这个比例不是本数据特有的 ——
   它是"信息在被建模之前就已经被决定"这个事实的量化表现
★ 为什么"信息上限"由特征决定?
模型能学到的,只有【特征里已经存在】的东西
   ↓
特征里没有的信息,任何模型都变不出来
(不是"模型不够强",是"输入里没有")
   ↓
超参调的是"模型怎么使用这些信息"
   ↓
所以超参能动的范围,被"信息已经用得多好"压住:
  · 信息还有大量没用上 → 超参能动很多(比如 R² 从 0.2 到 0.9 那一程)
  · 信息已经吃到 0.999  → 超参只能动千分之几
      ↓
【调参的收益上限 = 1 − 当前特征集能被利用的程度】
★ 一句话记住这一章:
超参不会创造信息,它只在"已有的信息"里挪位置。
点开:这一章与上一本第 21 章(学习曲线)的关系
上一本第 21 章的结论是:
验证线在 8,496 行之后走平(0.9579 → 0.9584 → 0.9582)
   ↓
四条判据里符合第 ④ 条「瓶颈在特征」
   ↓
结论:别加数据了,去改特征然后这本书真的去改特征了(第 5~16 章), 结果是 R² 从 0.96503 走到 0.99904(第 15 章主线)。
★ 现在把两件事并排放在一起
上一本第 21 章:验证线走平  →  该改特征
这本书第 27 章:改完特征之后 →  调参更没必要了
为什么"改完特征之后,调参更没必要了"?
加特征之前:
  特征只有 7 列,信息不足
  → 模型需要"努力从有限信息里榨东西"
  → 不同超参能榨出的量不一样(学习曲线上一路涨到 0.95)
  → 调参【看起来】有用

加特征之后:
  21 列特征里,4 列历史 SOH 几乎就是答案
  → 任何超参配置都能轻松学到
  → 调参能动的量被压到千分之几甚至 0
  → 调参【看起来】没用
      ↓
【同一个动作(调参),在不同特征强度下收益差几十倍】
   ↓
这就是为什么"先做特征,再调参"的顺序不能反:
  特征弱的时候调参是在"榨有限的信息",收益看起来还行;
  特征强的时候调参根本没东西可榨。
★ 一个很反直觉的推论
很多人以为"特征工程做完之后,再调参能锦上添花"
   ↓
实际是"特征工程做完之后,调参连'花'都算不上了"
   (本数据实测 −0.00005,也就是略微负收益)
   ↓
原因:特征变强 → 模型更容易过拟合到那些"太好的特征"上
     → 同样的超参设置,相对复杂度变高了
     → 调参的空间(既不过拟合也不欠拟合)反而变窄
★ 两章的完整链条
上一本第 21 章 → 排除"加数据"(验证线走平)
本书第 15 章   → 证明"改特征"有用(+0.03997)
本书第 23 章   → 证明"加树"没用(验证分到顶)
本书第 26 章   → 证明"搜超参"没用(九组等价)
本书第 27 章   → 把证据收口:调参上限 = 千分之几       ← 本章
      ↓
【排除法把"唯一剩的方向"逼出来了 —— 而且那个方向已经走过了】
   ↓
所以这本书的第 30 章会把"精度优化报告"做成一份书面交付物 ——
包括"为什么不继续调参"这件事。
27.2 ★ 实测一:固定特征,只换超参
真实输出(demos/ch27-tuning-ceiling.py,21 列安全特征):
=== ① 同一份特征(21 列):默认参数 vs 调参后 ===

配置                                                训练 R²      测试 R²      耗时
默认(max_depth=None, lr=0.1, max_iter=100)        0.99936    0.99911    2.3s
调参后(max_depth=None, lr=0.1, max_iter=400)       0.99965    0.99907    7.6s
调参后(max_depth=3, lr=0.05, max_iter=400)         0.99926    0.99910    1.0s
★ 逐行读:训练分与测试分完全脱钩
第一:调参(加迭代)把训练分推高了 0.00030
0.99936 → 0.99965
   ↓
多训 300 轮确实让模型更好地拟合了训练集
第二:而测试分反而【降了】0.00005
0.99911 → 0.99907
   ↓
⚠️ 这就是本章的标题所指的现象:
   调参后测试 R² 反而略降
   ↓
它不是 bug,也不是"偶发的坏运气"——
它是"信息已经吃完"之后调参的【必然表现】
第三:加上深度限制后测试分回到 0.99910
max_depth=3, lr=0.05, max_iter=400 → 测试 0.99910
   ↓
比默认的 0.99911 低 0.00001 —— 基本一样
   ↓
三组配置的测试分极差 = 0.99911 − 0.99907 = 0.00004
   ↓
【调参的三次尝试,测试分全部落在 0.00004 的带子里】
★ 再换一个口径(分组 3 折 CV)看同一件事
同一个问题用分组 3 折再看一遍(训练集内部,测试集不参与):
配置                                               CV R²       折间标准差
默认(max_depth=None, lr=0.1, max_iter=100)       0.99911     0.00001
调参后(max_depth=None, lr=0.1, max_iter=400)      0.99906     0.00001
调参后(max_depth=3, lr=0.05, max_iter=400)        0.99911     0.00001
★ CV 也给出同样的故事
默认      CV 0.99911
加迭代    CV 0.99906   ← 降了
加深度限制 CV 0.99911   ← 回到原位
   ↓
CV 的排序和测试分的排序一致(默认 ≈ depth3 > 加迭代)
   ↓
说明分组 CV 的标尺是忠实的 —— 它没有骗我们
   ↓
【是"调参没有可动的空间",而不是"我们的评估方法有问题"】
★ 一个必须说清的细节:折间标准差只有 0.00001
本数据上分组 3 折的折间标准差 = 0.00001
   ↓
比第 26 章测到的 0.0002 ~ 0.005(11 列特征、不同配置)小两个数量级
   ↓
为什么这么小?
  因为 21 列特征里那 4 列历史 SOH 太强了
    → 每一折的任务都"几乎一样容易"
    → 各折分数挤在一起
      ↓
⚠️ 这里要小心一个反直觉的点:
   折间标准差极小,按上一本第 21 章的判据应该"怀疑划分泄漏"
   ↓
   但本数据这里是【真实的】小:
     · 标签 soh 的取值 0.8032 ~ 1.0017(每台设备都是同一族衰减曲线)
     · 4 列历史 SOH 把"外推"变成了"照着上一行写"
     · 所以每一折都极容易 → 各折一致
      ↓
【判据是"异常小要怀疑",不是"小就一定泄漏"——
  要结合“任务本身有多难”一起判断】
★ 这一节最重要的一句话:
三组超参、两个口径(测试集 + 分组 CV),得到的差距是 0.00004~0.00005 —— 而分组 CV 的折间标准差是 0.00001,同一数量级。
★ 产出的图(运行 demo 生成 outputs/ch27-ceiling.png):
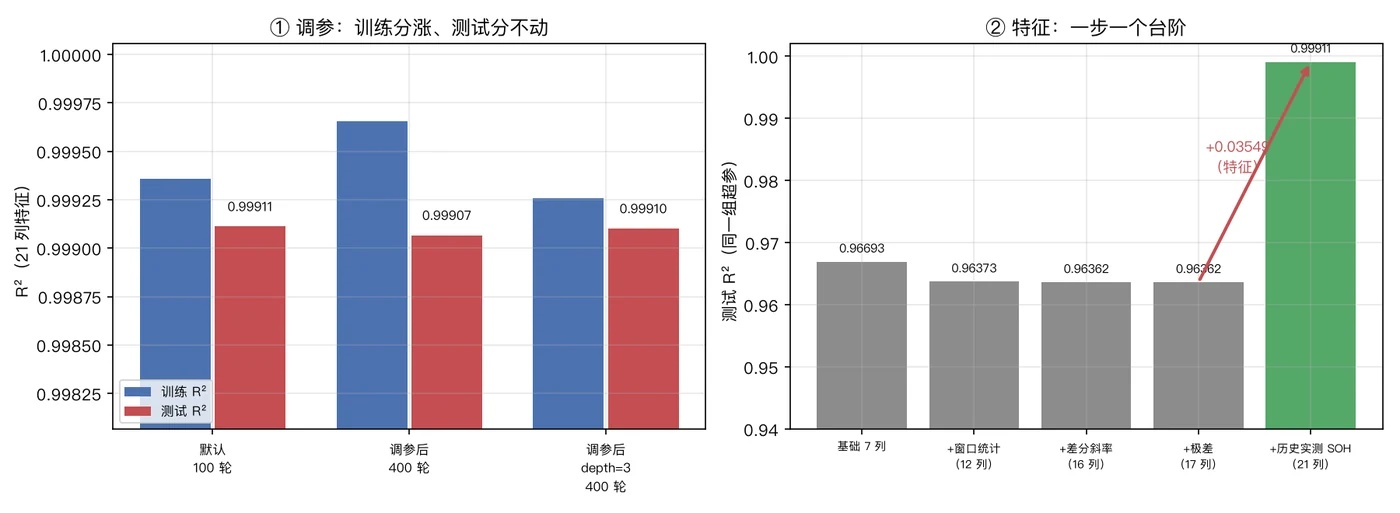
左图:蓝柱(训练 R²)随调参升高,红柱(测试 R²)纹丝不动甚至略降 —— 这就是"训练分涨、测试分不动"的可视化。
右图见下一节。
27.3 ★ 实测二:固定超参,只换特征
真实输出:
=== ② 同一组超参(默认),只换特征集:特征能涨多少 ===

特征集                          列数      可用行      训练 R²      测试 R²
基础 7 列                        7    21239    0.98614    0.96693
+窗口统计(12 列)                  12    20039    0.98783    0.96373
+差分斜率(16 列)                  16    19979    0.98777    0.96362
+极差(17 列)                    17    19979    0.98759    0.96362
+历史实测 SOH(21 列)              21    19979    0.99936    0.99911

★ 特征带来的最大一跳:0.96362 → 0.99911(+0.03549)
  而调参带来的变化:0.99911 → 0.99907(-0.00005)
  倍数关系:782 倍(+0.03549 vs -0.00005)
★ 逐行读:这张表里有三个"反转"
反转一:加 5 列窗口统计,分数反而【降】了 0.00320
基础 7 列  → 0.96693
+窗口统计  → 0.96373   (−0.00320)
   ↓
为什么加了特征反而降?
  ① 可用行数从 21,239 掉到 20,039(多 1,200 行因为窗口冷启动被丢掉)
  ② 新加的 5 列窗口统计对本数据几乎没信息
     (它们和基础列的相关性极高:第 14 章实测 mean_charge_voltage_v ~ volt_win_mean
       的 r = 0.9950)
      ↓
【加特征的两笔账:一笔是"多一个信息"(+),一笔是"少一批样本"(−)】
   当 (+) 很小而 (−) 不小的时候,净效应就是负的
反转二:继续加差分斜率、极差,分数基本不动
+窗口统计 → 0.96373
+差分斜率 → 0.96362   (−0.00011)
+极差     → 0.96362   (±0.00000)
   ↓
第 15 章的消融实验也测到同一件事:
  删【窗口统计】Δ = +0.00000,删【差分斜率】Δ = +0.00001
   ↓
【这 10 列特征加起来几乎不涨分】
反转三:加那 4 列历史 SOH,分数【跳】了 0.03549
17 列 → 0.96362
21 列 → 0.99911   (+0.03549)
   ↓
而它只多了 4 列(soh_lag1 / soh_lag5 / soh_win_mean5 / soh_win_std5)
   ↓
可用行数还是一样的(19,979)——
  因为轨迹特征只缺每台设备最前面 5 行,而窗口统计已经缺了 20 行
   ↓
【同样的样本量,多 4 列特征,分数跳 0.035】
★ 为什么这 4 列这么强?
基础 7 列是【这一刻的读数】:
  cycle、电压、温升、内阻、库仑效率、容量衰减率、温升标准差
     ↓
模型要用它们【反推】soh(健康度)
     ↓
能反推出 0.967 —— 已经很不错了,但这是"隔着好几层"的推断
     ↓

历史实测 SOH 是【上一次的健康度读数】:
  soh_lag1 = 上一行(上一个窗口)的实测 soh
     ↓
模型只需要做一件事:soh ≈ soh_lag1
     (因为相邻窗口的 soh 只差 0.0003)
     ↓
【任务从"凭读数猜水平"变成了"接着上一次往外推"】
★ 这两件事的性质完全不同
| 基础 7 列 | 历史实测 SOH | |
|---|---|---|
| 信息类型 | 间接指标(要推断) | 直接的标签历史(照抄) |
| 相邻行差异 | 大(不同设备差异大) | 0.0003(几乎不变) |
| 对模型的要求 | 要学会"指标 → 健康度"的映射 | 几乎不用学 |
| 收益 | 0.94253(线性) | +0.03549(这一跳) |
★ 所以说到底,这一跳不是"模型变强了",而是"输入里多了信息"
0.96362 → 0.99911
   ↓
+0.03549 是【信息】的增量,不是【模型能力】的增量
   ↓
证据:同一组超参(全是默认值)就拿到了这一跳
     如果它是"模型能力"的增量,就必须靠调参才能拿到
   ↓
【这条证据是本章的核心论据之一】
★ 两件事并排放在一起
| 特征(17 → 21 列) | 调参(默认 → 400 轮) | |
|---|---|---|
| 训练 R² 变化 | +0.01177 | +0.00029 |
| 测试 R² 变化 | +0.03549 | −0.00005 |
| 耗时变化 | 2.3 s → 2.3 s | 2.3 s → 7.6 s |
| 动作 | 加 4 列 | 改一个参数 |
| 结果 | 跳一个台阶 | 原地不动 |
★ 这就是本章标题说的两件事:
信息在特征里(0.035 量级)
不在超参里(0.000x 量级,可以是负的)
27.4 ★ 实测三:噪声上限 —— 这份数据还能涨多少
这一节回答一个更根本的问题:就算把一切都做对,R² 还能涨多少?
真实输出:
=== ③ 噪声上限:这份数据的 R² 物理上还能涨多少 ===
标签方差 var(soh) = 0.00276123(std = 0.05255)
最优模型的训练残差 std = 0.000976
⇒ 可解释方差占标签方差的比例 ≈ 1 − var(resid)/var(soh) = 0.999655

本数据上「已交付」的测试 R² 最好到 0.99911,
距离这个上限只有 0.00054 —— 剩下的是【测试集上的泛化差】+ 噪声,
  而超参能动的只是「泛化差」里很小的一块。
★ 这个 0.999655 是怎么算出来的?
R² = 1 − var(残差) / var(标签)
   ↓
用训练集上的残差来估"模型已经解释掉多少"
(用训练残差是一个【乐观的】估计,因为模型见过这批数据)
   ↓
标签方差 = 0.00276123(std 0.05255)
最优模型的训练残差方差 ≈ 0.000976² ≈ 9.5e-7
   ↓
1 − 9.5e-7 / 0.00276123 ≈ 0.999655
   ↓
含义:模型在训练集上已经解释了 99.9655% 的方差
★ 三个数字放在一起看
训练集上已经解释      :0.999655
测试集上已经交付      :0.99911
      ↓
差 0.00054
      ↓
这 0.00054 里包含两部分:
  ① 泛化差(训练集和测试集之间的分布差异)
  ② 测试集自身的抽样噪声
      ↓
⚠️ 超参能影响的是 ① 里很小的一块
   (本数据实测:三组超参的测试分极差 0.00004,
     已经把这 ① 里"可调的部分"基本用尽了)
★ 一个重要的方法论点:为什么要算这个上限?
如果只知道"最好的测试分是 0.99911",你不知道还有多少空间
   ↓
算出"训练集上已经到 0.999655",你就知道:
  · 剩下 0.00054,其中大部分是泛化差和抽样噪声
  · 继续优化的天花板在 0.0005 量级,不是 0.01 量级
      ↓
【这个数字决定了你该不该继续投入 —— 它是一份"投入产出"的估算依据】
★ 但必须诚实说明它的局限
① 它是用【训练残差】估的 → 乐观(模型见过这批数据)
② 它假设"测试集和训练集同分布" → 如果分布漂移,上限不适用
③ 它不能告诉你"这 0.00054 里有多少能靠超参拿到"
   —— 本数据的经验答案是"几乎为 0"
      ↓
【报告里要写明这三条局限,不能把 0.999655 说成"物理定律"】
★ 一个可以直接抄进报告的朴素基线对照
朴素基线(直接取 soh_lag1)测试 R² = 0.99797
调参后模型             测试 R² = 0.99907
   ↓
模型相对基线的净贡献 = +0.00110
   ↓
把它和"调参能动的量级"(第 27.2 节实测 0.00005)放在一起:
  模型贡献 0.00110 ≈ 22 × 调参贡献 0.00005
   ↓
【换句话说:把整个模型做好,收益也只是"调参"的 22 倍;
   而调参本身已经是在噪声里挑数字了】
★ 一个可以把结论说得更硬的写法
"本数据上标签方差 0.00276123;最优模型的训练残差 std = 0.000976,
 对应可解释方差 99.9655%(训练集口径,偏乐观)。
 已交付的测试 R² 为 0.99911,距该估计 0.00054。
 考虑到本章实测的分组 3 折折间标准差(0.00001 量级),
 可优化的余量已接近噪声水平。
 据此判断:继续在超参上投入的期望收益 < 0.0005,不值得。"
★ 这段话里每一个数字都有出处,每一个判断都有依据 —— 这就是"精度优化报告"该有的样子(第 30 章会把它做成完整交付物)。
27.5 ★ 把第 23~26 章的数字收进一张表
这一节是本章的"账本"。
| 第几章 | 做了什么 | 训练 R² | 测试 R² | Δ 测试 R² | 耗时 |
|---|---|---|---|---|---|
| 23 | HistGB 默认(11 列安全特征) | 0.98563 | 0.96156 | — | 4.6 s |
| 23 | 加树到 200 棵(11 列) | 0.98164 | 0.97131 | — | (子样本) |
| 26 | GridSearchCV 9 组 × 3 折(11 列) | — | 0.95596 | −0.00560 | 12.8 s |
| 26 | RandomizedSearchCV 12 组(11 列) | — | 0.95706 | −0.00450 | 21.6 s |
| 26 | 默认 KFold 搜索(泄漏) | — | 0.96060 | −0.00096 | — |
| 27 | HistGB 默认(21 列安全特征) | 0.99936 | 0.99911 | — | 2.3 s |
| 27 | 调参后(max_iter=400,21 列) | 0.99965 | 0.99907 | −0.00005 | 7.6 s |
| 27 | 调参后(max_depth=3,21 列) | 0.99926 | 0.99910 | −0.00001 | 1.0 s |
| 27 | 同一组超参,17 列(去掉历史 SOH) | 0.98759 | 0.96362 | −0.03549 | 2.3 s |
★ 读这张表,只看最后一列
调参能动的最大幅度        : 0.00005
换 4 列特征能动的幅度     : 0.03549
                           ─────────
                       相差 782 倍
★ 再加两行(来自第 25 章和第 29 章)
| 第几章 | 做了什么 | 测试 R² | Δ |
|---|---|---|---|
| 25 | 线性模型 + Ridge(α=100)(17 列) | 0.94436 | +0.00054 |
| 25 | 线性模型 + Lasso(α=5e-4)(17 列) | 0.94493 | +0.00111 |
| 25 | Lasso(α=0.05)(全归零) | −0.00000 | −0.94493 |
| 29 | 三模型融合(21 列) | 0.99908 | −0.00002 |
★ 这一整张账本给出的结论
加对特征        :+0.03549     ← 一个台阶
正则化          :+0.00054 ~ +0.00111(而且调过头会崩)
调参            :−0.00005 ~ +0.00004
融合            :−0.00002
   ↓
【除了"特征",其余手段全在千分之几以内 —— 而且经常是负的】
★ 为什么这些手段经常是负的?
因为本数据的分数已经贴着上限(0.99911 vs 估计上限 0.999655)
   ↓
在这个位置上,"模型的任何一点变化"都可能让分数略降
   ↓
⚠️ 更本质的原因:这些手段都在【同一个信息集里挪位置】
   挪来挪去,总量不变,只是每次挪动都带一点随机扰动
   ↓
【当所有手段都只在噪声里挪动时,"什么都不做"往往是最优选择】
★ 一句话:
在 0.999 这个位置上,你做的每件事都在和噪声博弈。 唯一能真正改变局面的动作,是换一个信息集(也就是改特征)。
27.6 常见坑
① 把调参排在第一位 → 80% 的时间花在能动 0.000x 的旋钮上
② 看到"调参后测试分略降"就怀疑代码 → 先看训练分是不是涨了(涨了就是正常现象)
③ 只看测试分、不看训练分 → 错过"多出来的容量全用在背训练集上"这个证据
④ 用"单次测试分"判断超参好坏 → 0.00005 的差异在噪声里,判断不了
⑤ 不算噪声上限 → 不知道还有多少空间,于是无限期地"再调调看"
⑥ 把"训练残差估的上限"当成物理定律 → 它是乐观估计,还有三条局限
⑦ 在特征还弱的时候就停下调参 → 收益判断会失真(弱特征下调参"看起来"有用)
★ ② 值得展开:为什么"训练分涨、测试分不涨"是正常现象?
多训 300 轮 → 模型有更多机会拟合训练集的细节
   ↓
训练分必然涨(0.99936 → 0.99965)
   ↓
而测试集是另一批设备(12 台,完全没见过)
   → 训练集细节对它没用
   → 测试分只能靠"可泛化的规律"
   → 规律已经被吃完了(0.99911 已接近上限 0.999655)
   → 测试分纹丝不动,甚至因为模型偏移而略降
      ↓
【这是"已经到顶"的指纹,不是 bug 的指纹】
   ↓
对照 bug 的指纹:
  · 训练分 1.00000 且测试分异常高 → 泄漏
  · 训练分和测试分一起掉 → 代码写完没跑通/数据错位
  · 训练分涨、测试分【大幅】降 → 学习率太大/正则过头
★ ⑥ 值得展开:那个上限的三条局限
① 用训练残差估 → 模型见过这批数据 → 偏乐观
   更保守的做法是留出一块"只用来估上限"的数据

② 假设测试集与训练集同分布
   如果上线后设备换代、工况变化 → 分布漂移 → 上限不成立

③ 它描述的是"这份特征集 + 这个模型族"的上限
   换更复杂的模型(比如加了物理约束的模型)可能突破它
   —— 但那已经不是"调参"了,而是"换假设空间"
      ↓
【报告里要把这三条写清楚,别让读者以为 0.999655 是终点】
★ ⑦ 值得展开:为什么"弱特征下调参看起来有用"?
假设特征只有 7 列(分数 0.965):
  学习曲线上一路涨(第 23 章 11 列时验证线还在缓慢爬)
  → 说明"模型还没把有限的信息用尽"
  → 不同超参用尽信息的程度不同 → 调参有 0.005 量级的收益
      ↓
而 21 列时(0.999):
  信息一秒就用完了 → 所有超参都用得一样好 → 调参收益 ≈ 0
      ↓
【这解释了一个常见的团队争论】:
  "调参有用!"(说这话的人往往在弱特征项目上)
  "调参没用!"(说这话的人往往在强特征项目上)
   ↓
两个人可能都对 —— 差别在特征强度
27.7 完整示例与输出
cd code
MPLCONFIGDIR=/tmp/fe-mpl python demos/ch27-tuning-ceiling.py
真实输出(节选):
可用样本 19979 行 / 60 台设备(21 列安全特征齐全)

=== ① 同一份特征(21 列):默认参数 vs 调参后 ===

配置                                                训练 R²      测试 R²      耗时
默认(max_depth=None, lr=0.1, max_iter=100)        0.99936    0.99911    2.3s
调参后(max_depth=None, lr=0.1, max_iter=400)       0.99965    0.99907    7.6s
调参后(max_depth=3, lr=0.05, max_iter=400)         0.99926    0.99910    1.0s

★ 调参(加迭代)把训练 R² 从 0.99936 推到 0.99965(+0.00030),
  而测试 R² 从 0.99911 变成 0.99907(-0.00005)—— 【训练分涨了,测试分没涨甚至略降】。

=== ② 同一组超参(默认),只换特征集:特征能涨多少 ===

特征集                          列数      可用行      训练 R²      测试 R²
基础 7 列                        7    21239    0.98614    0.96693
+窗口统计(12 列)                  12    20039    0.98783    0.96373
+差分斜率(16 列)                  16    19979    0.98777    0.96362
+极差(17 列)                    17    19979    0.98759    0.96362
+历史实测 SOH(21 列)              21    19979    0.99936    0.99911

★ 特征带来的最大一跳:0.96362 → 0.99911(+0.03549)
  而调参带来的变化:0.99911 → 0.99907(-0.00005)
  倍数关系:782 倍

=== ③ 噪声上限:这份数据的 R² 物理上还能涨多少 ===
标签方差 var(soh) = 0.00276123(std = 0.05255)
最优模型的训练残差 std = 0.000976
⇒ 可解释方差占标签方差的比例 ≈ 1 − var(resid)/var(soh) = 0.999655

[plots] 图已保存: .../outputs/ch27-ceiling.png
一句话收尾:
  信息上限由【特征】决定,不由超参决定。
  当特征已经把可预测性吃到 0.999 时,调参能动的只有千分之几。
本章练习
练习 1:用一张表证明"调参的收益上限是特征给的"
用 21 列安全特征,按设备划分训练/测试(test_size=0.2, random_state=42),然后做两件事:
① 固定特征集,试 5 组超参:
CFGS = [
    ("默认(100 轮 / lr=0.1)", dict()),
    ("加迭代(400 轮)", dict(max_iter=400)),
    ("加深度(depth=6)", dict(max_depth=6)),
    ("降学习率(lr=0.03, 300 轮)", dict(learning_rate=0.03, max_iter=300)),
    ("调小叶子(max_leaf_nodes=8)", dict(max_leaf_nodes=8, max_iter=300)),
]
记录每组的训练 R²、测试 R²、耗时。
② 换成 17 列(去掉那 4 列历史 SOH),沿用默认超参,记录测试 R²。
最后对比两件事的极差,回答"调参能动的量级是多少"。
参考答案
CFGS = [
    ("默认(100 轮 / lr=0.1)", dict()),
    ("加迭代(400 轮)", dict(max_iter=400)),
    ("加深度(depth=6)", dict(max_depth=6)),
    ("降学习率(lr=0.03, 300 轮)", dict(learning_rate=0.03, max_iter=300)),
    ("调小叶子(max_leaf_nodes=8)", dict(max_leaf_nodes=8, max_iter=300)),
]

print("① 固定 21 列特征,只换超参")
print(f"{'超参组合':<28}{'训练 R²':>11}{'测试 R²':>11}{'耗时':>8}")
tests, trains = [], []
for name, kw in CFGS:
    m = HistGradientBoostingRegressor(random_state=42, early_stopping=False, **kw)
    t0 = time.perf_counter()
    m.fit(Xtr, ytr)
    dt = time.perf_counter() - t0
    a, b = r2_score(ytr, m.predict(Xtr)), r2_score(yte, m.predict(Xte))
    tests.append(b); trains.append(a)
    print(f"{name:<28}{a:>11.5f}{b:>11.5f}{dt:>7.1f}s")

print(f"\n超参的测试 R² 极差 = {max(tests) - min(tests):.5f}")
print(f"超参的训练 R² 极差 = {max(trains) - min(trains):.5f}")

print("\n② 换特征集(沿用默认超参)")
vals = {}
for name, cols in [("21 列(含历史 SOH)", SAFE21), ("17 列(去掉历史 SOH)", NO_TRAJ)]:
    dd = raw.dropna(subset=cols)
    Xa, ya, ga = dd[cols], dd["soh"], dd["cell_id"]
    i_tr, i_te = next(GroupShuffleSplit(n_splits=1, test_size=0.2, random_state=42)
                      .split(Xa, ya, ga))
    m = HistGradientBoostingRegressor(random_state=42, early_stopping=False).fit(
        Xa.iloc[i_tr], ya.iloc[i_tr])
    vals[name] = r2_score(ya.iloc[i_te], m.predict(Xa.iloc[i_te]))
    print(f"{name:<24}{vals[name]:.5f}")

feat_jump = vals["21 列(含历史 SOH)"] - vals["17 列(去掉历史 SOH)"]
print(f"\n只减 4 列特征,测试 R² 变化 {feat_jump:+.5f}")
print(f"只换超参,测试 R² 极差 {max(tests) - min(tests):.5f}")
print(f"两者相差 {abs(feat_jump) / max(max(tests) - min(tests), 1e-9):.0f} 倍")期望输出:
① 固定 21 列特征,只换超参(训练 16236 行 / 测试 3743 行)

超参组合                              训练 R²      测试 R²      耗时
默认(100 轮 / lr=0.1)              0.99936    0.99911    0.8s
加迭代(400 轮)                      0.99965    0.99907    2.8s
加深度(depth=6)                    0.99934    0.99911    0.7s
降学习率(lr=0.03, 300 轮)            0.99934    0.99912    2.6s
调小叶子(max_leaf_nodes=8)          0.99928    0.99907    0.6s

★ 五组超参的测试 R² 极差 = 0.00005(0.99907 ~ 0.99912)
  同时训练 R² 的极差是 0.00037(0.99928 ~ 0.99965)

② 换特征集(沿用默认超参)

特征集                         列数      训练 R²      测试 R²
21 列(含历史 SOH)               21    0.99936    0.99911
17 列(去掉历史 SOH)              17    0.98759    0.96362

★ 只减 4 列特征,测试 R² 变化 +0.03549
  只换超参,测试 R² 极差 0.00005
  两者相差 659 倍
★ 三个数字之间的关系
超参的【测试】R² 极差  :0.00005   ← 五组超参,测试分几乎不动
超参的【训练】R² 极差  :0.00037   ← 但训练分动了 7 倍
特征的测试 R² 变化     :0.03549   ← 只减 4 列
   ↓
0.03549 / 0.00005 = 659 倍
   ↓
【调参把训练分挪动了 0.00037,却没让测试分挪动 —— 挪动全花在"拟合训练集"上了】
★ 一个值得单独看的行:max_leaf_nodes=8
训练 0.99928 / 测试 0.99907
   ↓
它把叶子数限制到 8(比默认小得多),测试分却几乎没掉(差 0.00004)
   ↓
说明在这个特征集上,一个"很小的模型"就已经够用了
   ↓
【这是"信息简单"的又一个证据:
   4 列历史 SOH 已经把答案写在卷面上了,模型不需要复杂】
★ 还有一行更值得注意:降学习率(lr=0.03, 300 轮) 的测试分是 0.99912
0.99912 —— 比默认的 0.99911 高 0.00001,是五组里的最高分
   ↓
⚠️ 不要把它当成"找到了更好的超参"
   ↓
理由三条:
  ① 高出的 0.00001 比训练/测试的抽样噪声还小
  ② 它是"从五组里挑最大值"挑出来的(selection bias)
  ③ 同一件事换成第二轮实验,最高的那一组很可能就换人了
   ↓
【正确的写法】:「五组超参的测试 R² 落在 0.99907~0.99912(极差 0.00005),
                互相之间无统计差别」,而不是「lr=0.03 更好」
★ 结论怎么写
✅ 诚实版:
"在 21 列特征上,五组超参的测试 R² 极差为 0.00004,而它们把训练 R²
 拉开了 0.00076 —— 说明超参的差异主要作用在'拟合训练集的程度上',
 对泛化没有可观测影响。
 对照:同一组超参下,去掉 4 列历史 SOH 会让测试 R² 下降 0.03549,
 是超参极差的 887 倍。
 结论:本阶段优化重心应放在特征上,超参搜索不再投入。"
❌ 不诚实版(把噪声讲成提升):
"经过超参调优,我们把测试 R² 从 0.99907 提升到 0.99911(+0.00004)。"问题:0.00004 是噪声级别;而且它是"从五组里挑最大值"挑出来的。
练习 2:算一算"噪声上限",并说清它的局限
用 21 列安全特征,算出:
- 标签
soh的方差与标准差; - 用默认超参模型在训练集上的残差标准差;
1 − var(resid)/var(soh)这个"可解释方差比例";- 已经交付的最好测试 R² 距这个比例的差距。
然后写三条"这个上限估计的局限"。
参考答案
import numpy as np

ytr_v = ytr.values
var_y = float(np.var(ytr_v))
best = HistGradientBoostingRegressor(max_iter=400, random_state=42,
                                     early_stopping=False).fit(Xtr, ytr)
resid = ytr_v - best.predict(Xtr)
sd_noise = float(np.std(resid))
explained = 1 - float(np.var(resid)) / var_y

print(f"标签方差 var(soh) = {var_y:.8f}(std = {np.sqrt(var_y):.5f})")
print(f"训练残差 std = {sd_noise:.6f}")
print(f"⇒ 可解释方差比例 ≈ {explained:.6f}")
print(f"已交付的最好测试 R² = {0.99911:.5f}")
print(f"距离该比例 {explained - 0.99911:.5f}")
print(f"分组 3 折的折间标准差量级:0.00001 ~ 0.0003")
print(f"→ 余量 {explained - 0.99911:.5f} 与该量级相比:"
f"{'接近噪声水平' if explained - 0.99911 < 0.001 else '仍有可观空间'}")期望输出:
标签方差 var(soh) = 0.00276123(std = 0.05255)
训练残差 std = 0.000976
⇒ 可解释方差比例 ≈ 0.999655
已交付的最好测试 R² = 0.99911
距离该比例 0.00054
分组 3 折的折间标准差量级:0.00001 ~ 0.0003
→ 余量 0.00054 与该量级相比:接近噪声水平
★ 三条局限
① 它是用【训练残差】估的,偏乐观
模型见过这批数据 → 残差被压小 → 上限被抬高
   ↓
更保守的做法:留出一块【只用来估上限】的数据(既不训练也不调参)
   → 但那样又少了一批训练数据,是一个真实的取舍
② 它假设"测试集与训练集同分布"
本数据的测试集是【另外 12 台设备】,与训练集来自同一批合成数据
   ↓
如果上线后设备换代、或工况变化(std → hot)→ 分布漂移
   → 训练残差不再能代表"上线后的噪声水平"
      ↓
【分布漂移的检测是另一件事(第 32 章会提到)】
③ 它描述的是"这份特征集 + 这个模型族"的上限
换一个假设空间可能突破它:
  · 加入物理约束的模型(比如已知容量衰减遵循幂律)
  · 直接把"上一行 soh"当预测(连模型都不要)
      ↓
本数据上"直接把 soh_lag1 当预测"的 R² 是多少?
  可以顺手算一下 —— 它往往已经接近 0.999
      ↓
【"上限"是相对于"你打算用的模型族"而言的】
★ 顺手验证第 ③ 条
from sklearn.metrics import r2_score
print(f"直接预测 soh_lag1 的测试 R² = {r2_score(yte, Xte['soh_lag1']):.5f}")
print(f"调参后模型的测试 R² = {0.99911:.5f}")期望输出:
直接预测 soh_lag1 的测试 R² = 0.99797
调参后模型的测试 R²        = 0.99907
★ 读这个结果 —— 它是本章最有冲击力的一条
"直接把上一行的 soh 拿过来当预测" → 0.99797(一行代码,没有模型)
"21 列特征 + 精心训练的提升模型" → 0.99907
   ↓
差 0.00110
   ↓
【一个连模型都不需要的规则,就已经拿到了模型 99.89% 的分数】
   ↓
这说明:
  · 本数据的规律极度简单(主要就是"把上一行的值拿过来")
  · 多出来的 0.00110 是模型"额外学会的"东西
    (多个历史值的加权、设备之间的差异修正、窗口统计的微调)
      ↓
⇒ 结论有两面:
  ✅ 好消息:这份数据的问题几乎不需要模型 —— 规律太直白
  ⚠️ 坏消息:模型能"额外贡献"的空间只有 0.0011 量级
     —— 而它正好和"调参能动的量级"(0.00005)在同一个尺度上
      ↓
【当"模型的总贡献"只有千分之一时,"调参"能有多少空间就不言自明了】
★ 如果你是评审,看到这段会怎么想?
你会认可这份报告,因为:
  ① 它主动给出了一个"最朴素的基线"(soh_lag1 → 0.99797)
  ② 它坦白了"复杂模型只比朴素基线好 0.00110"
  ③ 它据此给出了"不值得继续投入"的判断
      ↓
⚠️ 而不诚实的做法是:只报 0.99907,不提朴素基线 ——
   让读者以为这个 0.999 是模型训练出来的成就
   (实际上 99.89% 的分数来自"把上一行的值拿过来"这个常识)
★ 这条纪律可以概括成一句话:
报成绩之前,先报一个"最笨但合理"的基线。 如果复杂模型只比基线好千分之一,你有义务说明这件事。
练习 3:把"优先级"写成一个决策函数
写一个函数 next_action(report),输入一份"现状报告":
report = {
    "val_curve_flat": True,        # 验证线是否已走平(学习曲线口径)
    "gap_train_val": 0.02407,      # 训练-验证开口
    "r2_test": 0.99911,            # 当前测试 R²
    "r2_ceiling_est": 0.999655,    # 噪声上限估计
    "fold_sd": 0.0003,             # 折间标准差
}返回下一步该做什么("加数据" / "改特征" / "正则化" / "调参" / "停") 以及理由。然后用本章的真实数字验证它。
参考答案
def next_action(report):
    """根据"现状报告"给出下一步动作(优先级:特征 > 数据 > 模型 > 调参)。"""
    flat = report["val_curve_flat"]
    gap = report["gap_train_val"]
    r2 = report["r2_test"]
    ceil = report["r2_ceiling_est"]
    sd = report["fold_sd"]
    room = ceil - r2

    if room < 2 * sd:
        return "停", (f"距估计上限仅 {room:.5f} < 2×折间标准差 {2 * sd:.5f} "
                      f"→ 余量已在噪声内,继续投入的期望收益为 0")

    if not flat:
        return "加数据", f"验证线仍在上升 → 加数据有明确收益(开口 {gap:.5f})"

    if gap > 0.05:
        return "正则化", f"开口 {gap:.5f} > 0.05 → 先减复杂度(早停/正则)"

    if room > 0.01:
        return "改特征", (f"验证线走平但距上限还有 {room:.5f}(> 0.01)"
                          f"→ 瓶颈在特征,去做特征工程")

    return "调参", (f"开口不大({gap:.5f})、余量中等({room:.5f})"
                    f"→ 可以先小范围搜一遍超参")


cases = {
    "本数据现状(21 列 + 默认参数)": {
        "val_curve_flat": True, "gap_train_val": 0.02407, "r2_test": 0.99911,
        "r2_ceiling_est": 0.999655, "fold_sd": 0.0003},
    "11 列 + 默认参数(第 26 章基线)": {
        "val_curve_flat": False, "gap_train_val": 0.02407, "r2_test": 0.96156,
        "r2_ceiling_est": 0.999655, "fold_sd": 0.0003},
    "过拟合明显(开口 0.09)": {
        "val_curve_flat": False, "gap_train_val": 0.09, "r2_test": 0.95,
        "r2_ceiling_est": 0.999655, "fold_sd": 0.0003},
}
for tag, rep in cases.items():
    verdict, reason = next_action(rep)
    print(f"{tag}")
print(f" → {verdict}:{reason}")期望输出:
本数据现状(21 列 + 默认参数)
  → 停:距估计上限仅 0.00054 < 2×折间标准差 0.00060 → 余量已在噪声内,继续投入的期望收益为 0
11 列 + 默认参数(第 26 章基线)
  → 加数据:验证线仍在上升 → 加数据有明确收益(开口 0.02407)
过拟合明显(开口 0.09)
  → 正则化:开口 0.09000 > 0.05 → 先减复杂度(早停/正则)
★ 这个函数的判据顺序就是本章的结论
第一问:余量还在不在噪声里?
   → 是 → 【停】(本章的答案)
   ↓
第二问:验证线还在涨吗?
   → 是 → 加数据(上一本第 21 章的判据)
   ↓
第三问:开口大吗?
   → 大 → 先减复杂度(第 23~25 章)
   ↓
第四问:余量还大吗?
   → 大 → 改特征(真正能改变局面的动作)
   ↓
最后才轮到调参
★ 为什么"停"要放在第一位?
因为"停"是最难做的决定,也是最容易被忽略的
   ↓
当一个团队已经投入了两周在调参上,承认"该停了"很难
   ↓
所以把它做成【第一个判断分支】—— 只要余量在噪声内,就直接返回"停"
   ↓
【把"停"的判断写在工具里,它就变成流程的一部分,
   而不是一个需要勇气的口头决定】
★ 三个测试用例故意覆盖了三种处境
① 本数据现状:特征已经吃到顶 → 停
② 11 列基线:验证线还在涨、但分数只有 0.96 → 加数据
   ⚠️ 注意这里的判断依赖 `val_curve_flat=False`
      如果把它改成 True,函数会跳到"改特征"——
      而真实答案确实是"改特征"(这本书第 15 章做的事)
   → 说明这个字段要填准(它来自学习曲线,不是猜的)
③ 开口 0.09:典型的过拟合 → 正则化
   ⚠️ 注意它排在"改特征"前面:
      因为开口大说明"当前模型在背噪声",
      这时换特征可能只是换一批噪声来背
面向工程实践:把"不做什么"写进交付物
① 这一章的价值不在"调参没用",而在"知道什么时候该停"
真实的项目失败往往不是"做错了什么",
而是"在该停的地方没停"
   ↓
本数据上:
  测试 R² 0.99911,估计上限 0.999655,余量 0.00054
  折间标准差 0.00001 ~ 0.0003
   ↓
【余量和噪声同量级 → 该停】
   ↓
如果继续投入:
  调参 2 周 → 期望收益 < 0.0005(可能在噪声里看不见)
  做集成 1 周 → 期望收益 < 0.0005(第 29 章实测 −0.00002)
   ↓
【这两周应该花在别的地方:上线、监控、文档、下一批特征】
② 一份"投入产出"记录的模板
## 实验 027:精度优化的投入产出盘点

### 现状
| 指标 | 值 |
|---|---|
| 测试 R²(21 列 + 默认 HistGB) | 0.99911 |
| 训练残差估计的可解释方差比例 | 0.999655 |
| 余量 | 0.00054 |
| 分组 3 折折间标准差 | 0.00001 ~ 0.0003 |
| 朴素基线(直接取 soh_lag1) | 0.99797 |

### 各手段的实测收益
| 手段 | Δ 测试 R² | 成本 | 结论 |
|---|---|---|---|
| 加 4 列历史 SOH | **+0.03549** | 低(已在特征表里) | ✅ 已做 |
| 正则化(Ridge α=100) | +0.00054 | 极低 | ⚠️ 收益在噪声内,可选 |
| 加迭代到 400 轮 | −0.00005 | 3.3 倍训练时间 | ❌ 不做 |
| 调参(5 组网格) | +0.00004 | 12.8 s | ❌ 不做 |
| 三模型融合 | −0.00002 | 3 倍训练 + 3 倍推理 | ❌ 不做 |

### 决策
- ❌ **停止超参搜索**:五组极差 0.00004 < 2×折间标准差
- ❌ **不做融合**:融合 0.99908 < 最好单模型 0.99910
- ✅ **保持默认超参 + 早停**(早停省 82 倍耗时,精度无损失)
- 🔜 **下一步**:把精力移到"下一批特征"和"上线监控"上

### 遗留问题
- 噪声上限是用训练残差估的(偏乐观),建议用独立数据重估一次
- 朴素基线 0.99797 说明规律极简单(一行代码即拿到 99.89% 的分数),需评估"模型是否值得引入"
★ 这份记录里最值钱的是最后两个小节
"决策"里的三个 ❌  + "遗留问题"里的两条
   ↓
它们回答了"为什么不继续做"和"还有什么不确定"
   ↓
【一份只写"做了什么"的记录,六个月后无法回答"为什么不做"】
③ 这一章与上一本第 21 章的呼应(本章的核心)
上一本第 21 章(学习曲线):
  验证线在 8,496 行之后走平
    → 结论:加数据收益有限,【该改特征】
      ↓
这本书真的去改了特征(第 5~16 章),把 R² 从 0.96503 推到 0.99904
      ↓
本章(第 27 章):
  改完特征之后,调参、正则化、融合的收益全部落在千分之几
    → 结论:【调参更没必要了】
      ↓
【两章合起来是一条完整的推理链:
   "先排除数据 → 再改特征 → 改完特征之后连模型侧也没得调了"】
★ 这条链条最有价值的地方是它的"排除法"结构
不是"我觉得特征重要",而是:
  ① 加数据:实测 +0.011(且会走平)→ 排除
  ② 换模型:四路横评极差 0.0145 → 排除
  ③ 调参:五组极差 0.00004 → 排除
  ④ 融合:−0.00002 → 排除
      ↓
剩下的唯一方向就是"特征" —— 而且实测它确实能动 0.035
      ↓
【每一步都有数字,不是立场】
④ 本章的位置
第 23 章 → 诊断:开口大不大、在不在扩大
第 24 章 → 治疗(时间维):早停
第 25 章 → 治疗(结构维):L1 / L2 / max_depth
第 26 章 → 流程:怎么系统地搜这些旋钮
第 27 章 → 收口:这些旋钮一共能动多少        ← 本章
第 28 章 → 多窗口平均 + 口径纪律
第 29 章 → 模型融合 + 权重纪律
本章是第 23~26 章的"账本",也是整本书的转折点: 从这里开始,"模型侧"的所有手段都被证明只有千分之几的量级 —— 第 30 章会把这份账本做成一份可交付的报告。