第 14 章 · 特征选择:相关性与 k 曲线
这一章要解决什么:21 列安全特征全都能送进模型了(第 13 章)。 但它们全都值得留吗?这一章做两件事: 先看谁和标签相关、谁和谁冗余(相关性地图), 再扫一遍特征数与测试分数(k 曲线),找出"性价比最高的特征数"。
最容易踩的坑: ① 用相关系数筛掉"非线性但有用"的列 ——
|r|只看线性关系; ② 只看分数不看耗时 —— 本数据上 k=3 到 k=21 只涨万分之几,耗时却涨几倍; ③ 在划分之前对全量数据挑特征 —— "选择"这一步用了标签 y(14.5 给出两个口径的实测)。
本章你需要完成的代码:demos/ch14-feature-selection.py
14.1 相关性地图:先看谁和标签有关
真实输出(可用样本 19,979 行):
整表 21,239 行 → 时序特征齐全的可用样本 19,979 行 / 60 支设备
候选特征 21 列:基础 7 + 窗口统计 5 + 差分斜率 4 + 极差 1 + 轨迹 4
划分:按设备 GroupShuffleSplit(test_size=0.2, random_state=42)  训练 16,236 / 测试 3,743

① 21 列与 soh 的皮尔逊相关系数(按 |r| 从大到小)

  soh_win_mean5              +0.9994  ██████████████████████████████
  soh_lag1                   +0.9991  ██████████████████████████████
  soh_lag5                   +0.9990  ██████████████████████████████
  coulombic_eff              +0.9646  █████████████████████████████
  cycle                      -0.8999  ███████████████████████████
  res_win_mean               -0.8712  ██████████████████████████
  resistance_mohm            -0.8673  ██████████████████████████
  temp_std_c                 -0.7890  ████████████████████████
  mean_charge_voltage_v      -0.7875  ████████████████████████
  volt_win_mean              -0.7872  ████████████████████████
  temp_win_mean              -0.7388  ██████████████████████
  mean_temp_rise_c           -0.7351  ██████████████████████
  cap_fade_rate_ah_per_100   -0.4136  ████████████
  res_win_std                -0.3611  ███████████
  res_slope20                -0.3168  ██████████
  volt_slope20               -0.1288  ████
  volt_win_std               -0.1147  ███
  temp_slope20               -0.1000  ███
  soh_win_std5               -0.0654  ██
  temp_win_range20           -0.0599  ██
  res_diff1                  -0.0171  █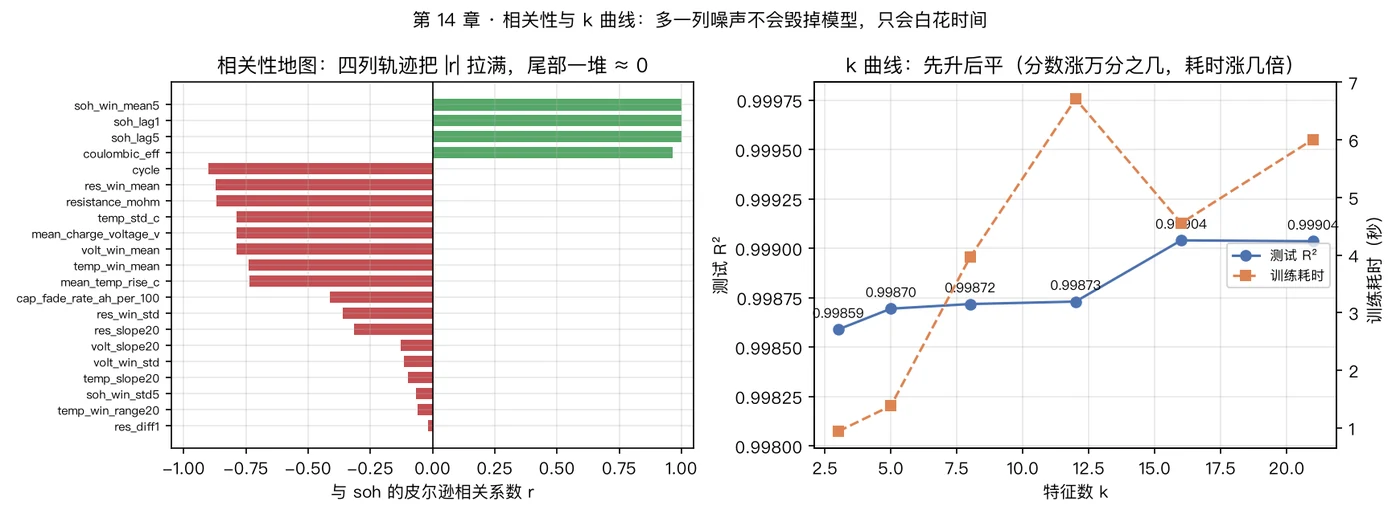
★ 这张表读四个地方:
| 看什么 | 数字 | 含义 |
|---|---|---|
| 前三名 | soh_win_mean5 +0.9994 / soh_lag1 +0.9991 / soh_lag5 +0.9990 | 全是轨迹组(历史实测 SOH)—— 它们几乎就是标签的"上一秒" |
| 第四名 | coulombic_eff +0.9646 | 唯一一个非轨迹列还能上 0.96 的 |
| 中间层 | cycle −0.8999、res_win_mean −0.8712、resistance_mohm −0.8673 | 老化过程的三个侧面,符号为负(越老化 SOH 越低) |
| 尾部 | volt_slope20 −0.1288、soh_win_std5 −0.0654、res_diff1 −0.0171 | 相关系数很小,但 14.4 会警告:这不等于"没用" |
★ 一个必读的细节:|r| 是线性相关的强度,不是"重要性"
|r| 的回答是:"这一列和标签能不能用一条直线拟合?"
    ↓
它看不见:拐点、阈值、区间效应、以及"和其它列配合才有效"的信息
    ↓
所以它适合当【地图】(快速定位可疑列),不适合当【裁判】(决定删不删)
14.2 冗余:9 对特征在说同一件事
真实输出:
② 特征之间的强相关对(|r| > 0.95 = 信息冗余)

  soh_lag1                   ~ soh_win_mean5              r = 0.9996
  soh_lag5                   ~ soh_win_mean5              r = 0.9996
  soh_lag1                   ~ soh_lag5                   r = 0.9990
  resistance_mohm            ~ res_win_mean               r = 0.9951
  mean_charge_voltage_v      ~ volt_win_mean              r = 0.9950
  mean_temp_rise_c           ~ temp_win_mean              r = 0.9917
  coulombic_eff              ~ soh_win_mean5              r = 0.9647
  coulombic_eff              ~ soh_lag1                   r = 0.9645
  coulombic_eff              ~ soh_lag5                   r = 0.9641
★ 9 对里有两组不同的故事:
故事一:轨迹组内部(0.9990 ~ 0.9996)
    soh_lag1 / soh_lag5 / soh_win_mean5 是同一个量的三个写法
    → 它们几乎完全等价(14.4 会看到:删任意一个都不掉分)

故事二:基础列 vs 它的"窗口版本"(0.9917 ~ 0.9951)
    resistance_mohm ~ res_win_mean、mean_charge_voltage_v ~ volt_win_mean、
    mean_temp_rise_c ~ temp_win_mean
    → "过去 20 个窗口的均值"和"当前这一行的读数"高度一致
    → 因为设备老化是慢过程:相邻 20 个窗口里,这一列几乎没变
★ 冗余的代价,说清楚三件事:
① 它【不会】直接让分数变差 —— 树可以只用其中一个,
   线性模型靠正则化/伪逆也能处理;
② 它会让【代价】变高:训练更慢、内存更大、上线要维护更多数据管道;
③ 它会让【解释】变差:功劳被随机分给其中一个,系数符号可能反转
   (上一本第 13 章的 VIF 一节讲过)。
★ 所以"冗余"是一个工程判断,而不是统计判断:
问:"删掉它,分数掉不掉?维护成本降不降?"两个答案都是"降/不掉",就删。
14.3 k 曲线:特征数 vs 测试分数
做法:把 SelectKBest 放进 Pipeline,扫一遍 k:
for k in [3, 5, 8, 12, 16, len(ALL)]:
    pipe = Pipeline([("sel", SelectKBest(f_regression, k=k)),
                     ("m", RandomForestRegressor(n_estimators=200,
                                                 random_state=42, n_jobs=-1))])
    pipe.fit(X.iloc[tr], y.iloc[tr])
...真实输出:
③ k 曲线:SelectKBest(f_regression) 挑前 k 列,随机森林 200 棵

   k    测试 R²      耗时    挑中的前 3 列
   3   0.99859     2.12s    soh_lag1, soh_lag5, soh_win_mean5
   5   0.99870     3.04s    cycle, coulombic_eff, soh_lag1 ...
   8   0.99872     4.85s    cycle, resistance_mohm, coulombic_eff ...
  12   0.99873    11.69s    cycle, mean_charge_voltage_v, mean_temp_rise_c ...
  16   0.99904     6.17s    cycle, mean_charge_voltage_v, mean_temp_rise_c ...
  21   0.99904     5.30s    cycle, mean_charge_voltage_v, mean_temp_rise_c ...

  → 最优 k = 16(0.99904);第一个达到『最优 − 0.001』的 k = 3
  → k=3 就已经拿到 0.99859,比 k=21 只低 0.00045,但快 2.5 倍。
  ★ 曲线是【先升后平】:多一列噪声不会毁掉模型,只会白花时间。
★ 三个读数,一个结论:
| 读什么 | 数字 | 结论 |
|---|---|---|
| k=3 的分数 | 0.99859 | 只留三列历史 SOH,就拿到最终成绩的 99.95% |
| k=16 才到最优 | 0.99904 | 从 3 列到 16 列,13 列只贡献 +0.00045 |
| 耗时 | 2.12s → 5~12s | 涨 2~5 倍(⚠️ 见下面的口径提醒) |
★ 关于耗时数字,必须说清口径:
上表的耗时是【单次实测】,而且这台机器当时还跑着别的任务(本机 8 核、n_jobs=-1)。
可以看见 k=12 那行(11.69s)比 k=16(6.17s)还慢 —— 这不是规律,是机器负载的噪声。
    ↓
所以:耗时只能当"数量级"看("几秒" vs "几十秒"),
      不能拿它做"k=12 比 k=16 慢一倍"这种结论。
      要报耗时,必须在【同一台机器、同一时刻、多次取中位数】的条件下测。
★ "先升后平"的机制:
k=1~3:把最强的信息(历史 SOH)放进来 → 分数从 0.96 档跳到 0.9985 档
k=3~16:边际列提供的是"冗余信息"和"噪声" → 分数缓慢上升
k≥16: 所有有用信息都在了 → 曲线变平
★ 一个反直觉的观察:k=3 挑中的是"最像标签"的三列
soh_lag1 / soh_lag5 / soh_win_mean5 —— 三列都是历史实测 SOH
    ↓
它们彼此 r ≈ 0.999(近乎同一列的三份拷贝)
    ↓
但就是这三列,把 R² 从 0.96 档抬到 0.99859
    ↓
这就是第 15 章"消融"要讲的核心:真正值钱的是【信息结构】,
不是【列数】
14.4 |r| 的边界:为什么它不能当裁判
真实输出(被 |r| 排在最后的那几列):
  |r| 最小的三列:soh_win_std5, temp_win_range20, res_diff1
                   (-0.0654 / -0.0599 / -0.0171)
★ 三种 |r| 看不见的信息:
| 看不见的东西 | 例子 | 相关系数会怎么判 |
|---|---|---|
| 非线性(拐点/阈值) | "温升超过 15℃ 之后 SOH 才快速掉" | 极低,甚至 0 |
| 区间效应 | "内阻在某区间内与 SOH 无关,超出就有关" | 被平均掉 |
| 交互作用 | "电压 × 温度"的组合才有意义 | 单列看都是 0 |
★ 更要命的一条:|r| 和 F 值排序是同一件事
真实输出:
④ 一个必须知道的等价性:f_regression 的排序 == |r| 的排序

  按 |r| 排序(前 5):['soh_win_mean5', 'soh_lag1', 'soh_lag5', 'coulombic_eff', 'cycle']
  按 F 值排序(前 5):['soh_win_mean5', 'soh_lag1', 'soh_lag5', 'coulombic_eff', 'cycle']
  两种排序是否完全一致:True
★ 为什么它们必然一致:
单变量 F 检验的统计量 = f(r²)
    ↓ f 是单调函数
排序完全一样
    ↓
所以 SelectKBest(f_regression) 在"逐列独立打分"这件事上,
等价于"按 |r| 取前 k 列"
    ↓
它【看不见】特征之间的配合,也【看不见】非线性
★ 那"多变量"的选择方法呢:
| 方法 | 它看什么 | 代价 |
|---|---|---|
SelectKBest(f_regression) | 单列与 y 的线性相关 | 最快,但忽略交互 |
SelectKBest(mutual_info_regression) | 单列与 y 的任意依赖 | 能抓非线性,慢一些 |
RFE / RFECV | 用模型自身的重要性反复删 | 慢(要训很多次模型) |
| 模型自带重要性(树) | 分裂带来的不纯度下降 | 快,但共线时会"随机挑一个" |
| 消融(第 15 章) | 拿掉重训,看分数掉多少 | 最慢,也最接近真相 |
★ 本数据上的诚实结论:
|r| 最小的 4 列(temp_slope20 / soh_win_std5 / temp_win_range20 / res_diff1)
    ↓
在第 15 章的消融里,删掉它们分数【不动】
    ↓
所以这次 |r| 的"小"恰好和消融的"没用"对上了
    ↓
但这是【巧合】,不是规律:换个数据集,|r| 会漏掉有用的非线性列
14.5 特征选择放在哪一步:两个口径的实测
这是本章最有价值的一段。"挑特征"这件事用了标签 y,所以它和缩放一样, 必须在每一折内部做。
口径 A:单次按设备划分(看不出差距)
X17 = d[BASE + WIN + DIFF + RANGE]        # 17 列安全特征(不含轨迹)

sel_full = SelectKBest(f_regression, k=5).fit(X17, y)              # ❌ 全量(含测试集)
sel_tr = SelectKBest(f_regression, k=5).fit(X17.iloc[tr17], ytr) # ✅ 只用训练集真实输出:
⑤ 对照:特征选择放在哪一步 fit —— 17 列安全特征 + 线性回归,k=5

  口径 A(单次按设备划分):
    全量挑特征(❌)  测试 R² = 0.93833   挑出:['cycle', 'resistance_mohm', 'coulombic_eff', 'temp_std_c', 'res_win_mean']
    训练集内挑(✅)  测试 R² = 0.93833   挑出:['cycle', 'resistance_mohm', 'coulombic_eff', 'temp_std_c', 'res_win_mean']
    差 = +0.00000   挑出的 5 列是否相同:True
    → 这两条用的是同一个模型、同一个划分、同样 5 列 —— 单次划分上[看不出差距]。
★ "看不出差距"不是"没问题":
单次划分只有一次运气
    ↓
两次挑出的是同样 5 列,用的是同样的模型 → 分数当然一样
    ↓
真正的问题在【折与折之间】:全局挑特征用了"全部折的标签"
口径 B:5 折 GroupKFold(差距出现了)
真实输出:
  口径 B(5 折 GroupKFold,同一个训练池):
    外面先挑好再来回验证(❌)[0.93764, 0.93027, 0.93119, 0.9446, 0.93901]
                             均值 0.93654 ± 0.00530
    SelectKBest 放进 Pipeline(✅)[0.91398, 0.93027, 0.93591, 0.92729, 0.93901]
                             均值 0.92929 ± 0.00869
    差 = -0.00725   标准差 0.00530 → 0.00869
★ 三个数字,三条结论:
① 泄漏版【虚高】 +0.00725(0.93654 > 0.92929)
       → 因为"挑哪 5 列"用到了每一折的验证标签
② 泄漏版的折间标准差【更小】:0.00530 vs 0.00869
       → 五折共享了同一份"从全部数据里挑出来的列",差异被抹平
       → ★ 折间方差异常小,是预处理泄漏的指纹(第 13 章也提过)
③ 干净版的逐折分数里有一折只有 0.91398
       → 那一折的验证设备比较难;干净版才会诚实地反映这种难度
为什么折内挑中的列会变
真实输出:
  为什么口径 B 里差距突然出现:折内挑中的 5 列【并不总是同一组】
    折 1:与全局 5 列不同   多出来的是 ['mean_charge_voltage_v']
    折 2:与全局 5 列相同   多出来的是 —
    折 3:与全局 5 列不同   多出来的是 ['mean_charge_voltage_v']
    折 4:与全局 5 列不同   多出来的是 ['mean_charge_voltage_v']
    折 5:与全局 5 列相同   多出来的是 —
★ 这个细节把"泄漏"从抽象变具体:
全局挑出的第 5 名是 temp_std_c
    ↓
但折 1/3/4 自己挑时,第 5 名换成了 mean_charge_voltage_v
    ↓
为什么?因为这两列本来就近乎等价(|r| = 0.99 量级),
它们的 F 值在所有 17 列里分别排第 4/5/6 位,谁上谁下只差一点点
    ↓
"全局挑特征"相当于用【所有折的标签】帮每一折做了决定
    ↓
于是模型在每一折上都多知道了一点"本不该知道"的信息
★ 一条可以直接背下来的纪律:
"没看见差距"永远不能当作"写法没问题"的证据。
同一份数据、同一个违规写法,用不同口径量出来的差距可以从 0.00000 到 0.00725。
★ 完整的预处理泄漏量化(缩放器 / PCA / 特征选择三类)在第 19 章。
14.6 常见坑
① 在划分之前做特征选择        → 选择用了 y;单次划分可能一模一样,5 折才露头(14.5)
② 用相关系数筛掉"非线性但有用"的列 → |r| 只看线性关系(14.4 的三类反例)
③ 只看分数不看耗时             → k=3 到 k=21 只涨万分之几,耗时涨几倍
④ 用测试集挑特征              → 那就是选择泄漏;挑完的测试集不再是"没见过的"
⑤ 把 SelectKBest 的 k 当成超参在外面调好
                              → k 必须在 Pipeline 里、由 CV 内部决定(或者用 RFECV)
⑥ 以为 f_regression 能看交互    → 它逐列独立打分,和 |r| 排序等价(14.4)
⑦ 只看"挑出来的前 3 列"就下结论  → 第 4~5 名常常在换(14.5),说明它们在等价线上
⑧ 忘了 dropna 会改变可用样本数   → 21 列口径是 19,979 行;7 列口径是 21,239 行(第 07 章)
★ 第 ⑤ 条展开一下(这是"高级用法"里最容易踩的):
# ❌ 用测试集调 k —— 等于把测试集当验证集
best_k = max([3, 5, 8, 12, 16, 21], key=lambda k: score_on_test(k))

# ✅ 让 CV 内部决定 k:把 k 当超参,走 GridSearchCV
GridSearchCV(Pipeline([("sel", SelectKBest(f_regression)), ("m", model)]),
             {"sel__k": [3, 5, 8, 12, 16, 21]},
cv=GroupKFold(5), scoring="r2")为什么后者是对的:GridSearchCV 会把 sel__k 也放进每一折内部去挑, 所以"选 k"这件事用的仍然只是训练部分。
14.7 完整示例与输出
cd tools/feature-engineering-pipeline/code
MPLCONFIGDIR=/tmp/fe-mpl /path/to/venv/bin/python demos/ch14-feature-selection.py真实输出(节选):
① 21 列与 soh 的皮尔逊相关系数(按 |r| 从大到小)
  soh_win_mean5              +0.9994
  soh_lag1                   +0.9991
  soh_lag5                   +0.9990
  coulombic_eff              +0.9646
  cycle                      -0.8999
  ...
  res_diff1                  -0.0171

② 特征之间的强相关对(|r| > 0.95 = 信息冗余)
  一共 9 对 |r| > 0.95;最高的一对几乎就是同一列的两个写法。

③ k 曲线:SelectKBest(f_regression) 挑前 k 列,随机森林 200 棵
   3   0.99859    soh_lag1, soh_lag5, soh_win_mean5
   5   0.99870    cycle, coulombic_eff, soh_lag1 ...
  16   0.99904    cycle, mean_charge_voltage_v, mean_temp_rise_c ...
  21   0.99904    cycle, mean_charge_voltage_v, mean_temp_rise_c ...
  → 最优 k = 16(0.99904);第一个达到『最优 − 0.001』的 k = 3

④ 两种排序是否完全一致:True

⑤ 口径 A:单次划分 全量挑 0.93833 / 训练集内挑 0.93833,差 +0.00000
   口径 B:5 折 CV 外面挑 0.93654 ± 0.00530 / Pipeline 内挑 0.92929 ± 0.00869
          差 -0.00725,标准差 0.00530 → 0.00869
★ 一页记住这一章:
相关性地图:三列历史 SOH 的 |r| 都 > 0.999;9 对特征 |r| > 0.95(冗余)
k 曲线    :k=3 → 0.99859;k=16/21 → 0.99904(涨万分之几,耗时涨几倍)
等价性    :SelectKBest(f_regression) 的排序 == |r| 的排序
纪律      :挑特征必须进 Pipeline(口径 A 看不出差距,口径 B 差 0.00725)
本章练习
练习 1:画一张相关性地图
用 21 列安全特征(dropna 后 19,979 行):
- 报
|r|最大的 5 列与最小的 5 列; - 报
|r| > 0.95的强相关对有几对,并列出最高的 5 对; - 回答:
soh_lag1与soh_win_mean5的r = 0.9996, 说明这两列在业务上分别是什么?它们能不能互相替代?
参考答案
import os

import numpy as np
import pandas as pd

HERE = os.path.dirname(os.path.abspath(__file__))
CODE = os.path.abspath(os.path.join(HERE, "..", ".."))
DATA = os.path.join(CODE, "data", "battery")

BASE = ["cycle", "mean_charge_voltage_v", "mean_temp_rise_c", "resistance_mohm",
        "coulombic_eff", "cap_fade_rate_ah_per_100", "temp_std_c"]
WIN = ["volt_win_mean", "volt_win_std", "res_win_mean", "res_win_std", "temp_win_mean"]
DIFF = ["volt_slope20", "res_slope20", "temp_slope20", "res_diff1"]
RANGE = ["temp_win_range20"]
TRAJ = ["soh_lag1", "soh_lag5", "soh_win_mean5", "soh_win_std5"]
ALL = BASE + WIN + DIFF + RANGE + TRAJ

df = pd.read_csv(os.path.join(DATA, "soh_features_v2.csv"))
d = df.dropna(subset=ALL)
print(f"可用样本 {len(d):,} 行 / {d['cell_id'].nunique()} 支设备")

corr = d[ALL + ["soh"]].corr()["soh"].drop("soh")
order = corr.sort_values(key=np.abs, ascending=False)
print("|r| 最大的 5 列:")
for c, v in order.head(5).items():
    print(f"  {c:26s} {v:+.4f}")
print("|r| 最小的 5 列:")
for c, v in order.tail(5).items():
    print(f"  {c:26s} {v:+.4f}")

c = d[ALL].corr().abs()
pairs = [(a, b, c.loc[a, b]) for i, a in enumerate(ALL) for b in ALL[i + 1:]
         if a != b and c.loc[a, b] > 0.95]
print(f"\n|r| > 0.95 的强相关对:{len(pairs)} 对,最高 5 对:")
for a, b, v in sorted(pairs, key=lambda t: -t[2])[:5]:
print(f" {a:26s} ~ {b:26s} r = {v:.4f}")期望输出:
可用样本 19,979 行 / 60 支设备
|r| 最大的 5 列:
  soh_win_mean5              +0.9994
  soh_lag1                   +0.9991
  soh_lag5                   +0.9990
  coulombic_eff              +0.9646
  cycle                      -0.8999
|r| 最小的 5 列:
  volt_win_std               -0.1147
  temp_slope20               -0.1000
  soh_win_std5               -0.0654
  temp_win_range20           -0.0599
  res_diff1                  -0.0171

|r| > 0.95 的强相关对:9 对,最高 5 对:
  soh_lag1                   ~ soh_win_mean5              r = 0.9996
  soh_lag5                   ~ soh_win_mean5              r = 0.9996
  soh_lag1                   ~ soh_lag5                   r = 0.9990
  resistance_mohm            ~ res_win_mean               r = 0.9951
  mean_charge_voltage_v      ~ volt_win_mean              r = 0.9950
③ 回答:它们不是同一列,但在这份数据上几乎可以互相替代。
soh_lag1       = 上一个窗口的【实测】SOH(一个点)
soh_win_mean5  = 过去 5 个窗口实测 SOH 的【均值】(一个窗口平均)

业务含义不同:前者对单点测量噪声敏感,后者被 5 点平均平滑掉
    ↓
但设备老化是慢过程:相邻 5 个窗口的 SOH 几乎没变
    ↓
所以两者 r = 0.9996
    ↓
能不能替代?在这份数据上能(第 15 章的逐列消融会显示:删掉任意一列都不掉分);
但在噪声更大的真实产线上,"均值"比"单点"稳,那时它们就不再等价了。
    ↓
★ 纪律:相关性只说明"在当前数据上近似等价",
  是否真的能替代,要靠消融(第 15 章)验证。
练习 2:k 曲线与"性价比最高的 k"
- 用
SelectKBest(f_regression)+ 随机森林扫 k = 1, 3, 5, 8, 12, 16, 21, 报每个 k 的测试 R²、耗时、挑中的前 3 列; - 报"最优的 k"和"第一个达到『最优 − 0.001』的 k";
- 回答:k=1 那一行的分数说明了什么?为什么 k=3 有时会比 k=1 略低?
参考答案
import os
import time

import numpy as np
import pandas as pd
from sklearn.ensemble import RandomForestRegressor
from sklearn.feature_selection import SelectKBest, f_regression
from sklearn.metrics import r2_score
from sklearn.model_selection import GroupShuffleSplit
from sklearn.pipeline import Pipeline

HERE = os.path.dirname(os.path.abspath(__file__))
CODE = os.path.abspath(os.path.join(HERE, "..", ".."))
DATA = os.path.join(CODE, "data", "battery")

BASE = ["cycle", "mean_charge_voltage_v", "mean_temp_rise_c", "resistance_mohm",
        "coulombic_eff", "cap_fade_rate_ah_per_100", "temp_std_c"]
WIN = ["volt_win_mean", "volt_win_std", "res_win_mean", "res_win_std", "temp_win_mean"]
DIFF = ["volt_slope20", "res_slope20", "temp_slope20", "res_diff1"]
RANGE = ["temp_win_range20"]
TRAJ = ["soh_lag1", "soh_lag5", "soh_win_mean5", "soh_win_std5"]
ALL = BASE + WIN + DIFF + RANGE + TRAJ

df = pd.read_csv(os.path.join(DATA, "soh_features_v2.csv"))
d = df.dropna(subset=ALL)
X, y, g = d[ALL], d["soh"], d["cell_id"]
tr, te = next(GroupShuffleSplit(n_splits=1, test_size=0.2, random_state=42)
              .split(X, y, g))

rows = []
for k in [1, 3, 5, 8, 12, 16, 21]:
    pipe = Pipeline([("sel", SelectKBest(f_regression, k=k)),
                     ("m", RandomForestRegressor(n_estimators=50,
                                                 random_state=42, n_jobs=-1))])
    t0 = time.perf_counter()
    pipe.fit(X.iloc[tr], y.iloc[tr])
    dt = time.perf_counter() - t0
    r2 = r2_score(y.iloc[te], pipe.predict(X.iloc[te]))
    picked = list(X.columns[pipe.named_steps["sel"].get_support()])
    rows.append((k, r2, dt, picked))
    print(f"k={k:2d}  测试 R² = {r2:.5f}  {dt:5.2f}s  前 3 列 = {picked[:3]}")

best = max(r for _, r, _, _ in rows)
first = next(k for k, r, _, _ in rows if r >= best - 0.001)
print(f"\n最优 = {best:.5f};第一个达到「最优 − 0.001」的 k = {first}")期望输出:
k= 1  测试 R² = 0.99865   0.11s  前 3 列 = ['soh_win_mean5']
k= 3  测试 R² = 0.99857   0.23s  前 3 列 = ['soh_lag1', 'soh_lag5', 'soh_win_mean5']
k= 5  测试 R² = 0.99868   0.31s  前 3 列 = ['cycle', 'coulombic_eff', 'soh_lag1']
k= 8  测试 R² = 0.99870   0.53s  前 3 列 = ['cycle', 'resistance_mohm', 'coulombic_eff']
k=12  测试 R² = 0.99871   0.77s  前 3 列 = ['cycle', 'mean_charge_voltage_v', 'mean_temp_rise_c']
k=16  测试 R² = 0.99903   0.99s  前 3 列 = ['cycle', 'mean_charge_voltage_v', 'mean_temp_rise_c']
k=21  测试 R² = 0.99902   1.32s  前 3 列 = ['cycle', 'mean_charge_voltage_v', 'mean_temp_rise_c']

最优 = 0.99903(k=16);第一个达到「最优 − 0.001」的 k = 1
**③ 回答:k=1 那一行说明"单列 soh_win_mean5 就拿到了 0.99865"—— 信息几乎全在它身上。
k=1:只留"过去 5 个窗口的实测 SOH 均值" → 0.99865
k=3:再加上 soh_lag1 / soh_lag5 → 0.99857(反而略低)
    ↓
为什么略低?
  ① 这三列 r ≈ 0.999,加进来的是【同一份信息的三个拷贝】;
  ② 50 棵树的随机性 + 单次划分的运气,波动量级就在 ±0.0001 上下;
  ③ 树多了、k 大了之后(k=16)才稳定到 0.99903。
    ↓
★ 所以"k=3 比 k=1 低"不是"三列有害",而是"在噪声量级内无法区分"。
  要把这种比较当结论,得报方差(回到上一本第 12 章)。
★ 口径提醒:这里用 50 棵树 + 容差 0.001;正文用 200 棵树,所以 正文 k=3 的读数是 0.99859、'最优 − 0.001' 的边界落在 k=3。 两处结论一致:曲线先升后平,收益在万分之几量级。
练习 3:特征选择放哪一步 —— 两个口径的差距
用 17 列安全特征(不含轨迹)+ 线性回归 + SelectKBest(f_regression, k=5):
- 证明
f_regression的排序与|r|的排序完全一致; - 单次划分口径:比"全量挑"与"训练集内挑"的测试 R²,报挑出的 5 列;
- 5 折
GroupKFold口径:比"外面先挑好"与"Pipeline 内挑"的均值 ± 标准差; - 逐折看"折内挑出的 5 列"与"全局 5 列"是否相同,数一数有几折不同;
- 回答:为什么单次划分看不出差距,5 折就看出来了?
参考答案
import os

import numpy as np
import pandas as pd
from sklearn.feature_selection import SelectKBest, f_regression
from sklearn.linear_model import LinearRegression
from sklearn.metrics import r2_score
from sklearn.model_selection import GroupKFold, GroupShuffleSplit, cross_val_score
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler

HERE = os.path.dirname(os.path.abspath(__file__))
CODE = os.path.abspath(os.path.join(HERE, "..", ".."))
DATA = os.path.join(CODE, "data", "battery")

BASE = ["cycle", "mean_charge_voltage_v", "mean_temp_rise_c", "resistance_mohm",
        "coulombic_eff", "cap_fade_rate_ah_per_100", "temp_std_c"]
WIN = ["volt_win_mean", "volt_win_std", "res_win_mean", "res_win_std", "temp_win_mean"]
DIFF = ["volt_slope20", "res_slope20", "temp_slope20", "res_diff1"]
RANGE = ["temp_win_range20"]
TRAJ = ["soh_lag1", "soh_lag5", "soh_win_mean5", "soh_win_std5"]
ALL = BASE + WIN + DIFF + RANGE + TRAJ
SAFE17 = BASE + WIN + DIFF + RANGE

df = pd.read_csv(os.path.join(DATA, "soh_features_v2.csv"))
d = df.dropna(subset=ALL)
X17, y, g = d[SAFE17], d["soh"], d["cell_id"]
tr, te = next(GroupShuffleSplit(n_splits=1, test_size=0.2, random_state=42)
              .split(X17, y, g))

corr_order = list(d[ALL + ["soh"]].corr()["soh"].drop("soh")
                  .sort_values(key=np.abs, ascending=False).index)
f_order = [ALL[i] for i in np.argsort(-f_regression(d[ALL], y)[0])]
print(f"两种排序完全一致:{corr_order == f_order}")

ytr, yte = y.iloc[tr], y.iloc[te]
full_cols = list(X17.columns[SelectKBest(f_regression, k=5).fit(X17, y).get_support()])
tr_cols = list(X17.columns[SelectKBest(f_regression, k=5)
                           .fit(X17.iloc[tr], ytr).get_support()])


def r2_of(cols):
    pipe = Pipeline([("s", StandardScaler()), ("m", LinearRegression())])
    pipe.fit(X17[cols].iloc[tr], ytr)
    return r2_score(yte, pipe.predict(X17[cols].iloc[te]))


print(f"单次划分:全量挑 {r2_of(full_cols):.5f}  训练集内挑 {r2_of(tr_cols):.5f}")
print(f"挑出的 5 列相同:{full_cols == tr_cols}   {full_cols}")

cv = GroupKFold(n_splits=5)
leak = cross_val_score(Pipeline([("s", StandardScaler()), ("m", LinearRegression())]),
                       X17[full_cols].iloc[tr], ytr, cv=cv, groups=g.iloc[tr])
ok = cross_val_score(Pipeline([("s", StandardScaler()),
                              ("sel", SelectKBest(f_regression, k=5)),
                              ("m", LinearRegression())]),
                     X17.iloc[tr], ytr, cv=cv, groups=g.iloc[tr])
print(f"5 折 CV:外面挑 {leak.mean():.5f} ± {leak.std():.5f}   "
      f"Pipeline 内挑 {ok.mean():.5f} ± {ok.std():.5f}")

n_diff = 0
for a, b in cv.split(X17.iloc[tr], ytr, g.iloc[tr]):
    picked = list(X17.columns[SelectKBest(f_regression, k=5)
                              .fit(X17.iloc[tr].iloc[a], ytr.iloc[a]).get_support()])
    n_diff += (picked != full_cols)
print(f"折内与全局 5 列不同的折数:{n_diff}/5")期望输出:
两种排序完全一致:True
单次划分:全量挑 0.93833  训练集内挑 0.93833
挑出的 5 列相同:True   ['cycle', 'resistance_mohm', 'coulombic_eff', 'temp_std_c', 'res_win_mean']

5 折 CV:外面挑 0.93654 ± 0.00530   Pipeline 内挑 0.92929 ± 0.00869
折内与全局 5 列不同的折数:3/5
⑤ 回答:因为"泄漏"这件事发生在折与折之间**,而不是折内部。**
单次划分:只有一次运气,而且两次都挑出同样 5 列
    → 模型的输入完全一样 → 分数当然一样(差 +0.00000)

5 折:全局挑特征用了【所有折的标签】,而每一折自己挑时只用那一折的训练标签
    → 3/5 折的第 5 名在 temp_std_c 与 mean_charge_voltage_v 之间换了
      (这两列本来就近乎等价,|r| 都在 0.78 档)
    → 泄漏版把这 3 折的"换列"抹平了:
      均值虚高 +0.00725,折间标准差从 0.00869 压到 0.00530
★ 两条可以带走的判据:
① "没看见差距"≠"写法没问题" —— 换一个口径差距就出来了;
② 折间方差异常小(明显小于同类实验)是预处理泄漏的指纹。
面向工程实践:相关性与 k 曲线在项目里怎么用
① 用相关性地图做"第一轮筛查",但只用来排优先级
|r| 很高(>0.9)   → 优先检查它和别的列是否冗余(可能有更便宜的替代)
|r| 中等(0.3~0.9)→ 正常候选
|r| 很低(<0.1)   → 【不能直接删】,要问三件事:
                     ① 它是类别/计数器类信息(如 ID、批次)吗?
                     ② 它和别的列组合起来有用吗?(交互)
                     ③ 它对标签的作用是非线性/阈值型的吗?
② 用 k 曲线回答"该花多少工程成本"
问:"我要不要再做两周特征工程?"
    ├─ 看曲线:现在处于"平"段吗?
    │     ├─ 是 → 加同质特征不会涨分(本数据 k=3→21 只涨 0.00045)
    │     └─ 否 → 优先找"结构不同的信息"(本数据就是"历史实测 SOH"这一整组)
    └─ 看耗时:从 k=3 到 k=21,训练时间涨几倍?
          → 如果业务要求"每天重训",这就是硬成本
③ 一个可以复制到项目里的报告骨架
def report_feature_cost(df, feats, target, groups, ks=(3, 5, 8, 16), cv=None):
    """一张表回答:加特征值不值、挑多少列最划算。"""
    import time
    import numpy as np
    from sklearn.ensemble import RandomForestRegressor
    from sklearn.feature_selection import SelectKBest, f_regression
    from sklearn.model_selection import GroupKFold, cross_val_score
    from sklearn.pipeline import Pipeline

    cv = cv or GroupKFold(5)
    print(f"{'k':>4s} {'CV R²':>10s} {'±':>8s} {'耗时(s)':>9s}  挑中的列")
    for k in ks:
        pipe = Pipeline([("sel", SelectKBest(f_regression, k=k)),
                         ("m", RandomForestRegressor(n_estimators=200,
                                                     random_state=42, n_jobs=-1))])
        t0 = time.perf_counter()
        sc = cross_val_score(pipe, df[feats], df[target], cv=cv,
                             groups=df[groups])
        dt = time.perf_counter() - t0
        picked = list(np.array(feats)[SelectKBest(f_regression, k=k)
                                      .fit(df[feats], df[target]).get_support()])
        print(f"{k:4d} {sc.mean():10.5f} {sc.std():8.5f} {dt:9.1f}  {picked}")
★ 三行输出对应本章的三个坑:
CV 均值        → 不要用单次划分下结论(14.5 口径 A 看不出差距)
± 标准差       → Δ 要和方差一起读(下一章整章都在讲这件事)
耗时           → 分数只涨万分之几时,耗时就是决策依据(14.3)
★ 最后一句,也是通往下一章的桥:
相关性和 k 曲线都只能告诉你"看起来怎么样"。要回答"这一列到底值多少",只有一个办法:拿掉它,重训一次。下一章会把这张表做成这本书最重要的一张。