第 21 章 · 亲手做出 R² = 1.000000
这一章要解决什么:亲手把一个模型做到 R² = 1.000000, 然后用系数反推出真相 —— 模型一个规律都没学到, 它只是把标签乘以 1 再加 0.8。
最容易踩的坑: ① 看到 1.000000 的第一反应是"我成功了"; ② 只盯着 R²,不看
coef_(那一列系数是 1,其余全是 0); ③ 以为这是"极端个案" —— 其实只要特征里出现标签的仿射函数, 任何线性模型都会精确地给出 1.000000。
本章你需要完成的代码:demos/ch21-perfect-score.py
本章的口径:soh_features_v2.csv 全部 21,239 行、 GroupShuffleSplit(test_size=0.2, random_state=42) 按设备划分、 模型是不加缩放的 LinearRegression(不加缩放是为了让系数可以直接读)。
21.1 对照组:诚实的 0.94253
先把"诚实水平"钉死。同样按设备划分,只用 7 列基础特征,线性回归:
m7 = LinearRegression().fit(X.iloc[tr][BASE], y.iloc[tr])
print(m7.score(X.iloc[tr][BASE], y.iloc[tr]))         # 训练
print(m7.score(X.iloc[te][BASE], y.iloc[te])) # 测试真实输出:
① 对照组:7 列基础特征 + 线性回归(按设备划分)
  训练 R² = 0.94296   测试 R² = 0.94253   MAE = 0.010820
  |系数| 最大 = 0.5556(对应 cap_fade_rate_ah_per_100)   截距 = 1.3436
  这是这份数据在『只用横截面特征』时的真实水平:0.94 上下。
★ 记住这三个数,它们是本章的"标尺":
测试 R² = 0.94253      ← 诚实的水平
MAE     = 0.010820     ← 诚实的误差量级(1e-2)
max|coef| = 0.5556     ← 诚实的系数量级(0.5 上下)
21.2 只加一列:R² = 1.000000
现在只做一件事:把 soh_margin 加进特征。
X8 = df[BASE + ["soh_margin"]]
lin8 = LinearRegression().fit(X8.iloc[tr], y.iloc[tr])真实输出:
② 只加一列 soh_margin:训练 1.000000,测试 1.000000
  训练 R² = 1.000000   测试 R² = 1.000000
  测试 MAE = 2.100e-06(7 列时是 0.010820)
  测试集上『预测值 − 实测值』的最大绝对值 = 9.05e-06
★ 三个数字放在一起看:
R²:0.94253 → 1.000000   (涨了 0.05747)
MAE:0.010820 → 2.100e-06(小了 5,153 倍)
最大误差:9.05e-06
     ↓
在一次评估里,"误差小到 1e-6" 意味着什么?
★ 先做一个量级判断,避免误读:
标签 soh 的取值范围:0.8032 ~ 1.0017(跨度约 0.2)
测试集的最大绝对误差:9.05e-06
     ↓
相对跨度:9.05e-06 / 0.2 ≈ 4.5e-05
     ↓
也就是说:模型"预测"的误差是标签尺度的十万分之四
★ 而这里必须补一句精确的话(这一点和本书第 11 章的"tol 真因"是同一个机制):
2.100e-06 还不是"零",它是 LinearRegression 默认 tol=1e-6 的【截断残留】
     ↓
把 tol 设成 0(或者只用 soh_margin 一列),MAE 会掉到 1.2e-16
—— 那才是真正的浮点零
     ↓
本节先记住"1e-6 已经小得离谱",21.3 节把 1e-16 算出来
★ 一个不该被忽略的疑问:为什么"加一列"能让 R² 精确到 1.000000?
正常的特征工程:加一列 → 涨 0.005 ~ 0.04(第 20 章实测)
这里:加一列 → 从 0.94253 直接到 1.000000
     ↓
"恰好 1.000000" 这个形状本身就是一个信号:
真实现象不会恰好落在边界上
(就像"命中率恰好 100%、误差恰好 0"一样)
21.3 用系数反推真相
这是本章的核心动作:把 coef_ 打印出来。
真实输出:
③ 用 coef_ 与 intercept_ 反推真相同:模型学到的是 soh = soh_margin + 0.80
  8 列线性回归学到的系数:
    cycle                       +0.00000001
    mean_charge_voltage_v       -0.00000093
    mean_temp_rise_c            -0.00000006
    resistance_mohm             +0.00000015
    coulombic_eff               +0.01087291
    cap_fade_rate_ah_per_100    +0.00005252
    temp_std_c                  +0.00000267
    soh_margin                  +0.99988176   ← 只有它是非零
    截距                          +0.78917045
★ 读这张表只要三步:
第一步:谁是主角?
soh_margin 的系数 = 0.99988176 ≈ 1
其余 7 列的系数都是 0.0000xxxx 量级(最大 0.01087291)
     ↓
8 列特征里,模型只用了一列
第二步:其余 7 列"退化"到什么程度?
刚才 7 列对照时:max|coef| = 0.5556(cap_fade_rate_ah_per_100)
现在 8 列时    :同一列的系数 = 0.00005252
     ↓
从 0.5556 掉到 0.00005252,缩小了约 10,000 倍
     ↓
也就是说:模型把 7 列真实物理量【全部丢掉了】
第三步:把系数代回去,看看它到底学到了什么。
模型学到的函数:
    soh = 0.99988176 × soh_margin + 0.78917045

把 soh_margin = soh − 0.80 代进去:
    soh = 0.99988176 × (soh − 0.80) + 0.78917045
        = soh                                (恒等式)
     ↓
它没有学到温度、内阻、库仑效率与 SOH 的任何关系
它学到的是:把标签减掉 0.80,再加上 0.80
★ 一句话:
模型一个规律都没学到。它只是把标签乘以 1 再加 0.8。
21.3.1 验证一:soh_margin 恒等于 soh − 0.80
真实输出:
  ③-1 验证一:soh_margin 是否恒等于 soh − 0.80
        max |soh_margin − (soh − 0.80)| = 1.11e-16(机器精度)
        → 这一列不是『和标签很相关』,它就是标签的一个仿射变换。
★ 这一步把"相关"和"等价"分开了:
|r| = 1.000000   → 两者有【完美的线性关系】(可能是 a·y + c,a ≠ 1)
max|差| = 1.1e-16 → 两者在浮点意义上是【同一个量的平移】(a = 1, c = −0.80)
     ↓
前者是警告,后者是判决:
     a = 1 时,这一列是标签减常数;
     a ≠ 1 时,这一列是标签乘系数再平移(同样是泄漏,只是系数不同)
21.3.2 验证二:只用这一列,系数精确等于 1、截距精确等于 0.80
真实输出:
  ③-2 验证二:只用 soh_margin 一列,照样 1.000000
        系数 = 1.0000000000   截距 = 0.8000000000   测试 R² = 1.0000000000
        测试 MAE = 1.167e-16   最大绝对误差 = 3.331e-16
        → 8 列时系数是 0.99988176、截距是 0.78917045,
           1 列时才是精确的 1 和 0.80。差在哪?差在 tol(下一段)。
★ 1.167e-16 是什么概念?
IEEE 754 双精度浮点的机器精度 ε ≈ 2.22e-16
     ↓
MAE = 1.167e-16 ≈ ε/2,最大误差 3.331e-16 ≈ 1.5ε
     ↓
这不是"预测得很准",这是【浮点意义上的零】
★ "模型"和"恒等式"的区别,就在这个数量级上:
| 现象 | 典型 MAE | 说明 |
|---|---|---|
| 真实的物理规律 | 1e-3 ~ 1e-2 | 有噪声、有未观测因素 |
| 很强的轨迹特征(历史 SOH) | 1e-3 量级 | 依然是"预测" |
| 标签的仿射函数 | 1e-16 | 恒等式,没有预测的成分 |
21.3.3 验证三:tol 把那个"精确"挡在了 1e-6 之外
真实输出:
  ③-3 验证三:默认 tol=1e-6 把方向截断了(与第 11 章同一个真因)
        tol=1e-06    coef(soh_margin) = 0.9998817630   截距 = 0.7891704538   rank_ = 7/8   MAE = 2.100e-06
        tol=0        coef(soh_margin) = 1.0000000000   截距 = 0.8000000000   rank_ = 8/8   MAE = 2.228e-16
        → tol=0 时,模型给出的正是那个恒等式:系数 1、截距 0.80。
           默认 tol 下它少用了一个方向(rank_ 7/8),
           所以把 0.8 的截距『分摊』了一点到其他列上。
★ 这里要非常小心地讲,因为它和第 11 章的"缩放真因"是同一件事:
LinearRegression 用 SVD 求解,默认 tol=1e-6 用来判断"哪些奇异值算 0"
     ↓
本数据 7 列基础特征的量纲差异极大:
    cycle 的尺度 ~ 10²(几百圈)
    coulombic_eff 的尺度 ~ 10⁰(0.99 左右)
     ↓
设计矩阵的条件数很大 → 最小奇异值被 tol 判为 0 → rank_ 从 8 变 7
     ↓
于是"精确的恒等式解"被牺牲掉一点点:
    系数 0.99988176、截距 0.78917045、MAE 2.1e-06
     ↓
tol=0 时 rank_ = 8,解回到精确的 1 和 0.80,MAE = 2.2e-16
★ 所以本章有两个"真因"要分清:
真因一(本章主线):soh_margin 是标签的仿射函数 → R² 必然是 1,与模型无关
真因二(数值细节):默认 tol 让系数从"精确的 1"变成"0.99988"
     ↓
真因一是【方法问题】,必须修(删列);
真因二是【数值细节】,改 tol 或缩放就能对齐 ——
它只是解释了"为什么系数不是恰好 1",不能用来替泄漏开脱
★ 反过来,这个细节还提供了一个额外的证据:
如果 soh_margin 只是一个"和标签高相关的普通特征",
那 tol=0 不会让它变成精确的恒等式
     ↓
tol=0 之后系数精确等于 1、截距精确等于 0.80、残差降到 1e-16
     ↓
这是"它本来就是恒等式"的强证据
21.4 三组反证:它学到的是"这一列",不是一个规律
前两节说的是"模型学到了恒等式"。本节要证明"它除了这一列,什么都没学到"。
21.4.1 把标签随机打乱
真实输出:
④ 三组反证:它学到的是『这一列』,不是一个规律
  ④-1 把标签随机打乱再拟合 → R² 崩塌
        打乱后测试 R² = -0.00066   coef(soh_margin) = -0.04040
        → 恒等式一旦被破坏,模型立刻什么都不会了。
★ 这个实验的设计逻辑:
如果模型学到的是"温度 + 内阻 + 库仑效率 → SOH"这个物理规律,
那把【标签】打乱,模型应该还能靠特征拟合出一部分结构(R² 不会变成负的那么彻底)
     ↓
但实测 R² = -0.00066,系数变成 −0.04040
     ↓
说明它依赖的不是"特征里的规律",而是"标签与这一列的恒等关系":
关系一断,模型立刻归零
21.4.2 把这一列换成随机噪声
真实输出:
  ④-2 把 soh_margin 换成随机噪声 → 分数正好掉回对照组
        测试 R² = 0.94253   (7 列对照组 = 0.94253)
        → 把钩子换掉,分数就回到 0.94253。这 1.000000 全部来自那一列。
★ 这是最干净的一个反证:
换掉钩子前:0.94253(7 列)+ 钩子 → 1.000000
换掉钩子后:0.94253(7 列)+ 噪声 → 0.94253
     ↓
变化量精确地等于"那一列的价值":
    1.000000 − 0.94253 = 0.05747 全部来自 soh_margin
    噪声版本与 7 列对照【完全一致】(0.94253 = 0.94253)
     ↓
也就是说:其余 7 列在这两种配置里贡献完全相同,
          唯一的变量就是那一列
21.4.3 把钩子乘 a(系数变成 1/a)
真实输出:
  ④-3 把钩子改成 2 倍 / 0.5 倍 → 系数变成倒数,R² 仍然 1
        新列                                  系数          截距       测试 R²
        soh_margin                    1.000000    0.800000    1.000000
        2 × soh_margin                0.500000    0.800000    1.000000
        0.5 × soh_margin              2.000000    0.800000    1.000000
        soh − 0.50(换常数)               1.000000    0.500000    1.000000
        → 新列 = a × soh_margin 时系数 = 1/a、截距 = 0.80;
           新列 = soh − c 时系数 = 1、截距 = c。
           模型学到的永远是『把这个新列还原成 soh』。
★ 这组实验说明了一个一般规律(下一节会给出推导):
只要特征 h 是标签的仿射函数 h = a·y + c,
线性回归就会学出 w = 1/a、b = −c/a,并且 R² 精确等于 1
     ↓
**这不是模型的成绩,这是代数结论**
     ↓
"模型很聪明地发现了规律"这个说法在这里完全失效 ——
它只是解了一个一元一次方程
★ 而这一组实验还有一个实用价值:它解释了"为什么有些泄漏的系数看起来很怪"。
如果你在真实项目里看到某个"重要特征"的系数是 12.7,
不要先怀疑数据错误 —— 先怀疑它是不是【标签的缩放版本】
     ↓
一个系数明显偏离其他系数量级的特征,本身就是一条线索
(第 21.6 节的"体检一")
21.5 一般化的结论:标签的仿射函数必然给出 R² = 1
把上面的现象写成一条定理,它比"这个数据里有一个钩子"有用得多。
命题:
    设标签为 y,特征 h = a·y + c(a ≠ 0)。
    用 h 做一元线性回归(含截距),最小二乘解为:
        w = 1/a,  b = −c/a
    并且在【任何】训练集上训练、在【任何】测试集上评估,
    都有 R² = 1、MAE = 0(浮点意义)。

直观证明(两行):
    ŷ = w·h + b = (1/a)·(a·y + c) − c/a = y
        ↓
    预测值恒等于真值 → 残差恒为 0 → R² = 1
★ 这条命题的三个推论,每一条都有工程价值:
| 推论 | 说明 | 工程含义 |
|---|---|---|
| 与数据无关 | 不管训练集多大、划分怎么切、有多少噪声 | "换数据再验证一次"对它无效 |
| 与模型无关 | 线性回归、带正则的回归(在 alpha→0 时)、树模型都会拟合到饱和 | "换个模型试试"也无效 |
| 与 a、c 无关 | a = 1 时系数 1、a = 2 时系数 0.5 | 不能靠"系数是不是 1"来判定 |
★ 第三个推论尤其重要,因为它否掉了一个常见的检查方法:
"我看系数不是 1,所以应该不是恒等式"   ❌ 错
     ↓
只要 a ≠ 1,系数就不是 1(而是 1/a),
但它仍然是标签的仿射函数,仍然是泄漏
     ↓
正确的检查不是"系数等不等于 1",而是:
    ① 残差是不是浮点零(MAE ~ 1e-16)
    ② 这一列能不能【不依赖标签】算出来
    ③ max|coef| 是不是远大于其他列(单列独大)
★ 与之对应的"漏报清单":
下面这些列都是"标签的仿射函数",但 R² 不一定是 1、系数不一定是 1:
    · 标签减去退役线:soh − 0.80          → 系数 1,本数据实测
    · 标签的百分比形式:soh / 1.0 × 100    → 系数 0.01
    · 标签的对数形式:log(soh)            → 线性模型 R² < 1(非线性变换)
    · 标签的移动平均:rolling(y).mean()    → R² 高但不为 1(因为混入了别的行)
    · 标签的排名:rank(y)                 → 线性模型 R² < 1(单调但非线性)
     ↓
关键不是"它长什么样",而是"它的计算里有没有用到 y"
★ 这也是为什么第 20 章要给三种家族:soh_margin 只是家族①里最极端的一种形态。
21.6 把本章变成三条可自动化的体检
这三条体检都可以挂在训练脚本的末尾,每次训练自动打印。
体检一:系数体检(最便宜)
真实输出:
⑤ 工程动作:把这一章变成三条可自动化的体检
  体检一(便宜、必做):训练完把所有线性系数打印出来,看最大 |系数|。
      对照组最大 |系数| = 0.5556(量级正常)
      泄漏组最大 |系数| = 0.9999(并且它对应的是 soh_margin)
规则:某一列系数 ≈ 1 且其余列系数 ≈ 0 → 立刻停手,去看那一列是怎么算的。c = np.abs(model.coef_)
top1 = c.max() / c.sum() # 单列占全部 |系数| 的比例
print(f"max|coef| = {c.max():.4f} 单列占比 = {top1:.1%}")★ 本数据的两组取值:
| 配置 | max|coef| | 单列占比 |
|---|---|---|
| 干净 7 列 | 0.5556 | 79.9% |
| 带钩子 8 列 | 0.9999 | 98.9% |
单列占比 98.9% 意味着:模型把几乎所有决策权重都放在了一列上
     ↓
正常的多特征模型不会这样(除非那一列真的携带了绝大部分信息)
     ↓
这条检查不需要标签、不需要测试集,训练完立刻能算 —— 成本接近零
体检二:MAE 量级体检(便宜)
真实输出:
  体检二(便宜、必做):看 MAE 的量级。
      正常 MAE ≈ 1e-2(0.010820)
      泄漏 MAE ≈ 1e-6(2.100e-06,tol=0 时 2.228e-16)
      规则:MAE 比正常水平小三个数量级以上,先怀疑恒等式或重复行。
★ 为什么用"相对量"而不是绝对值?
"MAE < 1e-6 就是泄漏"        ❌ 不可移植:标签尺度不同,阈值就不同
"MAE 比历史最好水平小 1000 倍" ✅ 可移植:它衡量的是"误差消失"这个异常现象
     ↓
本数据:MAE 从 1.08e-2 掉到 2.1e-6,缩小 5,153 倍 —— 触发
体检三:标签打乱体检(贵一点,但能抓未知的坑)
真实输出:
  体检三(贵一点,但能抓住未知的坑):把标签打乱再跑一次。
      规则:如果打乱标签后分数不塌,说明评估管路里有一条『不依赖标签』的捷径;
如果打乱后分数照旧很高(比如还是 0.99),那更糟 —— 去看 y 有没有传错。y_shuf = y.sample(frac=1.0, random_state=0).reset_index(drop=True)
m_shuf = LinearRegression().fit(X_tr, y_shuf_tr)
print(f"打乱标签后 R² = {m_shuf.score(X_te, y_shuf_te):.5f}") # 本数据:-0.00066★ 这个实验能抓到三类问题:
| 打乱标签后的现象 | 说明 |
|---|---|
| 分数崩塌到 ~0 或负 | ✅ 正常:模型确实在学 y 与 X 的关系 |
| 分数仍然很高(如 0.99) | ❌ 泄漏:评估里有一条不依赖标签的捷径(比如索引对齐错误) |
| 分数完全不变(一模一样) | ❌ 严重 bug:y 根本没传对(模型在预测常数或另一个量) |
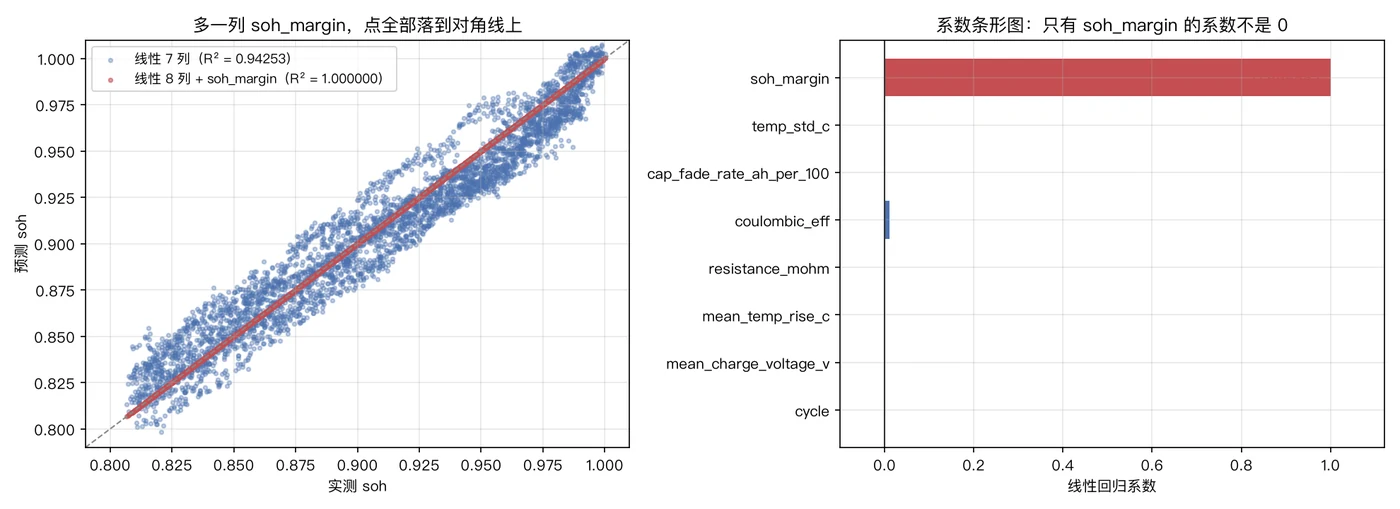
图的读法:
- 左图:横轴实测
soh、纵轴预测soh。蓝点是 7 列线性(散布在对角线两侧,R² = 0.94253); 红点是 8 列(+soh_margin),全部精确落在对角线上(R² = 1.000000)。 虚线是 y = x 的理想线。 - 右图:8 列线性回归的系数条形图。
soh_margin的系数是 0.9999,其余 7 列全部贴着 0 —— 一眼就能看出"模型只用了一列"。
21.7 常见坑
① 看到 R² = 1.000000 先高兴                   → 先怀疑,再查
② 只看 R²,不看 coef_                         → 系数表一眼就能定案
③ 以为"系数不是 1 就不是恒等式"                → h = 2y 时间样是恒等式,系数是 0.5
④ 用"换个模型/换个种子"验证                    → 代数结论与模型、数据无关,验证无效
⑤ 把 2.1e-6 的 MAE 当成"精度极高"             → 它是 tol 截断残留;tol=0 时是 1e-16
⑥ 只删掉这一列,不在账本里记录原因              → 下一个人会把它加回来(业务解释很动听)
⑦ 用"业务上说得通"替这一列背书                  → soh_margin 的业务名字叫"距退役线余量"
★ 第 ④ 条值得再强调一次,因为它是很多人"验证"泄漏的方式:
"我换了 random_state,R² 还是 1.000000,所以应该没问题"   ❌
     ↓
恒等式与随机种子无关 —— 换 100 个种子都会是 1.000000
     ↓
要验证"它是不是恒等式",正确的动作是看 coef_ / 看 MAE / 看那一列的定义
★ 第 ⑦ 条是本章最需要被记住的:
soh_margin 的业务含义是"距退役线的余量(0.80)还有多少"
     ↓
这个解释听起来完全合理 —— 甚至像是"领域知识驱动的特征工程"
     ↓
但它要求你先知道 soh。而 soh 就是你要预测的东西。
     ↓
**所有"由标签推导出来的业务指标",都长得非常合理。**
这就是为什么不能靠直觉筛查,要靠流程(第 22 章)。
21.8 完整示例与输出
cd tools/feature-engineering-pipeline/code
MPLCONFIGDIR=/tmp/fe-mpl /Users/jini/Projects/MyBooks/Basic-Tutorials/.pytmp/venv/bin/python \
demos/ch21-perfect-score.py真实输出(节选):
① 对照组:7 列基础特征 + 线性回归(按设备划分)
  训练 R² = 0.94296   测试 R² = 0.94253   MAE = 0.010820
  |系数| 最大 = 0.5556(对应 cap_fade_rate_ah_per_100)   截距 = 1.3436

② 只加一列 soh_margin:训练 1.000000,测试 1.000000
  测试 MAE = 2.100e-06
  测试集上『预测值 − 实测值』的最大绝对值 = 9.05e-06

③ 用 coef_ 与 intercept_ 反推真相
    soh_margin                  +0.99988176   ← 只有它是非零
    截距                          +0.78917045
  → soh = 1.0000 × soh_margin + 0.8000 = soh

  ③-1 max |soh_margin − (soh − 0.80)| = 1.11e-16
  ③-2 单列 soh_margin:系数 = 1.0000000000   截距 = 0.8000000000   测试 MAE = 1.167e-16
  ③-3 tol=1e-06  coef = 0.9998817630   截距 = 0.7891704538   rank_ = 7/8   MAE = 2.100e-06
       tol=0      coef = 1.0000000000   截距 = 0.8000000000   rank_ = 8/8   MAE = 2.228e-16

④ 三组反证
  ④-1 打乱标签    测试 R² = -0.00066   coef = -0.04040
  ④-2 换成噪声    测试 R² = 0.94253(7 列对照 = 0.94253)
  ④-3 2 × 钩子    系数 = 0.500000   截距 = 0.800000   测试 R² = 1.000000
本章练习
练习 1:复现 0.94253 → 1.000000,并打印 8 列系数
- 用 7 列基础特征 + 线性回归(按设备划分),打印训练 R²、测试 R²、
max|coef|; - 加上
soh_margin再跑一次,打印训练 R²、测试 R²、测试 MAE、max|coef|; - 打印 8 列的全部系数与截距;
- 用两句话说明:从这张系数表里,你怎么判断"模型只学了这一列"?
参考答案
import numpy as np, pandas as pd
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_absolute_error, r2_score
from sklearn.model_selection import GroupShuffleSplit

BASE = ["cycle", "mean_charge_voltage_v", "mean_temp_rise_c", "resistance_mohm",
        "coulombic_eff", "cap_fade_rate_ah_per_100", "temp_std_c"]
df = pd.read_csv("data/battery/soh_features_v2.csv")
y = df["soh"]
tr, te = next(GroupShuffleSplit(n_splits=1, test_size=0.2, random_state=42)
              .split(df[BASE], y, df["cell_id"]))

m7 = LinearRegression().fit(df[BASE].iloc[tr], y.iloc[tr])
print(f"7 列   训练 R² = {m7.score(df[BASE].iloc[tr], y.iloc[tr]):.5f}   "
      f"测试 R² = {r2_score(y.iloc[te], m7.predict(df[BASE].iloc[te])):.5f}   "
      f"max|coef| = {np.abs(m7.coef_).max():.4f}")

feats8 = BASE + ["soh_margin"]
m8 = LinearRegression().fit(df[feats8].iloc[tr], y.iloc[tr])
pred = m8.predict(df[feats8].iloc[te])
print(f"8 列   训练 R² = {m8.score(df[feats8].iloc[tr], y.iloc[tr]):.6f}   "
      f"测试 R² = {r2_score(y.iloc[te], pred):.6f}   "
      f"测试 MAE = {mean_absolute_error(y.iloc[te], pred):.3e}   "
      f"max|coef| = {np.abs(m8.coef_).max():.4f}")
print()
for c, v in zip(feats8, m8.coef_):
    print(f"  {c:<28s}{v:+.8f}")
print(f" {'截距':<28s}{m8.intercept_:+.8f}")期望输出:
7 列   训练 R² = 0.94296   测试 R² = 0.94253   max|coef| = 0.5556
8 列   训练 R² = 1.000000   测试 R² = 1.000000   测试 MAE = 2.100e-06   max|coef| = 0.9999

  cycle                       +0.00000001
  mean_charge_voltage_v       -0.00000093
  mean_temp_rise_c            -0.00000006
  resistance_mohm             +0.00000015
  coulombic_eff               +0.01087291
  cap_fade_rate_ah_per_100    +0.00005252
  temp_std_c                  +0.00000267
  soh_margin                  +0.99988176
  截距                          +0.78917045
★ 第 4 问的答案
① 横向比较:soh_margin 的系数是 0.99988176,其余 7 列全是 0.0000xxxx 量级 ——
   只有一列不是零。

② 纵向比较:同一批 7 列在"7 列对照"里的 max|coef| 是 0.5556,
   加进 soh_margin 之后,它们全部塌到 1e-4 以下 ——
   模型主动放弃了它们。
     ↓
"一列独大 + 其余归零" 就是"模型只学了这一列"的直接证据。
练习 2:拿到精确的"系数 1、截距 0.80",并手工验算残差
- 只用一个
soh_margin做线性回归,打印系数、截距、测试 R²、测试 MAE、最大绝对误差; - 用 8 列做两次回归:
tol=1e-6(默认)与tol=0,打印各自的coef(soh_margin)、截距、rank_、测试 MAE; - 打印
max |soh_margin − (soh − 0.80)|; - 用两句话说明:
tol在这里改变了什么?它能不能替泄漏开脱?
参考答案
import numpy as np, pandas as pd
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_absolute_error, r2_score
from sklearn.model_selection import GroupShuffleSplit

BASE = ["cycle", "mean_charge_voltage_v", "mean_temp_rise_c", "resistance_mohm",
        "coulombic_eff", "cap_fade_rate_ah_per_100", "temp_std_c"]
df = pd.read_csv("data/battery/soh_features_v2.csv")
y = df["soh"]
tr, te = next(GroupShuffleSplit(n_splits=1, test_size=0.2, random_state=42)
              .split(df[BASE + ["soh_margin"]], y, df["cell_id"]))

m1 = LinearRegression().fit(df[["soh_margin"]].iloc[tr], y.iloc[tr])
pred1 = m1.predict(df[["soh_margin"]].iloc[te])
print(f"单列:系数 = {m1.coef_[0]:.10f}  截距 = {m1.intercept_:.10f}  "
      f"测试 R² = {r2_score(y.iloc[te], pred1):.10f}")
print(f"      测试 MAE = {mean_absolute_error(y.iloc[te], pred1):.3e}  "
      f"最大绝对误差 = {np.abs(pred1 - y.iloc[te].to_numpy()).max():.3e}")

for tol in (1e-6, 0.0):
    m = LinearRegression(tol=tol).fit(df[BASE + ["soh_margin"]].iloc[tr], y.iloc[tr])
    pr = m.predict(df[BASE + ["soh_margin"]].iloc[te])
    print(f"8 列 tol={tol:<7g}:coef = {m.coef_[-1]:.10f}  截距 = {m.intercept_:.10f}  "
          f"rank_ = {m.rank_}/8  MAE = {mean_absolute_error(y.iloc[te], pr):.3e}")

print(f"\nmax |soh_margin − (soh − 0.80)| = "
f"{(df['soh_margin'] - (df['soh'] - 0.80)).abs().max():.2e}")期望输出:
单列:系数 = 1.0000000000  截距 = 0.8000000000  测试 R² = 1.0000000000
      测试 MAE = 1.167e-16  最大绝对误差 = 3.331e-16
8 列 tol=1e-06  :coef = 0.9998817630  截距 = 0.7891704538  rank_ = 7/8  MAE = 2.100e-06
8 列 tol=0      :coef = 1.0000000000  截距 = 0.8000000000  rank_ = 8/8  MAE = 2.228e-16

max |soh_margin − (soh − 0.80)| = 1.11e-16
★ 第 4 问的答案
tol 改变的是【数值求解的截断】:
7 列基础特征量纲差异大(cycle ~ 10²、coulombic_eff ~ 10⁰),
设计矩阵条件数大,默认 tol=1e-6 把最小奇异值判为 0 → rank_ 从 8 掉到 7,
于是精确解(1, 0.80)被牺牲成(0.99988, 0.78917),MAE 从 1e-16 抬到 2e-6。
     ↓
但它不能替泄漏开脱:
    · 泄漏的判定依据是"这一列用到了标签",与 tol 无关
    · 反过来,tol=0 之后残差降到 1e-16,恰好【加强】了"这是恒等式"的结论
     ↓
一个方便的记忆:tol 只影响"我们把这个恒等式解得有多精确",
不影响"它是不是恒等式"
练习 3:三组反证
- 把标签随机打乱后拟合 8 列,打印测试 R² 与
coef(soh_margin); - 把
soh_margin换成随机噪声,打印测试 R²,并与 7 列对照比较; - 对
1.0 × / 2.0 × / 0.5 × soh_margin三个版本(tol=0)打印系数、截距、测试 R²; - 用一句话说明第 3 步的规律。
参考答案
import numpy as np, pandas as pd
from sklearn.linear_model import LinearRegression
from sklearn.metrics import r2_score
from sklearn.model_selection import GroupShuffleSplit

BASE = ["cycle", "mean_charge_voltage_v", "mean_temp_rise_c", "resistance_mohm",
        "coulombic_eff", "cap_fade_rate_ah_per_100", "temp_std_c"]
df = pd.read_csv("data/battery/soh_features_v2.csv")
y = df["soh"]
tr, te = next(GroupShuffleSplit(n_splits=1, test_size=0.2, random_state=42)
              .split(df[BASE + ["soh_margin"]], y, df["cell_id"]))
feats8 = BASE + ["soh_margin"]

y_shuf = y.sample(frac=1.0, random_state=0).reset_index(drop=True)
m_shuf = LinearRegression().fit(df[feats8].iloc[tr], y_shuf.iloc[tr])
print(f"① 打乱标签    测试 R² = "
      f"{r2_score(y_shuf.iloc[te], m_shuf.predict(df[feats8].iloc[te])):.5f}   "
      f"coef = {m_shuf.coef_[-1]:+.5f}")

rng = np.random.RandomState(0)
Xn = df[BASE].copy()
Xn["h"] = rng.normal(size=len(df))
m_n = LinearRegression().fit(Xn.iloc[tr], y.iloc[tr])
print(f"② 换成噪声    测试 R² = {r2_score(y.iloc[te], m_n.predict(Xn.iloc[te])):.5f}")
m7 = LinearRegression().fit(df[BASE].iloc[tr], y.iloc[tr])
print(f"   (7 列对照 = {r2_score(y.iloc[te], m7.predict(df[BASE].iloc[te])):.5f})")

print("③ 钩子乘 a:")
for name, col in [("1.0 × soh_margin", df["soh_margin"]),
                  ("2.0 × soh_margin", 2 * df["soh_margin"]),
                  ("0.5 × soh_margin", 0.5 * df["soh_margin"])]:
    Xh = df[BASE].copy()
    Xh["h"] = col
    mh = LinearRegression(tol=0).fit(Xh.iloc[tr], y.iloc[tr])
    print(f"     {name:<20}系数 = {mh.coef_[-1]:.6f}   截距 = {mh.intercept_:.6f}   "
f"测试 R² = {r2_score(y.iloc[te], mh.predict(Xh.iloc[te])):.6f}")期望输出:
① 打乱标签    测试 R² = -0.00066   coef = -0.04040
② 换成噪声    测试 R² = 0.94253
   (7 列对照 = 0.94253)
③ 钩子乘 a:
     1.0 × soh_margin    系数 = 1.000000   截距 = 0.800000   测试 R² = 1.000000
     2.0 × soh_margin    系数 = 0.500000   截距 = 0.800000   测试 R² = 1.000000
     0.5 × soh_margin    系数 = 2.000000   截距 = 0.800000   测试 R² = 1.000000
★ 第 4 问的答案
新列 = a × soh_margin 时,学到的系数 = 1/a(截距仍是 0.80),R² 恒为 1。
     ↓
模型做的事永远是"把这个新列线性还原成 soh":
     ŷ = (1/a)·(a·soh_margin) + 0.80 = soh_margin + 0.80 = soh
     ↓
所以"系数是不是 1"不能当判据 —— 判据是"这一列的计算里有没有用到标签"。
面向工程实践
| 场景 | 怎么用 |
|---|---|
| 训练脚本 | 结尾固定打印 max|coef|、单列占比、MAE、以及 |r| > 0.999 的列 |
| 模型评审 | 要求提供系数表;出现"一列独大 + 其余归零"必须有解释 |
| 异常排查 | R² ≥ 0.9995 或 MAE 比历史小 1000 倍 → 按本章三条体检逐个跑 |
| 特征准入 | 任何"由标签派生的业务指标"(余量、达标率、健康分)一律不许入模 |
| 教学/复盘 | 本章是团队内最好的一次"反面示范":亲手做出 1.000000 再拆掉它 |
| 写文档 | 把本章的恒等式结论写进规范:"特征不得是标签的仿射函数或其函数" |
★ 一句话总结本章:
R² = 1.000000 不是成果,是事故。 它衡量的不是模型有多强,而是我们有多不小心 —— 一个恒等式被喂进模型,模型就只能把它原样还给你。
下一章:第 22 章 · 防泄漏检查清单