第 06 章 · rolling 的分组与排序:一个不报错的静默错误
这一章要解决什么:上一章学会了
rolling的三个默认语义。 这一章讲它的两条命根子:分组(按谁滚)和排序(沿什么顺序滚)。 漏掉任何一个,你会得到一张不报错、数值也合理、但完全错的表。最容易踩的坑: ① 直接在整张表上
df["soh"].rolling(20).mean()—— 每支设备的开头会拿到上一支设备的尾巴; ② 分了组但没排序 —— 每个窗口都是随机抽的,和真实历史毫无关系; ③ 用dropna之后的行数去验算滚动对不对 —— 错误的版本往往更"完整"(NaN 更少)。
本章你需要完成的代码:demos/ch06-rolling-groupby.py
6.1 一句话:rolling 只认行顺序
rolling 的实现里没有"设备"这个概念,也没有"时间"这个概念。 它只做一件事:取当前行往前数 W 行,算个统计量。
rolling(W).mean() 的实际语义:
   结果[i] = mean( 第 i-W+1 行 … 第 i 行 )
                ↑
        它只看【行号】,不看 cell_id,也不看 cycle
于是"行是怎么排的"就决定了结果对不对。
| 写法 | 行顺序 | 结果 |
|---|---|---|
sort_values([设备, 时间]) + groupby(设备).rolling(W) | 每支设备内部按时间升序 | ✅ 正确 |
直接 df[col].rolling(W) | 整张表的文件顺序 | ❌ 设备交界处串线 |
groupby(设备).rolling(W),但没排序 | 组内顺序 = 文件里的顺序 | ❌ 每个窗口都是随机抽的 |
groupby(批次).rolling(W),排序正确 | 批次内部跨设备 | ❌ 分组键选错,同样串线 |
★ 一句话记住:
rolling是一把"按行号切"的刀。 你不告诉它「哪些行是一家人」、「这一家人怎么排」, 它就会按你给它的顺序切下去 —— 而且不会抱怨。
这一章的所有输出,都来自同一份数据、同一个 rolling(20), 唯一的差别是那两行代码。
6.2 正确写法:先排序,再按设备分组
df = df.sort_values(["cell_id", "cycle"]).reset_index(drop=True)
df["soh_win_mean"] = (df.groupby("cell_id")["soh"]
.transform(lambda s: s.rolling(20).mean()))真实输出:
=== ① 正确写法:先排序,再按设备分组 ===
cell_id  cycle    soh  soh_win_mean_ok
   C002      1 1.0000              NaN
   C002      2 1.0000              NaN
   C002      3 0.9999              NaN
  新设备 C002 的前 19 行是 NaN —— 它还没有自己的历史,这是正确的结果。
  全表 NaN 行数:1,140(= 60 支 × 19 行)
★ 读三个地方:
| 观察 | 数字 | 含义 |
|---|---|---|
| C002 开头是 NaN | 前 19 行 | 它没有自己的历史,只能说"不知道" |
| NaN 总数 | 1,140 = 60 × 19 | 每支设备各自重新攒窗口 |
用的是 .transform | — | 返回与原表同索引的 Series,可以直接赋值 |
transform 与 groupby().rolling() 的区别,是一个常见事故点:
df["x"] = df.groupby("cell_id")["soh"].rolling(20).mean()   # ❌ 报错或错位
df["x"] = df.groupby("cell_id")["soh"].transform(lambda s: s.rolling(20).mean())  # ✅
前者返回的是带 MultiIndex 的 Series,后者返回的索引与原表一致。第 6.7 节的练习 1 会亲手试一次这个报错。
6.3 反面教材 A:不分组,直接 rolling
真实输出:
=== ② 反面教材 A:不分组,直接 rolling ===
cell_id  cycle    soh  soh_win_mean_bad
   C001    861 0.8003            0.8028
   C001    862 0.8000            0.8025
   C002      1 1.0000            0.8123
   C002      2 1.0000            0.8220
   C002      3 0.9999            0.8318

  C002 第一行(cycle=1,真实 soh = 1.0000)拿到的窗口均值 = 0.8123
  它其实混进了 C001 最后 19 圈 + C002 第 1 圈 —— 两支不相干的设备。
★ 这就是"跨设备串线":
C001 的生命末期:soh 一路掉到 0.8000
C002 的生命初期:soh 从 1.0000 开始
                        ↓
     不分组时,C002 第 1 行的"最近 20 圈"是:
     [C001 的最后 19 圈, C002 的第 1 圈]
                        ↓
     均值 = 0.8123 —— 一个既不属于 C001、也不属于 C002 的数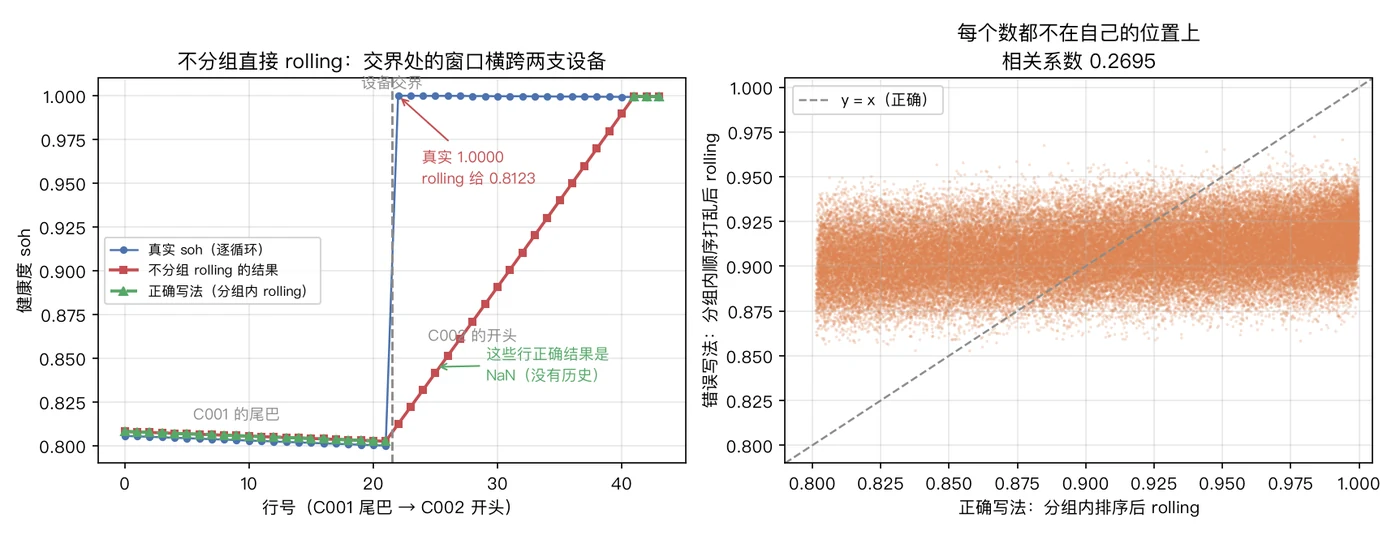
图里最要紧的是那两条线的关系:
蓝色(真实 soh)在交界处【垂直跳】到 1.0000
红色(错误 rolling)却从 0.80 慢慢爬
绿色(正确写法)在这些行上是【空的】—— 它诚实地不给数
污染的范围有多大
真实输出:
=== ③ 污染规模:多少行被串线,错得有多离谱 ===
  设备交界处:59 个(每两支之间一个)
  被污染的行:1,121(= 59 × 19),占全表 1.61%
  整表 soh 的跨度        :0.8000 ~ 1.0000(0.2000)
  混进来的那一个值       :0.8123,与真实值差 0.1877 —— 比整表跨度(0.2000)还大。
  ⚠️ 但它【不会报错】,也不会是 NaN:0.8123 是一个完全合理的健康度。
★ 这两组数字必须一起读:
| 说法 | 数字 | 听起来 |
|---|---|---|
| 被污染的行占比 | 1.61% | "才 1.6%,可以忽略吧" |
| 单行的误差 | 0.1877 | "整表跨度只有 0.20,这一个数就偏了 94%" |
这正是"局部但致命"的样子:
1.61% 的行 × 每行偏 0.19
   ↓
如果你要预测的恰恰是"设备刚上线时的状态"(这几行),
那你的特征在【最需要它的地方】是错的
★ 而且注意这一句:
0.8123是一个完全合理的健康度 —— 它落在 0.80 ~ 1.00 之间, 不违反任何约束。这就是它无法被"看一眼"发现的原因。
6.4 反面教材 B:分了组,但没排序
真实输出:
=== ④ 反面教材 B:分了组,但没排序 ===
  行内顺序被打乱后:NaN 行数 = 1,140(和正确写法一样多!)
  与正确值的相关系数 = 0.2695
  平均偏差 = 0.0485   最大偏差 = 0.1431
  → NaN 的数量一模一样,扫一眼「有没有缺」根本查不出来;
     每一个数都在自己那一支设备的真实范围内,只有和 cycle 一起看才露馅。
★ "NaN 数量一模一样"是这一节最刺眼的一句:
正确写法:每支设备前 19 行 NaN → 1,140
乱序写法:每支设备前 19 行 NaN → 1,140
                ↑
        连"缺失率"这个最常用的体检指标都过不了关
但相关系数掉到 0.2695 —— 也就是说两个数的关系已经不是一回事了:
上一张图的右半边把 69,591 个点画成了散点:
如果顺序是对的 → 所有点落在对角线上(y = x)
实际上是乱云一团 → 相关性 0.27
★ 一句话解释 0.27 这个数:
乱序之后,每一行的"最近 20 行"都是随机从这支设备的历史里抽的 20 行。 抽到的是生命初期还是末期,纯看运气。
这解释了为什么它的分布看起来还正常:
每支设备的 soh 都在 0.80 ~ 1.00 之间
   ↓
随机抽 20 行求均值,结果也一定落在 0.80 ~ 1.00 之间
   ↓
取值范围检查:通过 ✅
缺失率检查: 通过 ✅
均值、标准差:通过 ✅
               ↓
       只有"它和 cycle 的关系"这一项,过不了
6.5 分组键选错:按批次分组
"我分组了啊"是最常见的辩解。分错了组,等于没分。
真实输出:
=== ⑤ 分组键选错了:按【批次】分组而不是按【设备】 ===
  一个批次里有 15 支设备 —— 批次内部照样有设备交界。
  这些交界处 19 行的 v(批次内滚动)本应是 NaN,却被填上了上一支设备的尾巴:
cell_id batch  cycle    soh      v
   C005     A      1 0.9997 0.8123
   C005     A      2 0.9995 0.8220
   C005     A      3 0.9993 0.8317
  这样的行一共 1,064 行;它们的真实 soh 均值 = 0.9988,而滚动给出的值是 0.9002(差 0.0986)。
  ⚠️ 关键:这些行在【正确写法里是 NaN】,在错误写法里是一个正常的数。
     所以用 dropna 之后的行数去验算滚动,永远查不出这个错(错误版本反而更「完整」:不分组时 NaN 行数 1,140 → 19)。
  分组键必须是【设备编号】,不是批次、不是工况、不是文件来源。
★ 注意 1,140 → 19 这组数字:
| 写法 | NaN 行数 | 看起来 |
|---|---|---|
| 正确(按设备分组) | 1,140 | "怎么这么多缺失?" |
| 错误(不分组) | 19 | "数据很完整啊" |
⚠️ 这是一个反直觉的结论:
"数据缺得多"可能是做对了;"数据很完整"可能是做错了。
因为
NaN在这里的含义是"我没有足够的历史"—— 一个会诚实说"我不知道"的版本,NaN 本来就该多。
★ 所以判断标准不是"NaN 多不多",而是"NaN 出现在哪":
正确:NaN 出现在【每支设备】最前面的 19 行
错误:NaN 只出现在【整张表】最前面的 19 行
这一条会成为第 6.7 节体检函数的核心。
6.6 ★ 为什么这类错误最危险
这一节回答一个问题:同样是一个 bug,为什么"跨设备串线"值得单独用一章来讲?
危险点一:它不报错
对比一下各种错误的"反馈强度":
| 错误 | 什么时候暴露 | 反馈强度 |
|---|---|---|
| 列名拼错 | KeyError: 'soh_win_meam' | 立刻,无法忽略 |
| 形状不对 | ValueError: Expected 2D array | 立刻 |
| 除以 0 | inf / ZeroDivisionError | 立刻 |
| 类型不对 | TypeError | 立刻 |
| 忘了分组 | 没有任何提示 | 无 |
| 忘了排序 | 没有任何提示 | 无 |
★ 前四类错误是"会喊的",后两类是"不喊的"。
而"不喊的错误"在项目里的存活时间最长 —— 它唯一的暴露途径是 有人恰好去核对了一个具体数字,而那需要运气。
危险点二:数值看起来完全正常
0.8123 这个数满足所有能想到的约束:
落在 0.80 ~ 1.00 之间?        ✅
不是 NaN、不是 inf?           ✅
和相邻行的值接近?(0.8123 → 0.8220)✅
量纲对?                       ✅(无量纲)
统计分布合理? ✅唯一"不对"的地方是它的含义:
它说:"C002 在过去 20 圈的均值是 0.8123"
真相是:"这个数由 C001 的最后 19 圈和 C002 的第 1 圈算出来"
★ 这就是"静默错误"的定义:
一个错误如果不能通过"看结果"发现,就只能通过"看过程"发现。
危险点三:它是局部的,抽查抽不到
被污染的行:1,121 / 69,591 = 1.61%
                ↓
随手抽 10 行检查 → 中招概率 ≈ 1 - 0.9839^10 ≈ 15%
                ↓
85% 的概率你抽查完会得出"没问题"的结论
如果抽查的是 describe() 这种聚合指标,问题更糟:
1,121 行的错值混进 69,591 行里
   ↓
整体均值被拉动约 0.003(相对 0.90 的量级,不到 0.4%)
   ↓
describe() 看不出来
危险点四:连"分数"都不会提醒你
这是本章最后一个、也最反直觉的证据。 把上一章造的 4 列轨迹特征(soh_lag1 / soh_lag5 / soh_win_mean5 / soh_win_std5) 只改一处:去掉 groupby,其余写法完全一样。
真实输出:
=== ⑦ 分数会不会提醒你:不会 ===
  只差「有没有 groupby」,四列轨迹特征里有多少行不一样:
    soh_lag1         不同    59 行(占 0.28%)
    soh_lag5         不同   295 行(占 1.39%)
    soh_win_mean5    不同   295 行(占 1.39%)
    soh_win_std5     不同   406 行(占 1.91%)

  特征集                   写法                行数     测试 R²
  21 列(全安全特征)           分组            19,979  0.999029
  21 列(全安全特征)           不分组           19,979  0.999029
  11 列(基础 + 轨迹)         分组            20,939  0.999081
  11 列(基础 + 轨迹)         不分组           21,234  0.998977
  → 差异都在小数第 5 位:分数【不会提醒你】。
     它不会变差、不会报错、也不会让行数少得可疑(21 列那组行数完全相同)。
★ 读这张表要读三层:
第一层:21 列那一组,两种写法的测试 R² 打印到小数第 6 位完全相同。
0.999029(分组) vs 0.999029(不分组)第二层:为什么看不出差别?因为这个特征集里的差分列(volt_slope20 等) 要求每支设备开头 21 行是 NaN,dropna 会把它们先丢掉 —— 而被串线污染的行正好也都在这前 21 行里:
污染发生在:每支设备第 1~19 行(轨迹列)
dropna 丢掉:每支设备第 1~21 行(因为斜率列要 21 行历史)
                ↓
污染的行 100% 落在被丢掉的行里 → 分数一模一样第三层:换成不那么"宽容"的特征集(11 列),污染就露出一点头了 —— 但也只是 −0.000104:
0.999081 → 0.998977★ 这三层合起来才是这一章最值钱的一句话:
"分数没变"不能证明代码是对的。 在这个数据上,跨设备串线恰好被
dropna掩盖了 —— 如果我没写这一节, 你甚至不会知道它发生过。
危险点五:它会在重构里复发
这类错误不是"写一次就完了",它跟着代码走:
| 场景 | 会发生什么 |
|---|---|
| 换数据源(文件顺序变了) | 排序没了,静默串线 |
多进程/多文件读入再 concat | 设备被切碎、交错 |
| 加了新设备、历史数据回填 | 顺序不再单调 |
从 groupby 改成 pivot / merge | 行顺序被打乱 |
有人"优化"掉了那句看着多余的 sort_values | 全表回归 |
★ 所以正确的做法不是"这次小心一点",而是把这两行固定成模板:
def add_rolling_features(df, cols, w, group="cell_id", order="cycle", shift=1):
    # ★ 这两行是模板的一部分,任何调用方都不需要再想一次
    df = df.sort_values([group, order]).reset_index(drop=True)
    g = df.groupby(group)
    for c in cols:
        base = g[c].transform(lambda s: s.shift(shift)) if shift else df[c]
        df[f"{c}_win_mean{w}"] = base.rolling(w).mean()
    return df
★ 这个模板的哲学是本章的结论:
把"容易忘"变成"不可能忘"。
不是要求每个人每次写
rolling都记得排序分组, 而是让rolling只能通过这个函数被调用。
6.7 三行体检:写完之后自己查一遍
真实输出:
=== ⑥ 三行体检:写完之后自己查一遍 ===
  ① is_monotonic_increasing:每组内 cycle 是否升序
     正确写法:True
     打乱写法:False
  ② NaN 的位置:每组最前面 W-1 行(按 cycle 排)是否恰好为 NaN
     正确写法:NaN 的最大行号(按 cycle 排)=19   ← 恰好是第 19 行
     打乱写法:NaN 的最大行号(按 cycle 排)=1448   ← 散布在整支设备里
     打乱写法里落在最前面 19 行的 NaN 只有 18 / 1140 个 —— 少一个都不是它。
  ③ 窗口均值必须落在窗口内 soh 的最小值与最大值之间(越界即串线)
★ 三项检查放在一起,能抓住不同的错:
| 检查 | 抓什么 | 抓不到什么 |
|---|---|---|
组内 cycle 升序 | 漏排序 | 漏分组 |
NaN 都在组内最前面 W-1 行 | 漏排序 | 漏分组(交界处会被填值) |
| NaN 总数 = 组数 × (W-1) | 漏分组 | 漏排序 |
| 窗口值落在窗口内极值之间 | 严重串线 | 轻微串线 |
★ 关键:没有任何一项能单独兜底。
点开:一个可以抄走的体检函数(第 6.7 节练习 3 会让你自己写一遍)
def check_rolling(frame, value_col, w, group="cell_id", order="cycle"):
    """返回三个布尔量:排序 / NaN 位置 / NaN 总数。三个都 True 才算过。"""
    out = {}
    out["组内按时间升序"] = bool(
        frame.groupby(group)[order].apply(lambda s: s.is_monotonic_increasing).all())

    r = frame.assign(_r=frame.groupby(group)[order].rank())
    nan_rank = r.loc[frame[value_col].isna(), "_r"]
    out["NaN 都在组内最前面"] = bool(len(nan_rank) and nan_rank.max() <= w - 1)

    out["NaN 总数 == 组数 x (w-1)"] = bool(
        int(frame[value_col].isna().sum()) == frame[group].nunique() * (w - 1))
return out在三张表上的实测:
正确表(排序 + 分组)  :{'组内按时间升序': True,  'NaN 都在组内最前面': True,  'NaN 总数 == 组数 x (W-1)': True}
漏了分组(直接 rolling):{'组内按时间升序': True,  'NaN 都在组内最前面': True,  'NaN 总数 == 组数 x (W-1)': False}
漏了排序(分组内乱序) :{'组内按时间升序': False, 'NaN 都在组内最前面': False, 'NaN 总数 == 组数 x (W-1)': True}注意第二行:漏了分组时,"NaN 位置"这一项是 True —— 因为交界处被填上了别人的数据、不再有 NaN, 只有 NaN 总数 这一项抓得住它。
★ 这就是为什么需要三项,而不是一项。
6.8 常见坑
① 直接 df[col].rolling(W)             → 设备交界处串线(1,121 行,单行偏 0.1877)
② 分组了但没排序                       → 相关系数掉到 0.27,NaN 数量却一模一样
③ 按批次/工况分组                      → 批次内部照样串线(1,064 行)
④ 用 dropna 后的行数验算               → 错误版本 NaN 更少(1,140 → 19),反而"更完整"
⑤ 用 groupby().rolling() 直接赋值      → MultiIndex 与原表对不上,报 TypeError
⑥ 以为"分数没变说明没问题"             → 21 列时两种写法 R² 同为 0.999029
⑦ 抽查几行没发现问题就放心             → 中招概率只有 15%
第 ⑦ 条不是玩笑:它说明抽查不是一种验证方法。
抽查能发现的是"高频错误"(每一行都错)
抽查发现不了的是"低频错误"(1.6% 的行错)正确做法是"对答案":拿一支设备、一个位置、手算一次,看代码给不给同一个数。 这件事的成本是 5 分钟,收益是"知道它对不对"。
6.9 完整示例与输出
cd code
python demos/ch06-rolling-groupby.py
真实输出(节选):
=== ① 正确写法:先排序,再按设备分组 ===
   C002      1 1.0000              NaN
  新设备 C002 的前 19 行是 NaN —— 它还没有自己的历史,这是正确的结果。
  全表 NaN 行数:1,140(= 60 支 × 19 行)

=== ② 反面教材 A:不分组,直接 rolling ===
   C001    862 0.8000            0.8025
   C002      1 1.0000            0.8123
  C002 第一行(cycle=1,真实 soh = 1.0000)拿到的窗口均值 = 0.8123

=== ③ 污染规模:多少行被串线,错得有多离谱 ===
  被污染的行:1,121(= 59 × 19),占全表 1.61%
  混进来的那一个值       :0.8123,与真实值差 0.1877 —— 比整表跨度(0.2000)还大。

=== ④ 反面教材 B:分了组,但没排序 ===
  与正确值的相关系数 = 0.2695
  平均偏差 = 0.0485   最大偏差 = 0.1431

=== ⑦ 分数会不会提醒你:不会 ===
  21 列(全安全特征)           分组            19,979  0.999029
  21 列(全安全特征)           不分组           19,979  0.999029

结论:`rolling` 的两条命根子是【分组】和【排序】。
      漏掉分组:1,121 行串线,交界处那个数偏了 0.1877;
      漏掉排序:每个窗口都是随机抽的,相关系数掉到 0.2695。
      两种都【不报错】,这才是它危险的地方。
本章练习
练习 1:groupby().rolling() 与 groupby().transform() 不是一回事
对逐循环表各算一次 20 圈窗口均值:
df.groupby("cell_id")["soh"].rolling(20).mean()df.groupby("cell_id")["soh"].transform(lambda s: s.rolling(20).mean())
打印两者的类型、长度、索引层数,并检查去掉 NaN 后值是否一致; 然后试着把第 1 种结果直接赋给一个新列,看会发生什么(用 try/except 抓住异常并打印), 最后给出两种修法。
参考答案
import os

import numpy as np
import pandas as pd

HERE = os.path.dirname(os.path.abspath(__file__))
CODE = os.path.abspath(os.path.join(HERE, "..", ".."))
RAW_CSV = os.path.join(CODE, "data", "battery", "cycle_raw.csv")

raw = pd.read_csv(RAW_CSV).sort_values(["cell_id", "cycle"]).reset_index(drop=True)
W = 20
multi = raw.groupby("cell_id")["soh"].rolling(W).mean()
flat = raw.groupby("cell_id")["soh"].transform(lambda s: s.rolling(W).mean())

print(f"  groupby().rolling()    :{type(multi).__name__},"
      f"长度 {len(multi):,d},索引层数 {multi.index.nlevels}")
print(f"  groupby().transform()  :{type(flat).__name__},"
      f"长度 {len(flat):,d},索引层数 {flat.index.nlevels}")
print(f"  两者去掉 NaN 后的值是否一致:"
      f"{np.allclose(multi.dropna().to_numpy(), flat.dropna().to_numpy())}")

demo = raw.copy()
try:
    demo["bad_assign"] = multi
    print(f"  直接赋值:居然过了,非空 {int(demo['bad_assign'].notna().sum()):,d} 行")
except Exception as exc:
    print(f"  直接赋值 raw['x'] = groupby().rolling():{type(exc).__name__}")
    print(f"    {exc}")

demo["fix_droplevel"] = multi.droplevel(0)
print(f"  修法一 multi.droplevel(0)        :非空 "
      f"{int(demo['fix_droplevel'].notna().sum()):,d} 行")
demo["fix_reset"] = multi.reset_index(drop=True)
print(f"  修法二 multi.reset_index(drop=True):非空 "
      f"{int(demo['fix_reset'].notna().sum()):,d} 行")
demo["good_assign"] = flat
print(f"  修法三(推荐)transform           :非空 "
f"{int(demo['good_assign'].notna().sum()):,d} 行")期望输出:
=== 练习 1:groupby().rolling() 与 groupby().transform() 不是一回事 ===
  groupby().rolling()    :Series,长度 69,591,索引层数 2
  groupby().transform()  :Series,长度 69,591,索引层数 1
  两者去掉 NaN 后的值是否一致:True
  直接赋值 raw['x'] = groupby().rolling():TypeError
    incompatible index of inserted column with frame index
    ← 索引对不上(原表是单层索引,结果是 MultiIndex),pandas 拒绝写入。
  修法一 multi.droplevel(0)      :非空 68,451 行
  修法二 multi.reset_index(drop=True):非空 68,451 行
  修法三(推荐)transform         :非空 68,451 行
★ 这个报错是"好报错" —— 它立刻拦住了你。
对比一下"老版本 pandas"的行为:以前直接赋值不会报错, 而是按索引对齐,结果一列全是 NaN(因为 MultiIndex 匹配不上单层索引)。
老版本:静默变 NaN → 你可能过一周才发现
新版本:TypeError   → 你 5 秒内就知道
★ 但请看这一章的反面教材:
不是所有错误都这么友好。
rolling忘了分组时,pandas 没有任何意见 —— 它给你一个漂漂亮亮的 0.8123。
练习 2:修好一段不排序、不分组的窗口代码
先故意写错:不排序、不分组,直接 df["soh"].rolling(20).mean()。
- 打印
C002/cycle=1的窗口均值(错误结果); - 修好之后打印同一个位置(应该是
NaN); - 统计"错误写法有值、正确写法应为 NaN"的行数。
要求:说出那个错误值的量级为什么看起来完全合理。
参考答案
import os

import pandas as pd

HERE = os.path.dirname(os.path.abspath(__file__))
CODE = os.path.abspath(os.path.join(HERE, "..", ".."))
RAW_CSV = os.path.join(CODE, "data", "battery", "cycle_raw.csv")

W = 20
bad = pd.read_csv(RAW_CSV)
bad["v_bad"] = bad["soh"].rolling(W).mean()
n1 = int(bad.index[bad["cell_id"] == "C002"][0])

raw = pd.read_csv(RAW_CSV).sort_values(["cell_id", "cycle"]).reset_index(drop=True)
fixed = raw.copy()
fixed["v_ok"] = fixed.groupby("cell_id")["soh"].transform(
    lambda s: s.rolling(W).mean())

print(f"  修复前 C002/cycle=1 的窗口均值 = {bad['v_bad'].iloc[n1]:.4f}"
      f"(真实 soh = {bad['soh'].iloc[n1]:.4f})")
print(f"  修复后 C002/cycle=1 的窗口均值 = "
      f"{fixed[fixed['cell_id'] == 'C002']['v_ok'].iloc[0]}  ← NaN 才对")
j = fixed.merge(bad[["cell_id", "cycle", "v_bad"]], on=["cell_id", "cycle"])
print(f"  被污染的(错误有值、正确应为 NaN)行数:"
f"{int((j['v_bad'].notna() & j['v_ok'].isna()).sum()):,d}")期望输出:
=== 练习 2:修好一段不排序、不分组的窗口代码 ===
  修复前 C002/cycle=1 的窗口均值 = 0.8123(真实 soh = 1.0000)
  修复后 C002/cycle=1 的窗口均值 = nan  ← NaN 才对
  被污染的(错误有值、正确应为 NaN)行数:1,121
③ 为什么 0.8123 看起来完全合理:
它落在全表 soh 的范围(0.8000 ~ 1.0000)里
它不是 NaN,不是 0,不是负数
它甚至比正确值"更平滑"(因为它把一支设备的末期和另一支的初期连起来了)
★ 这件事的教训:
一个特征"看起来合理"的门槛非常低。 真正的门槛是"它的算法能不能被复述", 而"能不能被复述"只能靠手算第 W 行对答案。
练习 3:写一个自动体检函数 check_rolling
实现 check_rolling(frame, value_col, W, group_col="cell_id", order_col="cycle"),返回三个布尔量:
- 每组内
cycle是否升序; NaN是否恰好都在组内最前面W-1行;NaN总数是否等于组数 × (W-1)。
然后造三张表分别跑:正确表 / 漏了分组 / 漏了排序,说明哪一项抓哪一类错误。
参考答案
import os

import pandas as pd

HERE = os.path.dirname(os.path.abspath(__file__))
CODE = os.path.abspath(os.path.join(HERE, "..", ".."))
RAW_CSV = os.path.join(CODE, "data", "battery", "cycle_raw.csv")

W = 20
raw = pd.read_csv(RAW_CSV).sort_values(["cell_id", "cycle"]).reset_index(drop=True)


def check_rolling(frame, value_col, W, group_col="cell_id", order_col="cycle"):
    out = {}
    out["组内按时间升序"] = bool(
        frame.groupby(group_col)[order_col]
        .apply(lambda s: s.is_monotonic_increasing).all())
    r = frame.assign(_r=frame.groupby(group_col)[order_col].rank())
    nan_rank = r.loc[frame[value_col].isna(), "_r"]
    out["NaN 都在组内最前面"] = bool(len(nan_rank) and nan_rank.max() <= W - 1)
    out["NaN 总数 == 组数 x (W-1)"] = bool(
        int(frame[value_col].isna().sum()) == frame[group_col].nunique() * (W - 1))
    return out


fixed = raw.copy()
fixed["v_ok"] = fixed.groupby("cell_id")["soh"].transform(
    lambda s: s.rolling(W).mean())

bad = pd.read_csv(RAW_CSV)
bad["v_bad"] = bad["soh"].rolling(W).mean()

shuffled = raw.sample(frac=1.0, random_state=42).reset_index(drop=True)
shuffled["v"] = shuffled.groupby("cell_id")["soh"].transform(
    lambda s: s.rolling(W).mean())

print(f"  正确表(排序 + 分组)  :{check_rolling(fixed, 'v_ok', W)}")
print(f"  漏了分组(直接 rolling):{check_rolling(bad, 'v_bad', W)}")
print(f" 漏了排序(分组内乱序) :{check_rolling(shuffled, 'v', W)}")期望输出:
=== 练习 3:写一个自动体检函数 check_rolling ===
  正确表(排序 + 分组)  :{'组内按时间升序': True, 'NaN 都在组内最前面': True, 'NaN 总数 == 组数 x (W-1)': True}
  漏了分组(直接 rolling):{'组内按时间升序': True, 'NaN 都在组内最前面': True, 'NaN 总数 == 组数 x (W-1)': False}
  漏了排序(分组内乱序)  :{'组内按时间升序': False, 'NaN 都在组内最前面': False, 'NaN 总数 == 组数 x (W-1)': True}
  → 三项各抓一类错误,没有哪一项能单独兜底:
     「升序」抓漏排序,「NaN 位置」抓漏排序,「NaN 总数」抓漏分组。
★ 这张表最值得看的是"哪一项为 False":
| 表 | 升序 | NaN 位置 | NaN 总数 |
|---|---|---|---|
| 正确 | ✅ | ✅ | ✅ |
| 漏分组 | ✅ | ✅ | ❌ |
| 漏排序 | ❌ | ❌ | ✅ |
★ 一个反直觉的推论:
"NaN 位置对"不代表分组对 —— 漏分组时,交界处被填上了别人的数据, 那些行不再是 NaN,所以"NaN 都集中在开头"这一项反而通过了。
所以体检不能只查一项,也不能只查"看起来可疑的那一项"。
面向工程实践:把"容易忘"变成"不可能忘"
① 三道闸,缺一不可
| 闸 | 做什么 | 在哪一层 |
|---|---|---|
| 模板 | rolling / diff 只能通过一个封装函数调用 | 代码 |
| 体检 | 每次生成特征表后跑 check_rolling 三问 | 测试 |
| 对答案 | 手算一支设备的一个位置,和代码比 | 流程 |
② 为什么"模板"这一道最有效
靠"记得排序分组"      → 100 次里错 1 次,错的那次不会被发现
靠"函数里已经写好"    → 100 次里错 0 次(写错的概率被压到一个地方)
★ 一个可操作的建议:
在你的项目里搜一遍 ".rolling(" 和 ".diff("
   ↓
如果它们出现在业务代码里(而不是一个封装函数里)
   ↓
就说明"排序 + 分组"这件事散落在 N 个地方,N 就是未来的事故数
③ 一个真实的项目故事(这类错误的典型形态)
现象:离线 R² = 0.999,上线后第一周正常
      第二周开始,新上线的设备预测值系统性偏低 0.15
排查:新设备的窗口特征里混进了"训练期那批设备的尾巴"
     → 因为线上是【按文件追加】的,新设备的行紧跟在老设备后面
     → 离线的表是按设备排好序的,线上没有
修复:把"排序 + 分组"写进特征服务,并且加一条断言:
       每支设备的第一条记录,窗口特征必须是空
★ 最后那条断言,就是这一章的全部内容压缩成一行代码:
assert df.groupby("cell_id").head(19)["soh_win_mean"].isna().all(), \
    "窗口跨设备串线了"
④ 这一章的坑在整本书里的位置
第 05 章:rolling 的语义(含当前行 / 攒够才给数)
第 06 章:rolling 的边界(分组 / 排序)        ← 你在这里
第 07 章:rolling 的副作用(冷启动 NaN 怎么处理)
第 10 章:rolling 的方向(shift(1) 少写会怎样)
★ 四章合起来,才是一列"可以放心用的窗口特征"。