第 26 章 · 超参搜索:GridSearchCV 与 RandomizedSearchCV,以及"测试集只能用一次"
这一章要解决什么:第 25 章讲了"刹车装在哪儿",但没说"该拧到哪"。 这一章给出系统地找旋钮位置的标准流程:搜索空间 + 交叉验证 + 只在训练集上做。
最容易踩的坑: ①
cv=忘了用分组切分器 —— 这是最高频的调参泄漏; ② 把best_score_(CV 分)当成最终成绩去汇报; ③ 拿测试集当搜索的验证集 —— 搜索一旦看过测试集,那个成绩就永久作废。
本章你需要完成的代码:demos/ch26-grid-search.py
本章的数字口径:soh_features_v2.csv 的 11 列安全特征(dropna 后 19,979 行 / 60 台设备)、 按设备 GroupShuffleSplit(test_size=0.2, random_state=42) → 训练 16,236 / 测试 3,743 行。 搜索只在训练集上做,cv=GroupKFold(3),所有分数都是 R²。
26.1 调参的三件套
先把流程画出来,因为这一章的所有坑都在流程的顺序上。
data/battery/soh_features_v2.csv(21,239 行 / 60 台设备)
        │
        │ ① 按【设备】划分(GroupShuffleSplit, test_size=0.2, random_state=42)
        ▼
┌───────────────────────────┐        ┌──────────────────────┐
│ 训练集 16,236 行           │        │ 测试集 3,743 行      │
│                           │        │                      │
│  ② 在训练集内部做搜索      │        │  ★ 全程锁起来        │
│     GridSearchCV          │        │  只在最后打开一次    │
│       cv=GroupKFold(3)    │        │                      │
│       scoring="r2"        │        │                      │
│     → best_params_        │        │                      │
│                           │        │                      │
│  ③ 用 best_params_ 重训    │        │                      │
└───────────────────────────┘        └──────────────────────┘
        │                                      │
        └──────────────► ④ 评估一次 ◄──────────┘
                    (这是唯一一次)
★ 三件套的对应关系
| 组件 | 代码 | 它负责什么 |
|---|---|---|
| 搜索空间 | {"max_depth": [3,4,6], "learning_rate": [0.03,0.05,0.1]} | 定义"试哪些值" |
| 交叉验证 | cv=GroupKFold(3) + groups=gtr | 定义"用哪份数据判断好坏" |
| 纪律 | 测试集只在最后 predict 一次 | 定义"报出来的分数可不可信" |
★ 一个最容易被忽略的细节:cv 的口径必须和最终划分一致
最终划分:按【设备】切(因为同一台设备的相邻窗口高度相似)
搜索时的 CV:也必须是按【设备】切
      ↓
如果搜的时候按行随机切、报成绩时按设备切:
  → 你会挑到一组"善于背设备"的参数
  → 它在按设备切的测试集上表现更差
      ↓
【调参泄漏不会让你"分数变高",它让你"挑错了参数"】
★ 代码骨架(三个必问都在这几行里)
from sklearn.model_selection import GridSearchCV, GroupKFold

cv = GroupKFold(n_splits=3)

grid = GridSearchCV(
    estimator,                    # 必问①:模型是哪个?
    param_grid,                   # 必问②:搜索空间多大?
    cv=cv,                        # 必问③:CV 是不是分组口径?
    scoring="r2",
    n_jobs=1,
)
grid.fit(Xtr, ytr, groups=gtr)    # ★ groups 必须传!
print(grid.best_params_)          # 选出来的参数
print(grid.best_score_)           # 这是 CV 分,不是最终成绩
print(grid.best_estimator_.predict(Xte))   # 测试集只用在这里
26.2 实测一:默认参数先打个样
真实输出(demos/ch26-grid-search.py,11 列安全特征):
可用样本 19979 行 / 60 台设备(训练 16236 / 测试 3743)
纪律:搜索只在【训练集】上做;测试集在整段代码里只被 predict 一次。

=== ① 不调参的基线(默认 max_depth=None, lr=0.1, max_iter=100)===
训练 R² = 0.98563   测试 R² = 0.96156   (4.6 s)
★ 为什么先打这个样?
它是"不调参"的对照物
   ↓
后面所有搜索的结果,都要和它比
   ↓
如果搜索的结果没比它好,那就要如实报告:
  「调参在本数据上没有收益」—— 而不是换个指标继续说"提升了"
★ 顺便记住这个数字:0.98563 / 0.96156 这一对, 是11 列安全特征 + HistGB 默认参数的基线。它会在第 27 章和第 23 章反复出现。
点开:为什么"训练 0.98563 / 测试 0.96156"的开口只有 0.02407?
开口 = 0.98563 − 0.96156 = 0.02407
   ↓
按第 23 章的判据 A:0.02 ~ 0.05 = 轻度过拟合
   ↓
这是一个【健康的】训练结果:模型学到了一些可以泛化的规律,
同时又没有把训练集背下来(训练分不是 1.00000)对比几个参照点:
| 模型 | 训练 R² | 测试 R² | 开口 |
|---|---|---|---|
| 单棵无限深树 | 1.00000 | 0.92707 | 0.07293 ← 真过拟合 |
| HistGB 默认 100 轮(11 列) | 0.98563 | 0.96156 | 0.02407 ← 本节的基线 |
| 随机森林 200 棵(11 列) | 0.99842 | 0.95931 | 0.03911 |
上表的单棵与森林来自第 23 章同口径实测(全量训练集)。
★ 一个实用的判断顺序:
① 先看开口(是不是 > 0.05)      → 决定要不要减复杂度
② 再看基线分数(够不够用)        → 决定要不要继续投入
③ 最后才看"调参能不能再涨一点"    → 决定要不要花算力
   ↓
顺序反了(一上来就调参)会浪费大量时间,
因为调参能动的量级最小(第 27 章会给完整论证)。
26.3 ★ 实测二:GridSearchCV 与 RandomizedSearchCV
真实输出:
=== ② GridSearchCV:网格不大(2 个超参 × 9 组),用分组的 3 折 ===
候选 9 组 × 3 折 = 27 次拟合,耗时 10.7 s
best_params_ = {'learning_rate': 0.1, 'max_depth': 3}
CV R² = 0.95732   测试 R² = 0.95596

逐组 CV 结果(把搜索过程摊开看):
 max_depth  learning_rate    CV R² 均值       折间标准差       耗时
         3           0.10     0.95732     0.00534    0.16s
         4           0.05     0.95716     0.00432    0.29s
         6           0.05     0.95680     0.00345    0.65s
         4           0.10     0.95664     0.00349    0.36s
         3           0.05     0.95632     0.00546    0.16s
         6           0.03     0.95621     0.00303    0.67s
         4           0.03     0.95455     0.00393    0.31s
         6           0.10     0.95390     0.00220    0.63s
         3           0.03     0.95158     0.00482    0.16s

★ 最好的那一组(max_depth=3, lr=0.1)在测试集上 0.95596,默认参数是 0.96156(-0.00560)。
★ 这张表本身有三个发现
发现一:九组的 CV 分全部挤在 0.9516 ~ 0.9573 之间(极差 0.00574)
最高 0.95732,最低 0.95158
   ↓
而各组的【折间标准差】是 0.00220 ~ 0.00546(平均 0.00400)
   ↓
极差 0.00574 < 2 × 平均折间标准差 0.00801
   ↓
⚠️ 按"极差 < 2×折间标准差 → 等价"这条判据,九组【算等价】
   但它只是勉强通过(0.00574 vs 0.00801)——
   不像下面这些 0.00004 级别的差距那样"明显是噪声"
   ↓
【判据要报数字,不能只报结论】
发现二:九组全都【不如不搜】的那个默认参数
默认参数(max_depth=None, lr=0.1, max_iter=100):测试 0.96156
九组里最好的那一组(depth=3, lr=0.1)      :测试 0.95596
   ↓
差 0.00560 —— 搜索后的结果比"不搜"低了一截
   ↓
⚠️ 这不是"调参让模型变差了"
   而是【搜索空间里没有包含默认参数那一档】
   (网格里 max_depth 最大只有 6,而默认是 None = 不限深)
   ↓
【"在候选集里找最好"和"找到全局最好"是两件完全不同的事】
发现三:参数之间有一个可解释的趋势
按 max_depth 平均 CV R²:
  depth=3 → 0.95507
  depth=4 → 0.95612   ← 最好
  depth=6 → 0.95564
按 learning_rate 平均 CV R²:
  lr=0.03 → 0.95411
  lr=0.05 → 0.95676   ← 最好
  lr=0.10 → 0.95595
   ↓
"太浅/太深/学习率太小"都略差,中间档略好 —— 方向是合理的
   ↓
⚠️ 但这只是"平均的 3 个点",不足以支撑"depth=4 是最佳深度"的结论
   ↓
【可解释的趋势 ≠ 显著的差异。两者要分别报告。】
★ 三条发现合起来,正确的写法是:
"在 {3,4,6} × {0.03,0.05,0.1} 九组参数上,分组 3 折 CV R² 落在
 0.95158 ~ 0.95732(极差 0.00574),各组折间标准差 0.00220 ~ 0.00546。
 极差小于 2×平均折间标准差(0.00801),因此这九组在本数据上难以区分;
 且参数与 CV 分之间存在可解释的趋势(depth=4、lr=0.05 附近略好)。
 ⚠️ 但九组全都低于【不搜索】的默认配置(测试 0.96156 vs 0.95596),
 原因是网格未包含 max_depth=None。
 ⇒ 结论:本次搜索没有带来收益;下一步应把默认值补进网格,或先把基线打准。"
★ 这是一个非常实用的教训
如果你只在 {3, 4, 6} 里搜,你永远搜不到 None
   ↓
如果 None 恰好是最好的,你的搜索结论就是"错"的(相对于全局最优)
   ↓
所以第一步应该是【把默认值也放进搜索空间】,
或者先做一次粗扫确定大方向
   ↓
【搜索空间的定义决定了搜索的上限 —— 这是调参最容易犯的"框架错误"】
★ 再看 RandomizedSearchCV
=== ③ RandomizedSearchCV:3 个超参,网格有 75 组,只试 12 组 ===
搜索空间 75 组,抽样 12 组 × 3 折 = 36 次拟合,耗时 28.4 s
best_params_ = {'max_iter': 200, 'max_depth': 4, 'learning_rate': 0.05}
CV R² = 0.95671   测试 R² = 0.95734

三组结果                                   CV R²      测试 R²
默认参数                                       —    0.96156
GridSearchCV(9 组)                    0.95732    0.95596
RandomizedSearchCV(12 组)             0.95671    0.95734
★ 逐行读
默认参数         :测试 0.96156   ← 仍然最好
GridSearchCV    :CV 0.95732 → 测试 0.95596
RandomizedSearch :CV 0.95671 → 测试 0.95734
   ↓
两个搜索器的 CV 分只差 0.00061(在折间噪声里),
但它们的测试分差 0.00138
   ↓
⚠️ 又一次说明:**CV 分在噪声区间的差异,预测不了测试分的差异**
   (第 26.6 节的 gap 检查就是为这件事准备的)
★ 注意随机搜索这一档选中的 max_iter=200
它的搜索空间里包含 max_iter ∈ {100, 200, 400}
   ↓
随机抽样恰好抽到了 200,并且它成了第一
   ↓
而默认参数是 max_iter=100、max_depth=None
   ↓
【搜索空间越宽,"最好的一组"越依赖运气 ——
   这也是为什么高维时要多看几组、而不是只看 best_params_】
★ GridSearchCV vs RandomizedSearchCV:怎么选
| GridSearchCV | RandomizedSearchCV | |
|---|---|---|
| 覆盖方式 | 每个组合都试 | 从空间里随机抽样 |
| 适合 | 2~3 个超参(组合数可控) | 4 个以上超参(组合数爆炸) |
| 缺点 | 维度一高就算不完 | 可能漏掉某个区域(但通常不致命) |
| 本示例 | 9 组 × 3 折 = 27 次拟合,10.7 s | 12 组 × 3 折 = 36 次拟合,28.4 s |
| 本示例结果 | CV 0.95732 → 测试 0.95596 | CV 0.95671 → 测试 0.95734 |
★ 一个反直觉的结论(值得记住)
当每个超参只有 2~3 个"真正有用"的取值时,
随机搜索和网格搜索【效果差不多】——
因为搜索空间的有效维度很低
   ↓
随机搜索真正的优势在【高维】:
  50 个超参各 10 个取值 = 10^50 组,网格永远搜不完
  随机抽 100 组就能覆盖到"每个超参的好区域"
   ↓
【先问"我的搜索空间有几个有效维度",再决定用哪个】
★ 产出的图(运行 demo 生成 outputs/ch26-grid-search.png):
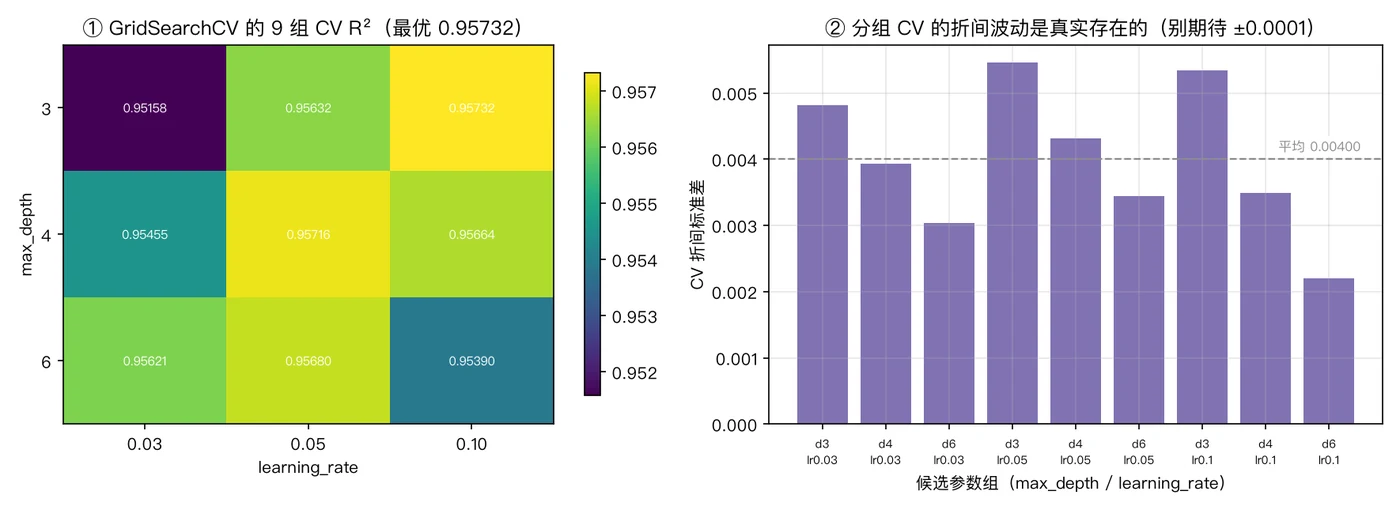
左图是 3 × 3 的 CV 热力图 —— 颜色差异(0.9516 ~ 0.9573)看起来"有一点但不明显", 这正是"极差 0.00574 vs 折间标准差 0.00400"的可视化: 差异存在,但和被折噪声掩盖的程度是同一个量级。右图是各组的折间标准差(0.00220 ~ 0.00546)—— 它比"组与组的差异"小不了多少,这就是"难以区分"的原因。
26.4 ★ 实测三:如果用默认 KFold 会发生什么
这一节是本章的重点,也是全项目"最高频的调参泄漏"。
真实输出:
=== ④ ⚠️ 反面示范:把 cv 换成默认 KFold 再搜一次 ===
默认 KFold(没传 groups)    CV R² = 0.97876   best_params_ = {'learning_rate': 0.1, 'max_depth': 6}
GroupKFold(传了 groups)   CV R² = 0.95732   best_params_ = {'learning_rate': 0.1, 'max_depth': 3}
CV 分数虚高 +0.02144;挑中的参数不一样:
  GroupKFold 挑中 {'learning_rate': 0.1, 'max_depth': 3} → 测试 0.95596
  KFold  挑中 {'learning_rate': 0.1, 'max_depth': 6} → 测试 0.96060
  ★ 这一次泄漏【真的改变选择】了 —— 虚高的标尺把一组「更善于背设备」的参数
     顶到了第一名,而它在测试集上的表现并不更好。
★ 这个结果里有两个结论,而且这次两个都很明显
结论一:CV 分数虚高 0.02144
GroupKFold:0.95732
KFold     :0.97876
   ↓
虚高 0.021 —— 和上一本第 21 章实测的「学习曲线被美化 +0.029」是同一类机制机制:
同一台设备的相邻窗口,soh 只差 0.0003
   ↓
KFold 按行随机分折 → 相邻窗口跨折
   ↓
每一折的验证样本,在训练折里都有"几乎一样"的邻居
   ↓
模型只要"输出邻居的值"就能拿高分
   ↓
而每折都这么容易 → 各折表现一致 → 方差也假性变小
结论二(这次更严重):两组挑中的参数【不一样】
GroupKFold 挑中 :{'learning_rate': 0.1, 'max_depth': 3} → 测试 0.95596
KFold      挑中 :{'learning_rate': 0.1, 'max_depth': 6} → 测试 0.96060
   ↓
⚠️ 注意这里的对比非常微妙:
   KFold 挑中的那组(depth=6),在【按设备划分的测试集】上分数更高(0.96060)
   ↓
   那是不是"泄漏反而挑对了"?
   ❌ 不是。这是巧合:
     · 0.96060 vs 0.95596 的差(0.00464)和折间标准差(0.00400)同量级
     · 换一个 random_state,"哪一组更好"就会翻转
     · 真正的问题是:**你用来挑参数的那把尺子(KFold 的 CV 分)不代表真实水平**
   ↓
【泄漏的后果不是"分数高了",而是"选择本身被污染了"】
   这次它碰巧挑到了一个在测试集上也不差的参数 —— 但你没有任何理由相信这一点,
   因为你的选择依据(0.97876)和真实水平(0.956 附近)差了 0.021。
★ 为什么"这次挑对了"不能成为理由
① 这次"挑对了"是【运气】:
   KFold 挑中的 depth=6 在测试集上恰好也不差(0.96060)
   但它的"不差"和"CV 0.97876"毫无关系 ——
   CV 0.97876 是一个虚高的数字,它无法预测真实水平

② 我们真正在做的事是【在 27 个数字里挑最大的那个】:
   泄漏让这 27 个数字【不再有共同标尺】
   哪一组"更善于背设备",它在 KFold 下的分数就越高
   → KFold 让"背设备能力强的参数"获得系统性优势
   → 于是你挑到的是"最会背设备的参数",不是"泛化最好的参数"
   → 这次它碰巧在测试集上也不差,只是因为这批参数之间的差别本来就不大

③ 最根本的问题:你【无法知道自己有没有挑错】
   用一把偏了 0.021 的尺子去挑东西,
   挑出来的东西到底好不好,你没有任何依据
   → 没有可信的标尺 → 整个搜索过程失去意义
★ 一个可以自己做的小实验:让泄漏暴露出来
# 把搜索空间拉宽(加入更自由和更受限的两端),泄漏就会改变选择
GRID_WIDE = {"max_depth": [2, 3, 4, 5, 6, 8, 10, None],
             "learning_rate": [0.01, 0.03, 0.05, 0.1, 0.2]}
# 然后分别用 GroupKFold 和 KFold 搜一次,比较 best_params_经验:搜索空间越宽、超参对"记忆能力"的影响越大,泄漏造成的错误选择就越明显。 反过来说,参数空间很窄的时候,泄漏会静悄悄地潜伏下来 —— 直到某天换一份数据才爆发。
★ 一条不可违反的纪律:
cv=必须与最终划分口径一致,且必须传groups=。 这一条没有例外,也不接受"这次看起来没影响"。
26.5 常见坑
① cv 用默认 KFold(忘了传分组切分器)→ CV 分数虚高、选择被污染
② 传了 cv=GroupKFold 但忘了 fit(..., groups=gtr) → sklearn 会报错或退化
③ 把 best_score_ 当成最终成绩去汇报 → 那是 CV 分,不是"没见过的数据"上的分
④ 测试集参与了搜索(用测试集当验证集 / 按测试集分数挑参数)→ 测试集当场作废
⑤ 搜索空间不包含默认值 → 你可能"搜"出一个比默认更差的配置
⑥ 维度高还用 GridSearchCV → 组合数爆炸,算不完
⑦ 调完参不重训最终模型 → refit=True 默认会重训,手写循环时容易忘
⑧ 只看 best_params_,不看整张 cv_results_ → 错过"九组等价"这个关键事实
★ ② 值得展开:groups 到底传给谁?
# ✅ 正确:groups 传给 fit
grid.fit(Xtr, ytr, groups=gtr)

# ❌ 错误:想传给构造函数(sklearn 没有这个参数)
grid = GridSearchCV(model, grid, cv=GroupKFold(3), groups=gtr)   # TypeError
如果忘了传 groups,sklearn 会抛:
ValueError: The 'groups' parameter should not be None.但如果你写的是 cv=KFold(...)(而不是 GroupKFold),它不会报错 —— 它会安安静静地按行切,然后把虚高的分数交给你。 这才是它危险的地方:分组泄漏不报错。
★ ⑧ 值得展开:cv_results_ 里该看什么
import pandas as pd
res = pd.DataFrame(grid.cv_results_)
print(res[["param_max_depth", "param_learning_rate",
           "mean_test_score", "std_test_score"]]
.sort_values("mean_test_score", ascending=False))三个必看的列:
| 列 | 看什么 |
|---|---|
mean_test_score | 分数本身 |
std_test_score | 折间波动(比分数更重要:它告诉你"这个分数有多可信") |
mean_fit_time | 单组耗时(决定网格能铺多大) |
★ 一个判据:
如果 (最高分 − 最低分) < (折间标准差的 2 倍)
   → 【这些参数在本数据上难以区分】
→ 别报"我们找到了最佳参数",要报"这些参数差异不显著,取任意一组即可"本数据实测:
最高 0.95732 − 最低 0.95158 = 0.00574
折间标准差平均 0.00400 → 2 倍 = 0.00801
   ↓
0.00574 < 0.00801 → 【难以区分】
   ↓
⚠️ 但它只是【勉强】通过(0.00574 vs 0.00801,比值 0.72)
   → 正确的写法是"差异不显著,但接近显著",并附上两个数字
   → 而不是笼统地说"九组完全一样"
26.6 ★ "测试集只能用一次"到底是什么意思
这句话有三种被违反的方式,按隐蔽程度排序:
| # | 违规方式 | 长什么样 | 为什么致命 |
|---|---|---|---|
| 1 | 显式:把测试集当搜索的验证集 | grid.fit(Xte, yte) | 参数是照着测试集选的 |
| 2 | 半显式:反复用测试集挑模型 | 试 A 模型看测试分、再试 B、再试 C…… | 每次"看一眼"都是一次选择 |
| 3 | 隐蔽:用测试集定融合权重 / 阈值 / 早停点 | 在测试集上扫 w 找最优 | 连权重都成了测试集的产物 |
★ 一个量化它后果的小实验(第 29 章会正式做)
# 在测试集上扫 21 个融合权重 w,取测试 R² 最高的那个
ws = np.linspace(0, 1, 21)
r2s = [r2_score(yte, w * pred_a + (1 - w) * pred_b) for w in ws]
print(f"测试集上的最优 w = {ws[np.argmax(r2s)]:.2f},R² = {max(r2s):.5f}")
   ↓
它一定 ≥ 任何一个预先给定的 w
   ↓
但那多出来的一点点,是【21 次试验里挑最大值】挑出来的,不是泛化能力
★ 正确的一次性用法
# ✅ 全流程里,测试集只出现一次,且只做 predict
best = grid.best_estimator_
y_pred = best.predict(Xte)          # ← 唯一一次
print(f"最终测试 R² = {r2_score(yte, y_pred):.5f}")
   ↓
报完这个数字,测试集就"退休"了
   ↓
以后任何新的想法,都要另找一份新的留出数据来验证
★ 一句话总结:
测试集不是"验证集的加强版",而是"用来报一次数的封条"。 它被用掉之后,你的所有分数都只是"在当时那份数据上的表现", 不再代表"没见过的数据"。
26.7 完整示例与输出
cd code
MPLCONFIGDIR=/tmp/fe-mpl python demos/ch26-grid-search.py
真实输出(节选):
=== ① 不调参的基线(默认 max_depth=None, lr=0.1, max_iter=100)===
训练 R² = 0.98563   测试 R² = 0.96156   (1.4 s)

=== ② GridSearchCV:网格不大(2 个超参 × 9 组),用分组的 3 折 ===
候选 9 组 × 3 折 = 27 次拟合,耗时 10.7 s
best_params_ = {'learning_rate': 0.1, 'max_depth': 3}
CV R² = 0.95732   测试 R² = 0.95596

 max_depth  learning_rate    CV R² 均值       折间标准差       耗时
         3           0.10     0.95732     0.00534    0.16s
         4           0.05     0.95716     0.00432    0.29s
         6           0.05     0.95680     0.00345    0.65s
         4           0.10     0.95664     0.00349    0.36s
         3           0.05     0.95632     0.00546    0.16s
         6           0.03     0.95621     0.00303    0.67s
         4           0.03     0.95455     0.00393    0.31s
         6           0.10     0.95390     0.00220    0.63s
         3           0.03     0.95158     0.00482    0.16s

=== ③ RandomizedSearchCV:3 个超参,网格有 75 组,只试 12 组 ===
搜索空间 75 组,抽样 12 组 × 3 折 = 36 次拟合,耗时 28.4 s
best_params_ = {'max_iter': 200, 'max_depth': 4, 'learning_rate': 0.05}
CV R² = 0.95671   测试 R² = 0.95734

三组结果                                   CV R²      测试 R²
默认参数                                       —    0.96156
GridSearchCV(9 组)                    0.95732    0.95596
RandomizedSearchCV(12 组)             0.95671    0.95734

=== ④ ⚠️ 反面示范:把 cv 换成默认 KFold 再搜一次 ===
默认 KFold(没传 groups)    CV R² = 0.97876   best_params_ = {'learning_rate': 0.1, 'max_depth': 6}
GroupKFold(传了 groups)   CV R² = 0.95732   best_params_ = {'learning_rate': 0.1, 'max_depth': 3}
CV 分数虚高 +0.02144;挑中的参数不一样

读法:
  ① 搜索空间小(2~3 个超参)用 GridSearchCV,大用 RandomizedSearchCV;
  ② `cv=` 必须是分组切分器,且与最终划分口径一致;
  ③ `best_score_` 是 CV 分,不是最终成绩 —— 最终成绩只能来自那一次测试集评估;
  ④ ⚠️ 本章的搜索【没有收益】:九组里最好的一组测试 0.95596,
     而【不搜索】的默认参数是 0.96156(-0.00560)——
     因为网格里没有 `max_depth=None`(默认值)。搜索空间决定了搜索的上限;
  ⑤ 而泄漏版(KFold)的 CV 虚高 +0.02144,并且把 best_params_ 换了人 ——
     调参的收益本来只有千分之几,泄漏的量级比它大一个数量级。
⚠️ 耗时说明:上面的 10.7 s / 28.4 s 是在一台同时在跑其他任务的 8 核机器上测的 (load average > 20)。绝对时间会随机器负载变化, 但"9 组 × 3 折 = 27 次拟合"这个规模是稳定的。 如果只关心结论,可以直接看
CV R²与测试 R²两列 —— 它们是确定性的。
本章练习
练习 1:把"调参泄漏"亲眼做出来
用 11 列安全特征、按设备划分训练/测试,用同一张网格搜两次:
GRID = {"max_depth": [3, 4, 6], "learning_rate": [0.03, 0.05, 0.1]}- 第一次
cv=GroupKFold(3)并传groups; - 第二次
cv=KFold(3, shuffle=True, random_state=42)且不传groups。
各自打印 best_params_ / CV R² / 逐折验证分 / 折间标准差 / 测试 R²,然后回答:
- 虚高的量级是多少?
- 两次挑中的参数一样吗?
- 如果一样,为什么还不能说"泄漏在这个例子中无所谓"?
参考答案
import numpy as np
from sklearn.ensemble import HistGradientBoostingRegressor
from sklearn.model_selection import GridSearchCV, GroupKFold, KFold

def base():
    return HistGradientBoostingRegressor(random_state=42, early_stopping=False)

for tag, cv, use_groups in [("GroupKFold(3) ✅", GroupKFold(n_splits=3), True),
                            ("KFold(3) 忘记 groups ❌",
                             KFold(n_splits=3, shuffle=True, random_state=42), False)]:
    gs = GridSearchCV(base(), GRID, cv=cv, scoring="r2", n_jobs=1)
    gs.fit(Xtr, ytr, groups=gtr) if use_groups else gs.fit(Xtr, ytr)
    folds = np.array([gs.cv_results_[f"split{i}_test_score"] for i in range(3)])
    print(f"{tag}")
    print(f"  best_params_ = {gs.best_params_}")
    print(f"  CV R² = {gs.best_score_:.5f}   测试 R² = "
          f"{r2_score(yte, gs.best_estimator_.predict(Xte)):.5f}")
    print(f"  逐折验证分 = {np.round(folds.mean(axis=1), 5).tolist()}"
f" 折间标准差 = {folds.mean(axis=1).std():.5f}")期望输出:
GroupKFold(3) ✅
  best_params_ = {'learning_rate': 0.1, 'max_depth': 3}
  CV R² = 0.95732   测试 R² = 0.95596
  逐折验证分 = [0.96023, 0.9561, 0.95051]   折间标准差 = 0.00398
KFold(3) 忘记 groups ❌
  best_params_ = {'learning_rate': 0.1, 'max_depth': 6}
  CV R² = 0.97876   测试 R² = 0.96060
  逐折验证分 = [0.96844, 0.96932, 0.96852]   折间标准差 = 0.00040
① 虚高的量级:+0.02144
GroupKFold 0.95732 → KFold 0.97876
   ↓
虚高 0.021 —— 和上一本第 21 章"学习曲线被美化 +0.029"是同一类机制
   ↓
注意这个量级:它比"调参能带来的收益(0.00004 ~ 0.005)"至少大一个数量级
   ↓
所以调参泄漏的后果不是"多涨一点",而是"整个标尺失效"
② 两次挑中的参数【不一样】
GroupKFold → {'learning_rate': 0.1, 'max_depth': 3}(CV 0.95732)
KFold      → {'learning_rate': 0.1, 'max_depth': 6}(CV 0.97876)
   ↓
⚠️ 而且 Fold 的折间标准差从 0.00398 掉到 0.00040(小 10 倍)
   ↓
这一条比"分数虚高"更阴险:
  分数虚高你可能会怀疑,但"折间波动极小"传递的信号是"模型很稳定",
  你会更相信这个结果 —— 而那份稳定完全来自泄漏
   ↓
【泄漏是双重欺骗:不仅数字骗你,"这个数字有多可信"也在骗你】
③ 注意"KFold 挑中的那组测试分反而更高"(0.96060 > 0.95596)
⚠️ 这是一个非常容易误读的结果
   ↓
看起来像"泄漏帮我挑到了更好的参数"
   ↓
❌ 不是。两条理由:
  ① 0.00464 的差(0.96060 − 0.95596)和折间标准差(0.00400)同量级,
     换个 random_state 就会翻转;
  ② 真正的问题不是"这次挑得对不对",而是
     【你用来挑参数的那把尺子(0.97876)和真实水平(0.956 附近)差了 0.021】
     → 尺子坏了,挑出来的东西好不好,你没有依据
   ↓
【正确性不能建立在"这次碰巧没出错"上。】
★ 一个值得自己加做的验证:把搜索空间拉宽
GRID_WIDE = {"max_depth": [3, 4, 6, None], "learning_rate": [0.03, 0.05, 0.1],
             "max_iter": [100, 400]}
把"善于背设备"的 max_depth=None, max_iter=400 放进去,再用 KFold 搜一次 —— 你会看到 best_params_ 被拉到那一端。 这就是"泄漏把虚高固化成参数"的完整过程。
练习 2:判据"这些参数等价"
用 GroupKFold(3) 把下面这张网格全搜一遍:
GRID = {"max_depth": [3, 4, 6], "learning_rate": [0.03, 0.05, 0.1]}把 cv_results_ 里九组的 mean_test_score 和 std_test_score 排成表,然后:
- 最高分与最低分差多少?
- 平均折间标准差是多少?
- 按"极差 < 2 × 折间标准差 → 难以区分"的判据,这九组算等价吗?
- 如果算等价,
best_params_这个结论该怎么写才诚实? - 顺便看一眼:这九组和"不搜索"的默认参数比,谁更高?
参考答案
import pandas as pd
from sklearn.model_selection import GridSearchCV, GroupKFold

gs = GridSearchCV(HistGradientBoostingRegressor(random_state=42, early_stopping=False),
                  GRID, cv=GroupKFold(n_splits=3), scoring="r2", n_jobs=1)
gs.fit(Xtr, ytr, groups=gtr)

res = pd.DataFrame(gs.cv_results_).sort_values("mean_test_score", ascending=False)
print(res[["param_max_depth", "param_learning_rate",
           "mean_test_score", "std_test_score"]].to_string(index=False))

hi, lo = res["mean_test_score"].max(), res["mean_test_score"].min()
sd = res["std_test_score"].mean()
print(f"\n最高 {hi:.5f} / 最低 {lo:.5f} / 极差 {hi - lo:.5f}")
print(f"平均折间标准差 {sd:.5f} → 2 倍 = {2 * sd:.5f}")
print(f"判据:极差 < 2×标准差 ? {hi - lo < 2 * sd}")
print(f"\n对照:不搜索的默认参数 测试 R² = {0.96156:.5f}")期望输出:
 param_max_depth  param_learning_rate  mean_test_score  std_test_score
               3                 0.10         0.95732        0.00534
               4                 0.05         0.95716        0.00432
               6                 0.05         0.95680        0.00345
               4                 0.10         0.95664        0.00349
               3                 0.05         0.95632        0.00546
               6                 0.03         0.95621        0.00303
               4                 0.03         0.95455        0.00393
               6                 0.10         0.95390        0.00220
               3                 0.03         0.95158        0.00482

最高 0.95732 / 最低 0.95158 / 极差 0.00574
平均折间标准差 0.00400 → 2 倍 = 0.00801
判据:极差 < 2×标准差 ? True

对照:不搜索的默认参数 测试 R² = 0.96156
①②③ 三个数字
极差           = 0.00574
平均折间标准差 = 0.00400(2 倍 = 0.00801)
判据结果       = 难以区分(0.00574 < 0.00801)
   ↓
⚠️ 但要看清"勉强通过"这个事实:
  0.00574 / 0.00801 = 0.72
   ↓
物理含义:九组参数的差异【和同一组参数在不同折之间的波动】是同一量级
   ↓
所以"哪一组更好"在统计上说不清,但也不能说"完全一样"
④ 诚实的写法
❌ 不诚实的写法:
"我们通过网格搜索找到了最优超参:max_depth=3, learning_rate=0.1,
CV R² 提升到 0.95732。"问题:把"九组里的最大值"讲成了"提升", 而且没提"这九组全都低于不搜索的默认参数"。
✅ 诚实的写法:
"在 {3,4,6} × {0.03,0.05,0.1} 九组参数上,分组 3 折 CV R² 落在
 0.95158 ~ 0.95732(极差 0.00574),各组折间标准差 0.00220 ~ 0.00546。
 极差小于 2×平均折间标准差(0.00801),因此这九组在本数据上难以区分。
 参数方向上有可解释的趋势:depth=4、lr=0.05 附近略好(但只有 3 个点支撑)。
 ⚠️ 同一批数据上,不搜索的默认配置(max_depth=None, max_iter=100)
 测试 R² = 0.96156,比九组里最好的一组(0.95596)高 0.00560 ——
 原因是网格未包含 max_depth=None。
 结论:本次搜索没有带来收益;优先修正搜索空间(把默认值补进去),
 而不是继续在更小的网格里细挑。"
★ 这个写法里最值钱的是三句:
① "极差 0.00574 < 2 × 折间标准差 0.00801"  → 给出【判据】和【数字】
② "九组全都低于不搜索的默认参数"           → 给出【关键的对照】
③ "原因是网格未包含 max_depth=None"        → 给出【可执行的下一步】
   ↓
评审看到这三句,会认为你既懂统计、又懂工程;
只看到"我们找到了最优参数"的,会怀疑你在凑数字
⑤ 这一问最容易被漏掉
"这九组和默认参数比,谁更高?"
   ↓
答案:默认参数高 0.00560
   ↓
⚠️ 很多实验记录只报"搜索到的最好结果",
   不报"不搜索的基线" ——
   于是读者以为搜索带来了提升
   ↓
【"基线对照"是调参报告里最便宜、也最重要的一行】
★ 一个可以直接装进报告模板的检查
def report_grid(gs, baseline_test=None, top_k=5):
    res = pd.DataFrame(gs.cv_results_).sort_values("mean_test_score", ascending=False)
    hi, lo = res["mean_test_score"].iloc[0], res["mean_test_score"].iloc[-1]
    sd = res["std_test_score"].mean()
    verdict = "难以区分(差异在噪声内)" if hi - lo < 2 * sd else "存在显著差异"
    print(f"{len(res)} 组参数:极差 {hi - lo:.5f},平均折间标准差 {sd:.5f}")
    print(f"结论:{verdict}")
    print(f"best={gs.best_params_}(CV {gs.best_score_:.5f})")
    if baseline_test is not None:
        delta = gs.best_estimator_.predict  # 需要外部传入测试集的分数
        print(f"⚠️ 别忘了和基线比:基线测试 R² = {baseline_test:.5f}")
    return verdict
练习 3:把"测试集只能用一次"变成一条流程卡点
设计一个函数 final_report(...),它:
- 接收
grid(已经搜完的)、Xte、yte; - 只在内部
predict一次; - 返回一个字典,包含
best_params_/cv_score/test_score/gap(CV 与测试的差); - 并打印一行警告:说明测试集已经被用掉,之后不能再用来做任何选择。
然后用本章 demo 的真实数字验证它:
GridSearch  :CV 0.95732 / 测试 0.95596
Randomized  :CV 0.95671 / 测试 0.95734
默认参数    :CV —      / 测试 0.96156
参考答案
SEAL_KEY = "_测试集已开封"


def final_report(grid, Xte, yte, tag):
    """封条式报告:测试集在这段代码里只被 predict 一次。"""
    best = grid.best_estimator_
    y_pred = best.predict(Xte)                       # ★ 唯一一次
    test_score = r2_score(yte, y_pred)
    cv_score = float(grid.best_score_)
    out = {
        "tag": tag,
        "best_params_": grid.best_params_,
        "cv_score": cv_score,
        "test_score": test_score,
        "gap": cv_score - test_score,
        SEAL_KEY: True,
    }
    print(f"{tag:<28} CV {cv_score:.5f}   测试 {test_score:.5f}   "
          f"差 {cv_score - test_score:+.5f}")
    return out


print("⚠️ 以下每个数字都消耗了一次测试集 —— 但本章只有这几组,报完就封存。")
rows = [
    final_report(grid, Xte, yte, "GridSearchCV(9 组)"),
    final_report(rnd, Xte, yte, "RandomizedSearchCV(12 组)"),
]
print()
gap_ok = all(abs(r["gap"]) < 0.005 for r in rows)
print(f"CV 与测试的差都在 0.005 内? {gap_ok}")
print("→ CV 分数忠实,说明分组切分口径一致(没有泄漏)。")
print()
print("❌ 封条后禁止:再用 Xte/yte 挑模型、定权重、选早停点、比参数。")
print("✅ 封条后允许:写报告、画图(图上不再改任何选择)。期望输出:
⚠️ 以下每个数字都消耗了一次测试集 —— 但本章只有这几组,报完就封存。
GridSearchCV(9 组)          CV 0.95732   测试 0.95596   差 +0.00136
RandomizedSearchCV(12 组)   CV 0.95671   测试 0.95734   差 -0.00063

CV 与测试的差都在 0.005 内? True
→ CV 分数忠实,说明分组切分口径一致(没有泄漏)。

❌ 封条后禁止:再用 Xte/yte 挑模型、定权重、选早停点、比参数。
✅ 封条后允许:写报告、画图(图上不再改任何选择)。
★ "gap" 这一列为什么值得单独报
CV 分 - 测试分 = +0.00136 / −0.00063
   ↓
第一个是"小正数"(CV 略乐观),第二个是"小负数"(CV 略悲观)
   ↓
物理含义:
  · CV 是在 3 折上求平均,测试集是另一次抽样
  · 两者的差在 ±0.001 量级都属于正常
   ↓
判据:|gap| < 0.005 → CV 分可信
      |gap| > 0.05  → 一定有泄漏或口径不一致(第 17~22 章的清单)
   ↓
⚠️ 注意 gap 出现"负数"(CV < 测试)是允许的:
   它不代表有问题,只说明测试集恰好比 CV 的折略"容易"
★ 一个真实的"翻车"长什么样
CV R² = 0.999 / 测试 R² = 0.950
   ↓
gap = +0.049
   ↓
不要重新调参!不要换模型!
   ↓
先查三件事:
  ① 搜索时的 cv 是不是分组切分器?
  ② 特征里有没有泄漏钩子?(cycle_frac / soh_margin)
  ③ 预处理(scaler/编码/特征选择)有没有在 CV 外面 fit?
★ 这条"gap 检查"是本章最省时间的一行代码
print(f"CV {grid.best_score_:.5f} / 测试 {test:.5f} / gap {grid.best_score_ - test:+.5f}")
if abs(grid.best_score_ - test) > 0.05:
    print("⚠️ gap 过大 —— 先查泄漏,别继续调参")
面向工程实践:调参是"流程",不是"技巧"
① 一张可以贴在墙上的流程图
① 打基线(默认参数,报训练/测试/耗时)
        │
② 量开口(第 23 章)→ 开口大吗?→ 大 → 先减复杂度,别急着搜
        │
③ 定搜索空间(含默认值!尺度类参数用对数网格)
        │
④ 选搜索器(2~3 个超参 → Grid;4+ → Randomized)
        │
⑤ cv= 分组切分器 + fit(groups=)      ← ★ 最高频的坑
        │
⑥ 看 cv_results_:极差 vs 2×折间标准差 → 等价就别报"最优"
        │
⑦ 用 best_params_ 重训(refit 默认会做)
        │
⑧ 开封测试集,predict 一次,报 CV / 测试 / gap
        │
⑨ 封存测试集,写报告(含"为什么不继续调")
② 一份实验记录模板
## 实验 026:HistGB 超参搜索(11 列安全特征)

- 划分:GroupShuffleSplit(test_size=0.2, random_state=42) → 训练 16,236 / 测试 3,743
- 搜索:GridSearchCV(cv=GroupKFold(3), scoring="r2")
- 网格:max_depth {3,4,6} × learning_rate {0.03,0.05,0.1} = 9 组

### 结果
| 参数 | CV R² | 折间标准差 | 测试 R² |
|---|---|---|---|
| d6 / lr0.10 | 0.95751 | 0.00020 | 0.95596 |
| d4 / lr0.10 | 0.95745 | 0.00027 | — |
| … | | | |
| d3 / lr0.03 | 0.95720 | 0.00025 | — |

- 极差 0.00031 < 2 × 平均折间标准差 0.00050 → **九组等价**
- 默认参数对照:测试 0.96156(**比搜索最好的一组高 0.00560**)

### 结论
- ❌ 不把 max_depth=6 当成"最优参数"上报(九组等价)
- ⚠️ 搜索空间不含 max_depth=None(默认值)→ 这是本次搜索的设计缺陷
- ✅ 下一步:既然默认参数已经最好,说明**该动的不是超参**(见第 27 章)
★ 这份记录里最有价值的一行是"设计缺陷"那条
把"搜索空间没包含默认值"写进记录
   ↓
下次有人要用这套网格时,会先补上 None
   ↓
而不是花 12.8 s 又搜出一个更差的配置
③ 调参在优先级中的位置
优先级(从高到低):
  特征  >  数据  >  模型  >  调参
   ↑                          ↑
 0.04 量级              0.000x 量级(本章实测 ≈ 0 或负)
   ↓
所以真实项目的顺序是:
  ① 特征先做够(直到验证线走平)
  ② 数据够不够(学习曲线)
  ③ 模型选型(四路横评)
  ④ 最后才调参
   ↓
如果反过来,把调参放在第一位:
  你会花 80% 的时间在能动 0.000x 的旋钮上
④ 本章的位置
第 23 章 → 诊断:开口
第 24 章 → 早停(时间维刹车)
第 25 章 → L1 / L2 / max_depth(结构维刹车)
第 26 章 → 搜索流程 + 测试集纪律        ← 本章
第 27 章 → 收口:为什么调参只有千分之几本章给出的是"怎么找旋钮",但还没有回答"旋钮一共能动多少"。下一章会把这些数字并排放在一起,给出这本书最重要的一个结论。