第 13 章 · ColumnTransformer:把预处理焊进 Pipeline
这一章要解决什么:前两章的缩放和编码都是"手工分头做"的 —— 手工挑列、手工拼表、手工决定谁先谁后。真实项目里必须把它们合成一个对象, 因为它要作为一个整体进入
Pipeline,让交叉验证、网格搜索、上线部署 都在每一折内部重新学一遍均值/标准差/类别表。最容易踩的坑: ① 在交叉验证外面把整表
fit_transform好 —— 第 19 章会量化这个泄漏; ② 忘了点名列 —— 它不报错,而是静默丢掉(13.5 有实测); ③ 以为Pipeline也有coef_—— 它是AttributeError,正确写法是named_steps。
本章你需要完成的代码:demos/ch13-column-transformer.py
13.1 一个对象描述"哪列走哪条路"
先看这段声明:
from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import OneHotEncoder, StandardScaler

pre = ColumnTransformer(
    [("num", StandardScaler(), NUM_COLS),                                    # 数值列
     ("cat", OneHotEncoder(handle_unknown="ignore", sparse_output=False),    # 类别列
      CAT_COLS)],
    verbose_feature_names_out=False,      # 输出列名不带 num__ / cat__ 前缀
)
pre.set_output(transform="pandas") # 输出直接是 DataFrame这段代码只说了三件事:
① 数值列(7 列)走 StandardScaler
② 类别列(2 列)走 OneHotEncoder
③ 两个结果【横向拼起来】
没有循环、没有手工切片、没有 pd.concat —— 因为"哪列走哪条路"是一份声明, 不是一个过程。
真实输出:
① 一个对象吃掉所有列

  输入 (17244, 9)  →  ColumnTransformer  →  输出 (17244, 14)

  输出列名(14 列):
     0  cycle
     1  mean_charge_voltage_v
     2  mean_temp_rise_c
     3  resistance_mohm
     4  coulombic_eff
     5  cap_fade_rate_ah_per_100
     6  temp_std_c
     7  batch_A
     8  batch_B
     9  batch_C
    10  batch_D
    11  test_condition_fast
    12  test_condition_hot
    13  test_condition_std

  前 3 行(保留 3 位小数):
     cycle  mean_charge_voltage_v  mean_temp_rise_c  resistance_mohm  coulombic_eff  cap_fade_rate_ah_per_100  temp_std_c  batch_A  batch_B  batch_C  batch_D  test_condition_fast  test_condition_hot  test_condition_std
255 -1.615                 -1.305            -0.248           -1.494          1.496                     -2.01      -0.245      0.0      1.0      0.0      0.0                  1.0                 0.0                 0.0
256 -1.603                 -1.077            -0.570           -1.537          1.870                     -2.01      -0.200      0.0      1.0      0.0      0.0                  1.0                 0.0                 0.0
257 -1.597                 -1.351            -0.478           -1.550          1.496                     -2.01      -0.180      0.0      1.0      0.0      0.0                  1.0                 0.0                 0.0

  ★ num 那一段是标准化之后的 z 值;cat 那一段是 0/1 —— 两种预处理在同一张表里共存。
★ 这张表读三个地方:
| 看什么 | 数字 | 说明 |
|---|---|---|
| 前 7 列 | cycle = −1.615 这种小数 | 它们是 z 值(均值 0、标准差 1),不是原始单位 |
| 后 7 列 | 全是 0.0 / 1.0 | 独热列;每行在 batch 段恰好 1 个 1,在 test_condition 段恰好 1 个 1 |
| 列数 | 9 → 14 | 7 个数值列 + 4 个批次列 + 3 个工况列 |
★ 一个必须知道的口径:
输入是 DataFrame + 列名 → ColumnTransformer 按【列名】对齐
输入是 numpy 数组       → 只能按【整数下标】对齐
    ↓
所以给 ColumnTransformer 喂 DataFrame 是工程上的默认选择:
列改名(或位置变化)时,它要么继续正确,要么当场报错,不会静默算错
(13.6 会看到它报错的样子)
13.2 焊进 Pipeline:两条规则
from sklearn.pipeline import Pipeline

pipe = Pipeline([("pre", pre),
                 ("model", RandomForestRegressor(n_estimators=200,
                                                 random_state=42, n_jobs=-1))])
pipe.fit(Xtr, ytr)          # pre 先 fit_transform,model 只 fit
pipe.predict(Xte) # pre 只 transform(用训练集学的参数),model 再 predict真实输出:
② 焊进 Pipeline:两条规则

  pipe.fit(Xtr, ytr)      →  pre 先 fit_transform,model 只 fit
  pipe.predict(Xte)       →  pre 只 transform(用【训练集】学的参数),model predict

  随机森林 测试 R² = 0.96092    4.71s

  随便换最后一步,前面的预处理一个字都不用改:
    线性回归         测试 R² = 0.93971
    Ridge(alpha=1) 测试 R² = 0.93972

  ❌ 直接对 Pipeline 取 coef_:
     AttributeError: 'Pipeline' object has no attribute 'coef_'
  ✅ 正确写法:pipe.named_steps["model"].coef_(注意它是【标准化尺度】的系数,见第 11 章)
★ 两条规则就是"不可能泄漏"的全部机制:
pipe.fit(X, y):前面每一步 fit_transform(只用 X、y 的训练部分),最后一步只 fit
pipe.predict(X):前面每一步 transform(用【已经学好的】参数),最后一步 predict
    ↓
scaler 的 mean_/scale_、OneHot 的类别表,全部只在 fit 的那一刻被学一次
    ↓
把 pipe 交给 cross_val_score / GridSearchCV,它们在每一折里重新调用 pipe.fit
    → 每一折的预处理都只用那一折的训练部分
★ 取系数的三种写法,只有一种是对的:
pipe.coef_                                          # ❌ AttributeError
pipe.named_steps["model"].coef_                     # ⚠️ 对,但单位是"标准化尺度"
pipe.named_steps["model"].coef_ / pipe.named_steps["pre"].named_transformers_["num"].scale_
                                                    # ✅ 还原回原始单位(第 11 章练过)
★ 一个必须记住的细节:ColumnTransformer 里的每个子变换器要取出来, 走的是 named_transformers_,不是 named_steps:
pipe.named_steps["pre"].named_transformers_["num"]   # 那个 StandardScaler
pipe.named_steps["pre"].named_transformers_["cat"]   # 那个 OneHotEncoder
13.3 ★ 为什么必须焊进去:每折重新 fit 的可执行证据
这一节是本章的核心。 光说"应该放进去"没用,要能看见它真的分折 fit 了。
真实输出:
③ ★ 为什么必须焊进去:每折重新 fit,统计量每折都不一样

  折 1:训练 13693 行 / 38 支   学到的 cycle 均值 = 612.3637   标准差 = 347.8245
  折 2:训练 13706 行 / 38 支   学到的 cycle 均值 = 612.6348   标准差 = 347.8595
  折 3:训练 13940 行 / 39 支   学到的 cycle 均值 = 609.0801   标准差 = 347.0285
  折 4:训练 13931 行 / 39 支   学到的 cycle 均值 = 608.6993   标准差 = 346.7909
  折 5:训练 13706 行 / 38 支   学到的 cycle 均值 = 612.5800   标准差 = 347.7580
  对照:整份训练集一起 fit 时 cycle 均值 = 611.0568   标准差 = 347.4535
  五折之间 cycle 均值的极差 = 3.9355(整份训练集的均值差 0.0147)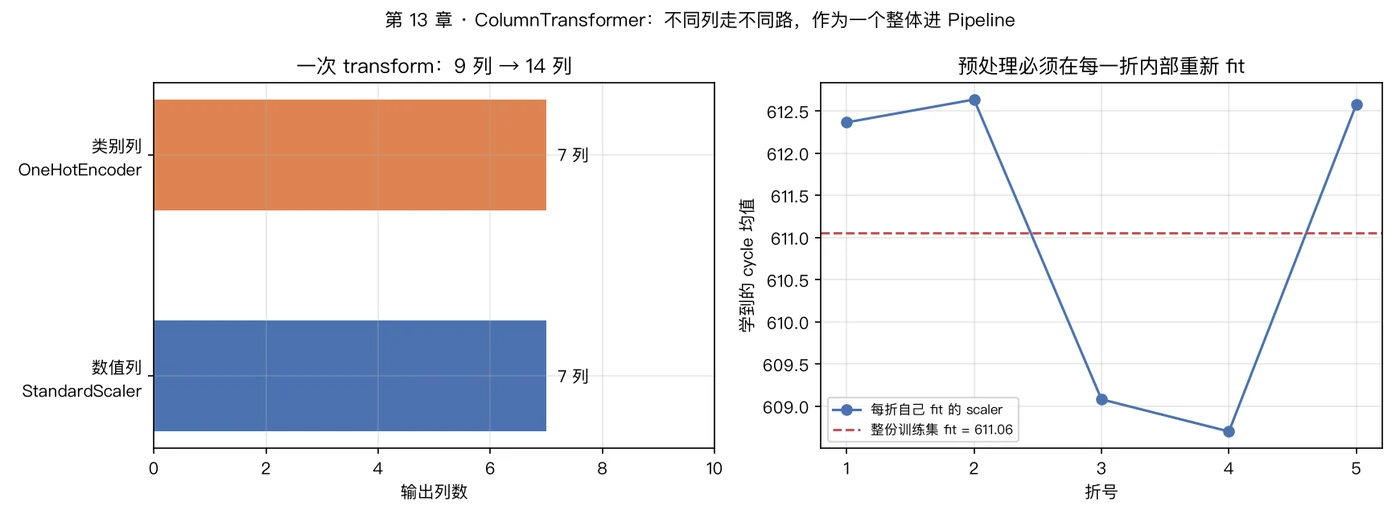
★ 三个数字要一起读:
五折的 cycle 均值:612.36 / 612.63 / 609.08 / 608.70 / 612.58
    ↓ 极差 3.94(约 0.65%)
整份训练集一起 fit:611.06
↓ 它与五折均值的差只有 0.0147为什么"整份训练集的均值"落在五折中间、却又不等于任何一折:
GroupKFold 是把【设备】分成 5 组,每一折用 4 组做训练
    ↓ 每折看到的设备不同 → cycle 的分布不同 → 均值和标准差不同
    ↓ 五折的并集就是整份训练集 → 整份的均值落在它们中间
★ 这就解释了"为什么不能在外面 fit":
如果五折共享同一套 mean_/scale_(在外面 fit 好)
    ↓
那么"折与折的差异"里就少了一块"每折自己学到的统计量不同"的差异
    ↓
分数会显得更稳(方差被人为抹平),但它已经不再等于
  "用 4 组设备训练、去预测剩下 1 组" 的真实流程
★ 一条可以当指纹用的信号:
如果一个模型的折间方差异常小(例如 ±0.0000x),先怀疑预处理在 CV 外面 fit 过。
真实输出(用 Pipeline 做交叉验证):
  cross_val_score 直接用 Pipeline,预处理自动进每一折:
    逐折分数 = [0.95355, 0.95374, 0.95463, 0.94216, 0.9437]
    均值 0.94956 ± 0.00544
★ 为什么这里是 ±0.00544 而不是 ±0.0000x:
5 折、每折留下 12 支左右的设备做验证
    ↓
不同折的难度不同(有的折设备比较"典型",有的折遇到难缠的设备)
    ↓
±0.005 是这份数据上【诚实的】折间波动
★ 这一节的一句话结论:
把预处理放进 Pipeline,不是"代码整洁",而是让"每一折只用自己那份训练数据" 从人的纪律变成代码的结构。
13.4 对照:整表 fit_transform 在这份数据上测不出差距(诚实结论)
先说错误写法:
# ❌ 在 CV 外面把整表标准化好(用到了验证折的数据)
X_all = pd.DataFrame(StandardScaler().fit_transform(X[NUM_COLS]), columns=NUM_COLS)
X_all = pd.concat([X_all, pd.get_dummies(X[CAT_COLS], dtype=float)], axis=1)
scores_leak = cross_val_score(LinearRegression(), X_all.iloc[tr], ytr,
cv=cv, groups=gtr)真实输出:
④ 对照:手工在 CV 外面预处理(错误写法)在这份数据上长什么样

  整表 fit_transform + CV :均值 0.94956 ± 0.00544
  Pipeline 内部预处理 + CV:均值 0.94956 ± 0.00544
  差 = +0.00000
  ★ 这一条是【诚实结论】:带截距的线性回归对特征的仿射变换等变,
    所以这份数据上看不出差距。但换 KNN / PCA / 特征选择就会立刻露头 ——
    '这次没影响'不等于'这个写法对'。
★ 为什么是 0.00000:StandardScaler 是仿射变换
用整表均值标准化 vs 用训练集均值标准化
    ↓ 只差一个"先减 a 再除 b"的线性变换
带截距的线性回归对这种变换【等变】:最优解会跟着换算过去,最终预测完全相同
    ↓
所以这个泄漏在这份数据 + 这个模型上【测不出来】
★ 这正是最危险的地方(第 19 章会展开):
"分数一模一样" → 你很安心 → 代码里留着这个写法
    ↓ 下一次换成 KNN / SVR / 神经网络
"分数一模一样" → 这次不一样了:KNN 掉 0.055、SVR 掉 0.062(上一本第 15 章实测)
    ↓ 再下一次换成 PCA / SelectKBest
差距直接到 0.07 量级(上一本实测 PCA(2)+KNN:0.85767 vs 0.93191,差 −0.07424)
★ 所以纪律要写成"结构"而不是"判断":
只要你在
train_test_split/ CV 之前调用过任何fit或fit_transform, 你就在做预处理泄漏 —— 不管它有没有让分数变好看。
★ 一张"必须放进 Pipeline"的清单:
| 预处理 | 为什么必须放进 Pipeline |
|---|---|
StandardScaler / MinMaxScaler | 均值、标准差来自数据 |
OneHotEncoder / OrdinalEncoder | 类别表来自数据 |
SimpleImputer | 填充值(中位数/众数)来自数据 |
PCA | 主方向来自数据的协方差 |
SelectKBest / RFE | 特征选择用了标签 y |
| 目标编码(target encoding) | 直接用 y 算编码 |
任何 fit_transform(X_all) | 同一类错误的不同写法 |
唯一的例外:只用到 X 的行数、列名、dtype 这类与数值分布无关的信息 (例如"检查缺失值比例")。
13.5 四个必须知道的开关
真实输出:
⑤ 三个必须知道的开关

  (1) verbose_feature_names_out 默认 True,列名会带前缀:
      ['num__cycle', 'num__mean_charge_voltage_v', 'num__mean_temp_rise_c'] ...
      ['cat__test_condition_fast', 'cat__test_condition_hot', 'cat__test_condition_std']
      关掉之后:['cycle', 'mean_charge_voltage_v', 'mean_temp_rise_c'] ...
      ['test_condition_fast', 'test_condition_hot', 'test_condition_std']

  (2) 手上有一张 10 列的表(多了一列 cycle_frac,没在 ColumnTransformer 里点名):
        remainder="drop"(默认)    → 输出 14 列,没点名的列被【静默丢掉】
        remainder="passthrough"  → 输出 15 列,没点名的列被【原样带进模型】
          最后两列的名字 = ['cat__test_condition_std', 'remainder__cycle_frac']
      ⚠️ 一列没被点名,默认是'悄悄丢掉'而不是报错 ——
         这既能藏住你的疏忽,也能替你把泄漏列挡住。

  (3) 稀疏输出:OneHot 列多了以后,OneHotEncoder 默认吐稀疏矩阵。
      type = csr_matrix   shape = (3995, 7)   非零元占比 = 28.6%
      想让下游拿到稠密数组:OneHotEncoder(sparse_output=False)
      ⚠️ 忘了这一步又同时要 pandas 输出,会真报错:
ValueError: Pandas output does not support sparse data. Set sparse_output=False to output pandas dat开关一:verbose_feature_names_out
| 取值 | 列名长什么样 | 什么时候用 |
|---|---|---|
True(默认) | num__cycle、cat__batch_A | 多个变换器处理了同名列时,靠前缀区分 |
False | cycle、batch_A | 下游要按业务列名读特征重要性/系数 |
★ 为什么默认是 True:
如果 num 段和 cat 段里出现了同名列(例如两段都含 batch)
    ↓
不加前缀就分不清"batch_A 是哪一个变换出来的"
    ↓
前缀是防止列名冲突的默认保护;确认没冲突再关掉开关二:remainder(最容易出事故的一个)
真实输出里那个实验值得单独看:
extra = Xtr.copy()
extra["cycle_frac"] = df["cycle_frac"].iloc[tr].to_numpy()   # ← 第 17 章的泄漏钩子
ct_drop = ColumnTransformer([...], remainder="drop")          # 默认
ct_pass = ColumnTransformer([...], remainder="passthrough")remainder="drop" → 输出 14 列,cycle_frac 被静默丢掉
remainder="passthrough" → 输出 15 列,最后一列名 = remainder__cycle_frac★ 一句话:
remainder决定了"没被点名的列"的命运,而它的默认值是"悄悄扔掉"。这既是保护(挡住不该进的列),也是陷阱(藏住你的疏忽)。
★ 工程纪律:
点名清单(NUM_COLS + CAT_COLS)必须和特征账本(第 16 章)对得上:
    账本里 ✅ / ⚠️ 的列 → 应该在点名单里
    账本里 ❌ 的列      → 必须不在点名单里,而且不能用 passthrough 漏进来
开关三:稀疏输出
真实输出:
      type = csr_matrix   shape = (3995, 7)   非零元占比 = 28.6%
      想让下游拿到稠密数组:OneHotEncoder(sparse_output=False)
      ⚠️ 忘了这一步又同时要 pandas 输出,会真报错:
         ValueError: Pandas output does not support sparse data...
      (类别多的时候别急着要稠密:60 类的独热稀疏率是 98%,稠密化纯属浪费内存)
★ 什么时候要稠密、什么时候要稀疏:
| 场景 | 选择 | 理由 |
|---|---|---|
| 类别少(十几类)、后面要接线性模型读系数 | sparse_output=False | 便于检查、便于取列名 |
| 类别多(上百类以上) | 保持默认稀疏 | 内存差一个数量级 |
需要 set_output(transform="pandas") | 必须 sparse_output=False | 否则真报错(见上) |
| 下游是树模型 | 都可以 | 树内部会转成稠密 |
开关四:set_output(transform="pandas")
pre.set_output(transform="pandas") # 输出是 DataFrame,带列名为什么它值得开:
不开:输出是 numpy 数组 → 想知道"第 7 列是什么"要去数 get_feature_names_out()
开:  输出是 DataFrame   → 可以直接 df.head()、df.corr()、按列名取
    ↓
调试"到底哪一列把分数拉起来了"时,省下的时间以小时计注意它只影响"包装层",不会改变任何数值 —— 第 11 章那条纪律(fit 只在训练集上) 它一点都帮不上忙,那是 Pipeline 的职责。
13.6 上线:一起存、一起读,以及三个真实报错
真实输出:
⑥ 上线:Pipeline 一起存、一起读

  存盘大小 = 3.8 KB   文件:/var/folders/.../fe-ch13-pipe.joblib
  读回来之后前 5 行预测:[0.987259 0.980193 0.985945 0.979425 0.981852]
  与存盘前逐点最大差     :0.00e+00
  ★ scaler 的 mean_/scale_、OneHot 的类别表都跟着对象一起走。
只存 model 不存 pre,就等于上线时用了另一套预处理规则。⑦ 两个错误写法(真报错)
① 漏点名一列【不报错】:输出只有 10 列,batch 被静默丢掉了
② 列名拼错:ValueError: Some column names are not columns of the dataframe: {'cycles'}
③ 上线时缺列:ValueError: columns are missing: {'batch'}
→ ColumnTransformer 会【按列名严格对齐】:写错名字、缺列都会当场报错;
但'漏点名'是静默丢弃 —— 所以点名清单要和特征账本(第 16 章)对得上。★ 把这三条对照起来看,就是一份"上线纪律":
| 错误 | 什么时候炸 | 报错信息 | 危害 |
|---|---|---|---|
| 漏点名一列 | 不炸 | 无 | 静默丢信息(或漏进泄漏列,取决于 remainder) |
| 列名拼错 | fit 时 | Some column names are not columns of the dataframe: {'cycles'} | 立刻发现,最安全的一种错 |
| 上线缺列 | predict 时 | columns are missing: {'batch'} | 上线当场炸(比"悄悄算错"好) |
★ 一个正确姿势:
import joblib

joblib.dump(pipe, "model.joblib")        # scaler + 编码器 + 模型,一起存

pipe = joblib.load("model.joblib")       # 上线时只加载它
pipe.predict(new_df[FEATURE_ORDER])      # 预处理自动按训练时的参数执行
★ 为什么"只存模型"是经典生产事故:
你只存了 model
    ↓
上线时新同学重新写了一套预处理(或者忘了写)
    ↓
模型收到的数据分布与训练时完全不同 → 预测全错,而且【不报错】
    ↓
所以"把预处理和模型打包成一个对象"这件事,本身就是一条防呆设计
13.7 常见坑
① 在 CV / 划分之前 fit 预处理        → 预处理泄漏;这份数据上可能"分数一模一样"(13.4)
② 忘了点名列                        → 不报错,静默丢掉(remainder="drop")
③ 用 remainder="passthrough" 兜底    → 泄漏列会一路进模型,也不报错
④ 用 pipe.coef_                     → AttributeError;要用 named_steps["model"]
⑤ 找 ColumnTransformer 里的子变换器用 named_steps
                                    → 应该用 named_transformers_
⑥ set_output(transform="pandas") 又不关稀疏
                                    → ValueError: Pandas output does not support sparse data
⑦ 高基数类别 + OneHot + 稠密输出      → 内存爆(稀疏率 98%+,没必要稠密化)
⑧ 只保存模型、不保存预处理            → 上线用了另一套规则,而且不报错
⑨ 用整数下标而不是列名                → 列顺序一变就静默算错(用 DataFrame 可以避免)
★ 第 ⑨ 条展开一下:
ColumnTransformer([("num", StandardScaler(), [0, 1, 2, 3, 4, 5, 6])])   # ⚠️ 按位置
    ↓
有人在上游加了一列(或者 df 的列顺序变了)
    ↓
位置下标全部错位 → 缩放器作用在别的列上 → 不报错,但结果全错
    ↓
✅ 始终按【列名】声明(本章 demo 全程用列名)
13.8 完整示例与输出
cd tools/feature-engineering-pipeline/code
MPLCONFIGDIR=/tmp/fe-mpl /path/to/venv/bin/python demos/ch13-column-transformer.py真实输出(节选):
① 输入 (17244, 9)  →  ColumnTransformer  →  输出 (17244, 14)

② 焊进 Pipeline:两条规则
  随机森林 测试 R² = 0.96092
    线性回归         测试 R² = 0.93971
    Ridge(alpha=1) 测试 R² = 0.93972
     AttributeError: 'Pipeline' object has no attribute 'coef_'

③ 折 1:训练 13693 行 / 38 支   学到的 cycle 均值 = 612.3637
   折 3:训练 13940 行 / 39 支   学到的 cycle 均值 = 609.0801
   折 4:训练 13931 行 / 39 支   学到的 cycle 均值 = 608.6993
   对照:整份训练集一起 fit 时 cycle 均值 = 611.0568
   五折之间 cycle 均值的极差 = 3.9355
   cross_val_score 逐折分数 = [0.95355, 0.95374, 0.95463, 0.94216, 0.9437]
                均值 0.94956 ± 0.00544

④ 整表 fit_transform + CV :均值 0.94956    Pipeline + CV:均值 0.94956   差 +0.00000

⑥ 读回来之后前 5 行预测:[0.987259 0.980193 0.985945 0.979425 0.981852]
   与存盘前逐点最大差     :0.00e+00
★ 一页记住这一章:
ColumnTransformer([("num", StandardScaler(), num_cols),
                   ("cat", OneHotEncoder(handle_unknown="ignore"), cat_cols)])

① 它把"哪列走哪条路"写成一份声明(按列名,不按位置)
② 它整体进 Pipeline → CV / GridSearch / 上线共用同一个对象
③ 它的两个默认值都要留心:verbose_feature_names_out=True、remainder="drop"
④ 它天然会跟模型一起被 joblib 存下来 —— 这就是"不泄漏"最省事的落地方式
本章练习
练习 1:看清一个 ColumnTransformer 的输出
用 soh_features_v2.csv(7 列数值 + 2 列类别),按设备划分(random_state=42):
- 写一个
ColumnTransformer(数值StandardScaler、类别OneHotEncoder(handle_unknown="ignore")), 报输入形状、输出形状、14 个输出列名; - 对比
verbose_feature_names_out=True/False的列名前 2 项; - 在输入里加一列没被点名的
cycle_frac,分别用remainder="drop"与"passthrough"跑一次,报输出列数与最后一列的名字; - 回答:
remainder的默认值会带来什么风险?
参考答案
import os

import numpy as np
import pandas as pd
from sklearn.compose import ColumnTransformer
from sklearn.model_selection import GroupShuffleSplit
from sklearn.preprocessing import OneHotEncoder, StandardScaler

HERE = os.path.dirname(os.path.abspath(__file__))
CODE = os.path.abspath(os.path.join(HERE, "..", ".."))
DATA = os.path.join(CODE, "data", "battery")

NUM = ["cycle", "mean_charge_voltage_v", "mean_temp_rise_c", "resistance_mohm",
       "coulombic_eff", "cap_fade_rate_ah_per_100", "temp_std_c"]
CAT = ["batch", "test_condition"]

df = pd.read_csv(os.path.join(DATA, "soh_features_v2.csv"))
X, y, g = df[NUM + CAT], df["soh"], df["cell_id"]
tr, te = next(GroupShuffleSplit(n_splits=1, test_size=0.2, random_state=42)
              .split(X, y, g))

pre = ColumnTransformer(
    [("num", StandardScaler(), NUM),
     ("cat", OneHotEncoder(handle_unknown="ignore", sparse_output=False), CAT)],
    verbose_feature_names_out=False).set_output(transform="pandas")
Z = pre.fit_transform(X.iloc[tr])
print(f"输入 {X.iloc[tr].shape} → 输出 {Z.shape}")
print(f"列名 = {list(Z.columns)}")

verbose = ColumnTransformer(
    [("num", StandardScaler(), NUM),
     ("cat", OneHotEncoder(handle_unknown="ignore", sparse_output=False), CAT)]).fit(X.iloc[tr])
print(f"默认(带前缀)前 2 列 = {list(verbose.get_feature_names_out())[:2]}")
print(f"关掉前缀     前 2 列 = {list(pre.get_feature_names_out())[:2]}")

extra = X.iloc[tr].copy()
extra["cycle_frac"] = np.linspace(0, 1, len(extra))
for rem in ["drop", "passthrough"]:
    ct = ColumnTransformer(
        [("num", StandardScaler(), NUM),
         ("cat", OneHotEncoder(handle_unknown="ignore"), CAT)], remainder=rem)
    out = ct.fit_transform(extra)
    print(f"remainder={rem:12s} → {out.shape[1]:2d} 列,最后一列 = "
f"{list(ct.get_feature_names_out())[-1]}")期望输出:
输入 (17244, 9) → 输出 (17244, 14)
列名 = ['cycle', 'mean_charge_voltage_v', 'mean_temp_rise_c', 'resistance_mohm', 'coulombic_eff', 'cap_fade_rate_ah_per_100', 'temp_std_c', 'batch_A', 'batch_B', 'batch_C', 'batch_D', 'test_condition_fast', 'test_condition_hot', 'test_condition_std']
默认(带前缀)前 2 列 = ['num__cycle', 'num__mean_charge_voltage_v']
关掉前缀     前 2 列 = ['cycle', 'mean_charge_voltage_v']
remainder=drop         → 14 列,最后一列 = cat__test_condition_std
remainder=passthrough  → 15 列,最后一列 = remainder__cycle_frac
④ 回答:默认的 "drop" 会"静默丢掉"没被点名的列。
好处:你想漏掉一个泄漏列(比如 cycle_frac)时,它会替你挡住
坏处:你想用的一列忘了点名时,它不报错 —— 你会以为它进了模型,其实没有
    ↓
更危险的是反过来:写成 remainder="passthrough" 兜底
    ↓
任何没点名的列(包括泄漏列)都会原样进模型,同样不报错
    ↓
纪律:点名清单必须和特征账本(第 16 章)对得上,且不要用 passthrough 兜底
练习 2:用 GroupKFold(5) 证明"每折各自 fit"
在同一份训练集上,用 GroupKFold(n_splits=5)(按设备分组):
- 逐折用那一折的训练部分
fit一个StandardScaler,打印学到的cycle均值与标准差; - 再对整份训练集
fit一次,打印它的均值与标准差; - 报五折之间
cycle均值的极差; - 用
cross_val_score(Pipeline(...))跑一次,报逐折分数与均值 ± 标准差; - 回答:如果这五折共享同一套
mean_/scale_(在 CV 外面 fit 好), 上面哪个数字会变、往哪个方向变?
参考答案
import os

import pandas as pd
from sklearn.compose import ColumnTransformer
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import GroupKFold, GroupShuffleSplit, cross_val_score
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import OneHotEncoder, StandardScaler

HERE = os.path.dirname(os.path.abspath(__file__))
CODE = os.path.abspath(os.path.join(HERE, "..", ".."))
DATA = os.path.join(CODE, "data", "battery")

NUM = ["cycle", "mean_charge_voltage_v", "mean_temp_rise_c", "resistance_mohm",
       "coulombic_eff", "cap_fade_rate_ah_per_100", "temp_std_c"]
CAT = ["batch", "test_condition"]

df = pd.read_csv(os.path.join(DATA, "soh_features_v2.csv"))
X, y, g = df[NUM + CAT], df["soh"], df["cell_id"]
tr, _ = next(GroupShuffleSplit(n_splits=1, test_size=0.2, random_state=42)
             .split(X, y, g))
Xtr, ytr, gtr = X.iloc[tr], y.iloc[tr], g.iloc[tr]

cv = GroupKFold(n_splits=5)
means = []
for k, (a, b) in enumerate(cv.split(Xtr, ytr, gtr), start=1):
    sc = StandardScaler().fit(Xtr.iloc[a][NUM])
    means.append(sc.mean_[0])
    print(f"折 {k}:训练 {len(a):5d} 行 / {gtr.iloc[a].nunique():2d} 支   "
          f"cycle 均值 = {sc.mean_[0]:8.4f}   标准差 = {sc.scale_[0]:8.4f}")
whole = StandardScaler().fit(Xtr[NUM])
print(f"整份训练集一起 fit:cycle 均值 = {whole.mean_[0]:8.4f}   "
      f"标准差 = {whole.scale_[0]:8.4f}")
print(f"五折之间 cycle 均值的极差 = {max(means) - min(means):.4f}")

pipe = Pipeline([("pre", ColumnTransformer(
    [("num", StandardScaler(), NUM),
     ("cat", OneHotEncoder(handle_unknown="ignore"), CAT)])),
    ("m", LinearRegression())])
scores = cross_val_score(pipe, Xtr, ytr, cv=cv, groups=gtr)
print(f"逐折分数 = {[round(float(s), 5) for s in scores]}")
print(f"均值 {scores.mean():.5f} ± {scores.std():.5f}")期望输出:
折 1:训练 13693 行 / 38 支   cycle 均值 = 612.3637   标准差 = 347.8245
折 2:训练 13706 行 / 38 支   cycle 均值 = 612.6348   标准差 = 347.8595
折 3:训练 13940 行 / 39 支   cycle 均值 = 609.0801   标准差 = 347.0285
折 4:训练 13931 行 / 39 支   cycle 均值 = 608.6993   标准差 = 346.7909
折 5:训练 13706 行 / 38 支   cycle 均值 = 612.5800   标准差 = 347.7580
整份训练集一起 fit:cycle 均值 = 611.0568   标准差 = 347.4535
五折之间 cycle 均值的极差 = 3.9355
逐折分数 = [0.95355, 0.95374, 0.95463, 0.94216, 0.9437]
均值 0.94956 ± 0.00544
⑤ 回答:变的是"逐折分数的差异",方向是变小**。**
在外面 fit 好 → 五折共享同一套 mean_/scale_
    ↓
"折与折的差异"里少掉了一块:"每折自己学到的统计量不同"
    ↓
于是折间标准差被人为抹平(可能从 ±0.005 掉到 ±0.000x)
    ↓
分数看起来"更稳",但那个"稳"不是模型稳,是流程被焊死了
★ 一句话判据:
折间方差异常小(±0.0000x)是"预处理泄漏"的一个有效指纹 —— 因为真实的折间差异不可能那么小。
练习 3:上线三件事(存读往返 / 缺列 / 列名拼错)
- 拟合一个
Pipeline(ColumnTransformer + LinearRegression),报测试 R²; - 用
joblib存盘再读回,报存盘大小与"读回前后逐点预测最大差"; - 制造两个错误并抄下真实的报错信息: (a)预测时删掉
batch列;(b)把点名单里的cycle拼成cycles; - 再制造一个"不报错"的情况:点名单里漏掉
batch,报输出列数并说明发生了什么。
参考答案
import os
import tempfile

import joblib
import numpy as np
import pandas as pd
from sklearn.compose import ColumnTransformer
from sklearn.linear_model import LinearRegression
from sklearn.metrics import r2_score
from sklearn.model_selection import GroupShuffleSplit
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import OneHotEncoder, StandardScaler

HERE = os.path.dirname(os.path.abspath(__file__))
CODE = os.path.abspath(os.path.join(HERE, "..", ".."))
DATA = os.path.join(CODE, "data", "battery")

NUM = ["cycle", "mean_charge_voltage_v", "mean_temp_rise_c", "resistance_mohm",
       "coulombic_eff", "cap_fade_rate_ah_per_100", "temp_std_c"]
CAT = ["batch", "test_condition"]

df = pd.read_csv(os.path.join(DATA, "soh_features_v2.csv"))
X, y, g = df[NUM + CAT], df["soh"], df["cell_id"]
tr, te = next(GroupShuffleSplit(n_splits=1, test_size=0.2, random_state=42)
              .split(X, y, g))

pipe = Pipeline([("pre", ColumnTransformer(
    [("num", StandardScaler(), NUM),
     ("cat", OneHotEncoder(handle_unknown="ignore"), CAT)])),
    ("m", LinearRegression())]).fit(X.iloc[tr], y.iloc[tr])
print(f"测试 R² = {r2_score(y.iloc[te], pipe.predict(X.iloc[te])):.5f}")

path = os.path.join(tempfile.gettempdir(), "fe-ch13-exercise.joblib")
joblib.dump(pipe, path)
loaded = joblib.load(path)
d = np.abs(pipe.predict(X.iloc[te].head(5)) - loaded.predict(X.iloc[te].head(5))).max()
print(f"存盘 {os.path.getsize(path) / 1e3:.1f} KB,读回逐点最大差 = {d:.2e}")

for tag, fn in [("缺列", lambda: loaded.predict(X.iloc[te].drop(columns=["batch"]))),
                ("拼错列名", lambda: ColumnTransformer(
                    [("n1", StandardScaler(), ["cycles"]),
                     ("n2", StandardScaler(), NUM)]).fit(X.iloc[tr]))]:
    try:
        fn()
    except Exception as exc:                            # noqa: BLE001
        print(f"{tag} → {type(exc).__name__}: {str(exc)[:80]}")

bad = Pipeline([("pre", ColumnTransformer(
    [("num", StandardScaler(), NUM),
     ("cat", OneHotEncoder(handle_unknown="ignore"), ["test_condition"])])),
    ("m", LinearRegression())]).fit(X.iloc[tr], y.iloc[tr])
print(f"漏点名 batch → 不报错:输出 {bad.named_steps['pre'].transform(X.iloc[te]).shape[1]} 列")期望输出:
测试 R² = 0.93971
存盘 3.8 KB,读回逐点最大差 = 0.00e+00
缺列 → ValueError: columns are missing: {'batch'}
拼错列名 → ValueError: Some column names are not columns of the dataframe: {'cycles'}
漏点名 batch → 不报错:输出 10 列
★ 三种错误,三种危险等级:
| 错误 | 何时暴露 | 危险等级 |
|---|---|---|
| 列名拼错 | fit 时 | ★ 最低 —— 立刻炸 |
| 缺列 | predict 时 | ★★ 中 —— 上线炸,比静默好 |
| 漏点名 | 永远不炸 | ★★★ 最高 —— 你以为它在,其实不在(或者反过来) |
★ 上线自检三句话:
① 我保存的是【Pipeline】还是【只有模型】?        → 必须是一整个 Pipeline
② 上线时的列名/列顺序与训练时一致吗?             → 不一致会报错(好事),
                                                  但如果用了整数下标就会静默算错
③ 点名单和特征账本(第 16 章)对得上吗?           → 逐列核对一遍
面向工程实践:预处理器是一份"列清单 + 路由表"
① 生产管道的标准形状
from sklearn.compose import ColumnTransformer
from sklearn.impute import SimpleImputer
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import OneHotEncoder, StandardScaler

pre = ColumnTransformer([
    ("num", Pipeline([("imp", SimpleImputer(strategy="median")),   # 缺失值
                      ("sc", StandardScaler())]), NUM_COLS),        # 缩放
    ("cat", Pipeline([("imp", SimpleImputer(strategy="most_frequent")),
                      ("oh", OneHotEncoder(handle_unknown="ignore"))]), CAT_COLS),
], remainder="drop", verbose_feature_names_out=False)

pipe = Pipeline([("pre", pre), ("model", Ridge(alpha=1.0))])

pipe.fit(X_train, y_train)                                  # 训练
scores = cross_val_score(pipe, X_train, y_train,            # 交叉验证(每折重新 fit)
                         cv=GroupKFold(5), groups=groups)
GridSearchCV(pipe, {"model__alpha": [0.1, 1, 10]},          # 网格搜索(每折重新 fit)
             cv=GroupKFold(5)).fit(X_train, y_train)
joblib.dump(pipe, "model.joblib")                           # 上线(一起存)
★ 注意 GridSearchCV 的超参名:model__alpha(步骤名__参数名)。 预处理有超参时同理 —— pre__num__sc__with_mean 这样一路点下去。
② 三件必须写进文档的事
① 点名单:NUM_COLS / CAT_COLS 各有哪些列,以及【为什么】它们在里面
   (这里就是特征账本,第 16 章)
② 未知类别的策略:handle_unknown="ignore" + 上线后要监控"未知类别占比"
③ 保存物:joblib 里是一个完整 Pipeline,不是一个裸模型
③ 一个可复用的自检函数
def check_preprocessor(pipe, X_train, X_new):
    """上线前跑一遍:点名对得上吗?会静默丢列吗?未知类别多吗?"""
    pre = pipe.named_steps["pre"]
    named = {c for _, _, cols in pre.transformers for c in cols}
    missed = set(X_new.columns) - named - {"soh", "cell_id"}
    print(f"输入 {X_new.shape[1]} 列,被点名 {len(named)} 列,"
          f"没被点名 {sorted(missed)}")
    if missed:
        print("  ⚠️ 没被点名的列会被 remainder 的策略处理(默认静默丢掉)")
    for name, trans, cols in pre.transformers:
        if hasattr(trans, "categories_"):
            for c, cats in zip(cols, trans.categories_):
                new = set(X_new[c].unique()) - set(cats)
                if new:
                    print(f"  ⚠️ {c} 出现 {len(new)} 个未知类别:{sorted(new)[:5]}")
★ 这个函数对应的三个坑:
"没被点名的列"   → remainder 的静默丢弃(13.5)
"未知类别"       → handle_unknown(第 12 章)
"输入列数"       → 上线缺列/多列(13.6)
★ 最后一句,也是通往下一章的桥:
到这里,21 列安全特征都能送进模型了:数值列缩放、类别列独热、整体装进 Pipeline。但 21 列全都值得留吗?下一章先看"谁和标签相关、谁和谁冗余",下下章再逐组拿掉重训 —— 把"这一列到底值多少"变成一个数字。