第 20 章 · 泄漏③:特征泄漏
这一章要解决什么:把"特征泄漏"从"标签混进
X"这个简单印象, 扩展成三个形态完全不同的家族,并且量出它们各自的虚高量:cycle_frac+0.00556、soh_margin+0.03497、自己造的soh_future+0.03329。最容易踩的坑: ① 只盯着"标签在不在特征里" —— 会漏掉
cycle_frac这种"未来聚合量"; ② 用相关性阈值(|r| > 0.99)排查 —— 它既漏报(cycle_frac只有 0.9757) 又误报(soh_lag1高达 0.9991 却完全合法); ③ 把"提升只有千分之几"当成"这个特征很温和" —— 那正是它最危险的地方。
本章你需要完成的代码:demos/ch20-leak-feature.py
本章的数字口径:soh_features_v2.csv 全部 21,239 行、 7 列基础特征为基线、按设备 GroupShuffleSplit(test_size=0.2, random_state=42)、 随机森林 200 棵。所有分数都是测试集 R²。
为什么基线只用 7 列? 因为要"看得见差异"(第 18.4 节的天花板效应): 21 列全特征下干净口径已经 0.99904,任何钩子的虚高都会被天花板吃掉。
20.1 第一个钩子:一个"有提升但不夸张"的特征
先看基线(只用当圈读数和圈数本身):
真实输出:
① 基线:7 列基础特征(只用过去、且不含标签本身),测试 R² = 0.96503
  基线(7 列)                            可用 21,239 行   R² = 0.96503   MAE = 0.007901
现在加一列 cycle_frac。
Xf = df[BASE + ["cycle_frac"]]
s_frac = r2_score(y.iloc[te], rf().fit(Xf.iloc[tr], y.iloc[tr]).predict(Xf.iloc[te]))真实输出:
② 钩子一 cycle_frac:把『该设备的最终总寿命』告诉了模型
  + cycle_frac                       可用 21,239 行   R² = 0.97058   MAE = 0.007078
     虚高 +0.00556(R²)  -0.000823(MAE)
     与 soh 的相关系数 r = -0.9783
     计算方式:cycle_frac = cycle ÷ n_cycles_to_eol
     分母是该设备【跑到退役才有的】总寿命 —— 预测这一刻根本不知道。
     它长得非常像业务特征(『老化进度』),提升又只有千分之几,
     属于最容易蒙混过关的那一类。
     随机森林把多少重要性给了它:0.9581(其余 7 列合计 0.0419)
     —— 模型几乎只用了这一列。
★ 这一节有四个数字,每一个都要读懂:
| 数字 | 含义 | 为什么危险 |
|---|---|---|
| 虚高 +0.00556 | 提升 0.56 个百分点 | 在周报里这是"优化有成效",没有人会怀疑 |
| MAE 从 0.007901 → 0.007078 | 误差只小了 10% | 也不显眼 |
| |r| = 0.9783 | 强相关,但不到 0.99 | 过不了相关性阈值,会漏报 |
feature_importances_ = 0.9581 | 一列吃掉 95.8% 的重要性 | 这才是最可疑的信号 |
★ 注意最后一行:真正的红灯不是分数,是"模型几乎只用了一列"。
一个"业务上很合理"的特征(老化进度),
让模型放弃了其余 7 列物理量
     ↓
如果这 7 列里真有规律,模型为什么不用?
     ↓
因为它发现了一条捷径:知道"还能活多久",就能反推"现在多好"
     ↓
而"还能活多久"在预测这一刻是不存在的
★ cycle_frac 属于哪一类泄漏?"未来聚合量"。
cycle_frac = cycle / n_cycles_to_eol
                        ↑
            这一支设备从生到死的总圈数
            它必须等这支设备【退役】才能算出来
     ↓
在"第 500 圈"做预测时,这支设备还要再跑 900 圈
     ↓
所以这个数在未来,不在当下 —— 它是【时间穿越式泄漏】的教科书样本
点开:为什么"提升很小"反而是加分项(从骗人的角度)
设想一个评审场景,两种候选特征:
候选 A:+soh_margin   → R² 从 0.96503 直接到 1.00000
候选 B:+cycle_frac   → R² 从 0.96503 到 0.97058
候选 A 的结局:所有人都会停下来问"怎么会这么高?" → 大概率被查出来。 候选 B 的结局:"这个特征有点用,先合进去吧。"
★ 所以从"能不能骗过评审"的角度看:
虚高太大   → 触发怀疑(1.00000 是自曝)
虚高很小   → 无人察觉(+0.00556 是理想伪装)
     ↓
真正需要防的,是那些"提升量级符合预期"的泄漏特征
     ↓
因为人的注意力总是被极端值吸引,而泄漏的常态是"温和"
★ 这解释了本书为什么把这一章排在 ch21(R² = 1.000000)之前:
先认识"温和的泄漏"(本章 20.1),
再看"夸张的泄漏"(20.2 与第 21 章)——
     ↓
否则你会以为"1.00000 才是泄漏",而漏掉日常 90% 的情况
20.2 第二个钩子:一个"直接把分数打满"的特征
再加一列 soh_margin。
真实输出:
③ 钩子二 soh_margin:模型直接把标签抄了一遍,测试 R² = 1.00000
  + soh_margin                       可用 21,239 行   R² = 1.00000   MAE = 0.000002
     虚高 +0.03497(R²)  -0.007899(MAE)
     与 soh 的相关系数 r = 1.000000(恰好 1)
     计算方式:soh_margin = soh − 0.80 —— 它【就是】标签的线性函数。
     MAE 从 0.007901 掉到 0.000002(约 3,719 分之一)。
★ 这里有三个"自曝"信号,任何一个都足够定案:
① R² = 1.00000(恰好),不是 0.9997 也不是 0.99998
② MAE 掉了 3,719 倍(从 7.9e-3 到 2.1e-6)
③ r = 1.000000(恰好),|r| 的极限就是 1
     ↓
三个信号同时出现,说明这一列不是"和标签相关",
而是"标签的一个等价形式"
★ soh_margin 属于哪一类?"标签自身"。
soh_margin = soh − 0.80
     ↓
把标签减去一个常数,还叫它特征
     ↓
在业务上它有一个非常体面的名字:距退役线还有多少余量
(0.80 是退役线)
     ↓
所以它是最容易被"业务解释"包装起来的泄漏:
"我们当然要看离退役线还有多远啊!"
     ↓
回答是:那你得先知道 soh,才知道余量 —— 这就是循环论证
★ 第 21 章会把这一列彻底拆开(系数 = 1、截距 = 0.80、tol 的影响、 以及三组反证实验)。这里先记住它的指纹:R² 恰好 1、MAE 掉 4 个数量级、r 恰好 1。
20.3 第三个钩子:自己造一个(shift(-1))
前两个钩子是数据里"故意埋的"。本节要你自己造一个 —— 因为真实项目里的泄漏, 绝大多数不是别人埋的,而是你自己不小心造出来的。
# 同一支设备【下一个窗口】的 SOH
df["soh_future"] = (df.sort_values(["cell_id", "cycle"])
.groupby("cell_id")["soh"].shift(-1))真实输出:
④ 钩子三 soh_future:自己造的 shift(-1),测试 R² = 0.99832
  + soh_future(shift(-1))            可用 21,179 行   R² = 0.99832   MAE = 0.001777
     虚高 +0.03329(R²)  -0.006124(MAE)
     与 soh 的相关系数 r = 0.9991;NaN 60 个(每支设备最后 1 行)
     构造方式:df.groupby('cell_id')['soh'].shift(-1)
     它没有『恰好 1.00000』,因为相邻窗口的 SOH 不是完全相等 ——
     但 0.99832 已经足够让人误以为『模型学会了外推』。
     ★ 注意 NaN 的位置:[60 个] 恰恰是每支设备的最后一行。
       dropna 之后你其实是在『能预测未来』的样本上打分。
★ 这一节有三处细节值得停一下:
细节一:shift(-1) 与 shift(1) 只差一个符号,性质完全相反。
soh_lag1   = groupby(cell).soh.shift( 1)   → 上一个窗口的实测 SOH   ✅ 可用(历史)
soh_future = groupby(cell).soh.shift(-1)   → 下一个窗口的实测 SOH   ❌ 泄漏(未来)
     ↓
而它们的相关系数都是 0.9991 量级 —— 从数字上【完全分不出来】
★ 这是本章最重要的一条认知:
同一列数据,往前挪一格是合法特征,往后挪一格是泄漏。 它们的统计性质几乎完全一样,唯一的区别是"它指向过去还是未来"。
所以判断特征泄漏,不能看数据的分布,只能看数据的"时间方向"。
细节二:NaN 的位置暴露了方向。
soh_lag1  :每支设备【最早】1 行是 NaN(60 个)
soh_future:每支设备【最后】1 行是 NaN(60 个)
     ↓
同样是 60 个 NaN,位置在头部还是尾部,方向刚好相反
     ↓
所以"数 NaN 的个数"没有用,要"看 NaN 在哪一头"细节三:dropna 之后,你在什么样本上打分?
soh_future 只有最后一行为 NaN
     ↓
dropna 掉这 60 行之后,剩下的每一行都【能看见下一个窗口】
     ↓
也就是说:你评估的样本里,100% 都是"下一格已知"的样本
     ↓
如果真实场景里存在"最后一个窗口"(设备即将退役,没有下一格),
那你还漏掉了一类边界情况
★ 工程上的防呆写法(让方向变成显式的):
# ✅ 明确写出方向,并把"未来列"单独隔离
HIST_COLS = ["soh_lag1", "soh_lag5", "soh_win_mean5", "soh_win_std5"]   # shift(+k)
FUTURE_COLS = []                                                        # shift(-k) 一律不许出现
LEAKY_COLS = ["cycle_frac", "soh_margin"]                               # 已知钩子

def assert_no_future(feats):
    bad = sorted(set(feats) & (set(FUTURE_COLS) | set(LEAKY_COLS)))
    assert not bad, f"这些列在预测时刻拿不到:{bad}"
20.4 三个钩子,三种家族
真实输出(阶梯表):
⑤ 阶梯表:三个钩子,三种『看起来都很好』
  配置                             特征数        R²         MAE       ΔR²
  基线(7 列基础)                        7   0.96503    0.007901  +0.00000
  + cycle_frac(未来聚合)               8   0.97058    0.007078  +0.00556
  + soh_future(未来时刻值)              8   0.99832    0.001777  +0.03329
  + soh_margin(标签自己)               8   1.00000    0.000002  +0.03497
★ 三种家族,三种形态:
| 家族 | 例子 | 它偷了什么 | 虚高 | 常见伪装 |
|---|---|---|---|---|
| ① 标签自身 | soh_margin、soh 混入 | 答案本身(或它的仿射变换) | +0.03497 | "距退役线的余量" |
| ② 未来聚合量 | cycle_frac、全周期均值 / 最大值 | 未来才知道的汇总统计量 | +0.00556 | "老化进度" |
| ③ 未来时刻值 | soh_future、shift(-1)、lead | 未来某一点的观测值 | +0.03329 | "趋势外推" |
★ 为什么必须分成三种?因为查法不同:
家族①(标签自身)→ 查"X 里有没有 y、或 y 的线性组合"
     · 最省事的查法:算每一列与 y 的 r,看有没有恰好 1 的
     · 注意:差一个常数(soh_margin)也会给出 r = 1,所以 r 恰好为 1 就要查

家族②(未来聚合量)→ 查"这一列的分母/参照物是什么时候才知道的"
     · cycle_frac 的分母是总寿命 → 要问"总寿命什么时候算得出来?"
     · 全周期均值 / 最大值 → 要问"这段周期的范围是怎么定的?"

家族③(未来时刻值)→ 查"shift 的符号"
     · grep 一遍代码里的 shift(- / lead( / ffill 之后的 bfill
     · 这类泄漏最容易在"对齐特征与标签"时手滑产生
★ 三者的共同点(也是唯一的共同点):
它们都满足:"在预测这一刻,这个数不存在"
     ↓
所以三种家族只需要一句判据(下一节)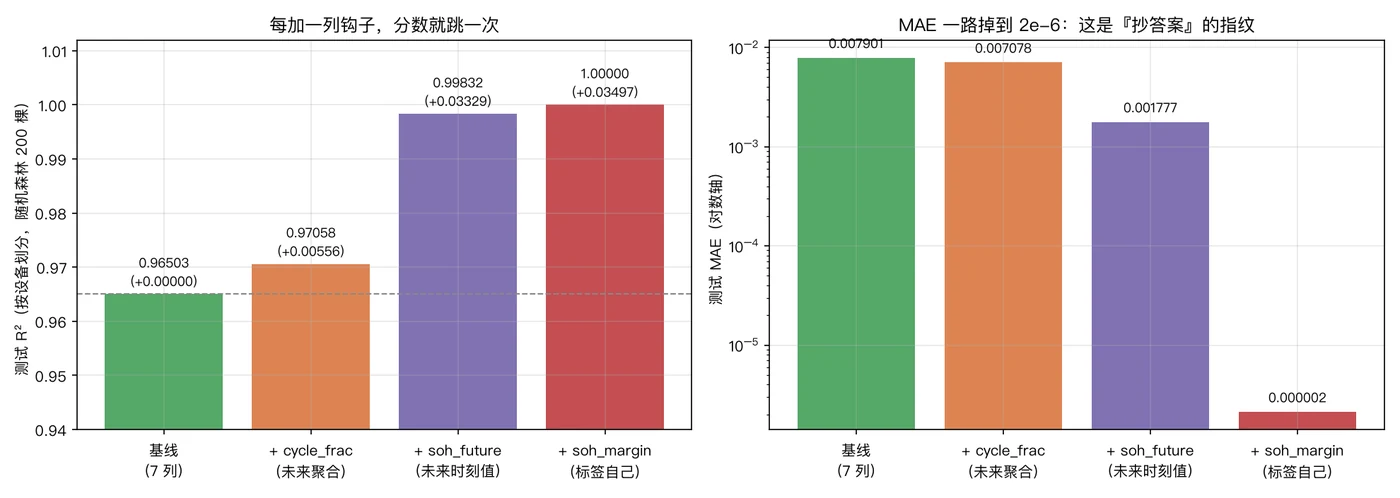
图的读法:
- 左图:四种配置的测试 R²。灰虚线是基线 0.96503。
cycle_frac只抬了 0.00556,soh_future抬了 0.03329,soh_margin直接顶到 1.0。 - 右图:同样的四种配置,纵轴是 MAE(对数轴)。 注意最后一个柱:MAE 掉到 2e-6 —— 这就是"抄答案"的指纹。
20.5 判据:为什么"相关性排查"抓不住它们
这是本章最实用的一节。 很多团队用"|r| > 0.99 就报警"来防泄漏。看它在本数据上的表现:
真实输出:
  为什么『相关性排查』抓不住它们?看与 soh 的 |r| 排序:
    (口径:按本书主表 dropna 后的 19,979 行;soh_future 单列另算)
    1. soh_margin                 |r| = 1.0000  ← 泄漏钩子
    2. soh_win_mean5              |r| = 0.9994  ← 可用,但前提是能拿到历史实测 SOH
    3. soh_lag1                   |r| = 0.9991  ← 可用,但前提是能拿到历史实测 SOH
    4. soh_future                 |r| = 0.9991  ← 泄漏钩子(自造)
    5. soh_lag5                   |r| = 0.9990  ← 可用,但前提是能拿到历史实测 SOH
    6. cycle_frac                 |r| = 0.9757  ← 泄漏钩子
    7. coulombic_eff              |r| = 0.9646
    8. cycle                      |r| = 0.8999
★ 这张表把"相关性阈值"这个方案彻底否掉了:
漏报(该报没报):
    cycle_frac 的 |r| = 0.9757 < 0.99 → 阈值不报,但它是泄漏

误报(不该报却报了):
    soh_lag1(0.9991)、soh_win_mean5(0.9994)、soh_lag5(0.9990)
    → 全部超过 0.99,但它们只要"上线时能拿到历史实测 SOH"就是完全合法的

更难的是:
    soh_lag1(0.9991,合法)与 soh_future(0.9991,泄漏)
    → |r| 一模一样,阈值的输出也是一模一样
★ 结论:
|r| 只能用来"叫你来回答问题",不能用来"给出答案"。 判据必须是"预测时刻可得性",而不是任何统计量。
★ 这里还有一个更深的教训(第 18 章说过一次):
所有"从数据里算出来的指标",都可能被泄漏污染
     · |r| 高 → 可能是强特征,也可能是泄漏
     · R² 高 → 可能是模型好,也可能是在背答案
     · MAE 极低 → 可能是很准,也可能是在抄答案
     ↓
唯一不可能被污染的判据,是【关于流程的事实】:
     这一列在预测这一刻算得出来吗?
     这个数是在哪一行代码里算出来的?
20.6 逐列问一遍:把"可得性"写成账本的一列
真实输出(逐列判定):
⑥ 同一条判据,逐列问一遍(这就是第 16 章特征账本的『可得性』列)
  列名                        判定    依据
  cycle                     ✅     已知:想预测第几圈就知道
  mean_charge_voltage_v     ✅     当圈实测
  mean_temp_rise_c          ✅     当圈实测
  resistance_mohm           ✅     当圈实测
  coulombic_eff             ✅     当圈实测
  cap_fade_rate_ah_per_100  ✅     当圈实测
  temp_std_c                ✅     当圈实测量算出来的
  volt_win_mean             ✅     过去 20 窗口(shift(1) 后 rolling)
  volt_win_std              ✅     同上
  res_win_mean              ✅     同上
  res_win_std               ✅     同上
  temp_win_mean             ✅     同上
  volt_slope20              ✅     过去 20 窗口的变化量
  res_slope20               ✅     同上
  temp_slope20              ✅     同上
  res_diff1                 ✅     相邻窗口一阶差分
  temp_win_range20          ✅     过去 20 窗口的极差
  soh_lag1                  ⚠️    需要能拿到历史【实测】SOH(现场是否每若干圈做容量标定?)
  soh_lag5                  ⚠️    同上
  soh_win_mean5             ⚠️    同上
  soh_win_std5              ⚠️    同上
  cycle_frac                ❌     分母 = 该设备最终总寿命,只有退役才知道(未来聚合)
  soh_margin                ❌     = soh − 0.80,等于把标签当作输入(标签自身)
  soh_future                ❌     = 下一个窗口的 soh(未来时刻的值)
★ 这张表就是第 16 章"特征账本"格式在泄漏排查上的用法。 账本至少要有这几列:
| 列名 | 类型 | 怎么算 | 预测时刻可得吗 | 依据 / 责任人 | 风险 |
|---|---|---|---|---|---|
resistance_mohm | 当圈实测 | BMS 上报 | ✅ | 数据字典 v3 | — |
soh_lag1 | 历史实测 | shift(1) | ⚠️ | 待业务方确认:现场是否定期容量标定? | 高 |
cycle_frac | 未来聚合 | cycle / 总寿命 | ❌ | 总寿命只有退役才知道 | 禁止入模 |
soh_margin | 标签自身 | soh − 0.80 | ❌ | 需要先知道 soh | 禁止入模 |
★ 账本的价值在于:它把"⚠️ 待确认"变成一个具体的、可以追着人问的问题。
"这一列能用吗?"                       → 没人能回答
"现场每 20 圈做一次容量标定吗?如果是,soh_lag1 可以用" → 业务方能回答
     ↓
本章的主线配置(21 列安全特征 + 4 列轨迹)能到 0.99904,
完全取决于这个问题的答案是"是"
     ↓
所以这一行必须写进文档,并且写上【谁确认的、什么时候确认的】
20.7 工程防呆:让"用错特征"变成一件麻烦事
技术手段只能降低概率,流程手段才能挡住它。三条实践:
# ① 把危险列单独列出来,默认口径永远不含它们
LEAKY_COLS = ["cycle_frac", "soh_margin"]          # 已知钩子
FUTURE_COLS = []                                    # shift(-k) 一律进这里
SAFE = BASE + WIN + DIFF + RANGE                    # 17 列
WITH_TRAJ = SAFE + TRAJ # 21 列(需业务确认)# ② 入模前断言:默认路径不可能碰到钩子
def build_feats(include_traj=False, allow_leaky=False):
feats = WITH_TRAJ if include_traj else SAFE
if not allow_leaky:
assert not (set(feats) & set(LEAKY_COLS)), "危险列进入了默认口径"
return feats# ③ 复现泄漏必须显式写参数(让"想看泄漏"变成一个需要解释的动作)
X = df[build_feats(allow_leaky=True)] # 只有对照实验才这么写★ 这三条的核心思想是:
把"正确的做法"变成默认路径,把"违规的做法"变成需要显式声明的例外。
因为泄漏从来不是"有人故意做错",而是"顺手就做错了"。
★ 再加一条"输出侧"的防呆:训练完自动打印三个体检数字。
print(f"max|coef| = {np.abs(model.coef_).max():.4f}   "
      f"MAE = {mae:.2e}   "
f"|r|>0.999 的列 = {[c for c in feats if abs(corr[c]) > 0.999]}")正常配置:max|coef| 0.56 量级,MAE 1e-2 量级,无超高相关列
异常配置:max|coef| ≈ 1,MAE 1e-6,出现 soh_margin
↓
每训练一次就打印一行,成本接近零,抓到一次就回本20.8 常见坑
① 看到 R² = 1.00000 先高兴再查              → 正确顺序是先怀疑
② 只用 |r| > 0.99 排查                      → 漏报 cycle_frac(0.9757)、误报 soh_lag1(0.9991)
③ 用 shift(-1) 造"下一格"当特征              → 方向错一格,性质完全相反
④ 只数 NaN 的个数,不看 NaN 在头还是尾        → 头部 NaN = 只看过去,尾部 NaN = 看了未来
⑤ 用"全周期均值/最大值"当特征                → 未来聚合量的经典形态
⑥ 把"提升只有千分之几"当成"这个特征温和"      → 那正是它最不容易被发现的原因
⑦ 只在代码里删掉钩子,不写进账本              → 下一个人还会加回来
★ 第 ④ 条给一个可以直接用的检查:
def check_shift_direction(df, col, group_col="cell_id"):
    head_nan = df.groupby(group_col)[col].apply(lambda s: s.isna().iloc[:5].all()).all()
    tail_nan = df.groupby(group_col)[col].apply(lambda s: s.isna().iloc[-5:].all()).all()
    if tail_nan and not head_nan:
        return "❌ 危险:NaN 在尾部,这一列很可能是 shift(-k)(用了未来)"
    if head_nan and not tail_nan:
        return "✅ 正常:NaN 在头部,说明它只用了过去"
    return "⚠️ 需要人工确认(头部/尾部都没有 NaN,可能没有分组或没有 shift)"
★ 第 ⑦ 条是团队层面的:
删掉一列的成本是 1 分钟
写清"为什么删、谁确认的"的成本是 5 分钟
     ↓
但后者能防住"下一个人重新加回来" —— 而这件事一定会发生
(因为那一列的业务解释听起来太合理了)
20.9 完整示例与输出
cd tools/feature-engineering-pipeline/code
MPLCONFIGDIR=/tmp/fe-mpl /Users/jini/Projects/MyBooks/Basic-Tutorials/.pytmp/venv/bin/python \
demos/ch20-leak-feature.py真实输出(节选):
① 基线:7 列基础特征,测试 R² = 0.96503   MAE = 0.007901
② + cycle_frac     R² = 0.97058   MAE = 0.007078   虚高 +0.00556
     重要性 0.9581(其余 7 列合计 0.0419)
③ + soh_margin     R² = 1.00000   MAE = 0.000002   虚高 +0.03497
     r = 1.000000
④ + soh_future     R² = 0.99832   MAE = 0.001777   虚高 +0.03329
     r = 0.9991;NaN 60 个(每支设备最后 1 行)
⑤ 阶梯表
  基线(7 列基础)          7   0.96503    0.007901  +0.00000
  + cycle_frac(未来聚合)  8   0.97058    0.007078  +0.00556
  + soh_future(未来时刻值) 8   0.99832    0.001777  +0.03329
  + soh_margin(标签自己)   8   1.00000    0.000002  +0.03497
⑥ 逐列可得性:21 列 ✅ / 4 列 ⚠️(需业务确认历史实测 SOH)/ 3 列 ❌
本章练习
练习 1:复现 cycle_frac 的 +0.00556,并看它的"重要性占比"
- 用 7 列基础特征 + 随机森林 200 棵、按设备划分,打印基线 R² 与 MAE;
- 加上
cycle_frac再跑一次,打印 R²、MAE、虚高; - 打印
feature_importances_中cycle_frac的占比; - 用一句话解释:为什么"一列吃掉 95.8% 的重要性"比"虚高 0.00556"更值得警惕?
参考答案
import pandas as pd
from sklearn.ensemble import RandomForestRegressor
from sklearn.metrics import mean_absolute_error, r2_score
from sklearn.model_selection import GroupShuffleSplit

BASE = ["cycle", "mean_charge_voltage_v", "mean_temp_rise_c", "resistance_mohm",
        "coulombic_eff", "cap_fade_rate_ah_per_100", "temp_std_c"]
df = pd.read_csv("data/battery/soh_features_v2.csv")
tr, te = next(GroupShuffleSplit(n_splits=1, test_size=0.2, random_state=42)
              .split(df[BASE], df["soh"], df["cell_id"]))

def run(feats):
    m = RandomForestRegressor(n_estimators=200, random_state=42, n_jobs=-1)
    m.fit(df[feats].iloc[tr], df["soh"].iloc[tr])
    pred = m.predict(df[feats].iloc[te])
    return r2_score(df["soh"].iloc[te], pred), mean_absolute_error(df["soh"].iloc[te], pred), m

r2_base, mae_base, _ = run(BASE)
r2_frac, mae_frac, m = run(BASE + ["cycle_frac"])
print(f"基线(7 列)   R² = {r2_base:.5f}   MAE = {mae_base:.6f}")
print(f"+ cycle_frac   R² = {r2_frac:.5f}   MAE = {mae_frac:.6f}   虚高 {r2_frac - r2_base:+.5f}")
imp = dict(zip(BASE + ["cycle_frac"], m.feature_importances_))
print(f"cycle_frac 的重要性 = {imp['cycle_frac']:.4f}"
f"(其余 7 列合计 {1 - imp['cycle_frac']:.4f})")期望输出:
基线(7 列)   R² = 0.96503   MAE = 0.007901
+ cycle_frac   R² = 0.97058   MAE = 0.007078   虚高 +0.00556
cycle_frac 的重要性 = 0.9581(其余 7 列合计 0.0419)
★ 第 4 问的答案
虚高 0.00556 只是"结果上的小变化",你会把它当成正常优化;
但重要性 0.9581 是"模型结构上的异常":
    8 列里有一列吃掉了 95.8% 的决策权重
     ↓
一个正常的物理量特征不可能这样 —— 7 列当圈测量值都是真实信号,
它们加起来只值 4.2%?
     ↓
"一列独大"通常意味着两件事之一:
    ① 这一列是标签的等价形式(家族①)
    ② 这一列携带了答案的捷径(家族②/③,本例就是)
     ↓
所以查泄漏时,比起看分数变化,更应该看【重要性分布】
练习 2:自己造 soh_future = shift(-1),并验证 NaN 的位置
- 用
df.sort_values(["cell_id","cycle"]).groupby("cell_id")["soh"].shift(-1)造soh_future; - 加上它跑随机森林,打印 R²、MAE、虚高(基线用 7 列);
- 打印 NaN 的个数,并验证它们正好是每支设备的最后一行;
- 对照说明:如果改成
shift(1)(上一格),NaN 会在哪一头?性质有什么不同?
参考答案
import pandas as pd
from sklearn.ensemble import RandomForestRegressor
from sklearn.metrics import mean_absolute_error, r2_score
from sklearn.model_selection import GroupShuffleSplit

BASE = ["cycle", "mean_charge_voltage_v", "mean_temp_rise_c", "resistance_mohm",
        "coulombic_eff", "cap_fade_rate_ah_per_100", "temp_std_c"]
df = pd.read_csv("data/battery/soh_features_v2.csv")
df["soh_future"] = (df.sort_values(["cell_id", "cycle"])
                      .groupby("cell_id")["soh"].shift(-1))
tr, te = next(GroupShuffleSplit(n_splits=1, test_size=0.2, random_state=42)
              .split(df[BASE], df["soh"], df["cell_id"]))

def run(feats):
    d = df.dropna(subset=feats)
    a, b = d.index.isin(tr), d.index.isin(te)
    m = RandomForestRegressor(n_estimators=200, random_state=42, n_jobs=-1)
    m.fit(d.loc[a, feats], d.loc[a, "soh"])
    pred = m.predict(d.loc[b, feats])
    return r2_score(d.loc[b, "soh"], pred), mean_absolute_error(d.loc[b, "soh"], pred), len(d)

r2_base, _, _ = run(BASE)
r2_fut, mae_fut, n = run(BASE + ["soh_future"])
print(f"+ soh_future   R² = {r2_fut:.5f}   MAE = {mae_fut:.6f}   虚高 {r2_fut - r2_base:+.5f}")
nan_pos = set(df.index[df["soh_future"].isna()])
last_of_cell = set(df.groupby("cell_id").tail(1).index)
print(f"NaN 个数 = {len(nan_pos)} 是否正好是每支设备的最后一行:{nan_pos == last_of_cell}")期望输出:
+ soh_future   R² = 0.99832   MAE = 0.001777   虚高 +0.03329
NaN 个数 = 60   是否正好是每支设备的最后一行:True
★ 第 4 问的答案
shift(-1) → NaN 在【尾部】(每支设备最后 1 行,60 个)
shift( 1) → NaN 在【头部】(每支设备最早 1 行,60 个)
     ↓
NaN 的个数完全相同、位置刚好相反 —— 那个"相反"就是时间方向
     ↓
shift(1) 用上一格(历史)→ 只要上线时能拿到历史实测 SOH,它是合法特征
shift(-1) 用下一格(未来)→ 无论什么条件都拿不到,必须删
     ↓
两者的 |r| 都是 0.9991 量级,从统计量上完全分不出来;
唯一能分辨的,是"它指向过去还是未来"
练习 3:写一张"可得性判定表",并证明 |r| 会漏报也会误报
- 给下面 8 列写判定(✅ 可用 / ⚠️ 有条件可用 / ❌ 泄漏)与依据:
cycle、resistance_mohm、temp_win_range20、soh_lag1、soh_win_mean5、cycle_frac、soh_margin、soh_future; - 在 dropna 后的主表上,打印与
soh的 |r| 前 6 名; - 用第 2 步的结果说明:为什么"|r| > 0.99 报警"这个方案在本数据上会漏报也会误报。
参考答案
import numpy as np, pandas as pd

BASE = ["cycle", "mean_charge_voltage_v", "mean_temp_rise_c", "resistance_mohm",
        "coulombic_eff", "cap_fade_rate_ah_per_100", "temp_std_c"]
WIN = ["volt_win_mean", "volt_win_std", "res_win_mean", "res_win_std", "temp_win_mean"]
DIFF = ["volt_slope20", "res_slope20", "temp_slope20", "res_diff1"]
TRAJ = ["soh_lag1", "soh_lag5", "soh_win_mean5", "soh_win_std5"]
SAFE21 = BASE + WIN + DIFF + ["temp_win_range20"] + TRAJ

df = pd.read_csv("data/battery/soh_features_v2.csv")
df["soh_future"] = (df.sort_values(["cell_id", "cycle"])
                      .groupby("cell_id")["soh"].shift(-1))

verdict = {
    "cycle": ("✅", "想预测第几圈就知道"),
    "resistance_mohm": ("✅", "当圈实测"),
    "temp_win_range20": ("✅", "过去 20 窗口的极差"),
    "soh_lag1": ("⚠️", "需要能拿到历史【实测】SOH"),
    "soh_win_mean5": ("⚠️", "同上"),
    "cycle_frac": ("❌", "分母是最终总寿命(未来聚合)"),
    "soh_margin": ("❌", "= soh − 0.80(标签自身)"),
    "soh_future": ("❌", "= 下一窗口的 soh(未来时刻值)"),
}
for c, (v, why) in verdict.items():
    print(f"{c:<18}{v:<4}{why}")

d = df.dropna(subset=SAFE21)
corrs = sorted([(c, abs(np.corrcoef(d[c], d["soh"])[0, 1]))
                for c in BASE + WIN + DIFF + TRAJ + ["temp_win_range20"]],
               key=lambda t: -t[1])[:6]
print("\n|r| 前 6 名:")
for c, v in corrs:
    print(f"  {c:<20}|r| = {v:.4f}")
print(f" {'soh_margin':<20}|r| = 1.0000")期望输出(节选):
cycle             ✅  想预测第几圈就知道
resistance_mohm   ✅  当圈实测
temp_win_range20  ✅  过去 20 窗口的极差
soh_lag1          ⚠️  需要能拿到历史【实测】SOH
soh_win_mean5     ⚠️  同上
cycle_frac        ❌  分母是最终总寿命(未来聚合)
soh_margin        ❌  = soh − 0.80(标签自身)
soh_future        ❌  = 下一窗口的 soh(未来时刻值)

|r| 前 6 名:
  soh_win_mean5       |r| = 0.9994
  soh_lag1            |r| = 0.9991
  soh_lag5            |r| = 0.9990
  coulombic_eff       |r| = 0.9646
  cycle               |r| = 0.8999
  res_win_mean        |r| = 0.8712
  (soh_margin |r| = 1.0000 若放进候选集,会直接排第 1)
★ 第 3 问的答案
误报:soh_win_mean5(0.9994)、soh_lag1(0.9991)、soh_lag5(0.9990)
      都超过 0.99,但它们是合法的"历史实测 SOH"轨迹特征
漏报:cycle_frac 只有 0.9757,低于阈值 —— 可它是"用了总寿命"的泄漏
对称盲区:soh_lag1(合法)与 soh_future(泄漏)的 |r| 都是 0.9991
     ↓
所以任何基于统计量的阈值,都无法区分"指向过去"与"指向未来"
     ↓
唯一能区分的判据是关于流程的事实:这个数在预测这一刻算得出来吗?
面向工程实践
| 场景 | 怎么用 |
|---|---|
| 特征评审会 | 每个新特征必须回答一句:"预测这一刻怎么算出来?"写进账本 |
| 代码评审 | grep -n "shift(-":任何负数 shift 都要有解释;全周期 mean()/max() 同理 |
| 特征平台 | 把 LEAKY_COLS / FUTURE_COLS 变成平台级常量,默认口径不可能取到它们 |
| 分数异常排查 | 分数突然涨 0.03 → 先看 feature_importances_ 有没有"一列独大" |
| 与业务方对齐 | soh_lag* 这类"有条件可用"列,必须拿到书面确认(谁能、多久、怎么标定) |
| 模型上线 | 推理端必须能提供每一列的原始输入;提供不了的列等于泄漏 |
★ 一句话总结本章:
特征泄漏不是一个 bug,是一族 bug。 家族有三支:标签自身、未来聚合、未来时刻值。 它们唯一的共同判据是"预测这一刻能不能拿到"—— 而这条判据只能问流程,不能问数据。