第 12 章 · 类别编码:OneHot 与 Label 到底差在哪
这一章要解决什么:上一章把数值列的量纲对齐了。表里还剩两列不是数字:
batch(批次 A~D)与test_condition(工况 std/fast/hot)。sklearn只吃数字,所以必须编码 —— 但怎么编会改变模型的世界观。最容易踩的坑: ① 对无序类别用
LabelEncoder再喂线性模型 —— 你等于告诉它"fast 是 std 的两倍"; ② 以为"加了类别列分数就该涨" —— 实测六种组合全都没涨(12.2); ③ 把高基数类别(比如设备编号)也 OneHot —— 维度爆炸 + 测试集全是 0(12.5)。
本章你需要完成的代码:demos/ch12-encoding.py
12.1 两列不是数字:先看分布,再问它和标签有没有关系
真实输出:
数据:soh_features_v2.csv  21239 行,训练 17244 行 / 测试 3995 行(按设备划分,random_state=42)

① 两列类别长什么样

  batch           4 类   A 5,553  B 5,446  D 5,223  C 5,017
test_condition 3 类 fast 7,802 hot 6,719 std 6,718先别急着编码,先问一个更前面的问题:这两列和标签真的有关吗?
② 类别与标签【真的有关】吗?——先别急着编码,先看数

                count     mean      std
test_condition
fast             7802  0.90979  0.05533
hot              6719  0.90865  0.05478
std              6718  0.90767  0.05431

  三个工况的 SOH 均值极差 = 0.00212
  而 SOH 自身的标准差     = 0.05484,单个工况内部的 std ≈ 0.05481
  → 工况之间的差异(0.00212)和工况内部的波动(0.05481)是一个量级 —— 这列与标签【基本无关】。

  批次均值极差 = 0.00159(A 最高 / D 最低)
★ 这三个数字要一起读:
"三个工况的均值不一样"(0.90979 / 0.90865 / 0.90767)
    ↓ 看起来排序整齐,像是有规律
"但组内标准差是 0.05481,组间差只有 0.00212"
    ↓ 组间差只有组内波的 1/26
    ↓ 这不是"工况有效应",这是"三个随机样本的均值不可能完全相等"
★ 一条纪律(第 10 章讲过、这一章再用一次):
类别列值不值得进模型,只能看它在验证集/消融上有没有把分数抬起来, 不能看它在训练集上"看起来有区分度"。
本数据的背景:这份表是教学合成数据,batch 来自真值表 cells.csv, test_condition 是按设备确定性轮流指派的(CONDITIONS[i % 3])—— 它们与 SOH 无关。所以这一章的重点不是"这两列有用没用", 而是**"同样两列,用不同编码方式送进去,会发生什么"**。
12.2 三种处理 × 两种模型:加进去,分数没涨
真实输出:
④ 三种处理 × 两种模型(同一划分、同一随机种子)

  丢掉类别列        + 随机森林   特征维度  7   测试 R² = 0.96503    5.84s
  丢掉类别列        + 线性回归   特征维度  7   测试 R² = 0.94253    0.00s
  OneHot 独热    + 随机森林   特征维度 14   测试 R² = 0.96091    6.76s
  OneHot 独热    + 线性回归   特征维度 14   测试 R² = 0.93270    0.01s
  Label 序号     + 随机森林   特征维度  9   测试 R² = 0.96183    6.19s
  Label 序号     + 线性回归   特征维度  9   测试 R² = 0.94288    0.01s

  → 和'丢掉'相比:OneHot+随机森林 -0.00412,Label+随机森林 -0.00319
  → 和'丢掉'相比:OneHot+线性回归 -0.00982,Label+线性回归 +0.00036
  ★ 加了列分数【没有变好】—— 类别列不是免费的午餐。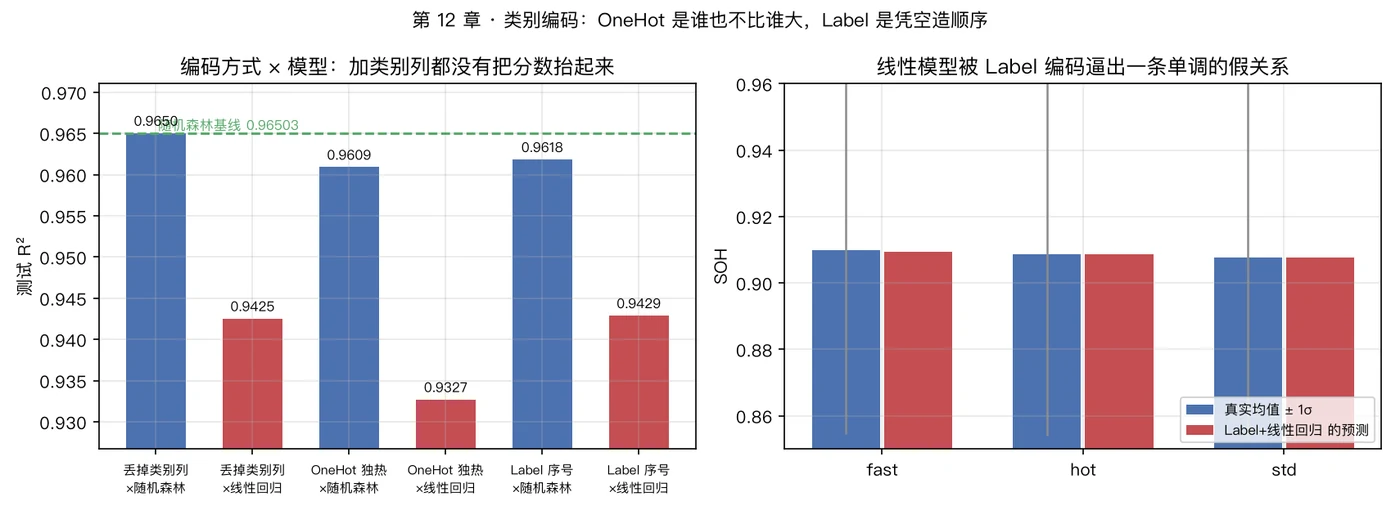
★ 六种组合,一次读完:
| 处理 | 特征维度 | 随机森林 | 线性回归 | 维度是怎么来的 |
|---|---|---|---|---|
| 丢掉类别列 | 7 | 0.96503 | 0.94253 | 基础 7 列 |
| OneHot 独热 | 14 | 0.96091 | 0.93270 | 7 + batch 4 + condition 3 |
| Label 序号 | 9 | 0.96183 | 0.94288 | 7 + 2(每列 1 个数) |
★ 三条观察,每条都在打破一个直觉:
观察一:加了两列,随机森林反而掉了 —— 0.96503 → 0.96091 / 0.96183
        (掉 0.004 / 0.003)
        原因:加的是噪声列,树会拿一部分分裂机会去"记住"这些噪声

观察二:线性回归这边,OneHot 掉得比 Label 还多(0.93270 < 0.94288 < 0.94253)
        原因:OneHot 给了 7 个 0/1 列,其中 4+3 列与截距近似共线 ——
        信息没增加,方差却增加了(第 14 章讲的多重共线性)

观察三:Label + 线性回归看着"没掉"(0.94288 vs 0.94253,+0.00036)
        ★ 这不是"Label 更好",而是【两个错误互相抵消】:
        多出来的 2 列噪声降分,被迫拟合出来的"假斜率"恰好又蒙对了一点点。
        12.3 会用换编号顺序的实验把它戳穿。
★ 一句话结论:
类别列不是免费的午餐。 它值不值得留,只能由消融实验(第 15 章)回答: 把它拿掉重训一次,分数掉不掉?
★ 那为什么还要学编码? 因为真实项目里总会有真的有用的类别列 (工况、产线、供应商、故障码)。那时候"编码方式对不对"就直接决定分数上限:
有用的类别列 × 正确的编码 → 分数涨
有用的类别列 × 错误的编码 → 分数涨得少,甚至不涨
没用的类别列 × 任何编码   → 分数不涨(本章的数据就是这种情况)
12.3 线性模型被 Label 误导的正面证据
先把 Label 编码做了什么看清楚:
③ Label 编码把字符串换成了什么

  batch           A → 0   B → 1   C → 2   D → 3
  test_condition  fast → 0   hot → 1   std → 2
  → 0/1/2 只是按字典序编的号,但线性模型会把它当成真的数值大小。
★ 关键的一句话:
"fast / hot / std" 三者之间【没有大小关系】(无序类别)
    ↓
LabelEncoder 给它们 0 / 1 / 2
    ↓
线性模型看到的是一个【数值列】,它会去找 w·编号 这条线性关系
    ↓
于是它被迫相信:"hot 比 std 大一倍,fast 是 std 的两倍"真实输出(这一章的正面证据之一):
⑤ 线性模型被 Label 误导的正面证据:它给每个工况安了一个'斜率'

  只用 Label 后的 test_condition 拟合:coef = -0.000938  intercept = 0.909494
  模型读到的'规律':工况编号每 +1,SOH 变化 -0.000938
    fast (编号 0)→ 预测 0.909494   真实均值 0.909792
    hot  (编号 1)→ 预测 0.908556   真实均值 0.908654
    std  (编号 2)→ 预测 0.907617   真实均值 0.907668
  → 三个预测值必然落在同一条直线上:1 个编号 = 1 个自由度 = 只能表达'单调趋势'。
★ 看清这两列的差距:
真实的三个均值:0.909792 / 0.908654 / 0.907668
模型的三个预测:0.909494 / 0.908556 / 0.907617
                                        ↑
                   它们【必然】等距(间隔都是 -0.000938)

而真实的三个均值间隔:-0.001138 / -0.000986 —— 不相等什么叫"被迫等距":
Label 编码把 3 个类别压成 1 个自由度(一维坐标轴)
    ↓
线性模型在这个轴上只能画一条直线
    ↓
3 个类别的预测值 = 直线上等距的 3 个点
    ↓
而"3 个类别各自有自己的均值"需要 2 个自由度(K−1 个虚拟变量)
    ↓
OneHot 才给得起这 2 个自由度(3 个 0/1 列,其中 1 列与截距冗余)
★ 决定性实验:换一个同样合法的编号顺序
"字典序编号"和"随便另一套编号"都同样合法 —— 因为类别本来就无序,任何顺序都行。 如果模型真的把编号当"类别",那换编号不该改变答案。
真实输出:
  同一列、两种合法编号顺序,线性回归给出的答案:
    丢掉类别列                  测试 R² = 0.94253
    OneHot(原顺序)            测试 R² = 0.94472
    OneHot(把列换个顺序)         测试 R² = 0.94472
    Label 编号(字典序)          测试 R² = 0.94231   ← 换个编号就变了
    Label 编号(换个顺序)         测试 R² = 0.94317   ← 换个编号就变了
  ★ OneHot 对列顺序不变的(R² 一模一样);Label 只换了个编号,答案就不同 ——
    说明线性模型真的把那个编号当成了数值大小,而不是'类别标签'。
★ 这张表是这一章的核心证据:
| 处理 | 原顺序 | 换个顺序 | 变了吗 | 说明 |
|---|---|---|---|---|
| OneHot | 0.94472 | 0.94472 | 没变 | 列的顺序不影响信息内容 |
| Label | 0.94231 | 0.94317 | 变了(差 0.00086) | 编号的数值大小参与运算 |
一个"与类别真实含义无关"的编号顺序,改变了模型的答案
    ↓
说明模型的答案【依赖一个不该存在的假设】
    ↓
这个假设就是:类别之间有序、而且间隔相等
★ 别把 0.00086 看小:
在这份数据上它只有万分之八,因为类别列本来就没用(12.1)
    ↓
但同一个机制放到"真的有关系"的类别列上(例如 20 个产线、5 档故障码):
    有序假设错误 → 模型只能沿一条假想的数轴走 → 分数上限被压住
    ↓
这就是"编码方式决定上限"的意思
★ 一句可以直接背下来的判据:
问:"这个类别的取值之间有大小关系吗?"有(小/中/大、温度档位)→ Label 可以;没有(批次、工况、颜色)→ 只能 OneHot。
12.4 树为什么不在乎:它只问"能不能分到不同分支"
真实输出:
⑥ 树模型为什么不敏感:它只问'能不能分到不同分支'

  Label 编号(字典序)          测试 R² = 0.96573
  Label 编号(换个顺序)         测试 R² = 0.96604
  OneHot(原顺序)            测试 R² = 0.96593
  → 换编号对树的影响:0.00031(对线性模型:0.00086)
★ 机制:树的一次分裂只用到一个问题
树在第 k 个节点问:"test_condition ≤ 0.5 ?"
    ↓
编号是 std=0/fast=1/hot=2 → 这一问把 std 单独切出来
编号换成 std=0/fast=1/hot=2 的任意排列 → 树会换一个阈值,切出【同一组】子集
    ↓
树只关心"能不能把不同类别分到不同分支",不关心它们是 0 还是 1 还是 2
★ 一张对照表:
| 线性回归 | 决策树 / 森林 | |
|---|---|---|
| 它怎么用类别列 | 算 w × 编号 | 算 编号 ≤ 阈值 ? |
| 编号的数值大小参与运算吗 | 参与(所以要乘 w) | 不参与(只改变阈值的具体数值) |
| 换个编号顺序会怎样 | 答案变(0.94231 → 0.94317) | 基本不变(0.96573 → 0.96604) |
| 类别多的时候 | 只能表达 1 个自由度 | 深度足够时可以切出多个子集 |
★ 但"树不敏感"有三条边界,别当免死金牌:
① 树仍然默认"编号有序":它能切出的子集是【编号区间】。
   如果类别本身没有序,某些组合就永远切不出来
   (例如 {hot} 单独一类、{fast, std} 一类,在 hot=1 这一套编号下要两次分裂才行)。
   → 类别多的时候,OneHot 往往让树更省深度。

② 类别一多,树的深度就要花在"二分"上:
   20 个类别用 Label 要 4~5 层才能分完,用 OneHot 1 层就行。

③ 树不敏感 ≠ 可以对无序类别用 Label:
   同一个管道里如果还有线性层(例如 stacking、(广义)线性模型、
   或者"先树挑特征再线性回归"的两段式),错误的编号顺序照样会传下去。
★ 工程结论:
不要问"我的模型是树还是线性",要问"这个类别的取值有没有顺序"。没有顺序就用 OneHot —— 这对树没有坏处(只是多几列),对线性模型是必须的。
12.5 高基数陷阱:把"设备编号"当类别列
真实输出:
⑦ 高基数陷阱:把设备编号当成类别列

  训练集出现 48 个设备编号 → 独热出 48 列 0/1
  测试集 12 支设备【一支都没在训练集里出现过】
  测试集独热后每一行都是全 0 的概率:1.00(实测非零元个数 = 0)
★ 为什么"设备编号"这列特别危险:
它当然和 SOH 有关 —— 每支设备有自己的个体偏置(上一本第 10 章讲过的第①层误差)
    ↓
所以它在【训练集内部】看起来是个好特征
    ↓
但"设备编号 = 某支设备"这件事,在没见过的新设备上没有任何意义两种划分方式,两个完全不同的世界:
| 划分方式 | OneHot(设备编号) 的命运 | 实测(线性回归) |
|---|---|---|
| 按设备划分(正确) | 测试集 12 支设备一支都没见过 → 48 列全是 0 | 0.83116(比不加还差,见练习 3) |
| 按行随机划分(错误) | 训练集里有这支设备的其它行 → 编号就是"身份证" | 0.98308(虚高 +0.03866) |
按行随机划分时,OneHot(设备编号) 给了模型一张"设备身份证":
    ↓
模型只要认出"这是第 7 支设备",就能直接吐出这支设备的平均 SOH
    ↓
而按设备划分时,测试集那 12 支设备一支都没出现过
    ↓
48 列全 0 → 这 48 列在测试集上【不提供任何信息】
★ 三条工程纪律:
① 高基数类别(几十~几万个取值)不要 OneHot:
   维度爆炸(1000 个取值 = 1000 列 0/1,稀疏率 99.9%),
   而且测试集极可能全是 0。
   替代方案:目标编码 / 频次编码 / 哈希编码 / 干脆丢掉。

② 判断"高基数"不是看列里有多少个字符串,而是看
   【每个取值在训练集里有几行】—— 5 行/取值的列,学不到东西。

③ 与个体强相关的列(设备编号、用户 ID、门店 ID)要问一句:
   "预测这一刻,这个 ID 是新出现的还是见过的?"
   新出现的多 → 它就不是特征,是划分方式的探针(第 18 章)。
12.6 handle_unknown="ignore":线上一定会遇到没见过的类别
真实输出(真报错):
⑧ 忘了 handle_unknown="ignore" 会怎样(真报错)

  ValueError: Found unknown categories ['std'] in column 0 during transform
  加了 handle_unknown="ignore" 之后:预测前 5 行 = [0.90922 0.90922 0.90922 0.90922 0.90922]
★ 这个报错是怎么制造出来的:
# 训练集里只出现 fast/hot(没有 std),测试集里冒出 std → 这就是线上"新工况"
seen = df[df["test_condition"] != "std"]
bad = Pipeline([("cat", ColumnTransformer([
            ("cat", OneHotEncoder(), ["test_condition"])])),   # ← 没写 handle_unknown
        ("m", LinearRegression())])
bad.fit(seen[["test_condition"]], seen["soh"])
bad.predict(df[["test_condition"]].head(5))     # ← 这里炸
★ 为什么这是"必然会发生"的错误:
离线时:测试集是你自己切的,里面当然只有训练时见过的类别
上线后:新工况、新批次、新供应商随时会出现
    ↓
默认 handle_unknown="error" → 线上第一个新类别就把服务打挂
    ↓
两种修法:
   ① handle_unknown="ignore"  → 未知类别编码成全 0(最省事,本章用这个)
   ② handle_unknown="infrequent_if_exist" + min_frequency
      → 把低频类别合并成一类(更稳,但要多一个超参)
★ "ignore" 的代价要写进文档:
未知类别 → 全 0
    ↓
线性模型:这些行等于"没有任何已知工况特征",预测值退化成只用数值列
树模型:这些行会与所有已知类别同路,走默认分支
    ↓
所以上线后要【监控未知类别的比例】:
    比例突然升高 = 数据分布变了 = 该重训了
12.7 常见坑
① 对无序类别用 Label 再喂线性模型   → 强迫模型沿一条假想的数轴走(0.94231 vs OneHot 0.94472)
② 用"分数没掉"证明 Label 没问题      → 换个编号顺序,答案就变了(0.94231 → 0.94317)
③ 以为"加了类别列分数就该涨"          → 六种组合全都没涨(0.96503 → 0.96091 / 0.96183)
④ 高基数类别硬上 OneHot               → 维度爆炸 + 测试集全 0(12.5)
⑤ 忘了 handle_unknown="ignore"        → 线上遇到新类别当场抛 ValueError
⑥ 在划分之前对整表 fit OneHot         → 类别表里混进了测试集的类别(预处理泄漏,第 19 章)
⑦ 用 LabelEncoder 编完就直接 fit      → LabelEncoder 本来是为标签设计的;
                                        特征列的编码要用 OrdinalEncoder 或 OneHotEncoder
⑧ 以为"树不敏感"就等于"可以乱用 Label" → 树能切出的只是编号区间,类别多时反而更费深度
★ 第 ⑦ 条展开一下(这是新手最常混的一对 API):
LabelEncoder    : 为【标签 y】设计,一次处理一列,返回 1 维
OrdinalEncoder  : 为【特征 X】设计,一次处理多列,保持 2 维(fit_transform 不改变形状)
OneHotEncoder   : 为【特征 X】设计,把每一类变成一个 0/1 列

本章 demo 里用 LabelEncoder 编特征列,只是为了"演示这个错误" ——
生产代码请用 OrdinalEncoder(如果真的要序号)或 OneHotEncoder。
12.8 完整示例与输出
cd tools/feature-engineering-pipeline/code
MPLCONFIGDIR=/tmp/fe-mpl /path/to/venv/bin/python demos/ch12-encoding.py真实输出(节选):
④ 三种处理 × 两种模型(同一划分、同一随机种子)

  丢掉类别列        + 随机森林   特征维度  7   测试 R² = 0.96503
  丢掉类别列        + 线性回归   特征维度  7   测试 R² = 0.94253
  OneHot 独热    + 随机森林   特征维度 14   测试 R² = 0.96091
  OneHot 独热    + 线性回归   特征维度 14   测试 R² = 0.93270
  Label 序号     + 随机森林   特征维度  9   测试 R² = 0.96183
  Label 序号     + 线性回归   特征维度  9   测试 R² = 0.94288

⑤ 线性模型被 Label 误导的正面证据:它给每个工况安了一个'斜率'
    OneHot(原顺序)            测试 R² = 0.94472
    OneHot(把列换个顺序)         测试 R² = 0.94472
    Label 编号(字典序)          测试 R² = 0.94231
    Label 编号(换个顺序)         测试 R² = 0.94317

⑦ 高基数陷阱:把设备编号当成类别列
  测试集独热后每一行都是全 0 的概率:1.00(实测非零元个数 = 0)
★ 一页记住这一章:
无序类别 → OneHot(K 列 0/1 或 K−1 列 + 截距)
有序类别 → Label / OrdinalEncoder 可以
线性模型 → 被错误编号误导(换顺序答案就变)
树模型   → 对编号几乎无感,但"区间切分"仍然是个假设
高基数   → 不要 OneHot;先问"这个 ID 在测试集里出现过吗"
线上     → handle_unknown="ignore" 必写,并且要监控未知类别比例
本章练习
练习 1:三种处理的特征维度是怎么算出来的
用 soh_features_v2.csv 的 7 列数值特征 + batch(4 类)+ test_condition(3 类):
- 手算三种处理的输出维度,并说出每一列是怎么来的;
- 用代码跑
丢掉 / OneHot / Label×随机森林(200) / 线性回归六种组合, 报特征维度与测试 R²(同一划分:GroupShuffleSplit(test_size=0.2, random_state=42)); - 用一句话回答:加了类别列之后,分数为什么没涨?
参考答案
import os

import pandas as pd
from sklearn.compose import ColumnTransformer
from sklearn.ensemble import RandomForestRegressor
from sklearn.linear_model import LinearRegression
from sklearn.metrics import r2_score
from sklearn.model_selection import GroupShuffleSplit
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import LabelEncoder, OneHotEncoder

HERE = os.path.dirname(os.path.abspath(__file__))
CODE = os.path.abspath(os.path.join(HERE, "..", ".."))
DATA = os.path.join(CODE, "data", "battery")

NUM = ["cycle", "mean_charge_voltage_v", "mean_temp_rise_c", "resistance_mohm",
       "coulombic_eff", "cap_fade_rate_ah_per_100", "temp_std_c"]
CAT = ["batch", "test_condition"]

df = pd.read_csv(os.path.join(DATA, "soh_features_v2.csv"))
X, y, g = df[NUM + CAT], df["soh"], df["cell_id"]
tr, te = next(GroupShuffleSplit(n_splits=1, test_size=0.2, random_state=42)
              .split(X, y, g))

enc = df.copy()
for c in CAT:
    enc[c] = LabelEncoder().fit_transform(enc[c])

print("维度账:")
print(f"  丢掉:7 列")
print(f"  OneHot:7 + batch {df['batch'].nunique()} + condition "
      f"{df['test_condition'].nunique()} = {7 + df['batch'].nunique() + df['test_condition'].nunique()} 列")
print(f"  Label:7 + 2 = 9 列")

handlers = {
    "丢掉类别列": (NUM, None, df),
    "OneHot 独热": (NUM + CAT, ColumnTransformer([
        ("num", "passthrough", NUM),
        ("cat", OneHotEncoder(handle_unknown="ignore"), CAT)]), df),
    "Label 序号": (NUM + CAT, None, enc),
}
for name, (cols, pre, table) in handlers.items():
    for mname, model in [("随机森林", RandomForestRegressor(
            n_estimators=200, random_state=42, n_jobs=-1)),
            ("线性回归", LinearRegression())]:
        pipe = (Pipeline([("pre", pre), ("m", model)]) if pre is not None
                else Pipeline([("m", model)]))
        xtr, xte = table[cols].iloc[tr], table[cols].iloc[te]
        pipe.fit(xtr, y.iloc[tr])
        n = pipe[:-1].fit_transform(xtr).shape[1] if pre is not None else len(cols)
        print(f"{name:12s} + {mname}  特征维度 {n:2d}  "
f"测试 R² = {r2_score(y.iloc[te], pipe.predict(xte)):.5f}")期望输出:
维度账:
  丢掉:7 列
  OneHot:7 + batch 4 + condition 3 = 14 列
  Label:7 + 2 = 9 列
丢掉类别列        + 随机森林  特征维度  7  测试 R² = 0.96503
丢掉类别列        + 线性回归  特征维度  7  测试 R² = 0.94253
OneHot 独热    + 随机森林  特征维度 14  测试 R² = 0.96091
OneHot 独热    + 线性回归  特征维度 14  测试 R² = 0.93270
Label 序号     + 随机森林  特征维度  9  测试 R² = 0.96183
Label 序号     + 线性回归  特征维度  9  测试 R² = 0.94288
③ 回答:因为这两列与标签无关,加进去只是给模型多塞了噪声。
维度从 7 涨到 14 / 9,但信息量为 0
    ↓
随机森林:把一部分分裂机会花在噪声列上 → 掉 0.004 / 0.003
线性回归:OneHot 多出 7 个近似共线的 0/1 列 → 掉 0.010
    ↓
所以"类别列不是免费的午餐":它的价值必须由消融实验回答(第 15 章)
练习 2:换一个同样合法的编号顺序,谁被误导了?
test_condition 有三个取值,编号方式天然有 6 种,全都同样合法。
- 用字典序编号(
fast=0, hot=1, std=2)跑一次线性回归与随机森林; - 换成
std=0, fast=1, hot=2再跑一次; - 把两次的差算出来,分别对"线性回归"和"随机森林"各报一个数;
- 用一个实验证明"OneHot 对列顺序不敏感"(把 OneHot 的列倒过来排,再跑一次)。
参考答案
import os

import numpy as np
import pandas as pd
from sklearn.ensemble import RandomForestRegressor
from sklearn.linear_model import LinearRegression
from sklearn.metrics import r2_score
from sklearn.model_selection import GroupShuffleSplit
from sklearn.preprocessing import OneHotEncoder

HERE = os.path.dirname(os.path.abspath(__file__))
CODE = os.path.abspath(os.path.join(HERE, "..", ".."))
DATA = os.path.join(CODE, "data", "battery")

NUM = ["cycle", "mean_charge_voltage_v", "mean_temp_rise_c", "resistance_mohm",
       "coulombic_eff", "cap_fade_rate_ah_per_100", "temp_std_c"]

df = pd.read_csv(os.path.join(DATA, "soh_features_v2.csv"))
y = df["soh"]
tr, te = next(GroupShuffleSplit(n_splits=1, test_size=0.2, random_state=42)
              .split(df[NUM], y, df["cell_id"]))

tc = df["test_condition"]
oh = OneHotEncoder(handle_unknown="ignore", sparse_output=False)
tc_oh = pd.DataFrame(oh.fit_transform(df[["test_condition"]]),
                     columns=oh.get_feature_names_out(["test_condition"]))
order_a, order_b = sorted(tc.unique()), ["std", "fast", "hot"]
lab_a = tc.map({v: i for i, v in enumerate(order_a)}).rename("tc_a")
lab_b = tc.map({v: i for i, v in enumerate(order_b)}).rename("tc_b")
print(f"编号顺序 A:{dict(zip(order_a, range(3)))}")
print(f"编号顺序 B:{dict(zip(order_b, range(3)))}")

variants = {
    "丢掉类别列": df[NUM],
    "OneHot": pd.concat([df[NUM].reset_index(drop=True), tc_oh.reset_index(drop=True)], axis=1),
    "OneHot 列倒序": pd.concat([df[NUM].reset_index(drop=True),
                             tc_oh[list(tc_oh.columns[::-1])].reset_index(drop=True)], axis=1),
    "Label A": pd.concat([df[NUM].reset_index(drop=True), lab_a.reset_index(drop=True)], axis=1),
    "Label B": pd.concat([df[NUM].reset_index(drop=True), lab_b.reset_index(drop=True)], axis=1),
}
scores = {}
for tag, X_ in variants.items():
    for mname, model in [("随机森林", RandomForestRegressor(
            n_estimators=100, random_state=42, n_jobs=-1)),
            ("线性回归", LinearRegression())]:
        model.fit(X_.iloc[tr], y.iloc[tr])
        scores[(tag, mname)] = r2_score(y.iloc[te], model.predict(X_.iloc[te]))
print(f"{'处理':16s} {'随机森林':>10s} {'线性回归':>10s}")
for tag in variants:
    print(f"{tag:16s} {scores[(tag, '随机森林')]:10.5f} {scores[(tag, '线性回归')]:10.5f}")
print(f"Label 换编号:线性回归差 "
      f"{abs(scores[('Label A', '线性回归')] - scores[('Label B', '线性回归')]):.5f},"
      f"随机森林差 "
      f"{abs(scores[('Label A', '随机森林')] - scores[('Label B', '随机森林')]):.5f}")
print(f"OneHot 列倒序:线性回归差 "
f"{abs(scores[('OneHot', '线性回归')] - scores[('OneHot 列倒序', '线性回归')]):.5f}")期望输出:
编号顺序 A:{'fast': 0, 'hot': 1, 'std': 2}
编号顺序 B:{'std': 0, 'fast': 1, 'hot': 2}
处理                       随机森林       线性回归
丢掉类别列                 0.96487    0.94253
OneHot                0.96574    0.94472
OneHot 列倒序             0.96574    0.94472
Label A               0.96566    0.94231
Label B               0.96581    0.94317
Label 换编号:线性回归差 0.00086,随机森林差 0.00015
OneHot 列倒序:线性回归差 0.00000
★ 三个数字,一个结论:
Label 换编号 → 线性回归差 0.00086(变了)
Label 换编号 → 随机森林差 0.00015(几乎没有)
OneHot 列倒序 → 线性回归差 0.00000(完全不变)

⇒ 线性模型把编号当【数值】用;树和 OneHot 都只把它当【类别】用。
★ 练习 2 为什么用 100 棵树:这里比的是同一实验内部的差, 树数不影响结论;100 棵只是为了跑得快(正文第 12.2 节用的是 200 棵, 所以那一节的随机森林数字比这里高第 4 位小数)。
练习 3:把"设备编号"OneHot 会发生什么
- 把
cell_id独热,报训练集有多少个类别、测试集有多少支设备在训练集里出现过、 测试集独热矩阵的非零元个数; - 用线性回归在按设备划分下拟合(数值列 + 设备编号的 48 列),报测试 R², 并与"不加设备编号"的对照比;
- 改用按行随机划分(
train_test_split(test_size=0.2, random_state=42))再跑一次, 报测试 R² 与虚高幅度; - 回答:为什么同一个特征在两种划分下差这么多?
参考答案
import os

import numpy as np
import pandas as pd
from sklearn.linear_model import LinearRegression
from sklearn.metrics import r2_score
from sklearn.model_selection import GroupShuffleSplit, train_test_split
from sklearn.preprocessing import OneHotEncoder

HERE = os.path.dirname(os.path.abspath(__file__))
CODE = os.path.abspath(os.path.join(HERE, "..", ".."))
DATA = os.path.join(CODE, "data", "battery")

NUM = ["cycle", "mean_charge_voltage_v", "mean_temp_rise_c", "resistance_mohm",
       "coulombic_eff", "cap_fade_rate_ah_per_100", "temp_std_c"]

df = pd.read_csv(os.path.join(DATA, "soh_features_v2.csv"))
y = df["soh"]
tr, te = next(GroupShuffleSplit(n_splits=1, test_size=0.2, random_state=42)
              .split(df[NUM], y, df["cell_id"]))

oh = OneHotEncoder(handle_unknown="ignore", sparse_output=False)
oh.fit(df[["cell_id"]].iloc[tr])
id_cols = pd.DataFrame(oh.transform(df[["cell_id"]]),
                       columns=oh.get_feature_names_out(["cell_id"]))
Xa = pd.concat([df[NUM].reset_index(drop=True), id_cols], axis=1)
print(f"训练集类别数 = {df['cell_id'].iloc[tr].nunique()},"
      f"输出列数 = {id_cols.shape[1]}")
print(f"测试集在训练集里出现过的设备数 = "
      f"{len(set(df['cell_id'].iloc[te]) & set(df['cell_id'].iloc[tr]))}")
print(f"测试集独热矩阵非零元个数 = {int(oh.transform(df[['cell_id']].iloc[te]).sum())}")

m = LinearRegression().fit(Xa.iloc[tr], y.iloc[tr])
base = LinearRegression().fit(df[NUM].iloc[tr], y.iloc[tr])
print(f"按设备划分:加设备编号 {r2_score(y.iloc[te], m.predict(Xa.iloc[te])):.5f}   "
      f"不加 {r2_score(y.iloc[te], base.predict(df[NUM].iloc[te])):.5f}")

tr_r, te_r = train_test_split(np.arange(len(df)), test_size=0.2, random_state=42)
m2 = LinearRegression().fit(Xa.iloc[tr_r], y.iloc[tr_r])
b2 = LinearRegression().fit(df[NUM].iloc[tr_r], y.iloc[tr_r])
r_add = r2_score(y.iloc[te_r], m2.predict(Xa.iloc[te_r]))
r_base = r2_score(y.iloc[te_r], b2.predict(df[NUM].iloc[te_r]))
print(f"按行随机划分:加设备编号 {r_add:.5f}   不加 {r_base:.5f}   "
f"虚高 {r_add - r_base:+.5f}")期望输出:
训练集类别数 = 48,输出列数 = 48
测试集在训练集里出现过的设备数 = 0
测试集独热矩阵非零元个数 = 0
按设备划分:加设备编号 0.83116   不加 0.94253
按行随机划分:加设备编号 0.98308   不加 0.94442   虚高 +0.03866
④ 回答:因为"设备编号"的价值完全取决于"测试集的设备在训练集里出现过没有"。
按设备划分:测试集 12 支设备一支都没出现过
    → 48 列全是 0 → 这 48 列既不提供信息,还扰乱了数值列的系数
    → 0.83116 < 0.94253(比不加更差)

按行随机划分:同一支设备的其它行就在训练集里
    → 模型只要认出"这是第 7 支设备",就能直接吐这支设备的平均水平
    → 0.98308 > 0.94442(虚高 +0.03866)
★ 这条练习的三个延伸结论:
① 一个特征"有没有用"不是它的固有属性,而是【相对于某种划分方式】的性质;
② 与个体强相关的 ID 类特征,在按行随机划分下会制造虚高 ——
   这正是第 18 章要量化的【划分泄漏】;
③ 高基数 OneHot 的列数 = 类别数,且测试集稀疏率极高(本章 = 100%)——
   工程上要么换编码方式,要么干脆丢掉。
面向工程实践:编码是一件要写进文档的事
① 一份"类别列处理"的决策顺序
拿到一列非数值列
    ├─ 它和标签有关吗?            → 先看验证集/消融,不要看训练集(12.1)
    ├─ 取值有顺序吗?
    │     ├─ 有(小/中/大、档位)  → 可以用 OrdinalEncoder / Label
    │     └─ 没有(批次、工况、颜色)→ OneHot
    ├─ 有多少个取值?
    │     ├─ ≤ 十几类              → OneHot 直接用
    │     └─ 几十~几万类           → 目标编码 / 频次编码 / 哈希 / 丢掉(12.5)
    └─ 上线会遇到没见过的取值吗?   → 一定会 → handle_unknown="ignore" + 监控比例(12.6)
② 三件必须写进文档的事
① 每一列用了哪种编码(OneHot / Ordinal / 目标编码),以及它的类别表从哪来
   —— 类别表是【训练集】里学出来的,要跟着模型一起存(Pipeline 会替你做)
② 未知取值的处理策略(ignore / infrequent / 报错),以及上线后的监控指标
③ 每个类别列在消融实验里的 Δ(第 15 章)—— "没用"也要写,
   因为下一版有人会问"为什么不加"
③ 一个可复用的自检函数
def audit_categories(pre, X_train, X_new, cat_cols):
    """上线前跑一遍:类别表覆盖够不够、新数据里有没有没见过的取值。"""
    for name, trans, cols in pre.transformers_:
        if not hasattr(trans, "categories_"):
            continue
        for col, cats in zip(cols, trans.categories_):
            seen = set(cats)
            now = set(X_new[col].unique()) - seen
            print(f"{col:16s} 训练集 {len(seen):3d} 类   "
                  f"新数据里没见过的 {len(now):3d} 类   {sorted(now)[:5]}")
            if now:
                print(f"  ⚠️ 未知类别会被 handle_unknown 的策略处理,"
                      f"占比 {X_new[col].isin(now).mean():.1%} —— 超过 5% 就该考虑重训")
★ 这个函数对应的三个坑:
"训练集 N 类"          → 类别表是学出来的(要随模型存)
"新数据没见过几类"      → handle_unknown 的必要性(12.6)
"占比多少"            → 分布漂移的监控指标
★ 最后一句,也是通往下一章的桥:
到这里,数值列要缩放、类别列要独热 —— 两条路都得走。真实项目里这两条路是同时走的,而且还必须在交叉验证里"每条折内各走一遍"。把它们合成一个对象,是下一章的事。