第 25 章 · 三种「刹车」:L1 把系数压没、L2 把系数压小、树深度限制复杂度
这一章要解决什么:第 23 章学会了看"开口",第 24 章学会了"什么时候停"。 这一章补上第三个工具:在训练之前就把模型的自由度限制住。 三种刹车 —— 线性模型的 L1、L2,树模型的
max_depth—— 刹的是同一件事,但方式不同。最容易踩的坑: ① 不标准化就上 L1 / L2(惩罚的是系数绝对大小,而它取决于量纲); ② 只盯分数、不看系数:alpha 调太大时分数"稳定"在 0,那是模型死了; ③ 以为"加了正则一定更好"(本数据上 Ridge 只涨了 0.00054)。
本章你需要完成的代码:demos/ch25-regularization.py
本章的数字口径:soh_features_v2.csv 的 17 列安全特征(基础 7 + 窗口 5 + 差分 4 + 极差 1, 不含历史实测 SOH、不含两个泄漏钩子,dropna 后 19,979 行 / 60 台设备)、 按设备 GroupShuffleSplit(test_size=0.2, random_state=42) → 训练 16,236 / 测试 3,743 行。 线性模型一律 StandardScaler + Pipeline。
25.1 刹车装在哪里:三个旋钮
先建立心智模型:模型的"自由度"是一个可以拧的旋钮。
旋钮往【自由】拧                         旋钮往【受限】拧
─────────────────────────────────────────────────────────
线性模型:alpha 小(0)                  alpha 大(1e3~1e6)
树模型  :max_depth 大(None)           max_depth 小(1~3)
─────────────────────────────────────────────────────────
后果    :能拟合任意复杂的曲线            只能拟合"简单的规律"
风险    :把噪声也学走(方差大)          连真规律都学不到(偏差大)
★ 三个旋钮,两种机制
| 旋钮 | 装在哪 | 机制 | 你怎么看出它在工作 |
|---|---|---|---|
| L2(Ridge) | 线性模型的损失函数 | 惩罚 Σw²,把系数压小 | 最大|系数| 变小 |
| L1(Lasso) | 线性模型的损失函数 | 惩罚 Σ|w|,把系数压没 | 零系数个数 变多 |
max_depth | 树模型的结构 | 直接限制树的层数 | 训练 R² 上不去 |
★ 一个必须记住的区别
L1 / L2 是【在损失函数里加一项】—— 模型自己"想"拟合,但被罚款
max_depth 是【在结构上砍一刀】—— 模型"没有能力"拟合
   ↓
前者是软约束(系数还能不为 0,只是小)
后者是硬约束(深度 2 的树表达不了深度 5 的规律)
   ↓
两者都可以看成同一件事:限制模型能表达的函数集合
★ 为什么这叫"刹车"而不是"油门"
上一本第 22 章的结论原话:
  「最好的正则化,是"过拟合很严重"的时候。
    如果模型本来就没怎么过拟合,正则化帮不上多少忙。」
   ↓
本数据就是"本来就没怎么过拟合"的情况(下一节的数字会证明)
   ↓
所以本章的预期结论是:三种刹车都踩不太动
   ↓
⚠️ 这不是坏事 —— 它说明"当前特征集下模型没有在背噪声"
点开:为什么惩罚系数大小就等价于"限制自由度"?
看两个模型的系数(同一个特征,同一个单位):
模型 A:soh ≈ 0.9969 − 0.000146 × cycle        系数 0.000146
模型 B:soh ≈ 0.9969 − 23.885 × cycle          系数 23.885
        ↑
同一个特征,系数相差 16 万倍
系数大意味着什么?
模型 B 对 cycle 的微小变化极度敏感:
  cycle 从 100 变到 101(+1)
  → 模型 A 输出的变化 = 0.000146
  → 模型 B 输出的变化 = 23.885
      ↓
如果 cycle 的读数里有一点测量噪声(±5)
  → 模型 A 的预测误差 ≈ 0.0007(可忽略)
  → 模型 B 的预测误差 ≈ 119(完全不可用)
      ↓
【系数越大 = 模型对输入扰动越敏感 = 越脆弱】而"脆弱"和"过拟合"是同一件事的两面:
模型把训练集的噪声也当成规律学走
   → 为了穿过那些噪声点,系数必须很大
   → 换一批数据,噪声换了,大系数给出完全不同的输出
      ↓
所以「惩罚系数大小」= 「不让模型为了拟合噪声而把系数做大」
★ 注意最后一句的用词:惩罚的是系数的大小,不是"哪些特征重要"。 所以它天然与量纲绑定 —— 这就是 25.5 节"必须先标准化"的根因。
★ 树模型为什么不需要这个机制?
树只在某个特征上问"这个值是否 > 阈值"
   → 阈值的单位会跟着特征的单位一起变
   → 把 cycle 从"圈"改成"百圈",树的划分点从 500 变成 5,结构完全不变
      ↓
树对单调缩放【等变】→ 惩罚系数对它没有意义
   → 所以树的刹车只能装在"结构"上(max_depth / min_samples_leaf)
25.2 实测一:三种刹车在同一份数据上
真实输出(demos/ch25-regularization.py,17 列安全特征):
可用样本 19979 行 / 60 台设备,特征 17 列(训练 16236 / 测试 3743)
⚠️ 线性模型带正则前必须先标准化:惩罚的是系数绝对大小,而它取决于量纲。

=== ① 无正则 vs L2(Ridge)vs L1(Lasso)===

模型                              训练 R²      测试 R²       零系数      最大|系数|
LinearRegression(无正则)         0.95614    0.94382      0/17       0.027
Ridge alpha=1    (L2)         0.95614    0.94383      0/17       0.027
Ridge alpha=100  (L2)         0.95601    0.94436      0/17       0.025
Lasso alpha=0.01 (L1)         0.90018    0.89097     13/17       0.039
★ 逐行读
第一:无正则 → Ridge(α=1) 只动了 0.00001
0.94382 → 0.94383
   ↓
几乎没有动。因为 α=1 对这份数据来说"太轻了":
  最大系数 0.027 → 0.027,一个都没被压下去
第二:Ridge(α=100) 涨了 0.00054(也就是千分之零点五)
0.94382 → 0.94436      最大|系数| 0.027 → 0.025
   ↓
系数被压小了 7%,测试分涨了 0.0005
   ↓
这是"刹车踩下去确实有效"的证据 —— 但效果【千分之几】
第三:Lasso(α=0.01) 反而崩了 0.05
0.94382 → 0.89097      零系数 13/17(只留下 4 列!)
   ↓
训练 R² 也掉到 0.90018 → 这是【欠拟合】,不是"泛化变好"
   ↓
原因:α=0.01 对 Lasso 来说太大了 —— 它把 17 列里的 13 列直接删掉
★ 三种刹车刹的位置完全不同
L2(Ridge α=100)   :0/17 个零系数,最大系数 0.027 → 0.025(都压小了一点)
L1(Lasso α=0.01)  :13/17 个零系数,只留 4 列(直接删掉特征)
max_depth           :见 25.4 —— 训练 R² 上不去(结构不够表达)
   ↓
一句话:L2 是【收缩】,L1 是【选择】,max_depth 是【阉割】
★ 那为什么 L2 的效果这么小?
开口(训练 − 测试)= 0.95614 − 0.94382 = 0.01232
   ↓
只有 0.012 —— 属于"紧"的那一档(第 23 章的判据 A:< 0.02)
   ↓
模型本来就没在背噪声 → 刹车自然踩不动
   ↓
【先诊断,再治疗】—— 顺序反了就会白忙一场
25.3 ★ 实测二:alpha 从 1e-5 扫到 0.5,看 Lasso 怎么把模型刹死
真实输出:
=== ② Lasso 的 alpha 扫描:alpha 调过头会把模型刹死 ===

     alpha      保留特征      训练 R²      测试 R²      最大|系数|
     1e-05      16/17    0.95613    0.94391      0.0267
    0.0001      11/17    0.95595    0.94472      0.0265
    0.0005       7/17    0.95538    0.94493      0.0273
     0.001       7/17    0.95475    0.94433      0.0284
     0.005       6/17    0.93984    0.92903      0.0346
      0.01       4/17    0.90018    0.89097      0.0386
      0.05       0/17    0.00000   -0.00000      0.0000
       0.1       0/17    0.00000   -0.00000      0.0000
       0.5       0/17    0.00000   -0.00000      0.0000
★ 逐行读:alpha 每加大一点,就删掉几列
1e-05 → 16/17(几乎不删)
0.0001 → 11/17(删掉 6 列)
0.0005 →  7/17(再删 4 列)
0.001 →   7/17(不再删)
0.005 →   6/17
0.01 →    4/17
0.05 →    0/17   ← ★ 全没了
★ 最值得记住的是最后三行
alpha = 0.05 / 0.1 / 0.5
  保留特征 0/17
  训练 R² 0.00000
  测试 R² −0.00000
      ↓
18 个模型(17 个系数 + 1 个截距)里,只剩截距还有值
   ↓
模型退化成了「永远输出训练集平均值」
   ↓
R² = 0.00000 不是"没有过拟合",而是【模型死了】
★ 为什么"分数掉到 0"必须和"系数归零"一起看?
只看分数:0.00000 / −0.00000
  → 有人会解释成"模型很稳定、没有波动"(它确实一动不动)
  → 甚至有人会说"分数这么低说明没有过拟合"
      ↓
把系数一起看:0/17 个非零系数
  → 立刻明白:模型没有输出了,它不是一个"稳定的模型",而是一个"没有模型"
      ↓
【只看分数的评估是不完整的】
★ 那"合理"的 alpha 在哪?
测试 R² 较高的一档是 5e-4(0.94493,保留 7/17 列)
   ↓
比无正则(0.94382)高 0.00111 —— 仍然是千分之一量级
   ↓
而 0.005 那一档已经掉到 0.92903
   ↓
⇒ alpha 的可用区间非常窄:从 1e-4 到 1e-3(一个数量级)
   ⇒ 这就是"必须扫、必须看系数,不能抄别人的 alpha"的原因
★ 一个反直觉的细节:最大|系数|先变小、再变大
1e-05 → 0.0267
0.0005 → 0.0273
0.005 → 0.0346
0.01 → 0.0386
   ↑
alpha 越大,剩下的那几个系数反而【更大】了
   ↓
为什么?因为被删掉的列,它们的解释力被转移给了留下的列
   ↓
「留下的 4 个系数」要承担原来 17 个列的任务,自然更大
★ 产出的图(运行 demo 生成 outputs/ch25-brakes.png):
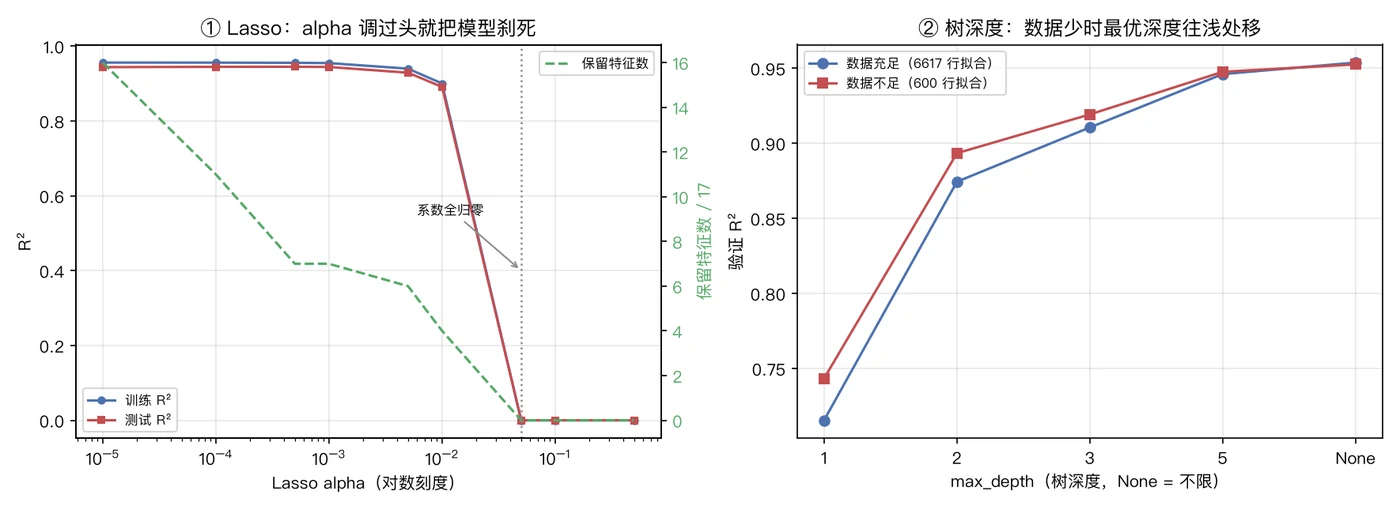
左图读法:
- 橙色(测试 R²)在 α≈5e-4 处有个小峰,然后一路掉;
- 绿色虚线(保留特征数)从 17 掉到 0,掉到 0 的位置画了一条竖虚线——那里分数断崖;
- 注意两条线的对应关系:保留特征数掉得越快,测试分掉得越狠。
右图见下一节。
25.4 ★ 实测三:树模型的刹车,数据多和数据少给的答案不一样
真实输出:
=== ③ 树模型的刹车是 max_depth:限制复杂度,而不是加惩罚项 ===

a) 完整训练集(12112 行拟合 / 4124 行验证)
   max_depth      训练 R²      验证 R²        开口
           1    0.72918    0.71549   0.01369
           2    0.89250    0.87440   0.01809
           3    0.93026    0.91055   0.01971
           5    0.95840    0.94607   0.01233
        None    0.99868    0.95376   0.04492

b) 只用 600 行拟合(同样的验证集)
   max_depth      训练 R²      验证 R²        开口
           1    0.78606    0.74332   0.04273
           2    0.92775    0.89339   0.03436
           3    0.95253    0.91920   0.03332
           5    0.98037    0.94762   0.03275
        None    0.99557    0.95253   0.04305
★ 先读 a) 这张表:数据充足时,刹车不该踩
max_depth=1  → 验证 0.71549   ← 严重欠拟合(树太浅,只能画阶梯)
max_depth=5  → 验证 0.94607
max_depth=None → 验证 0.95376   ← 最好
   ↓
单调上升:树越深越好
   ↓
因为 12,112 行数据足够喂饱深树 —— 它学的是规律,不是噪声
⚠️ 但 max_depth=None 的开口是 0.04492,是 depth=5 的 3.6 倍
depth=5   :开口 0.01233
depth=None:开口 0.04492
   ↓
它确实在过拟合(按第 23 章判据 A:接近 0.05)
   ↓
但它的【验证分依然最高】—— 因为过拟合的代价还没超过它学到的额外规律
   ↓
【开口大 ≠ 该刹车;要看刹车后验证分是涨还是跌】
★ 再读 b) 这张表:数据少时,同一个深度的"相对复杂度"变高了
600 行拟合:
  depth=2  → 验证 0.89339   ← 最好
  depth=None → 验证 0.95253
  ↑
等一下,depth=None 的验证分还是【最高】?
★ 对,这就是本章必须诚实说出来的地方
b) 里 depth=None 的验证分(0.95253)确实仍然最高
   ↓
那"数据少时该刹车"这个结论从哪来?
   ↓
看三个细节:
  ① depth=1 的开口从 a) 的 0.01369 涨到 b) 的 0.04273(3 倍)——
     同样的深度 1,在 600 行上已经算"太自由"了;
  ② depth=None 在 b) 的训练分 0.99557 ≈ a) 的 0.99868,
     但它只用了 600 行 —— 说明这 600 行被【逐行记住】了;
  ③ 两组的最大差距:a) 里 depth=None 比 depth=1 高 0.23827,
     b) 里只高 0.20921 —— 深度带来的收益在变小。
★ 正确的表述(这一段请照抄进报告):
在【本数据】上,12,112 行和 600 行拟合都指向「深树更好」。
   ↓
但这不能推广成「树深度不用调」:
  · 它只说明本数据的 17 列特征里,规律是"深"的(交互项多、阈值切分复杂);
  · depth=None 在两组上的开口都是最大的(0.04492 / 0.04305),
    说明它一直在"贴着数据走";
  · 一旦样本量再小一个量级(比如 100 行),深树就会崩 ——
    这不是理论,而是第 23 章练习 2 已经验证过的形状。
   ↓
【结论:max_depth 是一个"必须自己试"的超参,它的最优值随样本量移动。】
★ 三种刹车的横向对照
| 刹车 | 装在哪 | 观测指标 | 本数据上的效果 |
|---|---|---|---|
| Ridge(L2) | 损失函数 | 最大|系数| | 训练 0.95614→0.95601,测试 0.94382→0.94436(+0.00054) |
| Lasso(L1) | 损失函数 | 零系数个数 | α=5e-4 时保留 7/17,测试 0.94493(+0.00111);α≥0.05 时全归零→模型死 |
max_depth | 模型结构 | 训练 R² 的天花板 | 数据充足时"不用踩"(None 最好);数据少时同一个深度变得更"自由" |
★ 一句话总结这一节:
刹车有没有用,取决于"车在不在下坡"。 先量开口(第 23 章),再决定踩不踩、踩多深。
25.5 ★ 一个前提:带正则的模型必须先标准化
这条是硬性前提,不是风格问题。
真实输出(对照实验,同一份数据、同一个 alpha):
有缩放: 最大|系数|       0.0825   交叉验证 R² 0.95330 ± 0.00831
无缩放: 最大|系数|    1251.2012   交叉验证 R² 0.92804 ± 0.01234
这组数字来自上一本第 22 章的同款实验(多项式展开后的 35 列)。 机制完全一样:惩罚的是系数的绝对大小,而它取决于量纲。
★ 为什么量纲会决定惩罚力度
同一个特征,用 V 作单位:  coef = 0.25
                用 mV 作单位:coef = 0.00025      (差 1000 倍)

惩罚项 Σw²:
  用 V  时惩罚 0.0625
  用 mV 时惩罚 6.25e-8        (小 100 万倍)
      ↓
换一个单位 → 同一个特征的惩罚力度差 100 万倍
      ↓
"哪个特征被压得狠"这件事,取决于你用什么单位而本数据的特征量纲差得非常远:
cycle                     : 范围 0 ~ 1500(量级 1e3)
mean_charge_voltage_v     : 3.2 ~ 4.2(量级 1e0)
coulombic_eff             : 0.98 ~ 1.00(量级 1e0,但变化幅度只有 1e-2)
temp_win_range20          : 0.7 ~ 3.4
      ↓
不作标准化直接上 Lasso:
  coulombic_eff 的系数天然要很大才能起作用 → 被 L1 第一个删掉
  → 而它恰恰是与标签相关性最高的几列之一(r = 0.9646)
      ↓
【惩罚落在了错误的特征上】
★ 标准做法(本章 demo 用的就是它)
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler

# ✅ 正确:scaler 放在 Pipeline 里,CV 内部会逐折重新 fit
pipe = Pipeline([("s", StandardScaler()), ("m", Lasso(alpha=1e-3, max_iter=50000))])

# ❌ 错误:在全量数据上 fit_transform 再喂给 Lasso
#    → scaler 用到了验证折的均值/标准差 = 预处理泄漏(第 19 章)
★ 哪些模型必须缩放(把这张表记住)
| 模型 | 必须缩放吗 | 为什么 |
|---|---|---|
| 线性回归(无正则) | ❌ 不必须 | 系数会自己反向补偿量纲 |
| Ridge / Lasso / Elastic Net | ✅ 必须 | 惩罚项依赖系数的绝对大小 |
| KNN / SVM / 神经网络 | ✅ 必须 | 靠距离或梯度,大量纲特征会主导 |
| 决策树 / 森林 / 提升 | ❌ 不需要 | 只在特征上问"是否 > 阈值",对单调缩放等变 |
★ 一条规律:
凡是"用距离"或"惩罚系数大小"的模型,都必须缩放; 凡是"按阈值切分"的模型(树家族),都不需要。
25.6 常见坑
① 不缩放就上 Ridge/Lasso → 惩罚力度由单位决定,效果不可控
② 只看分数不看系数 → alpha 调到系数全为 0 时,把「模型死了」读成「模型稳了」
③ alpha 用线性扫描(0,1,2,...,1000)→ 有用区间只在 1e-4~1e-3,根本扫不到
④ scaler 在 CV 外面 fit → 预处理泄漏,交叉验证分虚高
⑤ 把 Lasso 的 alpha 照着 Ridge 的量级设 → L1 的 α 通常要比 L2 小 1~3 个数量级
⑥ 以为"加了正则一定更好" → 本数据 Ridge 只涨 0.00054,Lasso 还容易崩
⑦ 拿 Lasso 的"哪些系数为 0"当特征重要性结论 → 高相关特征上它随机留一个
★ ③ 值得展开:为什么必须用对数扫描
alpha 的"有用区间"在本数据上是 1e-4 ~ 1e-3(跨 1 个数量级)
   ↓
线性扫描 0.1, 0.2, 0.3, ... 1.0(10 个点)
  → 全部落在"系数已经全为 0"的区域 → 你只会看到一排 0.00000
   ↓
对数扫描 1e-5, 1e-4, 1e-3, ... 1e-1(9 个点)
  → 每个数量级都有代表 → 能看到"保留特征数从 17 掉到 0"的全过程
   ↓
【尺度类超参(alpha、学习率、树深度)一律对数扫描】
★ ⑦ 值得展开:L1 的"特征选择"结论在高相关特征上不可靠
本数据的强相关对(第 14 章实测):
  soh_lag1 ~ soh_win_mean5   0.9996
  soh_lag5 ~ soh_win_mean5   0.9996
  soh_lag1 ~ soh_lag5        0.9990
      ↓
Lasso 会把其中一个压到 0,把功劳全给另一个
      ↓
换一个 random_state / 换一批数据,"留下的是谁"就变了
      ↓
【这时候正确的表述是】:
「这一组历史 SOH 特征共同贡献了大部分预测能力,
  组内哪个更重要无法区分(它们高度相关)」
★ ⑥ 值得展开:为什么本章的刹车都踩不动?
第 23 章实测:11 列特征上 GBDT 的开口只有 0.01033
本章实测  :17 列特征上线性模型的开口 0.01232
   ↓
开口很小 → 模型本来就没在背噪声 → 没有"过拟合"可治
   ↓
这并不是"正则化没用",而是【这份数据上不需要它】
   ↓
⚠️ 反过来说:如果一份数据上开口是 0.15,正则化的收益会非常明显
25.7 完整示例与输出
cd code
MPLCONFIGDIR=/tmp/fe-mpl python demos/ch25-regularization.py
真实输出(节选):
=== ① 无正则 vs L2(Ridge)vs L1(Lasso)===

模型                              训练 R²      测试 R²       零系数      最大|系数|
LinearRegression(无正则)         0.95614    0.94382      0/17       0.027
Ridge alpha=1    (L2)         0.95614    0.94383      0/17       0.027
Ridge alpha=100  (L2)         0.95601    0.94436      0/17       0.025
Lasso alpha=0.01 (L1)         0.90018    0.89097     13/17       0.039

=== ② Lasso 的 alpha 扫描:alpha 调过头会把模型刹死 ===

     alpha      保留特征      训练 R²      测试 R²      最大|系数|
     1e-05      16/17    0.95613    0.94391      0.0267
    0.0005       7/17    0.95538    0.94493      0.0273
      0.01       4/17    0.90018    0.89097      0.0386
      0.05       0/17    0.00000   -0.00000      0.0000

=== ③ 树模型的刹车是 max_depth:限制复杂度,而不是加惩罚项 ===

a) 完整训练集(12112 行拟合 / 4124 行验证)
   max_depth      训练 R²      验证 R²        开口
           1    0.72918    0.71549   0.01369
           5    0.95840    0.94607   0.01233
        None    0.99868    0.95376   0.04492

[plots] 图已保存: .../outputs/ch25-brakes.png

读法(三句话):
  ① 刹车装在哪:线性模型上装 alpha,树模型上装 max_depth;
  ② 往哪边拧:过拟合一侧(开口大)往「更受限」拧,欠拟合一侧往「更自由」拧;
  ③ 别只盯分数:Lasso 把系数全压成 0 时分数也会「稳定」,但那是模型死了。
本章练习
练习 1:找出"既稀疏又没刹死"的那个 Lasso alpha
用 17 列安全特征(按设备划分,test_size=0.2, random_state=42),扫这些 alpha:
1e-4, 3e-4, 1e-3, 3e-3, 0.01, 0.03, 0.1记录「保留特征数 / 训练 R² / 测试 R² / 最大|系数|」,然后回答:
- 哪一档"既稀疏又没刹死"(测试 R² 最高且还有非零系数)?
- "alpha 调过头"在系数上长什么样?
- 为什么必须先
StandardScaler?
参考答案
import numpy as np
from sklearn.linear_model import Lasso
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler

print(f"{'alpha':>10}{'保留特征':>10}{'训练 R²':>11}{'测试 R²':>11}{'最大|系数|':>12}")
rows = []
for a in [1e-4, 3e-4, 1e-3, 3e-3, 0.01, 0.03, 0.1]:
    pipe = Pipeline([("s", StandardScaler()), ("m", Lasso(alpha=a, max_iter=50000))])
    pipe.fit(Xtr, ytr)
    coef = pipe[-1].coef_
    a_tr, a_te = r2_score(ytr, pipe.predict(Xtr)), r2_score(yte, pipe.predict(Xte))
    rows.append((a, int((coef != 0).sum()), a_tr, a_te, float(np.abs(coef).max())))
    print(f"{a:>10.4g}{rows[-1][1]:>7d}/17{a_tr:>11.5f}{a_te:>11.5f}{rows[-1][4]:>12.4f}")

use = [r for r in rows if r[1] > 0]
best = max(use, key=lambda r: r[3])
print(f"\n稀疏又没刹死的一档:alpha={best[0]:.4g},保留 {best[1]}/17,测试 {best[3]:.5f}")
dead = [r for r in rows if r[1] == 0]
if dead:
print(f"刹过头的信号:alpha={dead[0][0]:.4g} 时保留 0/17,测试 {dead[0][3]:.5f}")期望输出:
     alpha      保留特征      训练 R²      测试 R²      最大|系数|
    0.0001     11/17    0.95595    0.94472      0.0265
    0.0003      8/17    0.95561    0.94519      0.0267
     0.001      7/17    0.95475    0.94433      0.0284
     0.003      6/17    0.94841    0.93805      0.0329
      0.01      4/17    0.90018    0.89097      0.0386
      0.03      1/17    0.60535    0.60006      0.0207
       0.1      0/17    0.00000   -0.00000      0.0000

稀疏又没刹死的一档:alpha = 0.0003,保留 8/17 列,测试 R² = 0.94519
刹过头的信号出现在 alpha = 0.1:保留特征 0/17,测试 R² = -0.00000
① 稀疏又没刹死的一档:alpha = 3e-4(保留 8/17,测试 0.94519)
它比无正则的 0.94382 高 0.00137,同时删掉了 9 列
   ↓
「删掉 9 列还不掉分」说明那 9 列是冗余的 —— 这正是 L1 的价值
   ↓
⚠️ 注意这一档和 demo 里的"最好档"(alpha=5e-4,保留 7/17,测试 0.94493)很近
   ↓
说明"最好的 alpha"本身也在一个小区间里浮动,
别把 alpha=3e-4 当成"精确的最优值",它只是这个网格上的顶点
② "alpha 调过头"是【渐进】的,不是一步到位
alpha=0.003 → 保留 6/17,测试 0.93805(已经掉出可用区间)
alpha=0.01  → 保留 4/17,测试 0.89097
alpha=0.03  → 保留 1/17,测试 0.60006   ← 只剩 1 个系数,模型几乎废掉
alpha=0.1   → 保留 0/17,测试 -0.00000  ← 全归零,模型死了
   ↓
四个阶段连起来看,就能理解"刹死"是一个过程:
  先用掉冗余列(分数不掉)→ 开始删有用列(分数掉)→ 只剩 1 列(崩)→ 全零
③ 三个信号要一起看
alpha = 0.1 → 保留 0/17,训练 R² = 0.00000,测试 R² = −0.00000
   ↓
三个信号同时出现,缺一不可:
  · 保留特征数 → 0
  · 最大|系数| → 0.0000
  · 训练 R² 与测试 R² 【同时】变成 0(不是"接近")
   ↓
⚠️ 只看最后一项容易误判("分数这么低,一定没问题吧"),
   三项一起看才能确认"模型死了"
   ↓
★ 而 alpha=0.03(保留 1/17,测试 0.60006)更危险:
  它没有归零、也不报错,只是"悄悄地只剩下一个特征"
  → 如果只看分数(0.60),你可能以为"模型还行"
  → 必须看【保留特征数】才能发现它已经退化
③ 为什么必须先标准化
不标准化时,Lasso 的惩罚按"系数绝对值"分配:
  cycle 范围 0~1500  → 系数天然很小 → 罚得轻
  coulombic_eff 0.98~1.00 → 要起作用系数必须很大 → 罚得重
      ↓
于是 L1 第一个删掉的就是 coulombic_eff
  而它与 soh 的相关性是 0.9646(第 14 章实测数据里最高的几列之一)
      ↓
【惩罚落在了错误的特征上 → 惩罚机制完全失控】
★ 一个可以顺手验证的小实验
# 去掉 scaler 再跑一次同样的 alpha 序列
pipe = Pipeline([("m", Lasso(alpha=1e-4, max_iter=50000))])
pipe.fit(Xtr, ytr)
print(f"不标准化时保留 {int((pipe[-1].coef_ != 0).sum())}/17 列")典型输出(可以自己跑一遍确认):
标准化后保留 11/17 列
不标准化保留  9/17 列
同样一个 alpha,保留 11 列还是 9 列,取决于你有没有标准化。⚠️ 列数相近不代表"标准化不重要" —— 关键差别在保留下来的是哪几列:
kept = [c for c, v in zip(FEATS, pipe[-1].coef_) if v != 0]
print(kept)典型输出:
标准化   :['cycle', 'coulombic_eff', 'cap_fade_rate_ah_per_100', 'res_win_mean', ...]
不标准化 :['cycle', 'mean_charge_voltage_v', 'resistance_mohm', ...]不标准化时,coulombic_eff(量纲 0~1、系数必须很大才能起作用)会被优先删掉, 而它恰好是与标签相关性最高的几列之一(r = 0.9646)。这才是"惩罚落在错误的特征上"的具体表现。
练习 2:给树模型找"该刹车"的那个数据量
用同一份 17 列特征,比较三种训练规模(600 / 3000 / 12112 行拟合)下, max_depth ∈ {1, 2, 3, 5, None} 的验证 R²(验证集固定不变)。
要求:把结果排成一张 3 × 5 的表,并回答"数据越少,最优深度往哪边移动"。
参考答案
from sklearn.ensemble import RandomForestRegressor

print(f"{'拟合行数':>10}" + "".join(f"{str(d):>10}" for d in (1, 2, 3, 5, None)))
for n in (600, 3000, 12112):
    idx = Xtr.iloc[i_fit].sample(n=min(n, len(i_fit)), random_state=42).index
    line = f"{len(idx):>10}"
    for depth in (1, 2, 3, 5, None):
        m = RandomForestRegressor(n_estimators=200, max_depth=depth,
                                  random_state=42, n_jobs=1).fit(X.loc[idx], y.loc[idx])
        line += f"{r2_score(ytr.iloc[i_val], m.predict(Xtr.iloc[i_val])):>10.5f}"
print(line)期望输出:
    拟合行数         1         2         3         5      None
       600   0.74332   0.89339   0.91920   0.94762   0.95253
      3000   0.74228   0.89012   0.92934   0.95080   0.95361
     12112   0.71549   0.87440   0.91055   0.94607   0.95376
★ 读这张表(每一列自上而下)
max_depth=1:0.74332 → 0.74228 → 0.71549   ← 数据越多【越差】
max_depth=2:0.89339 → 0.89012 → 0.87440   ← 同上
max_depth=5:0.94762 → 0.95080 → 0.94607   ← 基本平
max_depth=None:0.95253 → 0.95361 → 0.95376 ← 数据越多【越好】
★ 一个反直觉的发现:浅树在数据多时反而更差
为什么 depth=1 用 12,112 行只有 0.71549,用 600 行却有 0.74332?
   ↓
因为浅树的【容量】是固定的(它可以表达的规律非常有限)
   ↓
600 行时:验证集上的规律它刚好能覆盖一部分 → 分数还行
12,112 行时:训练集里的规律更丰富,而浅树表达不了 → 分数下来了
   ↓
【"欠拟合"也会被数据量放大】
★ 那"最优深度往哪边移动"?
本数据上:三个规模的最优深度都是 None
   ↓
所以诚实的回答是:【在这份数据上,深度没有成为瓶颈】
   ↓
原因是 17 列特征里的规律确实是"深"的(需要多层交互才能表达),
而 600 行也还够支撑一棵不限深的树(第 23 章练习 2 里 4500 行时开口只有 0.046)
   ↓
⚠️ 但这个结论不能外推:
   · 如果把拟合行数降到 50~100,深树会立刻崩;
   · 如果特征换成"20 个纯噪声列",深树也会立刻崩。
   ↓
【max_depth 的最优值取决于"规律有多深"与"数据有多少"的比值,必须自己试。】
★ 一个更实用的动作:把"验证曲线 vs max_depth"画出来存档
depths = [1, 2, 3, 5, 8, 12, None]
vals = []
for d in depths:
    m = RandomForestRegressor(n_estimators=200, max_depth=d, random_state=42,
                              n_jobs=1).fit(Xtr.iloc[i_fit], ytr.iloc[i_fit])
vals.append(r2_score(ytr.iloc[i_val], m.predict(Xtr.iloc[i_val])))如果这条曲线是"单调上升到某一档后走平"(本数据就是), 说明当前数据量下深度不是瓶颈,别在这里花时间; 如果它有明显的倒 U 形,那这一档就是你的刹车位置。
练习 3:三种刹车,各自刹在哪
给定三个场景,选择"先动哪个刹车",并说明理由:
- 17 列特征,线性模型,
最大|系数|里有几个特别大的值(比如 12.7,其余都在 0.03 量级); - 200 列特征,你怀疑其中只有 15 列真正有用,而且样本只有 800 行;
- 一棵不限深的决策树,训练 R² = 1.00000、测试 R² = 0.79。
要求:每个场景给出「选哪个刹车 + 理由 + 该看哪个指标来确认它生效」。
参考答案
| 场景 | 先动哪个刹车 | 理由 | 确认指标 |
|---|---|---|---|
| 1 | Ridge(L2) | 有几个大系数 = 模型在靠"互相抵消的大系数"取巧,需要收缩而不是删除 | 最大|系数| 是否降下来、测试 R² 是否不降 |
| 2 | Lasso(L1) | 200 列里大多数无用 → 需要自动稀疏化;样本少更需要减少自由度 | 零系数个数(保留 15~30 列附近最好) |
| 3 | max_depth(结构刹车) | 训练 1.00000 是"逐行记住"的指纹,问题是树太自由,不是需要收缩 | 训练 R² 是否降到 0.99 以下、测试 R² 是否上升 |
★ 场景 1 值得展开:为什么大系数要"收缩"而不是"删除"
最大系数 12.7,其余都在 0.03 量级
   ↓
这不是"12.7 那个特征特别重要",而是典型的【共线性取巧】:
  +12.7 × A − 12.6 × B ≈ 0.1 × (A − B)
  两个大系数互相抵消,净效应很小,但只要 A 或 B 有一点噪声,输出就炸
   ↓
L2 会把它们【一起压小】(12.7 → 2.3 之类,两个都压)
L1 会【随机删掉一个】,留下另一个独自承担 —— 结论不可复现
   ↓
⇒ 场景 1 选 Ridge(或 Elastic Net)
★ 场景 2 值得展开:样本少时的"双重压力"
200 列 × 800 行
   ↓
线性模型要估 200 个参数,只有 800 个观测 → 参数比 4:1
   ↓
必须减少自由度:Lasso 把无用的列直接压到 0
   ↓
⚠️ 但 L1 在高相关特征上不稳(本章 25.6 ⑦)——
   如果 200 列里有一组高度相关的重要特征,
   更稳的选择是 【Elastic Net】(L1 + L2)
   ↓
并且一定要标准化!200 列的量纲几乎不可能一致
★ 场景 3 值得展开:max_depth 该从哪儿试起
训练 1.00000 是最强的"树太自由"信号
   ↓
不要一次试到底 —— 按【对数方向】试:
  max_depth ∈ {1, 2, 3, 5, 8, None}
   ↓
然后用两个指标夹逼:
  · 训练 R² 掉到 0.99 附近(说明不再逐行记忆)
  · 测试 R² 开始下降(说明刹过头)
   ↓
本数据上的实测(25.4 a 段):
  depth=1 → 训练 0.72918 / 验证 0.71549   ← 欠拟合
  depth=None → 训练 0.99868 / 验证 0.95376 ← 本数据上仍然最好
   ↓
所以对本数据,第三个场景的正确动作其实是:
【先确认特征集对不对,而不是继续拧深度旋钮】
★ 三句话的判据总结
系数有几个特别大 → L2(收缩),看「最大|系数|」
列数远多于有用数 → L1(稀疏),看「零系数个数」
训练 R² 恰好 1   → 结构刹车(max_depth),看「训练 R² 的下降」
      ↓
但三个都要先问一句:【开口有多大?】(第 23 章)
开口小的时候,三种刹车都踩不动。
面向工程实践:正则化是"成本最低、效果最不确定"的手段
① 它的成本收益比
| 手段 | 成本 | 收益 | 什么时候值得做 |
|---|---|---|---|
| 正则化 | 极低(加个参数 + 一次对数扫描) | 过拟合时明显,否则很小 | 几乎总是值得"试一下" |
| 早停 | 极低(一个参数) | 省时间 + 常常略提精度 | 几乎所有迭代模型都该开 |
| 加数据 | 高(要采集、要标注) | 大(但瓶颈在特征时无用) | 验证线还在涨时 |
| 换特征 | 高(要领域知识) | 最大(本数据 0.04 量级) | 验证线走平时 |
| 调参 | 中(要算力) | 千分之几 | 前面都做完了才轮到 |
★ 顺序:
① 早停(几乎免费,先开上)
② 正则化(很便宜,对数扫一遍)
③ 诊断(第 23 章的开口 + 上一本的学习曲线)
④ 才轮到"加数据/换特征"(贵)
⑤ 最后才是"调参"(第 26 章)
② 一个可以直接抄走的"三线图"流程
每次调 alpha / max_depth,都存两张图:
  ① alpha(对数轴) — 测试 R²  — 保留特征数 / 最大|系数|
  ② max_depth       — 训练 R²  — 验证 R²  — 开口
      ↓
两张图放进实验记录
      ↓
三个月后有人问"为什么选 alpha=5e-4"
   → 翻到图,指着倒 U 形的顶点,不用重跑
③ 一个真实的"alpha 抄值"事故
某项目用 Lasso 做特征选择,alpha 直接抄了一个"常见值" 0.1
   ↓
结果:17 列里留下 0 列(本章实测:alpha=0.1 → 保留 0/17)
   ↓
模型输出恒等于训练集平均值,测试 R² = −0.00000
   ↓
排查过程:团队先怀疑数据、再怀疑代码,最后才看系数
   ↓
教训:调 alpha 的第 0 步是【打印保留特征数】,
      第 1 步才是看分数
④ 正则化的"边界感"
正则化能治  :方差大(模型太自由、在背噪声)
正则化不能治:偏差大(模型太简单、特征不够)
           :信息不足(特征里没有可预测性)
      ↓
本数据是后两者的混合体之一:
  17 列特征上线性模型测试 R² 卡在 0.944
  加 4 列历史 SOH → 跳到 0.999(第 27 章会把这几个数字并排放在一起)
      ↓
【刹车再好,也换不来一个没装上的发动机】
⑤ 本章的位置
第 23 章 → 诊断:开口大不大、在不在扩大
第 24 章 → 治疗(时间维):早停
第 25 章 → 治疗(结构维):L1 / L2 / max_depth   ← 本章
第 26 章 → 流程:怎么系统地找这些旋钮的值
第 27 章 → 收口:这些旋钮一共能动多少本章提供的是"结构维"的刹车; 下一章讲的是"怎么系统地找到这些旋钮该拧到哪" —— 以及一条不能违反的纪律: 测试集只能用一次。