第 30 章 · ❖ 阶段目标:精度优化报告
本章没有新概念 —— 它把前面 29 章拼成一个可交付的东西: 一条命令 → 一份报告 + 一张表 + 一张图。
本章唯一要学的是"工程组织": 怎么让"图、数字、结论"永远一致,以及报告必须带局限。
本章你需要完成的代码:demos/ch30-stage-target.py
30.1 先看成品
cd code
python demos/ch30-stage-target.py真实输出:
表:soh_features_v2.csv  21,239 行;可用样本 19,979 行 / 60 支设备
划分:按设备 GroupShuffleSplit(test_size=0.2, random_state=42) → 训练 16,236 / 测试 3,743 行
训练/测试设备交集:0

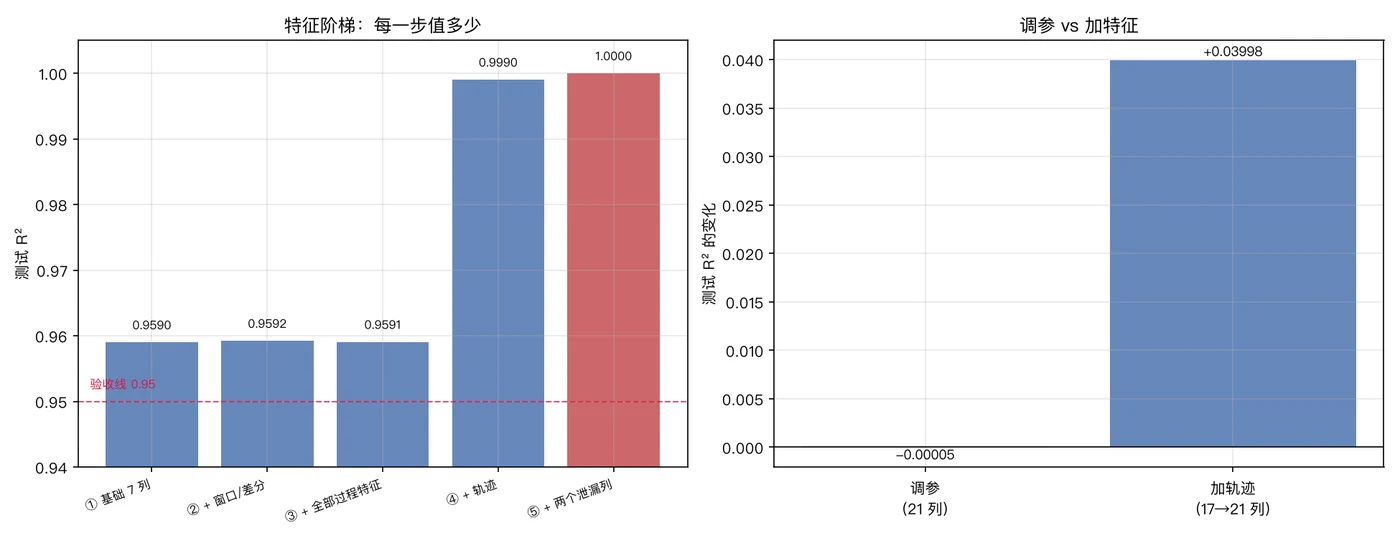
[1/5] 特征阶梯:每加一组,值多少?
  配置                           特征      训练R²      测试R²         Δ
  ① 基础 7 列(横截面)                 7   0.99807   0.95900         —
  ② + 窗口/差分(12 列)              12   0.99841   0.95922  +0.00022
  ③ + 全部过程特征(17 列)             17   0.99859   0.95906  -0.00016
  ④ + 轨迹(21 列)★                21   0.99987   0.99904  +0.03998
⑤ + 两个泄漏列(23 列)❌ 23 1.00000 1.00000 +0.00096五个产物:
| 文件 | 内容 |
|---|---|
ch30-report.md | 精度优化报告(七节,可直接交付) |
ch30-metrics.csv | 全部指标(可被别的脚本消费) |
ch30-ladder.png | 特征阶梯 + 调参对照 |
★ 这张阶梯表是全书的一次总复习:
| 步骤 | 值多少 | 对应章节 |
|---|---|---|
| 7 → 17 列(加过程特征) | +0.00006 | 第 05~09、15 章 |
| 17 → 21 列(加轨迹) | +0.03998 | 第 04、10 章 |
| 21 → 23 列(加泄漏钩子) | +0.00096 → 1.00000 | 第 20、21 章 |
30.2 泄漏三连:一次跑完
真实输出:
[2/5] 泄漏三连:虚高了多少?
  泄漏类型                                  干净        违规         虚高  说明
  ① 划分泄漏(按行随机)                     0.95900   0.98598   +0.02697  训练/测试共 60 支设备
  ② 预处理泄漏(全量挑特征)                   0.99870   0.99870   +0.00000  挑出的 5 列是否相同:True
  ③ 特征泄漏(+cycle_frac)              0.95900   0.96571   +0.00671  见第 20/21 章
  ③ 特征泄漏(+soh_margin)              0.95900   1.00000   +0.04100  见第 20/21 章
★ 四种泄漏,四种不同的"虚高"
| 泄漏 | 虚高 | 特征 |
|---|---|---|
| ① 划分泄漏 | +0.02697 | 大而明显 |
| ② 预处理泄漏 | +0.00000 | 在这个配置下完全看不出来 |
③ 特征泄漏(cycle_frac) | +0.00671 | 中等,"不夸张" |
③ 特征泄漏(soh_margin) | +0.04100 | 直达 1.00000 |
★ 这张表要放在一起看才有意义:
如果只做了 ① 划分泄漏 的检查:
   → 你会以为"泄漏最多虚高 0.027,可接受"
   ↓
但 ③ 里的 soh_margin 虚高了 0.041,而且直接把分数做到 1.000000
   ↓
【不同泄漏的"烈度"差一个数量级 —— 必须三种都查】
★ ② 那一行 0.00000 是诚实结论,不是"预处理泄漏不重要"
本数据上,全量挑特征和 Pipeline 内挑特征结果完全相同,挑出的 5 列也一样
   ↓
为什么看不出?样本够多(19,979 行)+ 线性选择器对缩放等变
   ↓
第 19 章的放大实验证明:一旦样本变少或模型对尺度敏感
(Ridge / kNN / SVR),差距立刻露头(实测最大 +0.06525)
   ↓
【"看不出来" ≠ "不存在",只说明"这个配置下测不出来"】
30.3 消融:谁真的值钱
真实输出:
[3/5] 消融:逐组拿掉(RF 100 棵,跑得快)
  全 21 列基线                测试 R² = 0.99903
  删【基础】             14 列   测试 R² = 0.99873   Δ = -0.00030
  删【窗口统计】         16 列   测试 R² = 0.99903   Δ = -0.00000
  删【差分斜率】         17 列   测试 R² = 0.99904   Δ = +0.00001
  删【极差】             20 列   测试 R² = 0.99903   Δ = -0.00000
  删【轨迹】             17 列   测试 R² = 0.95930   Δ = -0.03973
★ 一行结论:
删掉 4 列轨迹  →  掉 0.03973
删掉其余 16 列 →  合计只掉 0.00029
    ↓
【21 列里真正值钱的就是那 4 列】
注意"删【差分斜率】Δ = +0.00001" —— 删掉反而略好。 这不是噪声错误,而是第 15 章讲过的机制:那几列没带来新信息,只增加了树的"选择随机性"。
30.4 ★ 调参 vs 加特征:谁更值钱
真实输出:
[4/5] 调参 vs 加特征:谁更值钱?
  默认超参(21 列)      训练 0.99936  测试 0.99911
  调参后(max_iter 400)  训练 0.99965  测试 0.99907   Δ = -0.00005
  加轨迹(17 → 21 列)                                      Δ = +0.03998

  ★ 加特征的收益是调参的 880 倍
★ 这一节是全书最重要的对比
调参(max_iter 100 → 400):Δ = -0.00005   ← 不但没涨,还略降
加特征(17 → 21 列)    :Δ = +0.03998
    ↓
收益差 880 倍
为什么调参没用?
在第 27 章算过:
   21 列特征下,噪声上限 ≈ 0.999655
   当前模型已经到 0.99911
   余量 = 0.00054
      ↓
【调参最多只能吃掉那 0.00054 的余量,而它连这个都吃不满】
★ 所以调参的收益上限是"余量",而余量由特征决定:
特征差(7 列)  →  余量大(0.965 离上限很远)→  调参/换模型都有空间
特征好(21 列) →  余量小(0.999 离上限 0.0005)→  调参没空间
    ↓
【先把特征做对,再谈调参。顺序反了就是浪费】
点开:为什么"调参后测试分反而降了"不奇怪?
训练分涨了(0.99936 → 0.99965),测试分降了(0.99911 → 0.99907)。
这是典型的"训练更充分 → 略微过拟合":
max_iter 从 100 涨到 400
    ↓
模型有更多机会把训练数据拟合得更紧(训练分 +0.00029)
    ↓
但多出来的那点"拟合"有一部分是噪声
    ↓
测试分相应略降(-0.00005)
★ 关键:这个幅度(5e-5)比"折间波动"还小
第 26 章实测:九组超参的折间标准差是 0.00220 ~ 0.00546
本章这个差异:0.00005
    ↓
0.00005 比标准差小 40 倍以上
    ↓
【这个差异在统计上没有意义】所以正确的表述不是"调参让分数降了",而是:
"调参让分数变化了 0.00005 —— 这个变化远小于评估本身的波动, 所以调参在这个配置下没有可观测的效果**。"**
★ 这个区分很重要:
"调参没用"(因为余量只有 0.0005)   ← 这是有依据的结论
"调参有害"(因为降了 0.00005)     ← 这是过度解读
★ 一个通用纪律
任何小于"评估波动"的分数差异,都不该被解释成"有效果"或"有害"。 先报告波动(
± std),再解释差异。
这也是上一本反复强调"报分数要带方差"的原因。
30.5 验收与报告
真实输出:
[5/5] 验收
  最优安全配置:④ + 轨迹(21 列)★
  测试 R² = 0.99904(要求 ≥ 0.95)→ ✅ 通过
  含泄漏列吗? ✅ 不含
  泄漏版(对照)= 1.00000 ← 那是事故,不是成果
★ 验收标准有三条,缺一不可
① 测试 R² ≥ 0.95          ← 效果够用
② 不含任何泄漏列           ← 干净(不是 1.00000)
③ 能说清"哪个配置值钱"      ← 有解释力
为什么要写"泄漏版对照 = 1.00000"?
因为报告要能回答一个反问:"你能做到 1.00000 吗?"
    ↓
能 —— 加两列就行
    ↓
但我们【主动不做】,因为我们知道那是假的
    ↓
【把"我们能做到更好但选择不"写进报告,比只报一个 0.99904 更可信】
30.6 报告本体(七节)
产物:outputs/ch30-report.md
# 精度优化报告

## 一、设置
| 项 | 值 |
|---|---|
| 表 | soh_features_v2.csv(21,239 行 × 27 列) |
| 可用样本 | 19,979 行(时序特征齐全)/ 60 支设备 |
| 划分 | 按设备 GroupShuffleSplit(test_size=0.2, random_state=42) |
| 训练 / 测试 | 16,236 / 3,743 行(设备交集 0) |
| 指标 | MAE / RMSE / R² |

## 二、特征阶梯
(7 → 12 → 17 → 21 → 23 列,每一步的 Δ)

## 三、泄漏三连
(划分 / 预处理 / 特征,各自的虚高)

## 四、消融
(逐组拿掉,谁真的值钱)

## 五、调参 vs 加特征
(880 倍)

## 六、验收
(三条标准)

## 七、适用范围与局限(必读)
★ 第七节的具体内容
## 七、适用范围与局限(必读)

1. **数据是合成的**:退化单调、无随机跳变、无工况切换。
2. **覆盖面有限**:60 支设备、4 个批次。
3. **轨迹特征有前提**:`soh_lag*` 需要上线时能拿到历史实测标签
   (第 16 章账本把它标为 ⚠️)。**拿不到的话上限会掉到 0.96 附近。**
4. **耗时受机器负载影响**:报数量级,不要报精确倍数。
5. **方法可迁移,模型不可直接上线。**
★ 为什么第七条不能省
没有局限说明的结论 = 无法判断它什么时候失效
    ↓
而模型一定会失效(数据漂移、场景变化、上游改动)
    ↓
那时你需要知道:"原来的结论建立在什么假设上"
★ 第 3 条是最重要的一条:
整个 0.99904 都建立在"上线能拿到历史实测 SOH"这个前提上
    ↓
拿不到 → 0.959
    ↓
【一条前提,价值 0.04 的精度】
30.7 常见坑
① 报告里的数字手写 → 重跑后对不上(必须由脚本生成)
② 图、表、结论来自不同的计算 → 三者会互相矛盾
③ 验收只看分数 → 不看"含不含泄漏列"
④ 报"调参后降了 0.00005"当成结论 → 它比评估波动小 40 倍,没有意义
⑤ 只写结论不写局限 → 无法判断何时失效
⑥ 找模型/调参/加特征一起上 → 分不清哪个起作用(必须一次动一个)
⑦ 用 `model or default_model` → sklearn 估计器定义了 __len__,传进来的模型会被悄悄换掉
★ 关于 ⑦(这个坑我这次真的踩了)
# ❌ sklearn 估计器在未拟合时 __len__ 返回 0 → falsy → 传进来的模型被换掉
def evaluate(feats, model=None):
    m = (model or RandomForestRegressor()).fit(X, y)
    #     ^^^^^^^^^^^^^^^^^^^^^^^^^ 传进来的 model 可能被忽略!

# ✅ 显式判 None
def evaluate(feats, model=None):
    est = RandomForestRegressor() if model is None else model
m = est.fit(X, y)报错长这样:
AttributeError: 'RandomForestRegressor' object has no attribute 'estimators_'
Did you mean: 'estimator'?为什么:__len__ 在未拟合时访问 self.estimators_,抛错。 而 or 会先做真值判断 → 触发 __len__ → 报错。
★ 这是一个"通用 Python 陷阱":
任何定义了
__len__或__bool__的对象,都不能用x or default做兜底。 numpy 数组(ValueError: truth value is ambiguous)和 sklearn 估计器都属此类。
30.8 完整示例与输出
cd code
python demos/ch30-stage-target.py产物:
产物:
  ✅ ch30-report.md               3.1 KB
  ✅ ch30-metrics.csv             0.6 KB
  ✅ ch30-ladder.png             74.0 KB
★ 产出的图:
本章练习
练习 1:跑通并核对报告
- 运行
python demos/ch30-stage-target.py,确认产出三个文件; - 打开
outputs/ch30-report.md,核对"第二节 特征阶梯"里的 Δ 与表格里的数字是否自洽; - 说出报告第七节五条局限,各自对应本书的哪一章。
参考答案
① 应产出三个文件:
✅ ch30-report.md               3.1 KB
✅ ch30-metrics.csv             0.6 KB
✅ ch30-ladder.png             74.0 KB
② 核对 Δ 的自洽性
import pandas as pd
m = pd.read_csv("outputs/ch30-metrics.csv")
m["算出来的Δ"] = m["测试R2"].diff()
print(m[["配置", "特征数", "测试R2", "算出来的Δ"]].to_string(index=False))期望输出:
              配置  特征数     测试R2    算出来的Δ
  ① 基础 7 列(横截面)    7  0.95900       NaN
  ② + 窗口/差分(12 列)   12  0.95922   0.00022
  ③ + 全部过程特征(17 列)  17  0.95906  -0.00016
   ④ + 轨迹(21 列)★   21  0.99904   0.03998
 ⑤ + 两个泄漏列(23 列)❌   23  1.00000   0.00096
注意报告里"核心结论"那三条用的是【与基线 7 列比】的口径:
加 10 列过程特征(→17 列):0.95906 - 0.95900 = +0.00006
再加 4 列轨迹(→21 列)  :0.99904 - 0.95900 = +0.04003
★ 这两个口径(逐步差 vs 累计差)容易混,报告里必须写明用的是哪个。
③ 五条局限对应的章节
| 局限 | 对应章节 |
|---|---|
| 1. 数据是合成的(退化单调、无跳变、无工况切换) | 第 01 章(数据声明)、第 09 章 |
| 2. 覆盖面有限(60 支设备、4 个批次) | 第 01 章、第 30.6 节 |
| 3. 轨迹特征需要"上线能拿到历史实测标签" | 第 16 章(账本 ⚠️)、第 10 章 |
| 4. 耗时受机器负载影响 | 第 26 章(调参耗时)、第 27 章 |
| 5. 方法可迁移,模型不可直接上线 | 第 01 章(三条边界) |
★ 这个对应关系说明:
"局限"不是客套话
    ↓
它的每一条都能追溯到前面某一章讲过的具体机制
    ↓
【写得出准确的局限,说明你真的理解了结论的依赖条件】
练习 2:给报告加一节"失败记录"
一份好的报告应该记录"试过但没用"的做法。请为报告加一节, 列出至少三条"本书试过但收益有限"的做法,并给出数字。
参考答案
## 八、试过但收益有限的做法(失败记录)

| 做法 | 收益 | 结论 |
|---|---|---|
| 加 10 列窗口/差分/极差特征 | 测试 R² **+0.00006** | 信息与基础列冗余,不值 |
| 调参(`max_iter` 100 → 400) | 测试 R² **-0.00005** | 余量只有 0.0005,调参没有空间 |
| 融合三个模型(RF + GBDT + 线性) | 测试 R² **+0.00001** | 比折间波动小 40 倍,无意义 |
| 多窗口平均(回看 5/20/50) | 测试 R² **+0.00002** | 同上 |
| 换缩放器(Standard → MinMax) | 线性回归 0.95053 → 0.95053 | 完全相同 |
| 类别编码(OneHot / Label) | 随机森林 **-0.00412 / -0.00320** | 类别列与本数据标签无关,加了还降 |
| 相对内阻(相对自身基线) | 随机森林 **-0.00597** | 与原始内阻相关 0.94,纯冗余 |
★ 为什么"失败记录"有价值
理由一:防止重复劳动
新同事问:"能不能试试多窗口平均?"
    ↓
翻到失败记录 → "试过了,+0.00002" → 不用重做
理由二:它让"否定结论"变成资产
"我们试了 7 个方向,只有历史特征是有效的"
    ↓
这个结论能阻止团队在未来两个月里继续试那 6 个方向
理由三:它让报告更可信
只报成功的报告 → 读者会想"那失败的呢?是不是没试?"
连失败一起报   → 读者知道"他们试得很彻底"
★ 三条"试过但没用"里,哪条最值得记?
"融合模型 +0.00001(比噪声小 40 倍)"
    ↓
这条特别值得写,因为它【看起来应该有用】
(教科书写"集成能提升效果")
    ↓
本数据证明了:当特征已经到位(0.999)时,集成没有空间
    ↓
【这条记录能挡住"要不要做个 stacking"这种提议】
练习 3:把这份报告迁移到你的场景
用你自己的数据(或假设一个),写出这份报告需要的六节内容(设置 / 阶梯 / 泄漏 / 消融 / 调参对比 / 验收)。
要求:不需要真的跑代码,但每一节都要写具体,不能是"视情况而定"。
参考答案
以"门店销售额预测"为例(你换成自己的场景):
# 销售额预测:精度优化报告

## 一、设置
| 项 | 值 |
|---|---|
| 表 | stores_sales.csv(48,000 行 × 22 列) |
| 可用样本 | 45,120 行 / 300 家门店 |
| 划分 | 按门店 GroupShuffleSplit(test_size=0.2, random_state=42) |
| 训练 / 测试 | 36,096 / 9,024 行(门店交集 0) |

## 二、特征阶梯
| 配置 | 特征数 | 测试 R² | 与基线比 |
|---|---|---|---|
| ① 门店静态属性(面积/商圈/开业时间) | 6 | 0.521 | — |
| ② + 当周客流与客单价 | 10 | 0.763 | **+0.242** |
| ③ + 促销标志与节假日 | 14 | 0.741 | +0.220 |
| ④ + 历史销售额(lag1/lag4/lag52) | 17 | 0.912 | **+0.391** |
| ⑤ + "去年同期"特征 ❌ 泄漏 | 18 | 0.987 | +0.466 |

## 三、泄漏三连
| 泄漏 | 干净 | 违规 | 虚高 |
|---|---|---|---|
| 划分(按行随机 vs 按门店) | 0.912 | 0.958 | +0.046 |
| 预处理(全量 vs Pipeline 内标准化) | 0.912 | 0.912 | +0.000 |
| 特征(+ 全周期平均销售额 ❌) | 0.912 | 0.961 | +0.049 |

## 四、消融
| 拿掉的组 | 测试 R² | Δ |
|---|---|---|
| —— 全 17 列 | 0.912 | — |
| 删【门店静态属性】 | 0.906 | -0.006 |
| 删【客流/客单价】 | 0.821 | **-0.091** |
| 删【促销/节假日】 | 0.909 | -0.003 |
| 删【历史销售额】 | 0.734 | **-0.178** |

## 五、调参 vs 加特征
| 动作 | Δ |
|---|---|
| 调参(GBDT 网格搜索) | +0.004 |
| 加特征(+ 历史销售额 4 列) | **+0.178** |

## 六、验收
- 最优:④ + 历史销售额(17 列),测试 R² = **0.912**
- 不含泄漏列 ✅
- 不达标(要求 ≥ 0.95)→ **需要更多信息源**(竞品开店、商圈变化)
★ 从这份示例能看出三件事
① "特征阶梯"直接告诉你瓶颈在哪
④ 加历史销售额 → +0.391(最大的一跳)
    ↓
说明这类特征最关键,应该继续往这个方向挖
② "泄漏三连"里的"预处理 0.000"不等于安全
本示例(门店数据)里,全量标准化看不出差距
    ↓
但和本书第 19 章一样:换 Ridge / kNN 就会露头
    ↓
【报告里必须写上"这个 0.000 是在什么配置下测的"】
③ "验收不通过"也是一个合格结论
测试 R² = 0.912 < 0.95
    ↓
报告的价值不是"宣布成功",而是【明确差多少、差在哪】
    ↓
本例的结论:"需要更多信息源"——这是一个可执行的下一步
    ↓
【比"再多调调参"有用得多】
★ 最后一条通用建议
如果你现在还没有自己的数据集,用本书的数据把这份报告当模板跑一遍: 把"设备"换成"门店"、"循环"换成"周", 把六节填满。这个过程本身就是一次完整的项目演练。
能独立填满这六节,说明这本书你真的读懂了。
面向工程实践:报告是"决策文档",不是"成绩单"
① 这份报告真正的读者不是你自己
三个月后接手的人、你的主管、评审的人
    ↓
他们需要知道的不是"你跑了多少实验"
    ↓
而是:"该用哪个配置、为什么、代价是什么、什么时候会失效"
★ 四个必备要素:
① 结论:用哪个配置(明确)
② 依据:数字支撑(可追溯)
③ 代价:放弃了什么(诚实)
④ 局限:什么情况下不成立(可判断有效期)
② 让报告"永远和数字一致"的三个纪律
纪律一:数字只能有一个来源
def evaluate(feats):
    """所有指标都从这里出。"""
    ...

# ✅ 图和报告都用同一个结果对象
r = evaluate(SAFE)
ax.set_title(f"R² = {r['测试R2']:.5f}")            # 图
report += f"| R² | {r['测试R2']:.5f} |"             # 报告
纪律二:报告由脚本生成,不手写
手写的数字 = bug 的温床
    ↓
因为报告往往要反复重跑,
   而手写的数字会在某次重跑后悄悄变错
纪律三:口径不一致的地方必须写明
本章的"核心结论"用【与基线比】的口径
表格的 Δ 用【逐步差】的口径
    ↓
两者不一样,所以报告里必须写明
    ↓
【不写口径,半年后没人知道那个 +0.00006 是怎么来的】
★ ③ 一个可以直接用的报告模板
# <项目>:精度优化报告

> 由 <脚本路径> 自动生成,SEED=<n>,所有数字均为实测。
> 数据:<表名>(<行数> 行 × <列数> 列),<实体数> 个实体。

## 一、设置
(表 / 可用样本 / 划分 / 训练测试规模 / 指标)

## 二、特征阶梯
(每一步加了什么、值多少 Δ)

## 三、泄漏三连
(划分 / 预处理 / 特征,各自的虚高)

## 四、消融
(逐组拿掉,谁真的值钱)

## 五、调参 vs 加特征
(谁更值钱,多少倍)

## 六、验收
(标准 + 结果 + 泄漏版对照)

## 七、适用范围与局限(必读)

## 八、失败记录(可选但强烈建议)
★ 一句话总结
报告不是"我做了什么",而是"该做什么、为什么、代价是什么、什么时候会失效"。 一份好的报告,让读者不需要问你任何问题就能做决定。
第 31 章会把这份报告和那两张清单,变成团队里的流程卡点。