第 08 章 · 差分与斜率:变化量比绝对值更早报警
这一章要解决什么:上一章造的是"窗口内的水平"(均值、标准差)。 这一章造变化:同样是 0.90 的两支设备, 一支每月掉 0.3%、一支每月掉 3%,处置方式完全不同。
最容易踩的坑: ①
diff()忘了groupby—— C002 第一行减掉 C001 最后一行,造出一个 1429 倍的假信号; ② 只造逐圈差分 —— 这个数据里它被 4 位小数量化吃掉(1.94% 恰好为 0); ③ 窗口太短就拟合斜率 —— 得到一列噪声是信号 30 倍的垃圾(cap_slope)。
本章你需要完成的代码:demos/ch08-diff-slope.py
8.1 一句话:绝对值和变化量在回答两个问题
先看一个"两支设备分不开"的场景:
设备甲:SOH = 0.90,最近 60 圈掉了 0.83 个百分点   → 还能用很久
设备乙:SOH = 0.90,最近 60 圈掉了 1.18 个百分点   → 需要提前安排更换
              ↑
      只看 SOH 这一个数,它们一模一样
★ 这就是"变化量"的全部动机:
| 问的问题 | 该用哪类特征 | 例 |
|---|---|---|
| 现在多健康? | 绝对值 / 窗口均值 | soh、res_win_mean |
| 往哪走、多快? | 差分 / 斜率 | soh_d1、res_slope20 |
| 稳不稳? | 窗口内 σ / 极差 | volt_win_std、temp_win_range20 |
三类特征各管一段,不能互相替代。第 9 章讲第三类,这一章讲第二类。
★ 一个必须建立的本能:
"变化量"是把未来的信息提前"投影"到现在的唯一方式 —— 所以它也是最容易越界的地方(第 10 章会把这条边界讲完)。
8.2 三种差分的语义
真实输出:
=== ① 三种差分的语义(C001,每 100 圈取一行)===
 cycle    soh  soh_d1  soh_d100  cap_slope
     1 0.9999     NaN       NaN        NaN
   101 0.9831 -0.0001   -0.0168     0.0103
   201 0.9626 -0.0002   -0.0205     0.0048
   301 0.9404 -0.0003   -0.0222    -0.0118
   401 0.9171 -0.0003   -0.0233    -0.0117
   501 0.8929 -0.0003   -0.0242    -0.0076
   601 0.8680 -0.0002   -0.0249    -0.0172
   701 0.8424 -0.0002   -0.0256     0.0075
   801 0.8162 -0.0003   -0.0262    -0.0004
  三列的量纲:
    soh_d1    = soh(t) - soh(t-1)          → 每 1 圈变化了多少
    soh_d100  = soh(t) - soh(t-100)         → 每 100 圈变化了多少
    cap_slope = Δ容量 / Δ圈数              → Ah / 圈
  ⚠️ 每支设备第一行的差分为 NaN(没有上一行可减)——正常,建模时 dropna。
★ 三列各自的三个特征:
| 列 | 跨度 | 单位 | 抗噪 |
|---|---|---|---|
soh_d1 | 1 圈 | soh / 圈 | 差(被量化噪声主导) |
soh_d100 | 100 圈 | soh / 100 圈 | 好 |
cap_slope | 1 圈 | Ah / 圈 | 极差(噪声是信号 30 倍) |
看数字就能看出来:
soh_d1 那一列在 -0.0001 / -0.0002 / -0.0003 三个值之间跳(分辨率不够)
soh_d100 那一列从 -0.0168 单调走到 -0.0262(趋势清清楚楚)
cap_slope 那一列在 +0.0103 和 -0.0118 之间来回翻符号(纯噪声)
★ 一句话:
同样叫"斜率",跨度不同、对象不同,可用性可以差 30 倍。
8.3 差分也必须分组
第 06 章的坑换一个函数又来了 —— 而且这次更夸张。
真实输出:
=== ② 不分组差分:C002 第一行会减掉 C001 的最后一行 ===
cell_id  cycle      soh  soh_d1_bad
   C001    862  0.80000    -0.00030
   C002      1  1.00000     0.20000
   C002      2  1.00000     0.00000

  C002 第一行的「变化量」= +0.20000 —— 真实情况是它没有上一行,应该 NaN。
  这个假信号的绝对值 |0.20000| 是正常逐圈变化量(约 0.00014)的 1429 倍。
  → 和 rolling 一样,`diff` 也必须在 `groupby(...)` 里面做。
★ 这个 0.2 是怎么来的:
C002 第一行:soh = 1.0000
减掉"上一行"(其实是 C001 的最后一行):soh = 0.8000
              ↓
soh_d1 = 1.0000 - 0.8000 = +0.2000
              ↓
这个信号的正确含义是:"这台设备的健康度一夜之间上升了 20 个百分点"而且它的方向还是「错的」:
| 正常值的符号 | 这个假信号 | |
|---|---|---|
soh_d1 | 负(健康度只会下降) | 正 +0.2 |
★ 一个"正的变化量"本身就是最明显的异常标记:
if (df["soh_d1"] > 0).any():
    print("出现了正的健康度变化 —— 先怀疑分组,再怀疑传感器")
这句检查非常便宜,而且非常有效 —— 因为它的物理含义是"设备变好了", 而在这个数据里,非 NaN 的 soh_d100 一次都没有为正(第 8.4 节会给实测)。
8.4 跨度差分比逐圈差分稳
真实输出:
=== ④ 跨度差分比逐圈差分稳:噪声的账 ===
  soh_d1  :非空 69,531,其中恰好为 0 的 1,349 行(1.94%)
  → 原始表里 soh 只存到小数点后 4 位,早期每圈变化比 0.00005 还小,差分直接变成 0。
  soh_d1       标准差 = 0.000067
  soh_d100/100  标准差 = 0.000048   ← 同一个「每圈平均变化」,噪声小了 1.41 倍
  soh_d1   为负的比例 = 98.06%
  soh_d100 为负的比例 = 100.00%  ← 跨度差分【没有一次】给出方向相反的信号
  → 隔 100 圈相减,噪声被平均掉,趋势留下来了。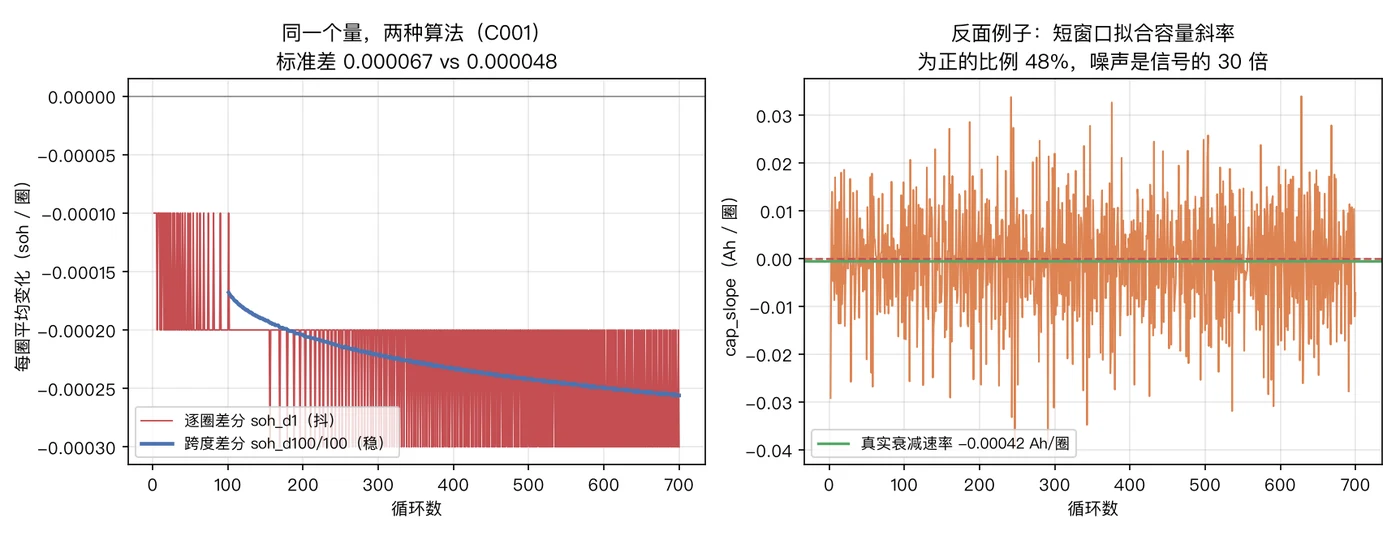
★ 这三行数据的完整解读:
| 指标 | soh_d1 | soh_d100 / 100 | 说明 |
|---|---|---|---|
| 恰好为 0 的比例 | 1.94% | 0% | 逐圈差分被 4 位小数量化吃掉了 |
| 标准差 | 0.000067 | 0.000048 | 同样表达"每圈平均变化",跨度版更稳 |
| 为负的比例 | 98.06% | 100.00% | 跨度版从不给反方向信号 |
★ "1.94% 恰好为 0"是最容易被忽略的一行:
原始表里 soh 的存储精度:小数点后 4 位
早期每圈真实变化:约 0.00005
             ↓
0.00005 < 0.0001(一个最低位)
             ↓
相邻两个数被四舍五入到同一个值 → 差分 = 0(假"没有变化")
⚠️ 这带来一个实际的建模后果:
用 soh_d1 当特征,模型会看到"有 1.94% 的样本变化量恰好是 0"
    ↓
那不是"真的没变",是"精度不够"
    ↓
如果这个数据里"没变"本身有含义(比如"设备停了"),
模型会把这两件事混在一起学
★ 两个修法:
# ① 用跨度差分代替逐圈差分(本章推荐)
x.diff(100) / 100

# ② 保留逐圈差分但降采样(比如每 10 圈一行)
x.iloc[::10].diff()
★ 一条通用纪律:
差分的跨度必须大于"数据精度能分辨的量"。 否则你得到的不是变化量,是"存储精度的量化栅栏"。
8.5 反面例子:短窗口拟合斜率 = 一列噪声
真实输出:
=== ⑤ 反面例子:在 100 圈的短窗口里拟合容量斜率 ===
  cap_slope = Δ容量/Δ圈数(逐圈)
    均值 -0.000432  标准差 0.012911  范围 -0.0648 ~ +0.0548
    为正的比例 48.40% —— 容量明明在单调下降
    相邻两行换符号的比例 0.67(一半以上都在跳)
  真实的容量衰减速率(窗口表口径):0.000424 Ah / 圈
  噪声 / 信号 = 30.5 倍 —— 这一列基本只有噪声。
  验证:容量每圈有约 0.01 Ah 的测量噪声,两个相邻测量相减再除以 1 圈,
        噪声标准差 ≈ 0.0141 Ah/圈,与实测 0.0129 吻合。
  → 特征不是越多越好:这一列喂进去只会让模型多一个机会拟合噪声。
★ 读这四个数字就够了:
| 数字 | 值 | 意味着 |
|---|---|---|
| 为正的比例 | 48.40% | 容量明明只降不升,却有近一半行给出正斜率 |
| 相邻两行换符号占比 | 0.67 | 三分之二的相邻行方向都不同 —— 这不是斜率,是抛硬币 |
| 真实衰减速率 | 0.000424 Ah/圈 | 信号 |
cap_slope 标准差 | 0.012911 | 噪声 |
| 噪声 / 信号 | 30.5 倍 | 这个特征的"信噪比" |
★ 为什么必然如此 —— 一笔可以手算的账:
容量的逐圈测量噪声:σ ≈ 0.01 Ah(相对 2.5 Ah 额定,即 0.4%)
逐圈差分 = 两个相邻测量相减再除以 1 圈
             ↓
噪声标准差 ≈ √2 × 0.01 = 0.0141 Ah/圈
             ↓
与实测的 cap_slope 标准差 0.0129 吻合 ✓
             ↓
而真实衰减只有 0.0004 Ah/圈 —— 被噪声盖住了 30 倍
★ 差分的"噪声放大"是一条数学必然:
差分 = 两个独立的测量相减 → 噪声按 √2 放大; 而信号(真实变化量)通常远小于单个测量的噪声。 所以"逐点差分 + 短窗口"= 噪声发生器。
★ 怎么救:
| 做法 | 效果 |
|---|---|
拉长跨度(diff(100)) | 信号线性增长、噪声只按 √100 增长 → 信噪比改善 10 倍 |
先平滑再差分(rolling(20).mean().diff()) | 噪声被平均掉 |
| 直接放弃这一列 | 本章的结论:这一列在这份数据上没有可用信息 |
⚠️ 最后一条要说清楚:
**不是说"容量斜率没用",而是说"在这份数据的分辨率下, 逐圈的容量斜率没用"。
换一份采样精度更高的数据,它可能就有用。
8.6 表里的差分列是什么口径
真实输出:
=== ⑥ v2 表里的差分列是什么口径 ===
  volt_slope20   非空 19,979   mean  +0.00065   std  0.00058   min   -0.0017   max   +0.0029
  res_slope20    非空 19,979   mean  +0.09374   std  0.07978   min   -0.2541   max   +0.3760
  temp_slope20   非空 19,979   mean  +0.02598   std  0.03369   min   -0.1349   max   +0.1534
  res_diff1      非空 21,179   mean  +0.09385   std  1.42716   min   -5.2369   max   +6.0536
  volt/res/temp_slope20 = (上一个窗口的值 − 20 个窗口前的值)/ 20
    → 单位是「每窗口变化量」,1 窗口 = 3 圈,所以它约等于过去的 60 圈里变了多少。
  res_diff1 = 相邻两个窗口的一阶差分(mΩ / 窗口)
  现场话术:20 个窗口 ≈ 最近 60 圈 ——
    关心的是「最近一个月掉了多少」,不是「昨天掉了多少」。
★ 两个口径必须分清:
| 列 | 跨度 | 单位 | 现场怎么读 |
|---|---|---|---|
volt_slope20 等 | 20 个窗口 ≈ 60 圈 | 每窗口变化量 | "最近两个月电压抬升了多少" |
res_diff1 | 1 个窗口 = 3 圈 | mΩ / 窗口 | "这一周转了多快" |
看标准差就能看出差别:
res_slope20   std = 0.07978      (跨度 20 窗口,平滑)
res_diff1     std = 1.42716      (跨度 1 窗口,抖)—— 相差 18 倍
★ 这两个列是"同一件事的两个时间尺度",而且它们的关系正好印证第 8.4 节:
跨度大的 → 稳
跨度小的 → 抖
⚠️ 一个容易犯的命名错误:
# 危险:名字里没有跨度
df["res_slope"] = ...

# 安全:跨度写在名字里
df["res_slope20"]    # 20 个窗口
df["res_diff1"]      # 1 个窗口
★ 纪律:
窗口类 / 差分类特征的列名里必须带跨度。 因为三个月后没人记得
res_slope到底是几圈的斜率 —— 而它的取值会因此差 18 倍。
点开:为什么本章把"斜率"和"差分"分开写?
因为在工程上它们的成本完全不同:
差分(diff(k)) | 斜率(polyfit / lstsq) | |
|---|---|---|
| 计算量 | 一行 pandas | 每个窗口一次最小二乘 |
| 抗噪 | 只减一次,噪声 √2 | 取决于窗口长度与拟合方式 |
| 可解释 | "掉了多少" | "平均掉得多快" |
| 出错方式 | 忘了分组(本章 8.3) | 窗口太短 → 噪声主导(8.5) |
★ 一句工程建议:
能用差分表达的,就不要拟合斜率。
"最近 60 圈掉了多少"(
diff(60))和"最近 60 圈的斜率"(/60) 是同一个数的两种写法 —— 但前者不用跑最小二乘,也不用担心 拟合出的截距把信息吃掉。
什么时候必须用拟合:
窗口内不是单调的(比如先降后升)
    ↓
"掉了多少"会掩盖形状
    ↓
这时需要斜率 + 二次项,或者干脆用窗口的 max / min / 分位点(第 9 章)
8.7 常见坑
① diff() 不分组                 → C002 第一行 +0.2000(正常值的 1429 倍)
② 用逐圈差分当"斜率"             → 1.94% 的值恰好为 0(4 位小数精度不够)
③ 短窗口拟合斜率                 → 噪声是信号的 30.5 倍(48.40% 为正)
④ 列名不带跨度                   → res_slope 与 res_diff1 标准差差 18 倍
⑤ 只看绝对值不管方向             → 正的健康度变化量 = 第一个该排查的信号
⑥ 忘了差分列的 NaN 也是两档      → slope20 缺 21 行,diff1 只缺 1 行(第 07 章)
第 ⑤ 条补一句:
在这个数据里:soh_d100 非空的行【100% 为负】、soh_d1 有 1.94% 为 0
   ↓
所以"出现正值"这件事,几乎一定意味着串线或传感器问题
8.8 完整示例与输出
cd code
python demos/ch08-diff-slope.py
真实输出(节选):
=== ① 三种差分的语义(C001,每 100 圈取一行)===
 cycle    soh  soh_d1  soh_d100  cap_slope
   101 0.9831 -0.0001   -0.0168     0.0103
   301 0.9404 -0.0003   -0.0222    -0.0118
   801 0.8162 -0.0003   -0.0262    -0.0004

=== ② 不分组差分:C002 第一行会减掉 C001 的最后一行 ===
   C001    862  0.80000    -0.00030
   C002      1  1.00000     0.20000
  C002 第一行的「变化量」= +0.20000 —— 真实情况是它没有上一行,应该 NaN。
  这个假信号的绝对值 |0.20000| 是正常逐圈变化量(约 0.00014)的 1429 倍。

=== ④ 跨度差分比逐圈差分稳:噪声的账 ===
  soh_d1       标准差 = 0.000067
  soh_d100/100  标准差 = 0.000048
  soh_d100 为负的比例 = 100.00%

=== ⑤ 反面例子:在 100 圈的短窗口里拟合容量斜率 ===
    为正的比例 48.40% —— 容量明明在单调下降
  噪声 / 信号 = 30.5 倍 —— 这一列基本只有噪声。

结论:绝对值说「现在多健康」,变化量说「往哪走、多快」——后期每圈变化是早期的 1.41 倍。
      跨度差分(隔 100 圈)比逐圈差分稳 1.41 倍;
      而窗口太短就拟合斜率,只会得到一列噪声(48% 为正)。
本章练习
练习 1:C003 的三种差分(每 100 圈取一行)
在逐循环表上按设备分组,造三列:soh_d1(逐圈差分)、soh_d100(隔 100 圈差分)、 cap_slope(Δ容量 / Δ圈数)。
打印 C003 每 100 圈取一行的表格(cycle / soh / 三列差分), 并说明第一行为什么三列都是 NaN。
参考答案
import os

import pandas as pd

HERE = os.path.dirname(os.path.abspath(__file__))
CODE = os.path.abspath(os.path.join(HERE, "..", ".."))
RAW_CSV = os.path.join(CODE, "data", "battery", "cycle_raw.csv")

raw = pd.read_csv(RAW_CSV).sort_values(["cell_id", "cycle"]).reset_index(drop=True)
g = raw.groupby("cell_id")
raw["soh_d1"] = g["soh"].diff()
raw["soh_d100"] = g["soh"].diff(100)
raw["cap_slope"] = g["capacity_ah"].diff() / g["cycle"].diff()

one = raw[raw["cell_id"] == "C003"]
print(one.iloc[::100][["cycle", "soh", "soh_d1", "soh_d100", "cap_slope"]]
.to_string(index=False, float_format=lambda v: f"{v:>9.5f}"))期望输出:
=== 练习 1:C003 的三种差分(每 100 圈取一行)===
 cycle       soh    soh_d1  soh_d100  cap_slope
     1   0.99990       NaN       NaN        NaN
   101   0.98340  -0.00020  -0.01650    0.01490
   201   0.96300  -0.00020  -0.02040    0.00420
   301   0.94090  -0.00020  -0.02210    0.02490
   401   0.91750  -0.00020  -0.02340   -0.00030
   501   0.89310  -0.00030  -0.02440    0.01740
   601   0.86800  -0.00020  -0.02510    0.01260
   701   0.84210  -0.00020  -0.02590   -0.01980
   801   0.81560  -0.00030  -0.02650    0.01140
★ 第一行为什么是三个 NaN:
soh_d1    → 没有上一行(diff(1) 需要 1 个历史点)
soh_d100  → 没有 100 圈前的行(diff(100) 需要 100 个历史点)
cap_slope → 同 soh_d1,而且容量列也是从这一行开始
★ 顺便看清一件事:cap_slope 在这 8 行里有 6 行是正的 (+0.0149 / +0.0042 / +0.0249 / +0.0174 / +0.0126 / +0.0114), 而容量在这 800 圈里明显在下降 —— 这就是 8.5 节那个反面例子的具体样子。
练习 2:不分组 diff 会造出一个巨大的假信号
- 不排序、不分组直接
df["soh"].diff(),打印C002/cycle=1的值; - 打印正常逐圈变化量的绝对值均值,算出这个假信号是它的多少倍;
- 分组后再算一次同一个位置(应该是
NaN)。
参考答案
import os

import pandas as pd

HERE = os.path.dirname(os.path.abspath(__file__))
CODE = os.path.abspath(os.path.join(HERE, "..", ".."))
RAW_CSV = os.path.join(CODE, "data", "battery", "cycle_raw.csv")

bad = pd.read_csv(RAW_CSV)
bad["d_bad"] = bad["soh"].diff()
n1 = int(bad.index[bad["cell_id"] == "C002"][0])

raw = pd.read_csv(RAW_CSV).sort_values(["cell_id", "cycle"]).reset_index(drop=True)
raw["soh_d1"] = raw.groupby("cell_id")["soh"].diff()

v = float(bad["d_bad"].iloc[n1])
normal = float(raw["soh_d1"].abs().mean())
print(f"  不分组:C002 第一行的差分 = {v:+.5f}")
print(f"  正常逐圈变化量的绝对值均值 = {normal:.6f}")
print(f"  假信号是正常值的 {abs(v) / normal:,.0f} 倍")
print(f"  分组后同一个位置 = "
f"{raw[raw['cell_id'] == 'C002']['soh_d1'].iloc[0]} ← NaN 才对")期望输出:
=== 练习 2:不分组 diff 会造出一个巨大的假信号 ===
  不分组:C002 第一行的差分 = +0.20000
  正常逐圈变化量的绝对值均值 = 0.000172
  假信号是正常值的 1,160 倍
  分组后同一个位置 = nan  ← NaN 才对
★ 这个数比第 8.3 节的 1429 倍小一点,因为这里的"正常值"用的是 全表(包含后期,后期变化更大)的平均,而 8.3 节用的是早期的一个典型值。
两个数都对,区别只在"拿什么当基准" ——
这也是第 02 章那条纪律的又一次出现: 说倍数的时候必须说清"分母是什么"。
练习 3:变化量后期更大 + 逐圈差分的量化噪声
- 算
soh ≥ 0.95与soh ≤ 0.85两个区段的|soh_d1|均值与倍数; - 统计
soh_d1恰好为 0 的行数占比,并解释原因; - 对比
soh_d1与soh_d100中为负的比例,说明哪一个能给方向。
参考答案
import os

import pandas as pd

HERE = os.path.dirname(os.path.abspath(__file__))
CODE = os.path.abspath(os.path.join(HERE, "..", ".."))
RAW_CSV = os.path.join(CODE, "data", "battery", "cycle_raw.csv")

raw = pd.read_csv(RAW_CSV).sort_values(["cell_id", "cycle"]).reset_index(drop=True)
g = raw.groupby("cell_id")
raw["soh_d1"] = g["soh"].diff()
raw["soh_d100"] = g["soh"].diff(100)

early = raw[raw["soh"] >= 0.95]["soh_d1"].abs().mean()
late = raw[raw["soh"] <= 0.85]["soh_d1"].abs().mean()
print(f"  早期(soh ≥ 0.95):{early:.6f} / 圈")
print(f"  后期(soh ≤ 0.85):{late:.6f} / 圈")
print(f"  后期 / 早期 = {late / early:.4f}")

d1 = raw["soh_d1"].dropna()
print(f"  soh_d1 恰好为 0 的行:{int((d1 == 0).sum()):,d} / {len(d1):,d}"
      f"({100 * (d1 == 0).mean():.2f}%)")
print(f"  soh_d1 为负的比例  :{100 * (d1 < 0).mean():.2f}%")
print(f" soh_d100 为负的比例:{100 * (raw['soh_d100'].dropna() < 0).mean():.2f}%")期望输出:
=== 练习 3:变化量后期更大 + 逐圈差分的量化噪声 ===
  早期(soh ≥ 0.95):0.000139 / 圈
  后期(soh ≤ 0.85):0.000197 / 圈
  后期 / 早期 = 1.4146
  soh_d1 恰好为 0 的行:1,349 / 69,531(1.94%)
  soh_d1 为负的比例  :98.06%
  soh_d100 为负的比例:100.00%
  → 同一份数据,跨度差分一个反方向的信号都没给;逐圈差分被 4 位小数量化吃掉了。
★ 1.4146 这个数在本书里出现了两次:
后期 / 早期(每圈变化量)        = 1.4146
std(soh_d1) / std(soh_d100/100) = 0.000067 / 0.000048 = 1.41这是巧合,但两个都在说同一件事:
这个数据里的退化是"加速"的(越到后期掉得越快)。 所以"变化量"不是可有可无的补充信息 —— 它承载了"这支设备现在走到哪一段"这个关键信息。
面向工程实践:变化量是"预测性维护"的语言
① 现场真正关心的是"还有多久",不是"现在多少"
只报绝对值:
   "这台设备 SOH = 0.90"  → 现场:"所以呢?"

加上变化量:
   "SOH = 0.90,最近 60 圈掉了 1.18 个百分点"
   → 现场:"照这个速度,掉到 0.80 还要约 500 圈"   ← 这才是一个决策
★ 换算方法(第 30 章会做成完整报告):
rate_per_cycle = abs(soh_d100) / 100          # 每圈掉多少
cycles_left = (soh - 0.80) / rate_per_cycle   # 距退役线还有多少圈
② 三类变化量的选择顺序
| 优先 | 做法 | 什么时候用 |
|---|---|---|
| 1 | 跨度差分 diff(k) | 默认。k 取"你关心的决策周期" |
| 2 | 平滑后差分 rolling(m).mean().diff(k) | 测量噪声大时 |
| 3 | 窗口内最小二乘斜率 | 窗口内非单调、需要形状信息时 |
★ k 怎么定:
你的维护决策周期是多久?
   → 一个月(30 圈)?→ k = 30
   → 一个季度?        → k = 100

k 的取值必须 ≥ "数据精度能分辨的最小变化量 / 每圈真实变化"
③ 一个便宜的异常检测
def check_diff_direction(df, col="soh_d1", group="cell_id"):
    """变化量的方向检查:健康度类指标不该上升。"""
    bad = df[df[col] > 0]
    if len(bad):
        print(f"⚠️ {len(bad)} 行出现正向变化 → 先怀疑分组,再怀疑传感器")
        print(bad[[group, "cycle", col]].head())
★ 为什么这类检查值得写:
分组错误 → 造出 +0.2 的假信号 → 方向检查立刻报警
传感器漂移 → 造出系统性正斜率 → 方向检查也会报警
                 ↓
一行代码,同时覆盖"代码错误"和"数据错误"两类问题
④ 这一章在整本书里的位置
第 05 章:窗口(把一段压成数)           → 水平
第 06 章:分组与排序(别串线)           → 前提
第 07 章:冷启动 NaN(缺了多少)         → 代价
第 08 章:差分与斜率(变化量)           ← 你在这里
第 09 章:滚动统计与极差(最坏情况)      → 波动
第 10 章:把上面这些收成一张检查表