第 18 章 · 泄漏①:划分泄漏
这一章要解决什么:把"按行随机会虚高"这件事量出来,并补上上一本没讲的两个视角 —— ① 近重复样本:测试行的最近邻有 88.9% 落在同一支设备上; ② 天花板效应:干净口径越接近 1,泄漏量就越会被挤没(21 列时只剩 +0.00001)。
最容易踩的坑: ① 它不报错、不警告,六项常规检查全部通过; ② 它给的分数很漂亮,而且训练/测试差很正常; ③ 你以为"分数稳定"是好事 —— 但在泄漏口径下,"稳定"恰恰是它作弊的证据。
本章你需要完成的代码:demos/ch18-leak-split.py
本章的数字口径:soh_features_v2.csv 全部 21,239 行、7 列基础特征、 随机森林 200 棵(random_state=42)、按设备 GroupShuffleSplit(test_size=0.2)。 所有分数都是测试集 R²。
18.1 先高兴一下:0.98764
假设你刚拿到这份数据,做了一个很正常的决定:
train_idx, test_idx = train_test_split(np.arange(len(X)), test_size=0.2, random_state=42)

model = RandomForestRegressor(n_estimators=200, random_state=42, n_jobs=-1)
model.fit(X.iloc[train_idx], y.iloc[train_idx])
print(model.score(X.iloc[test_idx], y.iloc[test_idx]))真实输出:
① 先高兴一下:按行随机划分,测试 R² = 0.98764
  按行随机:train_test_split(test_size=0.2, random_state=42)
    训练 16,991 行 / 测试 4,248 行
    训练 R² = 0.99821   测试 R² = 0.98764   训练/测试差 = 0.01057
  这份报告看起来健康:解释力 98.8%,几乎没有过拟合。(2.6 s)
★ 这两个数字放在任何一份周报里都是好成绩:
测试 R² 0.98764  → 在"没见过的数据"上解释了 98.8% 的方差
训练/测试差 0.01057 → 没有明显过拟合
而且你会做的六项检查,全部通过:
| 你可能会做的检查 | 结果 |
|---|---|
| 有没有报错 / 警告? | ✅ 没有 |
特征里有没有标签 soh? | ✅ 没有(只有 7 列基础特征) |
| 有没有 |r| > 0.99 的特征? | ✅ 没有(最大 |r| = 0.9683) |
| 训练/测试分数差大不大? | ✅ 只有 0.01057 |
X 与 y 行数是否一致? | ✅ 21,239 == 21,239 |
| 训练行与测试行有没有重叠? | ✅ 交集 0 行 |
★ 六项全过 —— 而泄漏就发生在第六项"通过"的那一瞬间。
"训练行与测试行有没有重叠" —— 这个检查永远通过
     ↓
因为它问的是【行】,而泄漏发生在【行所属的设备】上
     ↓
一个永远通过的检查,比没有检查更危险:
它让你以为自己已经查过了
点开:这时候人的第一反应是什么(以及它为什么是错的)
第一反应通常是"那我换个更强的模型,看能不能到 0.99"。
0.98764 → 换 HistGB → 0.988 → 换更大的森林 → 0.9905 → …这条路每一步都是错的,因为卡点不在模型,在划分方式。
看一个证据就懂了(本章 demo 的第 ⑤ 节实测):
        seed        按行随机         按设备
           0     0.98719     0.93903
           1     0.98684     0.96942
           7     0.98763     0.95514
          42     0.98764     0.96503
        2024     0.98693     0.94925
换种子、换比例、换模型,按行随机都在 0.987 附近打转。
这说明 0.987 不是"某个模型的成绩",而是"这套评估方法的天花板"
     ↓
当一个分数高到"换什么模型都差不多"的时候,
要做的事不是继续换模型,而是回头检查评估方式
★ 而"种子的影响"这一栏还藏着一个更反直觉的事实:
按行随机:极差 0.00079(非常稳)
按设备  :极差 0.03039(很散)

直觉会说"按行随机更可靠" —— 完全错了:
它的"稳"来自每次都把同一批设备当熟人在考,
考的永远是同一件事(认亲),所以分数当然稳。
     ↓
而按设备切一次只看到 12 支测试设备,结果自然会在 0.939 ~ 0.969 之间抖
—— 那才是真实的不确定性,也是我们必须用 GroupKFold 的原因(上一本第 12 章)
★ 两个数字的含义完全不同:
| 数字 | 它在衡量什么 | 该不该信 |
|---|---|---|
| 0.98764(按行随机) | 模型有多会认亲 | ❌ 与上线无关 |
| 0.96503 ± 0.03(按设备) | 遇到新设备时的真实精度区间 | ✅ 这才是要报的数字 |
18.2 亲手证明它是假的:0.96503
现在做本章第一件大事:把划分方式换成按设备。
gss = GroupShuffleSplit(n_splits=1, test_size=0.2, random_state=42)
tr, te = next(gss.split(X, y, groups=df["cell_id"]))

model = RandomForestRegressor(n_estimators=200, random_state=42, n_jobs=-1)  # 同一个模型
model.fit(X.iloc[tr], y.iloc[tr])
print(model.score(X.iloc[te], y.iloc[te]))真实输出:
② 亲手证明它是假的:换成按设备划分,测试 R² = 0.96503
  按设备:GroupShuffleSplit(test_size=0.2, random_state=42)
    训练 17,244 行 / 测试 3,995 行
    训练 R² = 0.99838   测试 R² = 0.96503   训练/测试差 = 0.03335

  ★ 虚高 = 0.98764 − 0.96503 = +0.02261
  ★ 两侧行数几乎一样(4,248 vs 3,995,差 6.3%),所以差别不在『数据变少』,
     而在『测试集里坐着谁』。
  ★ 训练 R² 几乎一样(0.99821 vs 0.99838)—— 模型拟合能力没问题,
     问题在评估口径。
★ 三行输出,三个必须记住的事实:
事实一:模型没变、数据没变、特征没变,只有划分方式变了。
0.98764 → 0.96503
     ↓
差的这 0.02261 不是"模型的差距",是"评估方法的差距"
事实二:虚高 0.02261 ≈ 2.26 个百分点。
R² = 0.96503  表示模型解释了 96.5% 的方差
R² = 0.98764  表示模型解释了 98.8% 的方差

在同一个业务里,这两句话的差别可能是:
    "够用了"  vs  "看起来完美"
事实三:这 0.02261 比大多数"模型改进"都大。
(上一本实测)7 特征线性 → 随机森林:+0.015
(上一本实测)换更强的提升模型:约 ±0.001
本章实测       划分方式改对:−0.02261(把虚高去掉)
     ↓
在评估方法没修好之前,模型比较是无效的 ——
你比较的是"谁更会抄",不是"谁更强"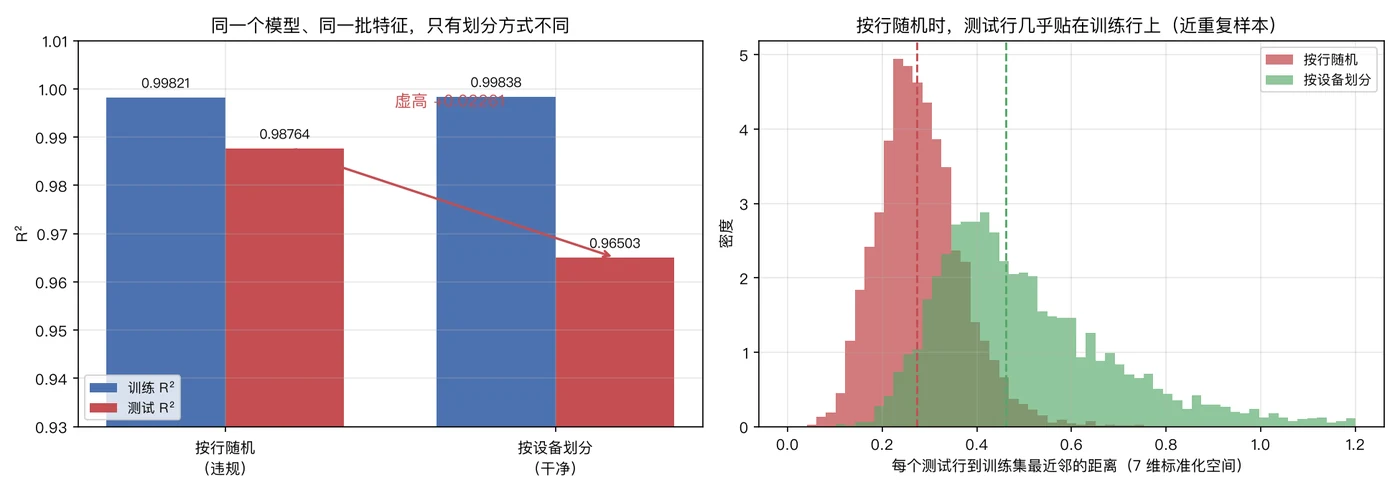
图的读法:
- 左图:两组柱子分别是两种划分下的训练 R²(蓝)与测试 R²(红)。 训练 R² 几乎一样(0.99821 / 0.99838),测试 R² 却差 0.02261 —— 问题一定出在测试集的构成上。
- 右图:每个测试行到训练集最近邻的距离分布。按行随机(红)整体偏左(更近), 按设备(绿)整体偏右 —— 这就是"近重复样本"的形状。
18.3 机制:测试行的最近邻,落在"哪一支设备"
划分泄漏的机制,上一本第 10 章讲透了(详见 第 10 章 · 划分泄漏),一句话复述:
每支设备都有一个固定的个体偏置(传感器标定、装配差异),
同一支设备的每一行都带着它。
     ↓
按行随机时,这个偏置在训练集里"可见" → 模型把它记住
测试时遇到同一支设备的其他行 → 直接套用记住的偏置
     ↓
这是【回忆】,不是【预测】
★ 本章补上一个可以直接量出来的版本:近重复样本。
scaler = StandardScaler().fit(X)
Xs = scaler.transform(X)
nn = NearestNeighbors(n_neighbors=1).fit(Xs[tr])
dist, idx = nn.kneighbors(Xs[te])真实输出:
③ 机制:测试行的最近邻,落在训练集里的『哪一支设备』
  按行随机:最近邻距离 中位 0.2737  5% 分位 0.1489  最小 0.0557
           测试行的设备出现在训练集的比例:100.0%
           最近邻【就是】同一支设备的比例:88.9%
  按设备划分:最近邻距离 中位 0.4615  5% 分位 0.2623  最小 0.1165
           测试行的设备出现在训练集的比例:0.0%
           最近邻【就是】同一支设备的比例:0.0%
  ★ 按设备划分 / 按行随机 的中位距离比 = 1.69 倍
★ 这一组数字比"共有设备 60 支"更有说服力,因为它不依赖你知道分组列:
按行随机:100% 的测试行,其设备在训练集里都出现过
          88.9% 的测试行,最近邻【就是】同一支设备的行
          最近邻距离中位只有 0.2737(按设备时是 0.4615,差 1.69 倍)
     ↓
也就是说:测试行不是"没见过的新样本",
它是"训练样本的邻居",甚至就是同一支设备旁边那一行
★ 那剩下的 11.1% 是怎么回事?
最近邻落在别的设备上 —— 这不矛盾:
在 7 维标准化空间里,两支状态接近的设备本来就会贴在一起
     ↓
泄漏靠的是整体上的【熟人圈子】,不是每一行都必须找到同一个编号的邻居
     ↓
所以"删掉 cell_id 这一列"根本没用(上一本第 10 章实测:
用 7 个特征去猜设备编号,MAE 14.71 与瞎猜 15.12 差不多)
点开:为什么"近邻距离"是比"共有设备"更通用的检查?
因为很多时候你不知道"分组列"是哪一列。
数据里可能有:用户、门店、产线、批次、时间段、供应商、设备……
     ↓
你甚至不知道存在分组结构(比如"同一批原料"这件事没写在表里)
     ↓
但只要"同一实体被反复测量",它的行就会在特征空间里聚堆
     ↓
所以"测试样本离训练集多近"这个指标,在你不知道分组键时也能报警
★ 它的用法是一个【比值】,不是一个绝对值:
比值(按设备 ÷ 按行)≈ 1     → 两种划分下测试样本的"孤独程度"差不多
比值明显 > 1(本数据 1.69)  → 按行随机让测试样本贴到了训练样本上

★ 为什么必须是比值:距离本身依赖特征个数与量纲,
  单独看 0.2737 没有意义;两种划分一比,量纲自动消掉。
★ 实战中的顺序建议:
| 顺序 | 检查 | 成本 | 抓什么 |
|---|---|---|---|
| 1 | 分组列交集 | 1 行 | 分组键已知时的 99% 泄漏 |
| 2 | 近邻距离比值 | 3 行 | 分组键未知时的近重复 |
| 3 | 两种划分的分数差 | 一次训练 | 兜底(也最贵) |
★ 第 1 条最快,第 2 条最通用,第 3 条最贵但最不含糊。
18.4 一个反直觉的现象:干净口径越准,越看不见泄漏
这是本章最重要的新内容。看下面这张表(同一个 demo、同一套口径,只换特征):
真实输出:
④ 天花板效应:干净口径越接近 1,泄漏量越会被挤没
  7 列基础               7 列  21,239 行   按行 0.98764   按设备 0.96503   虚高 +0.02261
  17 列安全(无轨迹)        17 列  19,979 行   按行 0.98953   按设备 0.95906   虚高 +0.03047
  21 列安全全集           21 列  19,979 行   按行 0.99904   按设备 0.99904   虚高 +0.00001
★ 三行连起来读,会得到一个非常危险的结论:
7 列  :虚高 +0.02261(一眼可疑)
17 列 :虚高 +0.03047(更可疑了!因为干净口径反而降了)
21 列 :虚高 +0.00001("没有泄漏")
★ 为什么 21 列时"看起来没有泄漏"?
21 列里有 4 列【历史实测 SOH】(soh_lag1 / lag5 / win_mean5 / win_std5)
     ↓
它们把干净口径直接推到 0.99904 —— 已经贴到天花板
     ↓
天花板是数据里的【窗口级测量噪声】,谁都消不掉
(上一本第 10 章算过:残差里约 35% 是逐行独立的噪声)
     ↓
按行随机也只能到 0.99904(0.99904 + 0.00001 ≈ 1 的上限)
     ↓
于是"虚高"被天花板吃掉了,不是泄漏消失了
★ 这条现象有一个非常现实的后果:
在"强特征"配置下,用泄漏口径跑出来的分数看起来完全合理, 你会发现不了它 —— 而这正是它最危险的时候。
换句话说:"分数看着不高不低、挺合理"不能当作"没有泄漏"的证据。 检查必须基于流程(怎么切的),而不是基于结果(分数像不像)。
★ 反过来,这也是一个选对照配置的通用原则(第 15 章的消融实验同样适用):
要做"两种口径的对照",必须挑【看得见差异】的配置
     ↓
本数据的正确选择:7 列基线(虚高 +0.02261 清晰可见)
错误选择:21 列全特征(被天花板压成 +0.00001,测了等于没测)
     ↓
通用经验:对照组要挑【干净口径离天花板还有距离】的那个配置
点开:为什么 17 列的虚高(+0.03047)反而比 7 列更大?
因为泄漏量 = "干净口径离天花板还有多远",而 17 列把干净口径往下拉了。
7 列 :干净 0.96503,按行 0.98764
17 列:干净 0.95906(反而降了),按行 0.98953(略升)
     ↓
17 列比 7 列多出来的 10 列(窗口统计 / 差分斜率 / 极差)几乎不提供新信息,
但它们带来了 1,260 行冷启动 NaN 被 dropna 掉的代价
     ↓
净效果:干净口径 −0.006,泄漏口径 +0.002
     ↓
于是"差距"从 0.02261 拉大到 0.03047
★ 这说明一件重要的事:
虚高量不是"泄漏的强度",而是"泄漏的优势 ÷ 干净口径的水平"的一个综合结果
     ↓
干净口径掉下去,虚高量会变大 —— 但你在报告里看到的,只是"按行随机 0.98953"
(还是很漂亮,甚至比 7 列的 0.98764 更好看)
     ↓
所以:不能靠比较"历史分数"发现泄漏
★ 顺便记住 17 列这一行的另一个意义(第 20 章会用到):
加 10 列特征(窗口/差分/极差)→ 干净口径从 0.96503 【降到】0.95906
加 4 列轨迹特征            → 干净口径从 0.95906 【跳到】0.99904

特征工程的收益来自"找对信息结构",不是"多加列"
18.5 判据:分数差 + 稳定性
18.5.1 分数一致性检查(最通用的软检查)
gap = s_row - s_grp # 0.98764 − 0.96503 = +0.02261真实输出:
⑤ 判据:两种划分的分数差(> 0.02 就要回头查管道)
  0.98764(按行) − 0.96503(按设备) = +0.02261
→ ⚠️ 几乎肯定是划分泄漏:改用分组划分,并回头检查数据管道| 分数差 | 含义 | 该做什么 |
|---|---|---|
| < 0.005 | 两种划分差不多 | 分组结构可能很弱,但要说明依据 |
| 0.005 ~ 0.02 | 有值得注意的差距 | 以分组口径为准,并在报告里注明 |
| > 0.02 | 几乎肯定是泄漏 | 按分组口径重跑,并回头检查数据管道 |
★ 这三个阈值是经验值,不是定律。 它们的作用是"叫你来回答一个问题":
分数差 > 0.02 → 你必须回答:"为什么两种划分差这么多?"
     · 能给出机制解释(比如"客户会连续下单")→ 记录在案,用分组口径
     · 给不出解释 → 当成泄漏处理
18.5.2 稳定性检查(本章新增)
真实输出:
  同时看『干净口径的稳定性』:只动划分的种子,模型种子固定 42
    seed        按行随机         按设备           差
       0     0.98719     0.93903    +0.04816
       1     0.98684     0.96942    +0.01743
       7     0.98763     0.95514    +0.03248
      42     0.98764     0.96503    +0.02261
    2024     0.98693     0.94925    +0.03768
★ 读这张表要注意三件事:
① 按行随机的 5 个分数全在 0.9868 ~ 0.9876:极差 0.00079(假稳)
② 按设备的 5 个分数落在 0.9390 ~ 0.9694:极差 0.03039(真实的不确定性)
③ "虚高"那一列在 +0.01743 ~ +0.04816 之间波动,中位约 +0.033
★ 结论有两层:
第一层(方法):只切一次根本没法比较模型 ——
    用 GroupKFold(上一本第 12 章)拿到"均值 ± 标准差"才算数。

第二层(反直觉):泄漏口径的"稳定"是一种【作弊的稳定】:
    它每次都让模型看到全部 60 支设备的邻居,
    考的是同一个能力(认亲),分数当然稳。
     ↓
所以以后再看到"CV 标准差只有 ±0.0005,模型非常稳定",
先问一句:折与折之间有没有同一支设备?
18.6 抄进项目的检查代码
检测方法的价值在于"你会想起来用它";断言的价值在于"你想不起来也会被执行"。
真实输出:
⑥ 抄进项目的三条断言 + 一条软检查
  按设备划分 → 断言通过:{'设备交集': 0, '行交集': 0, '跨集相邻对': 0}
  按行随机   → AssertionError: 划分泄漏:60 支设备同时出现在训练和测试集里,例如 ['C001', 'C002', 'C003']

  软检查(不抛错,只报告):
    [RandomForest(200)] 按行 0.98764 / 按设备 0.96503 / 差 +0.02261  ⚠️ 疑似泄漏
★ 完整代码(可以直接抄进你的项目):
def audit_split(df, idx_train, idx_test, group_col, max_overlap=0):
    """划分体检。任何一个条件不满足就抛 AssertionError。"""
    tr, te = df.loc[idx_train], df.loc[idx_test]

    # 断言一:实体不跨集(最重要)
    overlap = set(tr[group_col]) & set(te[group_col])
    assert len(overlap) <= max_overlap, (
        f"划分泄漏:{len(overlap)} 支设备同时出现在训练和测试集里,"
        f"例如 {sorted(overlap)[:3]}")

    # 断言二:同一行不在两边
    rows_overlap = set(idx_train) & set(idx_test)
    assert not rows_overlap, f"同一行同时出现在两边:{len(rows_overlap)} 行"

    # 断言三:没有跨集相邻对
    te_set = set(idx_test)
    cross = 0
    for _, sub in df.groupby(group_col):
        flags = sub.index.isin(te_set)
        cross += int(np.sum(flags[1:] != flags[:-1]))
    assert cross == 0, f"{cross} 对相邻行被拆到了不同集合"

    return {"设备交集": len(overlap), "行交集": len(rows_overlap), "跨集相邻对": cross}


def check_score_gap(s_row, s_grp, tol=0.02, name="模型"):
    """软检查:两种划分的分数差。不抛错,只报告。"""
    gap = s_row - s_grp
    flag = ("⚠️ 疑似划分泄漏:改用分组划分" if gap > tol
            else "⚠️ 有值得解释的差距:以分组口径为准" if gap > 0.005
            else "✅ 两种划分基本一致")
    print(f"[{name}] 按行 {s_row:.5f} / 按设备 {s_grp:.5f} / 差 {gap:+.5f}  {flag}")
    return gap
★ 三条断言的优先级:
| 断言 | 抓什么 | 运行代价 | 优先级 |
|---|---|---|---|
| ① 实体不跨集 | 99% 的划分泄漏 | 一个集合交集 | 必须 |
| ② 行不重复 | 索引对齐错误 | 一个集合交集 | 必须 |
| ③ 无跨集相邻对 | 实体内的近邻泄漏 | 60 次 groupby | 推荐 |
★ 第 ③ 条为什么会单独存在?本章实测:
按行随机 → 跨集相邻对 6,757 对
按设备 → 跨集相邻对 0 对21,179 对相邻行里有 6,757 对被拆到了两边 —— 占 31.9%
↓
这意味着:测试集里每 3 行,就有 1 行的"上一行"躺在训练集里
↓
断言①(实体不跨集)能挡住它,但如果你的分组键选得不够细
(比如按"批次"切,而同一支设备横跨两个批次),就只有断言③能挡住18.7 常见坑
① 用 train_test_split 切有分组结构的数据   → 虚高(本章实测 +0.02261)
② 用"行交集 = 0"当泄漏检查                 → 这个检查永远通过,没有信息量
③ 发现分数好就换更强的模型                  → 可能只是把"记忆能力"换成"分数"
④ 看到 CV 标准差很小就认为"模型很稳"        → 先查折间有没有同一实体
⑤ 在强特征配置下做泄漏对照                  → 天花板效应会把差距压成 0.00001
⑥ 用"分数看起来合理"当验收标准              → 泄漏的分数通常就是"看起来合理"
★ 第 ⑤ 条是本章新增的、也是最容易忽略的一条:
"我用 21 列全特征跑了两种划分,差 0.00001,说明没有泄漏。"
     ↓
错。那是天花板效应,不是干净。
正确的做法是:换一个"看得见差异"的配置(7 列基线)再测一次。
★ 五个坑的共同点(第 04 章说过一次,这里再说一次):
报错的错误  → 技术问题,改一下就好
不报错的错误 → 方法问题,会毁掉整个项目
18.8 完整示例与输出
cd tools/feature-engineering-pipeline/code
MPLCONFIGDIR=/tmp/fe-mpl /Users/jini/Projects/MyBooks/Basic-Tutorials/.pytmp/venv/bin/python \
demos/ch18-leak-split.py真实输出(节选):
① 先高兴一下:按行随机划分,测试 R² = 0.98764
    训练 R² = 0.99821   测试 R² = 0.98764   训练/测试差 = 0.01057

② 亲手证明它是假的:换成按设备划分,测试 R² = 0.96503
    训练 R² = 0.99838   测试 R² = 0.96503   训练/测试差 = 0.03335
  ★ 虚高 = 0.98764 − 0.96503 = +0.02261

③ 机制:测试行的最近邻,落在训练集里的『哪一支设备』
  按行随机:最近邻距离 中位 0.2737   测试行的设备出现在训练集的比例:100.0%
           最近邻【就是】同一支设备的比例:88.9%
  按设备划分:最近邻距离 中位 0.4615   测试行的设备出现在训练集的比例:0.0%
  ★ 按设备划分 / 按行随机 的中位距离比 = 1.69 倍

④ 天花板效应:干净口径越接近 1,泄漏量越会被挤没
  7 列基础     21,239 行   按行 0.98764   按设备 0.96503   虚高 +0.02261
  17 列安全    19,979 行   按行 0.98953   按设备 0.95906   虚高 +0.03047
  21 列安全全集 19,979 行   按行 0.99904   按设备 0.99904   虚高 +0.00001

⑤ 判据:两种划分的分数差(> 0.02 就要回头查管道)
  0.98764(按行) − 0.96503(按设备) = +0.02261   →  ⚠️ 几乎肯定是划分泄漏

⑥ 抄进项目的三条断言 + 一条软检查
  按设备划分 → 断言通过:{'设备交集': 0, '行交集': 0, '跨集相邻对': 0}
  按行随机   → AssertionError: 划分泄漏:60 支设备同时出现在训练和测试集里
本章练习
练习 1:复现 0.98764 / 0.96503,并算出"熟人比例"
用 7 列基础特征 + 随机森林 200 棵:
- 按行随机划分,打印测试 R²、测试行数、以及"测试行的设备在训练集出现过的比例";
- 按设备划分,打印同样三项;
- 打印虚高,以及两侧训练 R² 的差;
- 用一句话说明:为什么"训练 R² 几乎一样"这个事实很重要?
参考答案
import numpy as np, pandas as pd
from sklearn.ensemble import RandomForestRegressor
from sklearn.metrics import r2_score
from sklearn.model_selection import GroupShuffleSplit, train_test_split

BASE = ["cycle", "mean_charge_voltage_v", "mean_temp_rise_c", "resistance_mohm",
        "coulombic_eff", "cap_fade_rate_ah_per_100", "temp_std_c"]
df = pd.read_csv("data/battery/soh_features_v2.csv")
X, y, g = df[BASE], df["soh"], df["cell_id"]

def rf():
    return RandomForestRegressor(n_estimators=200, random_state=42, n_jobs=-1)

tr_r, te_r = train_test_split(np.arange(len(X)), test_size=0.2, random_state=42)
m_r = rf().fit(X.iloc[tr_r], y.iloc[tr_r])
s_row = r2_score(y.iloc[te_r], m_r.predict(X.iloc[te_r]))

tr_g, te_g = next(GroupShuffleSplit(n_splits=1, test_size=0.2,
                                    random_state=42).split(X, y, groups=g))
m_g = rf().fit(X.iloc[tr_g], y.iloc[tr_g])
s_grp = r2_score(y.iloc[te_g], m_g.predict(X.iloc[te_g]))

for tag, tr, te, s, m in (("按行随机", tr_r, te_r, s_row, m_r),
                          ("按设备划分", tr_g, te_g, s_grp, m_g)):
    sib = df.iloc[te]["cell_id"].isin(set(g.iloc[tr])).mean()
    print(f"{tag}  测试 {len(te):,d} 行   测试 R² = {s:.5f}   "
          f"设备在训练集出现过:{sib:.1%}")
print(f"虚高 = {s_row - s_grp:+.5f}")
print(f"训练 R² 差 = {abs(m_r.score(X.iloc[tr_r], y.iloc[tr_r]) - m_g.score(X.iloc[tr_g], y.iloc[tr_g])):.5f}")期望输出:
按行随机  测试 4,248 行   测试 R² = 0.98764   设备在训练集出现过:100.0%
按设备划分  测试 3,995 行   测试 R² = 0.96503   设备在训练集出现过:0.0%
虚高 = +0.02261
训练 R² 差 = 0.00017
★ 第 4 问的答案
两侧训练 R² 只差 0.00017(0.99821 vs 0.99838),说明模型在两个训练集上的
拟合能力完全一样。
     ↓
所以测试 R² 的 0.02261 差距,不可能是"模型学得好不好"造成的,
只能是"测试集里有什么"造成的
     ↓
一次干净的对照实验,必须把【无关变量】都按住:
模型、特征、行数量级、训练拟合程度,全部一致,只留划分方式一个变量
练习 2:只动划分种子,比较两种划分的"稳定性"
- 对
random_state ∈ {0, 1, 7, 42, 2024},分别用按行随机与按设备划分跑随机森林(模型种子固定 42); - 打印 5 行结果(两种分数 + 虚高);
- 算出两种划分各自的极差与标准差;
- 解释为什么"按行随机更稳"是坏事。
参考答案
import numpy as np, pandas as pd
from sklearn.ensemble import RandomForestRegressor
from sklearn.metrics import r2_score
from sklearn.model_selection import GroupShuffleSplit, train_test_split

BASE = ["cycle", "mean_charge_voltage_v", "mean_temp_rise_c", "resistance_mohm",
        "coulombic_eff", "cap_fade_rate_ah_per_100", "temp_std_c"]
df = pd.read_csv("data/battery/soh_features_v2.csv")
X, y, g = df[BASE], df["soh"], df["cell_id"]

def rf():
    return RandomForestRegressor(n_estimators=200, random_state=42, n_jobs=-1)

rows = []
for rs in (0, 1, 7, 42, 2024):
    tr, te = train_test_split(np.arange(len(X)), test_size=0.2, random_state=rs)
    a = r2_score(y.iloc[te], rf().fit(X.iloc[tr], y.iloc[tr]).predict(X.iloc[te]))
    tr2, te2 = next(GroupShuffleSplit(n_splits=1, test_size=0.2,
                                      random_state=rs).split(X, y, groups=g))
    b = r2_score(y.iloc[te2], rf().fit(X.iloc[tr2], y.iloc[tr2]).predict(X.iloc[te2]))
    rows.append((rs, a, b))
    print(f"seed {rs:>5}  按行 {a:.5f}  按设备 {b:.5f}  差 {a - b:+.5f}")

arr = np.array([[a, b] for _, a, b in rows])
print(f"\n按行随机:极差 {np.ptp(arr[:, 0]):.5f}  标准差 {arr[:, 0].std(ddof=1):.5f}")
print(f"按设备 :极差 {np.ptp(arr[:, 1]):.5f} 标准差 {arr[:, 1].std(ddof=1):.5f}")期望输出:
seed     0  按行 0.98719  按设备 0.93903  差 +0.04816
seed     1  按行 0.98684  按设备 0.96942  差 +0.01743
seed     7  按行 0.98763  按设备 0.95514  差 +0.03248
seed    42  按行 0.98764  按设备 0.96503  差 +0.02261
seed  2024  按行 0.98693  按设备 0.94925  差 +0.03768

按行随机:极差 0.00079  标准差 0.00038
按设备  :极差 0.03039  标准差 0.01219
★ 第 4 问的答案
按行随机的"稳"是假稳:它每次都给模型看到全部 60 支设备的邻居,
5 次实验考的都是同一个能力(认亲),所以分数几乎不动。
     ↓
按设备的"散"才是真的:每次只留 12 支设备当测试集,
不同设备组合的难度不同,分数自然在 0.939 ~ 0.969 之间抖。
     ↓
"稳"本身不是优点 —— 要问"稳在什么东西上":
    稳在"考试内容一致"上是好事,
    稳在"每次都作弊"上是坏事。
     ↓
所以:按设备的口径必须用 GroupKFold 取多折平均,
     并用标准差把这个不确定性如实报出来(上一本第 11/12 章)
练习 3:写"划分体检"函数(三条断言 + 一条软检查)
- 实现
audit_split(df, tr, te, group_col),包含三条断言(实体不跨集、行不重复、无跨集相邻对); - 实现
check_score_gap(s_row, s_grp, tol=0.02),按阈值打印结论; - 对干净口径打印通过信息;对违规口径捕获
AssertionError并打印; - 最后对两种划分各跑一次随机森林,调用软检查。
参考答案
import numpy as np, pandas as pd
from sklearn.ensemble import RandomForestRegressor
from sklearn.metrics import r2_score
from sklearn.model_selection import GroupShuffleSplit, train_test_split

BASE = ["cycle", "mean_charge_voltage_v", "mean_temp_rise_c", "resistance_mohm",
        "coulombic_eff", "cap_fade_rate_ah_per_100", "temp_std_c"]


def audit_split(df, idx_train, idx_test, group_col, max_overlap=0):
    overlap = set(df.loc[idx_train, group_col]) & set(df.loc[idx_test, group_col])
    assert len(overlap) <= max_overlap, (
        f"划分泄漏:{len(overlap)} 支设备同时出现在训练和测试集里,"
        f"例如 {sorted(overlap)[:3]}")
    rows_overlap = set(idx_train) & set(idx_test)
    assert not rows_overlap, f"同一行同时出现在两边:{len(rows_overlap)} 行"
    te_set = set(idx_test)
    cross = 0
    for _, sub in df.groupby(group_col):
        flags = sub.index.isin(te_set)
        cross += int(np.sum(flags[1:] != flags[:-1]))
    assert cross == 0, f"{cross} 对相邻行被拆到了不同集合"
    return {"设备交集": len(overlap), "行交集": len(rows_overlap), "跨集相邻对": cross}


def check_score_gap(s_row, s_grp, tol=0.02, name="模型"):
    gap = s_row - s_grp
    if gap > tol:
        flag = "⚠️ 疑似划分泄漏:改用分组划分"
    elif gap > 0.005:
        flag = "⚠️ 有值得解释的差距:以分组口径为准"
    else:
        flag = "✅ 两种划分基本一致"
    print(f"[{name}] 按行 {s_row:.5f} / 按设备 {s_grp:.5f} / 差 {gap:+.5f}  {flag}")
    return gap


df = pd.read_csv("data/battery/soh_features_v2.csv")
X, y, g = df[BASE], df["soh"], df["cell_id"]
tr_r, te_r = train_test_split(np.arange(len(X)), test_size=0.2, random_state=42)
tr_g, te_g = next(GroupShuffleSplit(n_splits=1, test_size=0.2,
                                    random_state=42).split(X, y, groups=g))

print("按设备划分(干净口径):")
print(f"  断言通过 → {audit_split(df, tr_g, te_g, 'cell_id')}")
print("按行随机(违规口径):")
try:
    audit_split(df, tr_r, te_r, "cell_id")
except AssertionError as e:
    print(f"  AssertionError: {e}")

def rf():
    return RandomForestRegressor(n_estimators=200, random_state=42, n_jobs=-1)

s_row = r2_score(y.iloc[te_r], rf().fit(X.iloc[tr_r], y.iloc[tr_r]).predict(X.iloc[te_r]))
s_grp = r2_score(y.iloc[te_g], rf().fit(X.iloc[tr_g], y.iloc[tr_g]).predict(X.iloc[te_g]))
check_score_gap(s_row, s_grp, name="RandomForest(200)")期望输出:
按设备划分(干净口径):
  断言通过 → {'设备交集': 0, '行交集': 0, '跨集相邻对': 0}
按行随机(违规口径):
  AssertionError: 划分泄漏:60 支设备同时出现在训练和测试集里,例如 ['C001', 'C002', 'C003']

[RandomForest(200)] 按行 0.98764 / 按设备 0.96503 / 差 +0.02261  ⚠️ 疑似划分泄漏:改用分组划分
★ 把这两个函数放进你的项目里,只需要一次改动:
划分函数  →  调用 audit_split(挡住已知的坑)
评估函数  →  调用 check_score_gap(挡住未知的坑)
     ↓
两者都通过,你才有资格说"这个分数是可信的"
面向工程实践
| 场景 | 怎么用 |
|---|---|
| 评估脚本模板 | 把 audit_split 放在划分之后、check_score_gap 放在评估之后,各一行 |
| 评审模型报告 | 先看"按什么切的",再看分数;没有分组键说明的报告一律不签 |
| 监控分数异常 | 分数突然从 0.96 涨到 0.98 → 先查划分,别急着庆功 |
| 排查线上掉点 | 离线 0.98 / 线上 0.94 → 大概率就是本章这个坑(离线口径错了) |
| 样本量很大时的小心 | 每个实体样本越多,泄漏越严重;实体数少时检查越容易漏(差异不显著) |
| 时序数据 | 分组键要选"实体 + 时间段"两级:同一支设备的相邻窗口不能跨集且训练要在时间上早于测试 |
★ 一句话总结本章:
划分泄漏不改变模型、不改变数据、不改变特征 —— 它改变的是"你手里那个分数代表什么"。 0.98764 衡量"认亲",0.96503 衡量"预测",只有后者对应上线。